V-RAE:重构视频生成的潜在空间,语义表征如何重塑生成范式?
近年来,视频生成模型在规模、数据和算力的推动下飞速发展,扩散模型与自回归架构不断刷新生成质量的上限。然而,在追求更大模型和更长训练的同时,一个更为基础却常被忽视的问题浮出水面:生成模型究竟在什么样的潜在空间中学习? 这个问题的答案,直接决定了模型需要建模的内容、训练的难度以及最终生成结果的合理性。

当前主流视频生成系统普遍采用两阶段范式:首先通过视频变分自编码器(Video VAE)将原始像素视频压缩为低维潜在表示(latent),再由生成模型(如扩散或自回归网络)学习该潜在空间中的分布。这一潜在空间如同整个生成系统的“隐形地基”——它虽不直接可见,却深刻影响着模型的能力边界。传统视频VAE的设计目标高度聚焦于像素级重建精度,即尽可能还原输入视频的纹理、色彩和局部细节。这种设计逻辑看似合理,实则隐含一个关键假设:能够准确重建真实视频的潜在空间,也必然易于生成新视频。 然而,越来越多的证据表明,这一假设在复杂动态场景中并不成立。
近期,图像生成领域兴起的表征自编码器(Representation Autoencoder, RAE)为这一问题提供了新思路。RAE摒弃了从像素重建中学习潜在表示的传统路径,转而直接利用冻结的预训练视觉基础模型(如DINO、CLIP等)提取的高层语义特征作为生成空间。这些特征已在大规模数据上学习到丰富的物体、场景和语义结构,使得生成模型无需从零开始发现高层概念,从而显著降低学习难度。这一范式在图像生成中已展现出优越性,但其能否成功扩展至视频领域,仍是一个开放问题。
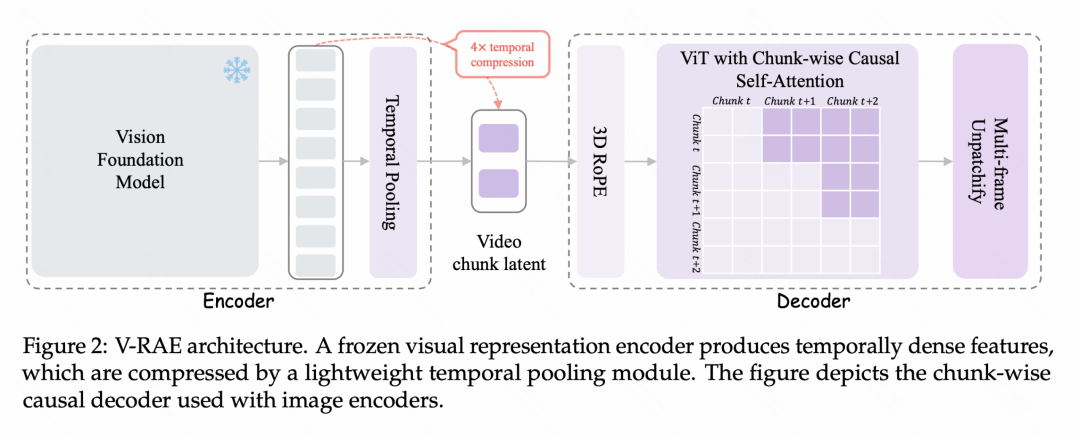
视频相较于静态图像,引入了时间维度这一核心挑战。除了空间语义,视频还包含动作、运动轨迹、事件演化等动态信息,且逐帧视觉表征存在大量冗余。若简单沿用图像RAE的逐帧处理策略,潜在token数量将随视频长度线性增长,导致计算成本不可接受;而若采用粗粒度时间压缩(如平均池化),又极易丢失关键的时序动态。因此,如何在压缩时间维度的同时保留语义与动作信息,成为视频RAE落地的关键瓶颈。
针对上述挑战,新加坡国立大学与牛津大学团队提出的V-RAE(Video Representation Autoencoder)系统性地验证了基于预训练表征的潜在空间在视频生成中的可行性,并重新定义了视频潜在空间的设计原则。V-RAE的核心思想极为简洁:将冻结的视觉基础模型作为编码器,直接以其输出的高层表征作为生成模型的工作空间。研究团队系统评估了四种具有不同预训练范式的模型——DINOv3(自监督对比学习)、SigLIP2(图像-文本对齐)、EUPE(统一嵌入)和V-JEPA 2.1(联合嵌入预测架构),覆盖了当前主流的视觉表征学习路径。
为解决视频表征过长的问题,V-RAE引入了一个轻量级的时间注意力池化(temporal attention pooling)模块。该模块并非简单地对时间维度进行均匀下采样,而是通过内容自适应的注意力机制,动态聚合连续帧中的关键信息。例如,在人物行走的视频片段中,池化模块会更关注肢体关节的位置变化,而非背景的静态纹理。这种设计在实现4倍时间压缩的同时,有效保留了动作语义和跨帧依赖关系。随后,压缩后的表征通过一个配备3D旋转位置编码(3D RoPE)的时空Transformer解码器,重建为连续视频序列。3D RoPE显式建模了空间位置与时序顺序的联合关系,确保解码过程中的时空一致性。
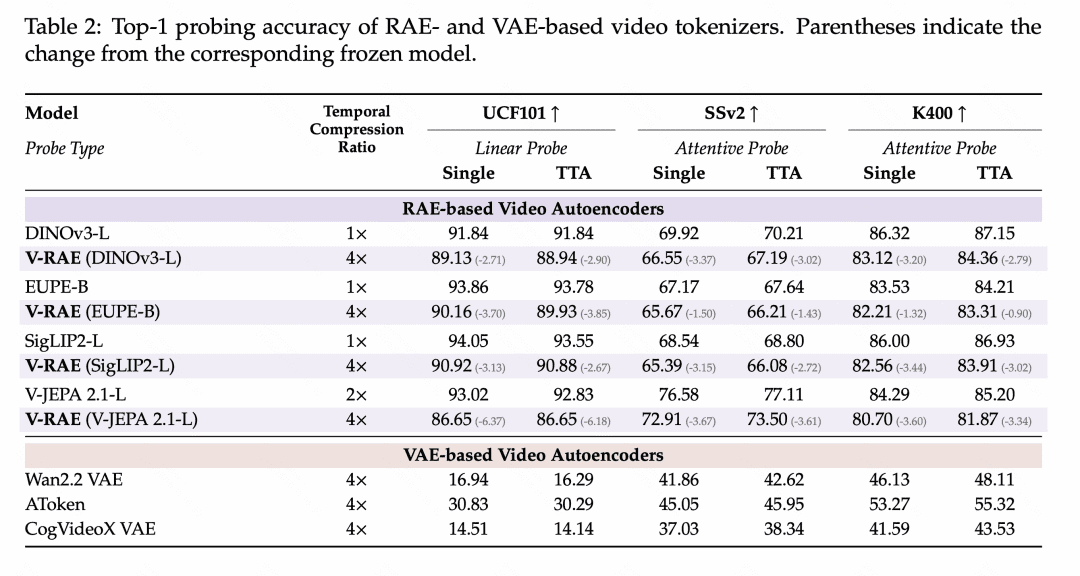
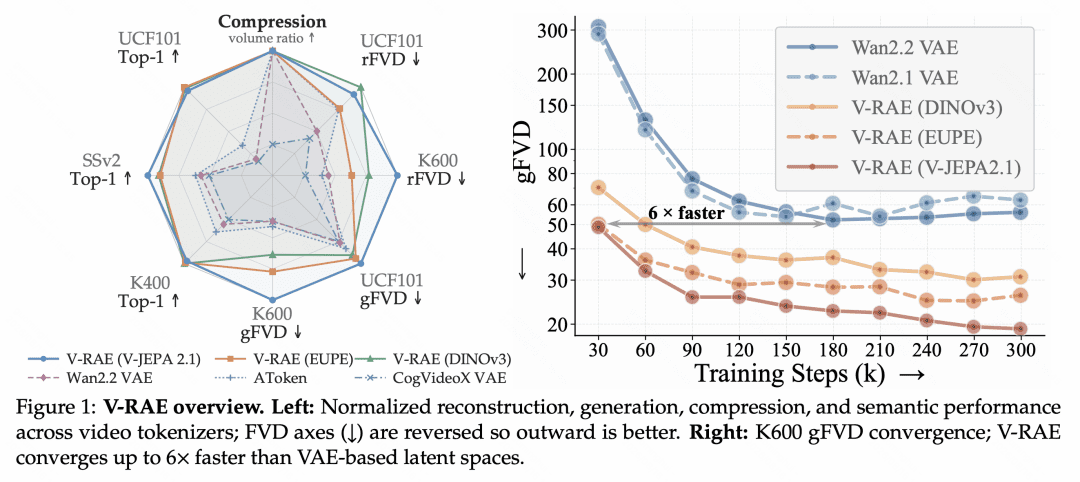
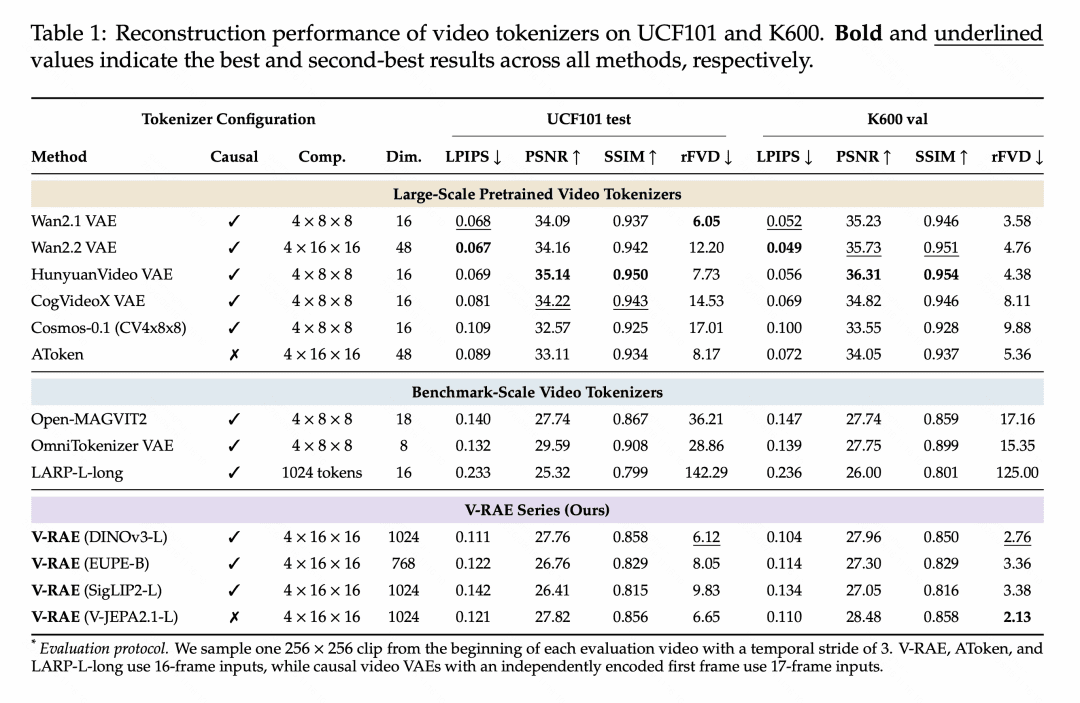
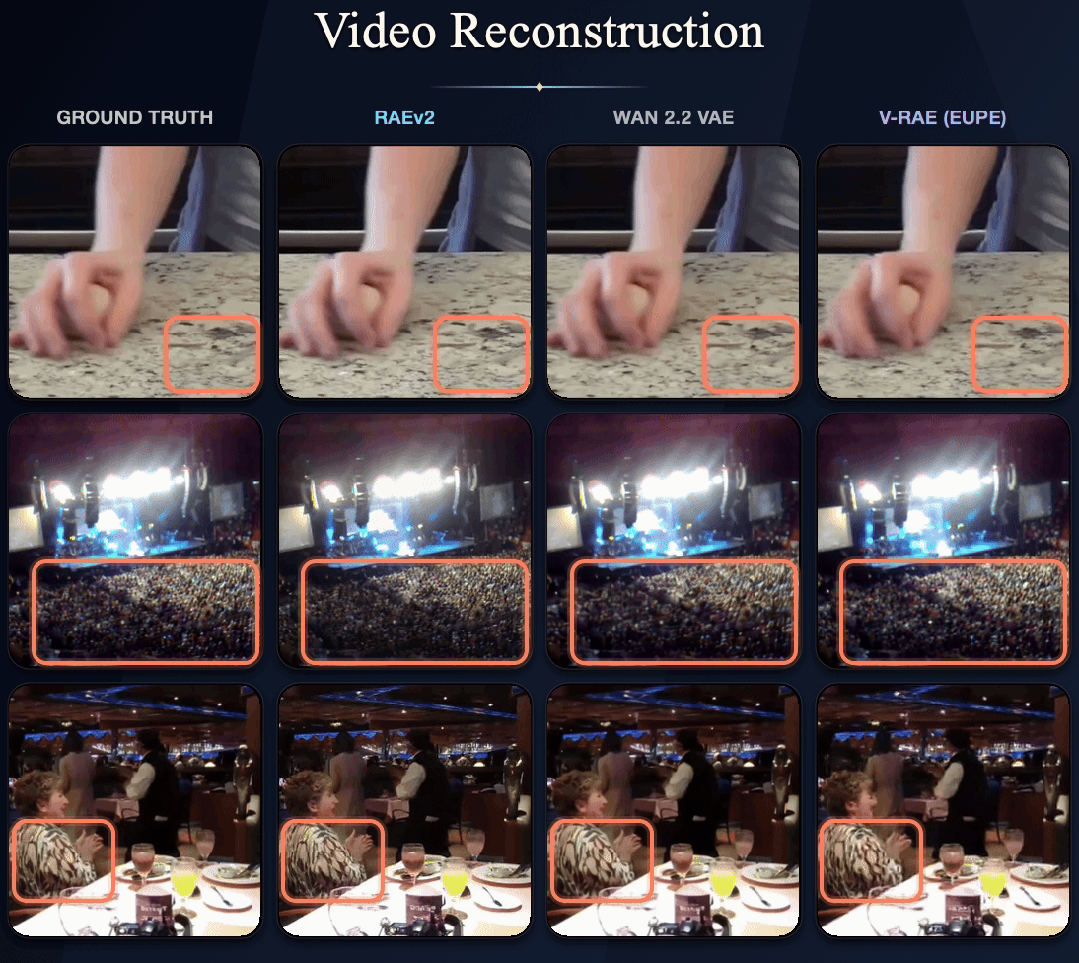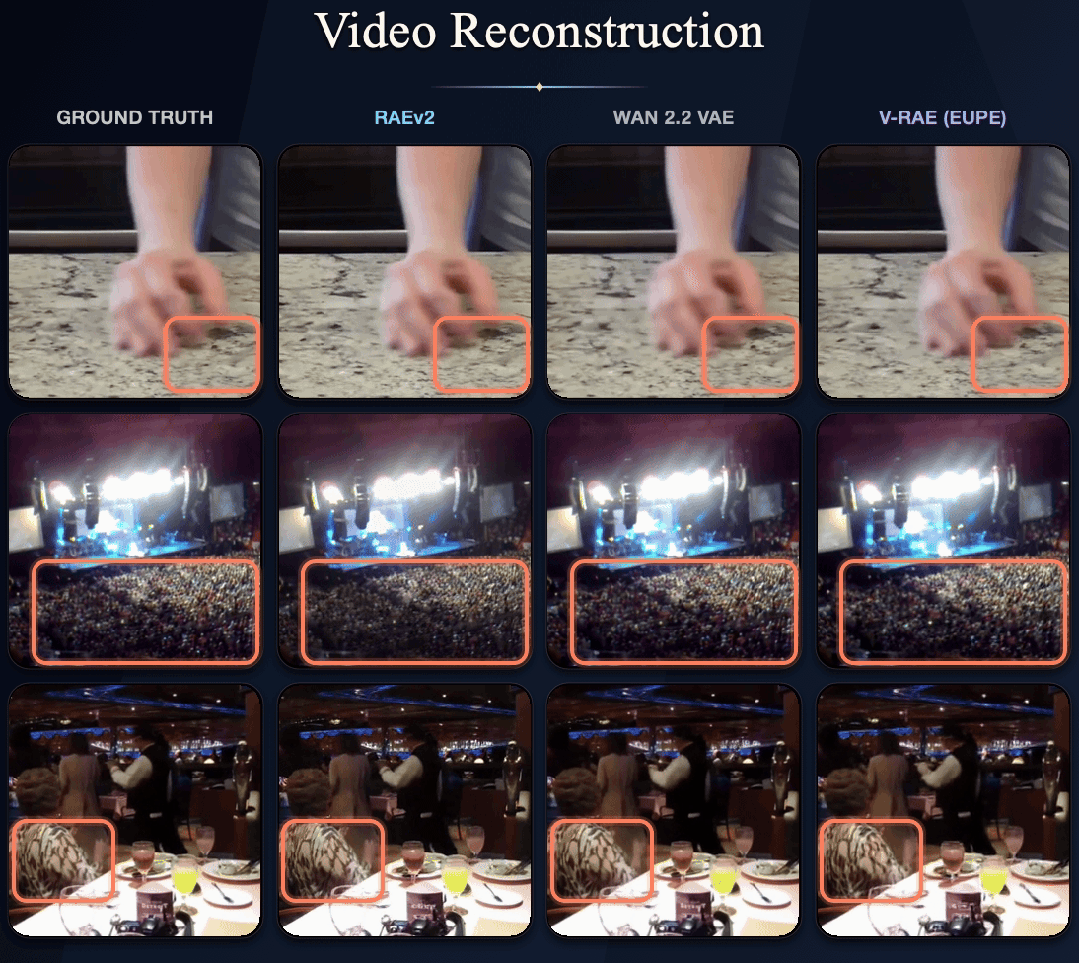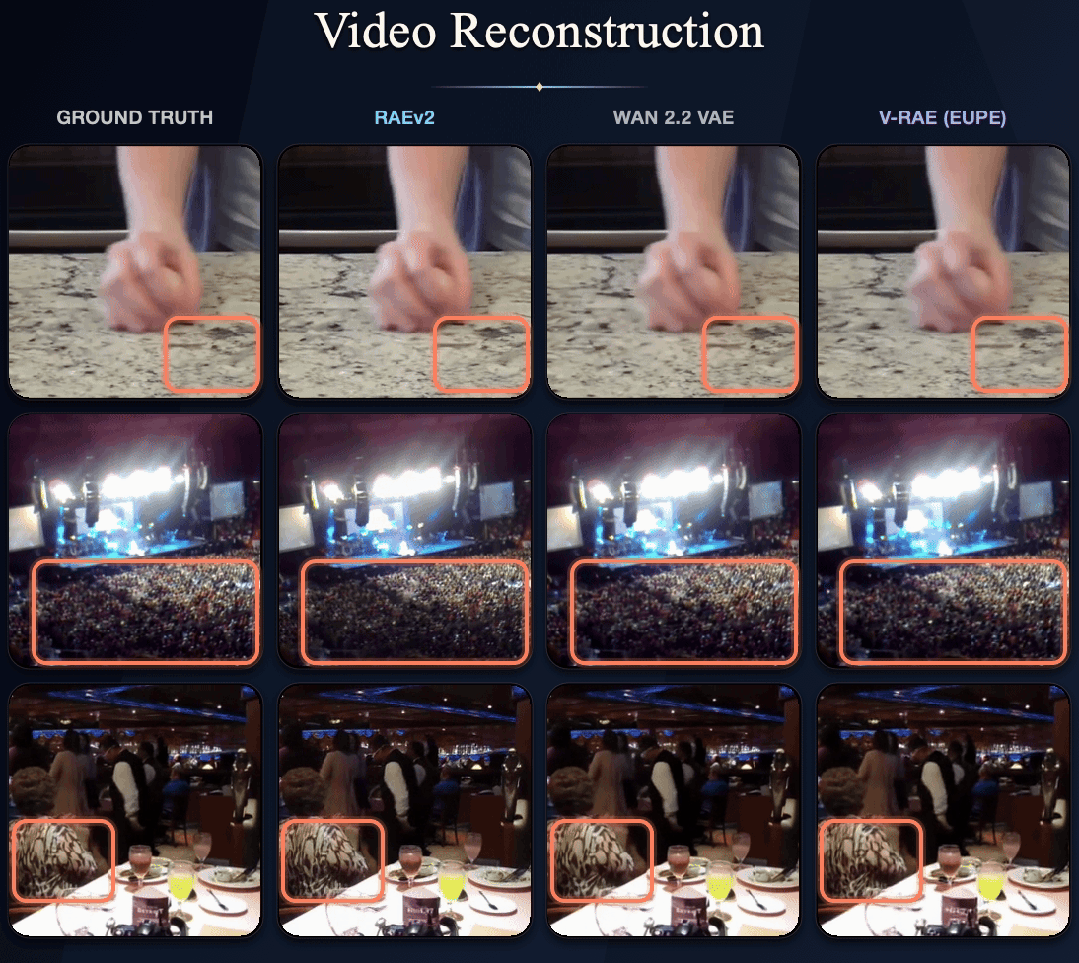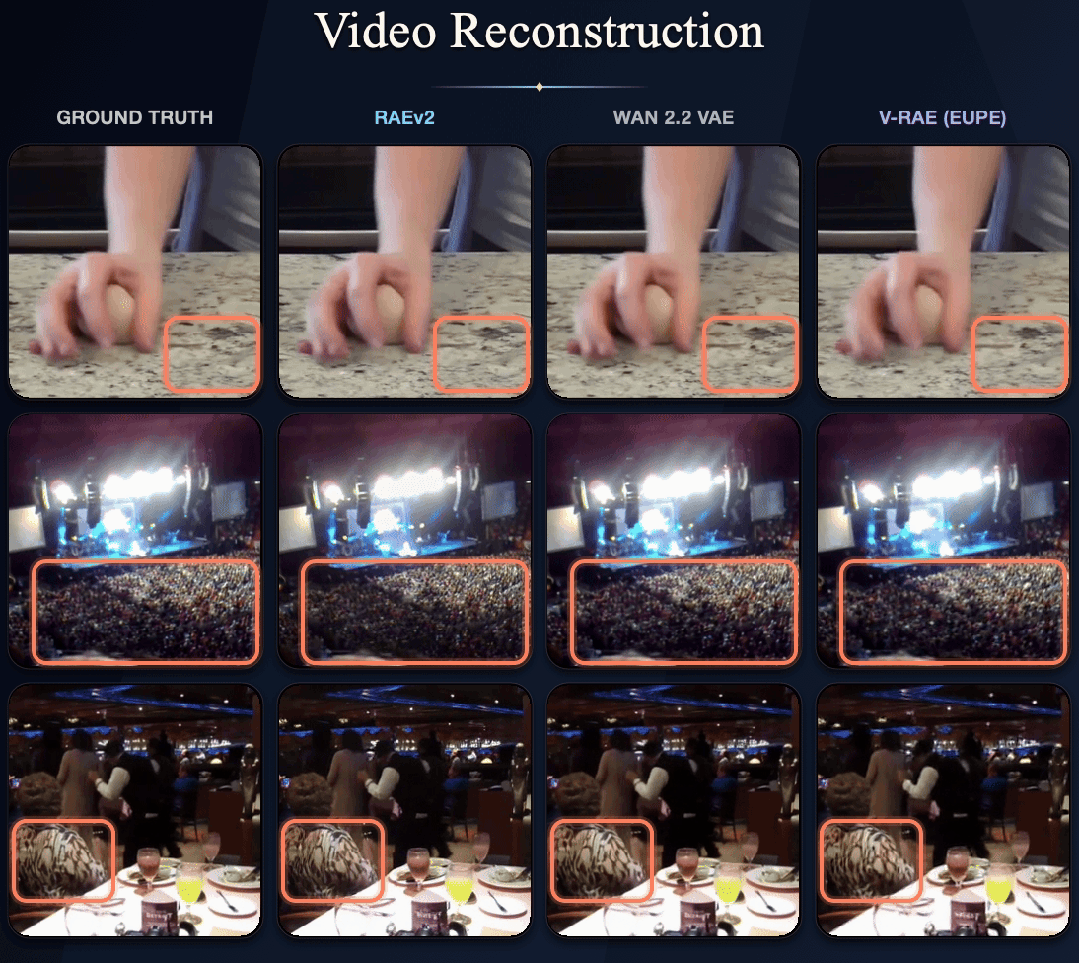
实验首先验证了RAE范式在视频领域的基本可行性。尽管所用表征并非为像素重建而优化,V-RAE在Kinetics-600数据集上仍取得了2.13的rFVD(reconstruction Fréchet Video Distance),显著优于当前最佳视频VAE的3.58;在UCF101上,其重建性能也与最强VAE基线相当。更值得关注的是潜在表征本身的信息含量:在UCF101的语义探针任务中,V-RAE潜在表征的分类准确率高达90.92%,而传统VAE最高仅30.83%;在强调时序理解的Something-Something V2数据集上,V-RAE也达到72.91%。这表明,即使经过时间压缩,预训练模型学到的物体、动作及事件结构仍被有效保留。
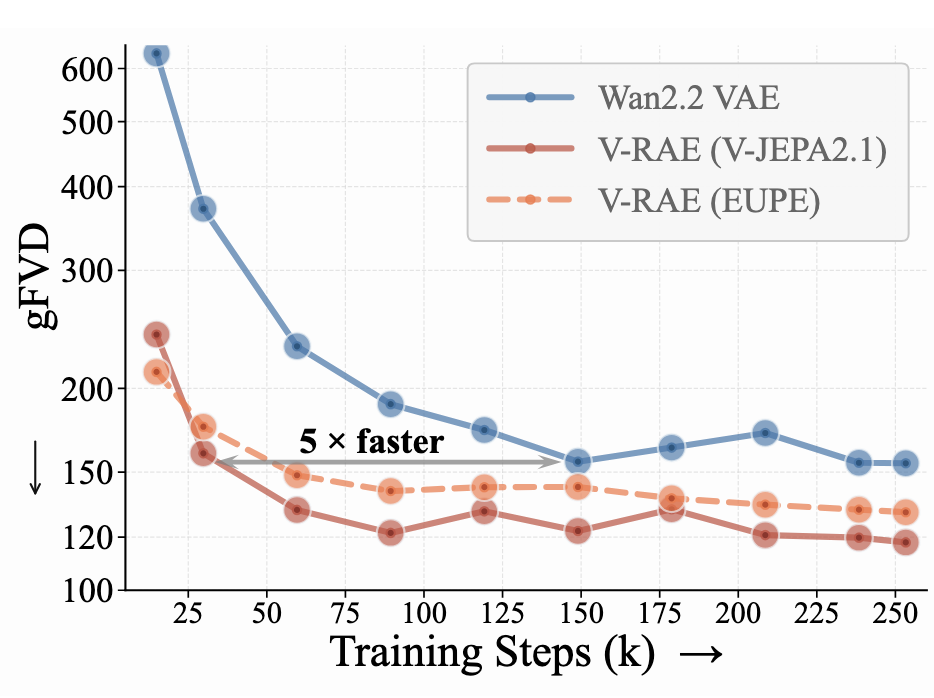
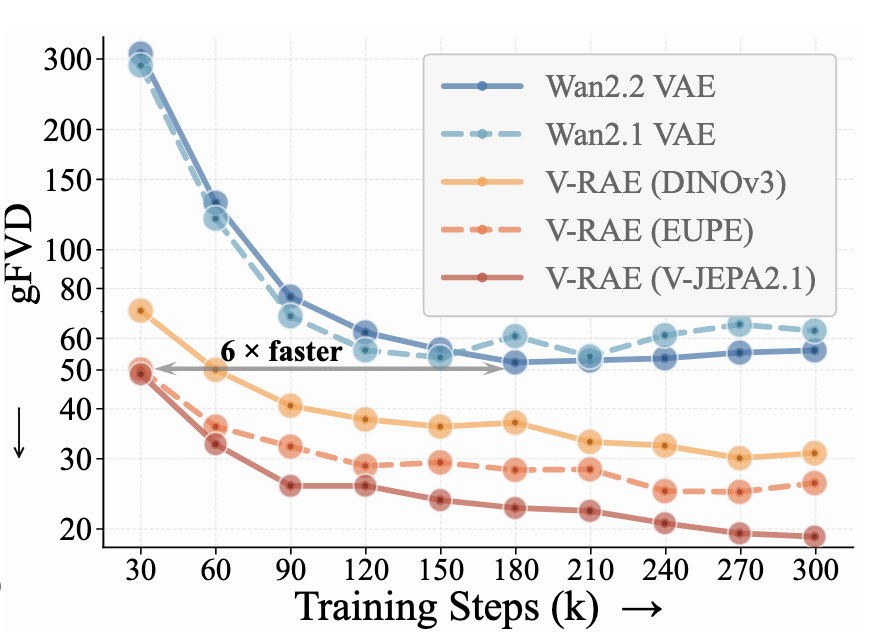
然而,真正的考验在于:这些丰富的语义是否能转化为生成优势? 为此,研究团队在固定生成骨干、潜在token数量和训练设置的前提下,仅替换底层自编码器。结果显示,所有四种V-RAE变体在UCF101和Kinetics-600上均带来显著的生成性能提升。最佳模型在UCF101上gFVD(generation FVD)达117.86,在K600上为19.16。更令人惊讶的是训练效率:在UCF101上,V-RAE仅需约3万次更新即可达到传统VAE约15万次更新的生成水平;在K600上,最高观察到6倍的收敛加速。这一现象揭示了一个深层机制:传统VAE的潜在空间虽能重建像素,但其组织方式仍以低层视觉特征为主,生成模型需额外学习高层语义结构;而V-RAE的潜在空间已显式编码了视觉状态,使生成模型能直接建模状态间的转移规律,而非像素的逐帧变化。
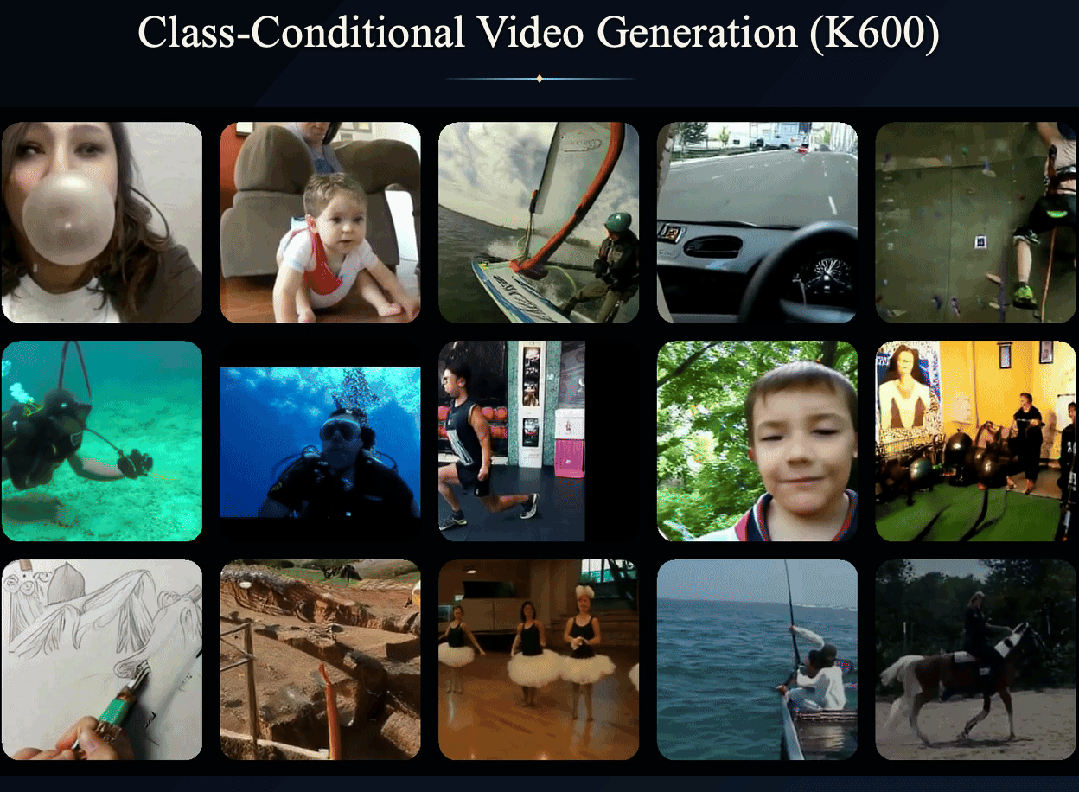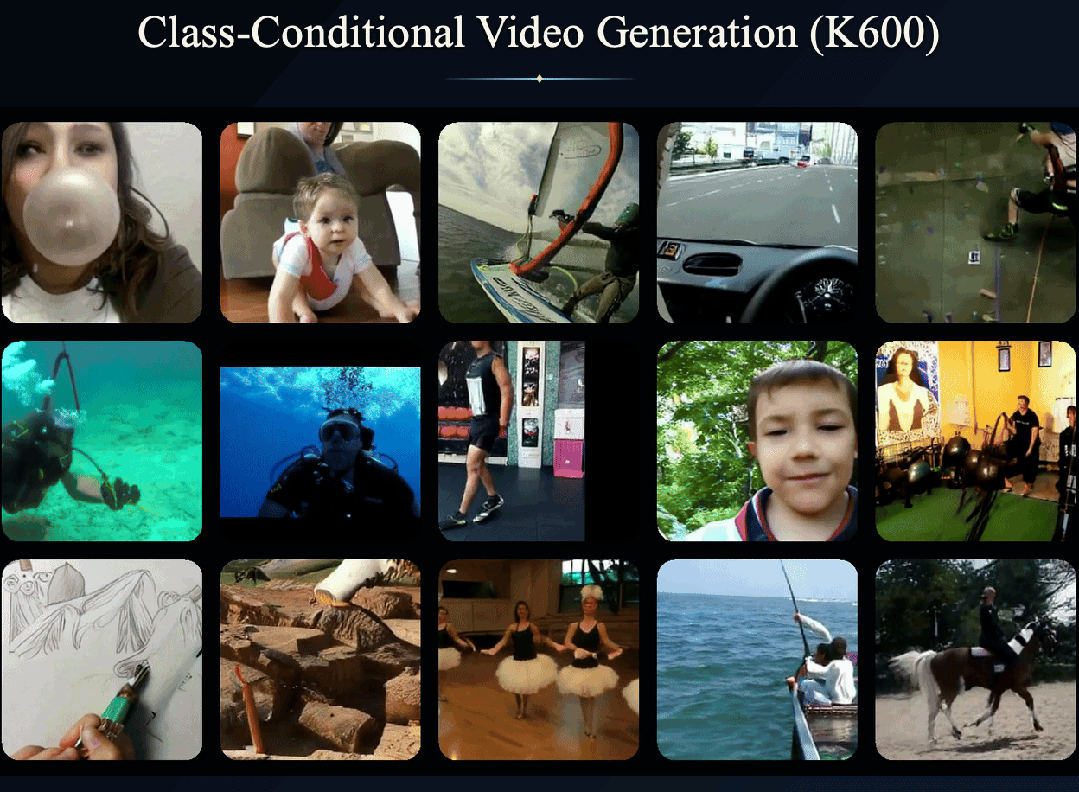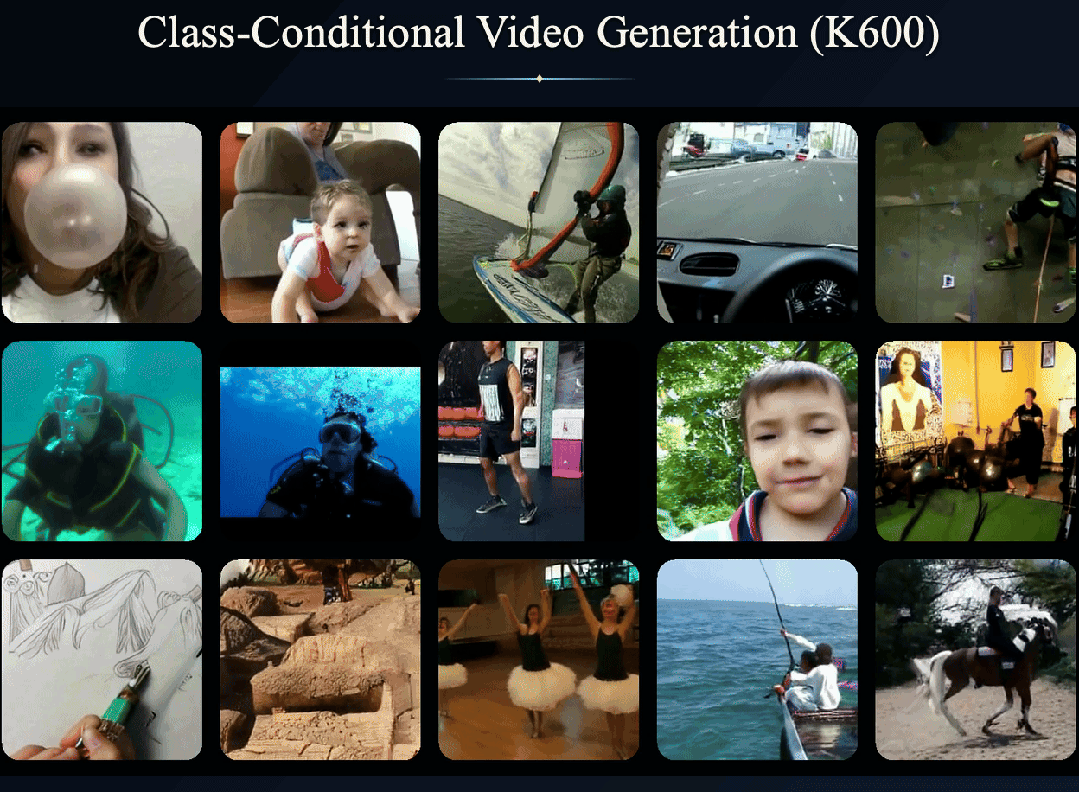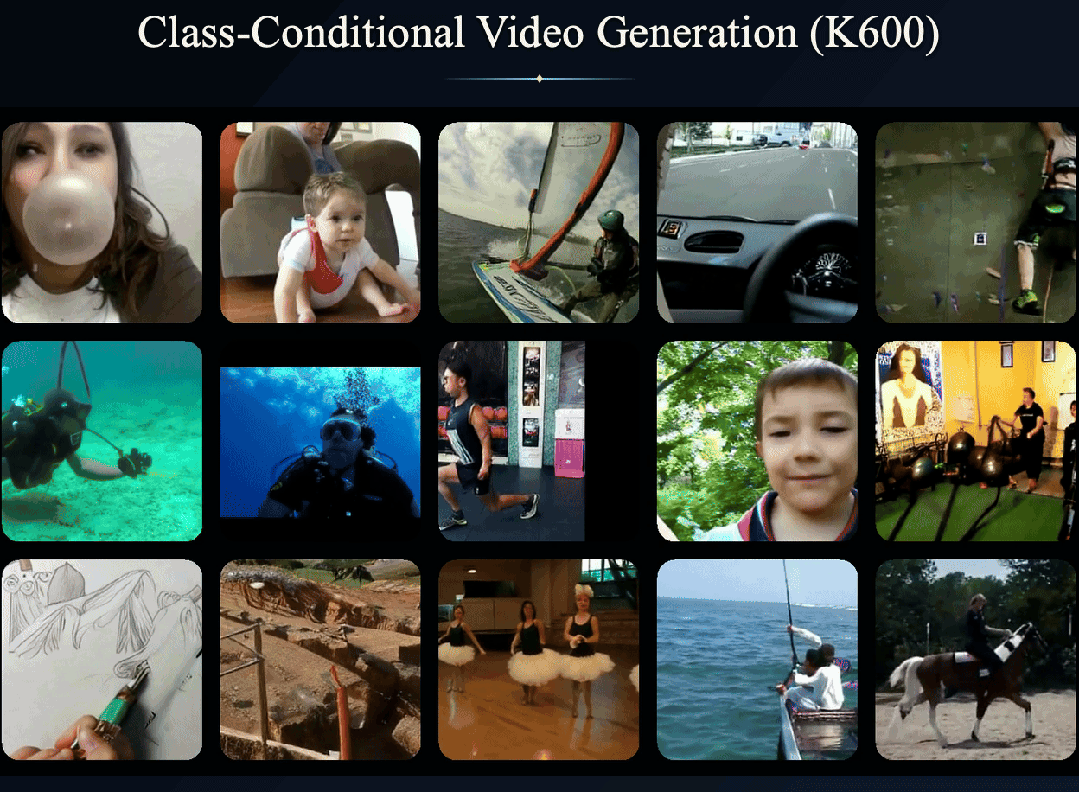
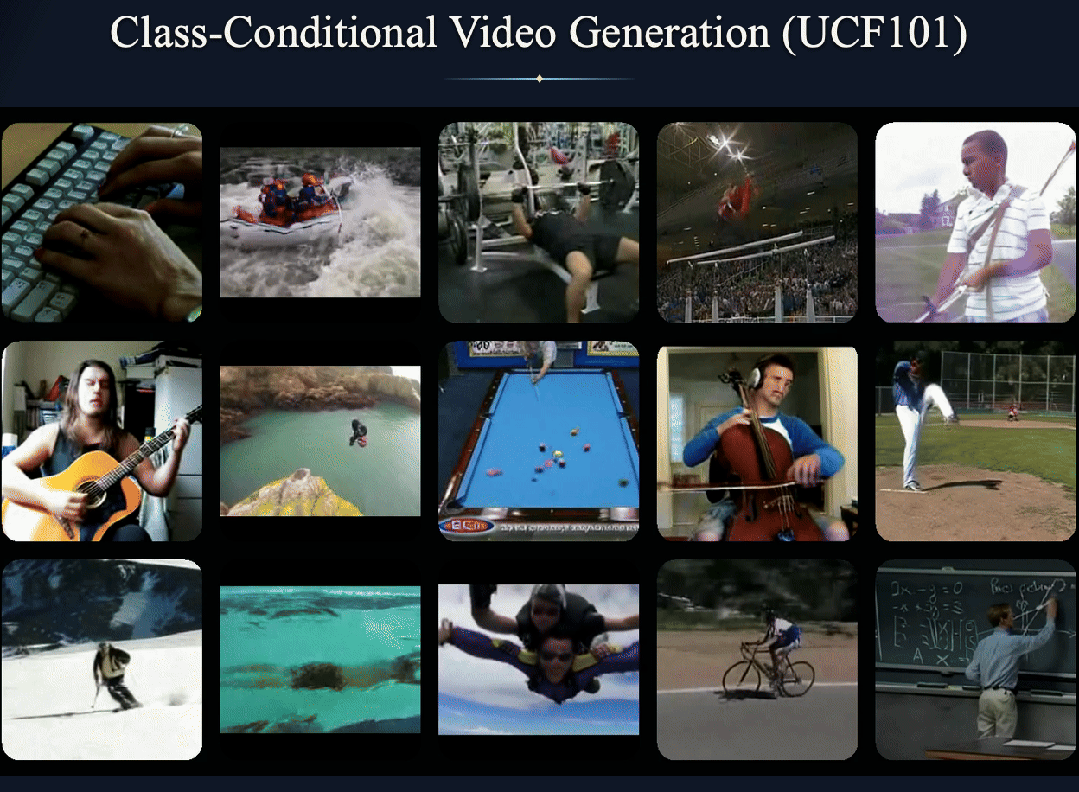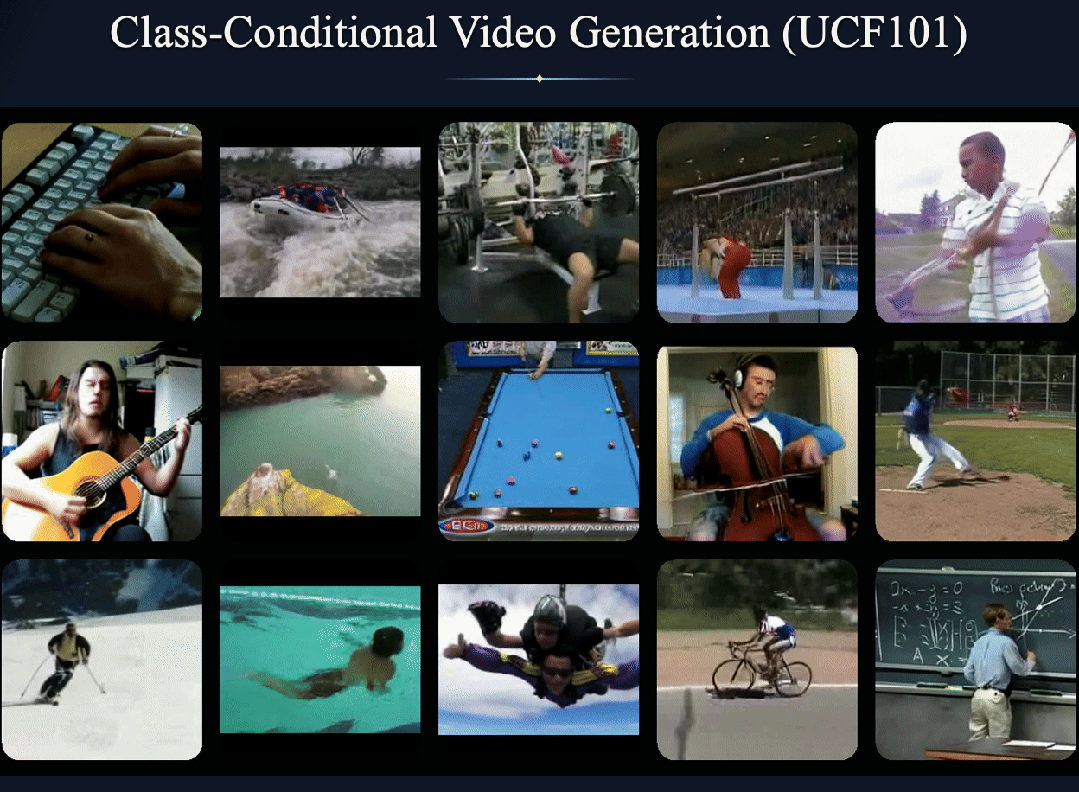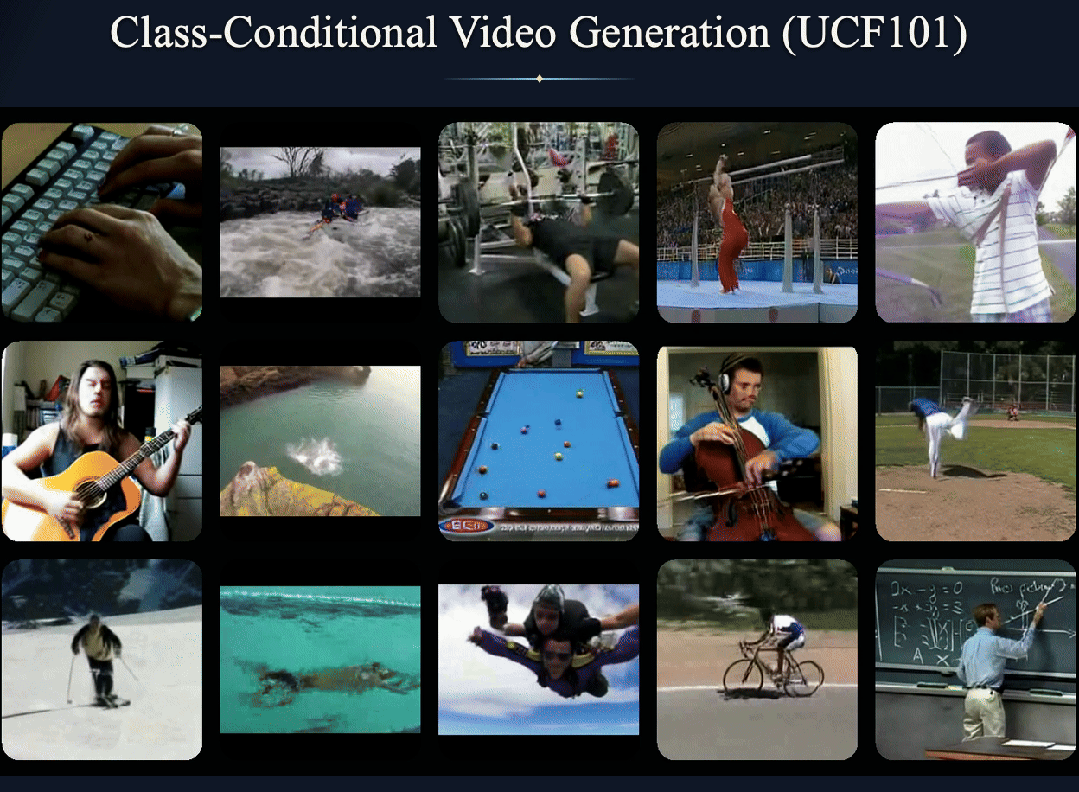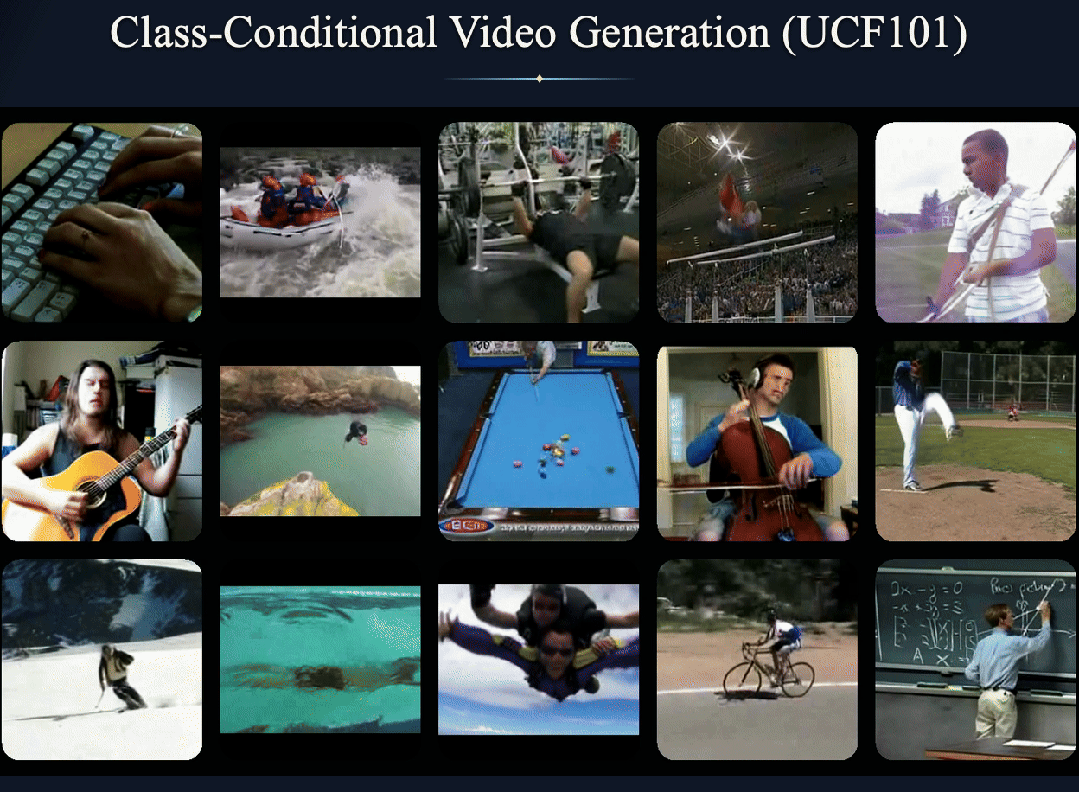
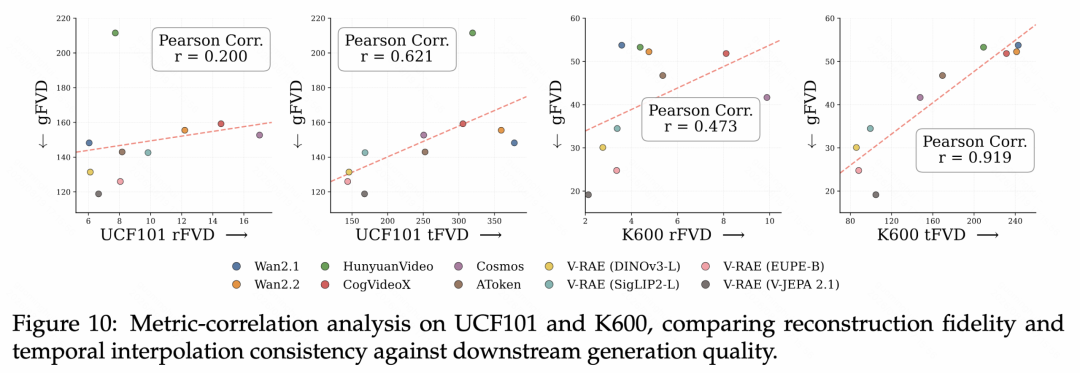
这一发现引出了一个颠覆性观点:良好的重建能力并不等同于良好的生成能力。实验数据显示,不同自编码器的rFVD与其下游生成质量的相关性极弱——在UCF101上相关系数仅0.200,K600上为0.473。这意味着,一个擅长重建真实视频的潜在空间,可能对生成任务而言反而是“困难”的。原因在于,生成模型在推理时无法精确命中真实数据对应的潜在轨迹,其预测必然存在偏差。若潜在空间缺乏平滑性,微小的预测误差在解码后会被放大,表现为鬼影、闪烁或结构漂移等 artifacts。
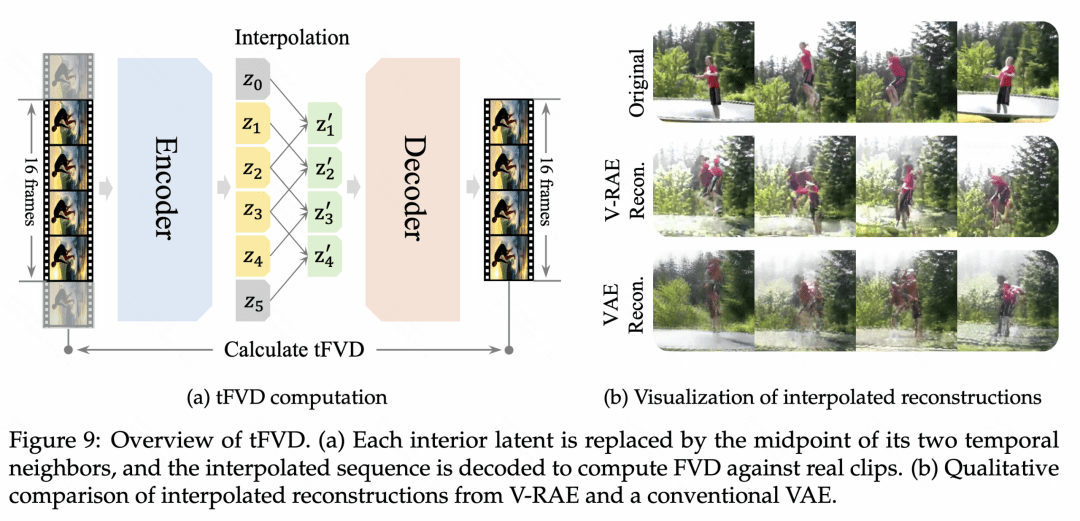
基于此,研究团队提出了新评估指标——tFVD(temporal FVD)。其核心思想是在时间相邻的潜在点之间进行局部插值,主动构造轻微偏离真实轨迹的潜在表示,并评估解码视频的自然性与连续性。tFVD不再仅测试对真实数据点的重建能力,而是衡量潜在空间的时间平滑性与解码器对生成误差的鲁棒性。实验结果令人信服:tFVD与实际生成质量的相关系数在UCF101和K600上分别达到0.621和0.919,远高于传统重建指标。这为潜在空间设计提供了新准则:一个好的视频潜在空间,不仅应准确表示已发生的视频,更应使不同视觉状态间形成连续、可预测的流形结构。
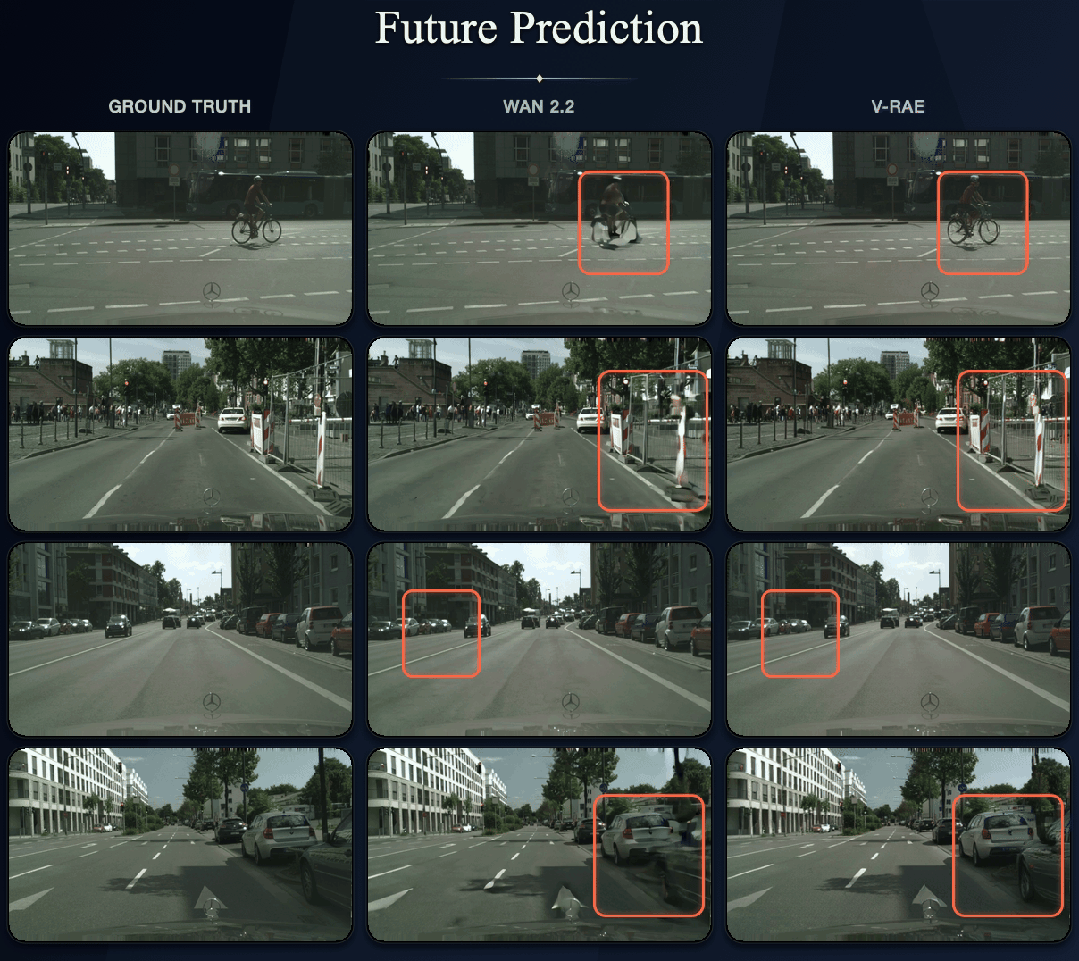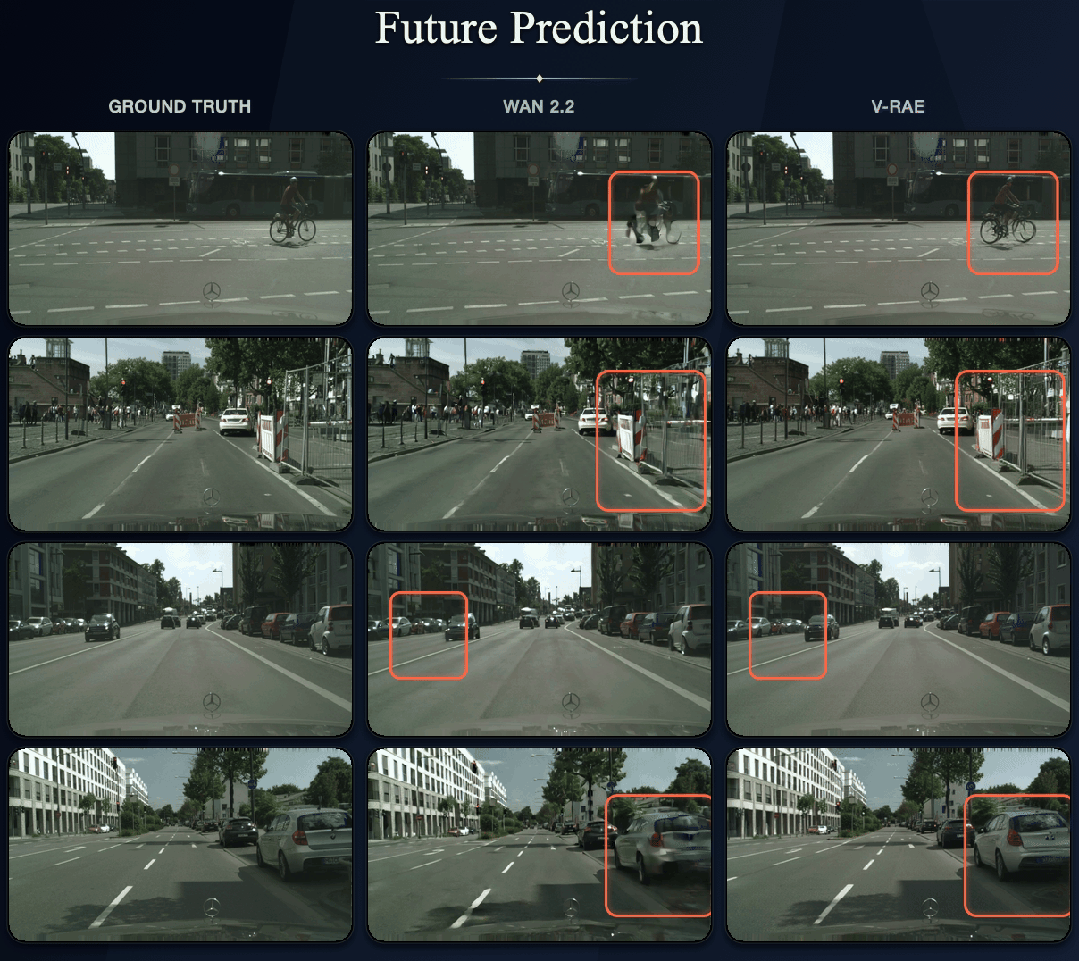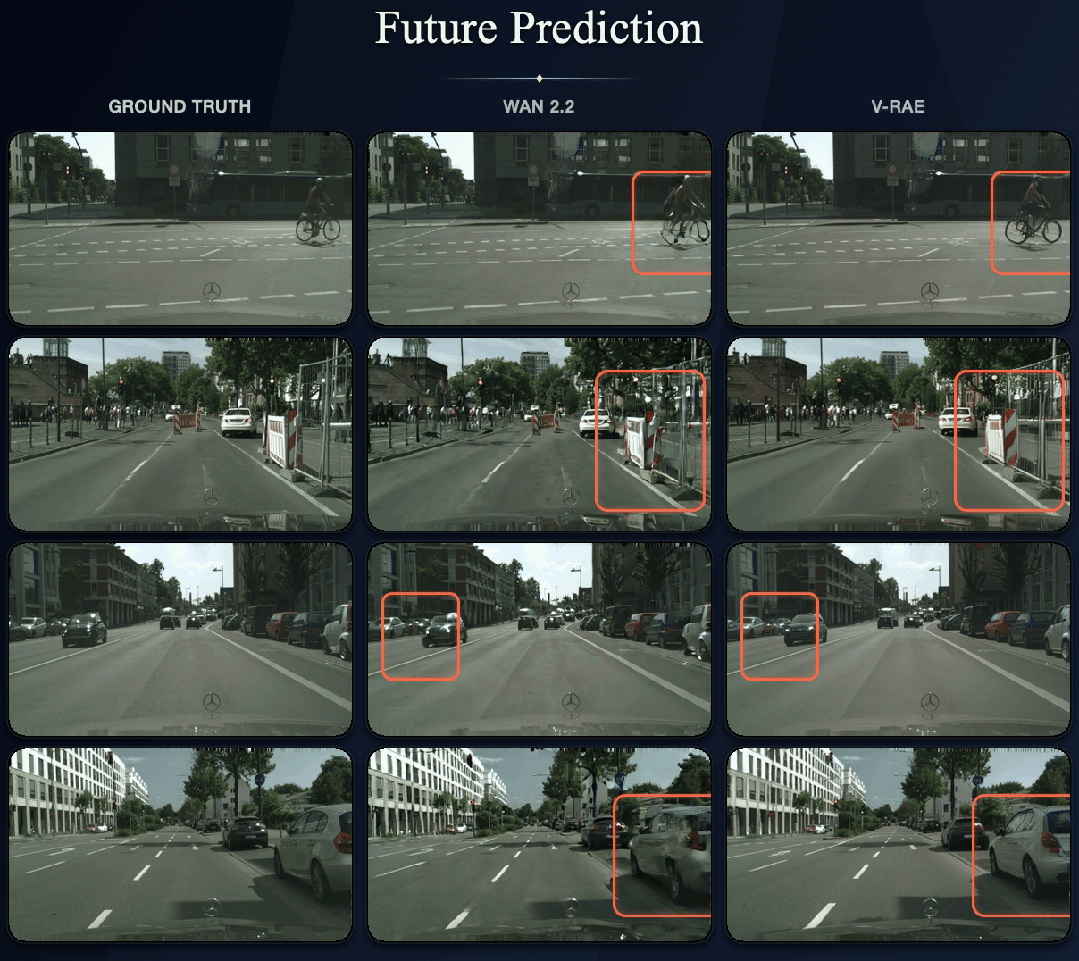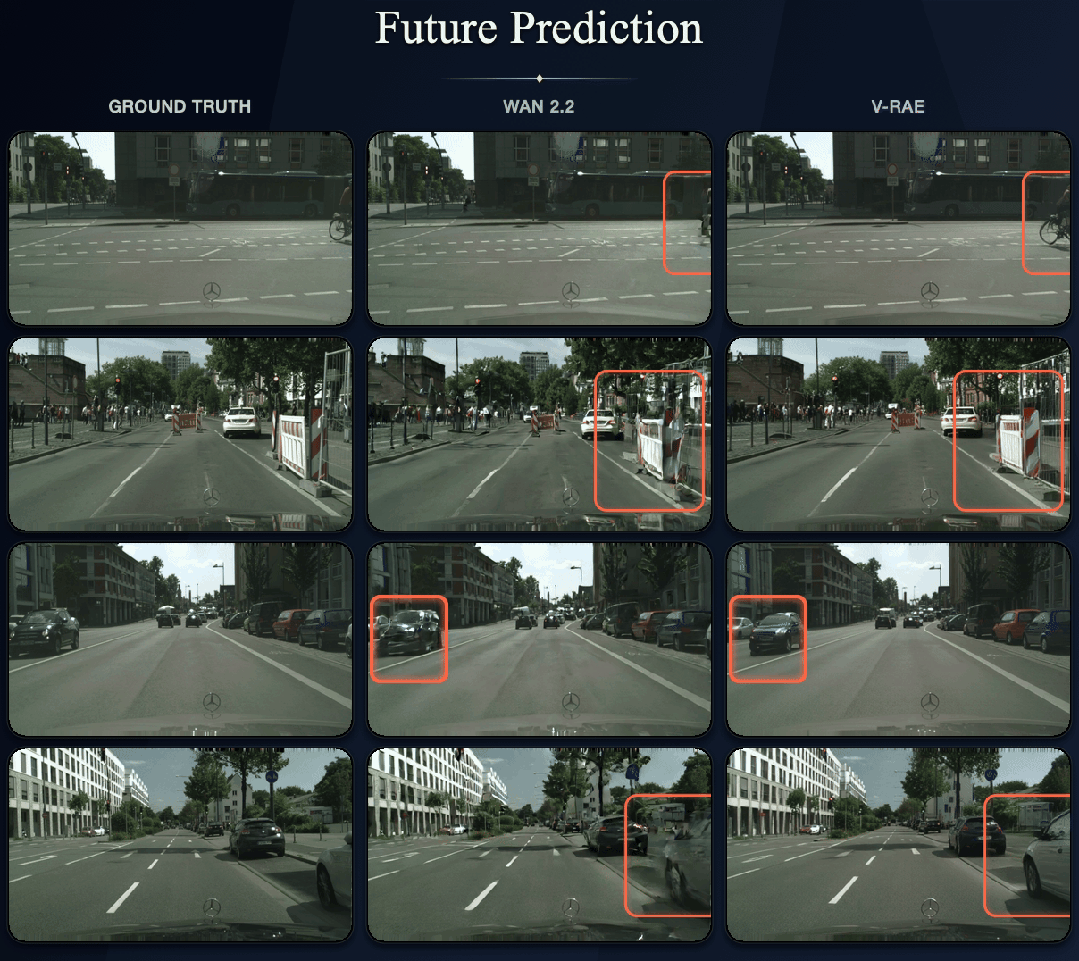
为进一步验证V-RAE的泛化能力,研究将其应用于未来视频预测任务。在Cityscapes数据集上,采用完全相同的预测架构和训练预算,V-RAE将gFID从传统VAE的15.02降至11.52,gFVD从144.47降至111.36。值得注意的是,V-RAE在此任务中的重建rFVD反而更差,但未来预测性能却显著更优。这一看似矛盾的现象恰恰印证了核心论点:对于预测性建模而言,像素级重建并非目标,一个语义清晰、时间平滑、易于外推的状态空间才是关键。在V-RAE框架下,同一个潜在接口可无缝连接视觉理解、状态预测、视频生成与像素解码,形成端到端的视觉世界模型。
综上所述,V-RAE的意义远不止于将图像RAE扩展至视频。它通过系统性实验揭示了视频潜在空间设计中的多个关键洞见:首先,预训练视觉表征可有效承载视频的时空语义,即使经过压缩仍保留丰富结构;其次,语义化的潜在空间能显著提升生成质量与训练效率;再次,重建质量并非生成性能的可靠代理,时间平滑性与预测鲁棒性更为关键;最后,该范式在无条件生成与条件预测任务中均具优势,展现出作为通用视频接口的潜力。这些发现共同指向一个根本性转变:视频自编码器不应仅被视为压缩模块,而应被重新定义为生成任务的“坐标系设计者”。未来的视频生成系统,或许不再追求将过去重建得更精确,而是致力于构建一个让未来更容易被想象与生成的潜在空间。