AI基础设施转向Agent时代:NVIDIA Vera Rubin如何重构计算架构?
近年来,人工智能基础设施的竞争焦点长期集中在GPU性能上。更大的模型参数量、更强的推理能力推动数据中心不断堆叠高性能GPU,形成以算力密度为核心指标的发展路径。然而,随着AI Agent开始承担复杂任务链——如自主编程、多步骤决策、工具调用与数据处理——传统计算架构暴露出明显局限性。
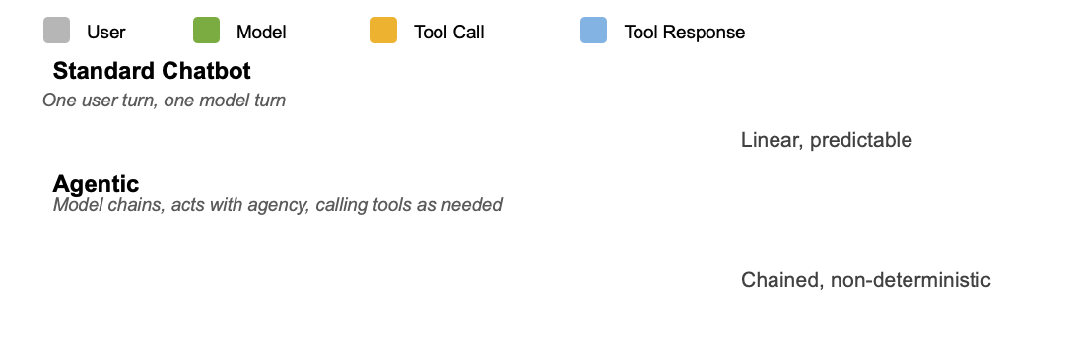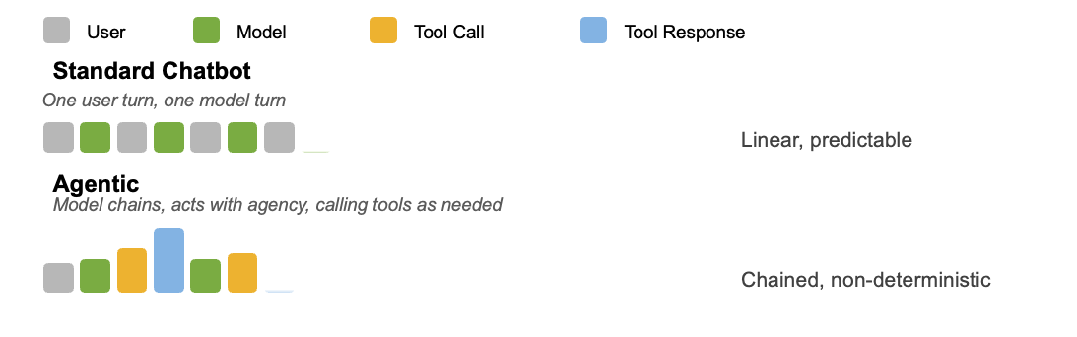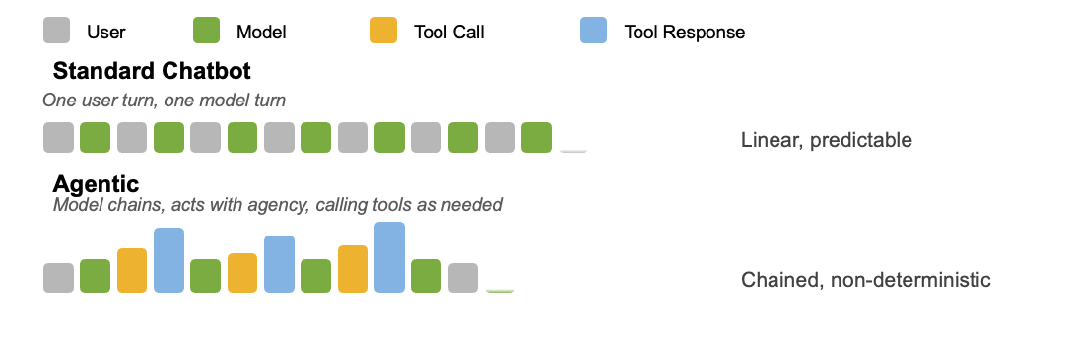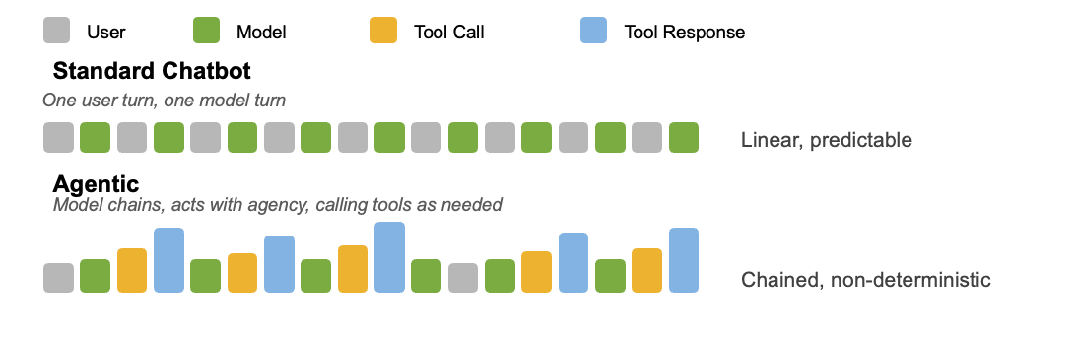
根据NVIDIA引用的OpenRouter真实流量数据,当前AI请求的平均Prompt长度已增长约4倍,单次Agentic请求消耗的token数量最高可达普通聊天请求的15倍。这种变化意味着,AI系统不再仅需“一次性”完成高质量推理,而是要在长时间任务中维持上下文连贯性、高效调度资源并持续生成有效输出。这一转变催生了对新型计算基础设施的迫切需求。
异构架构:从单一GPU到Agent专用计算工厂
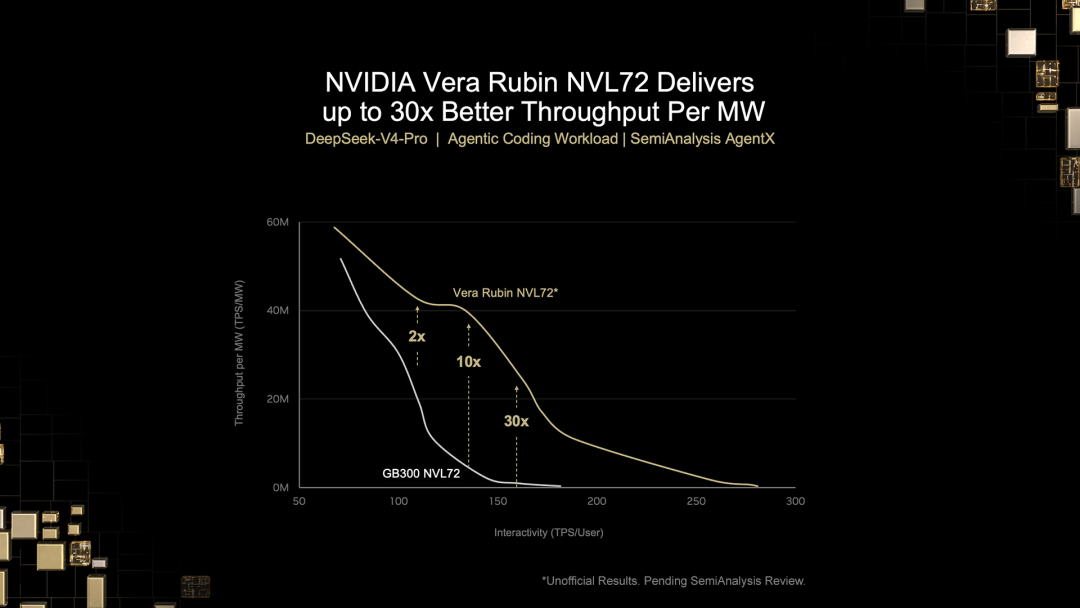
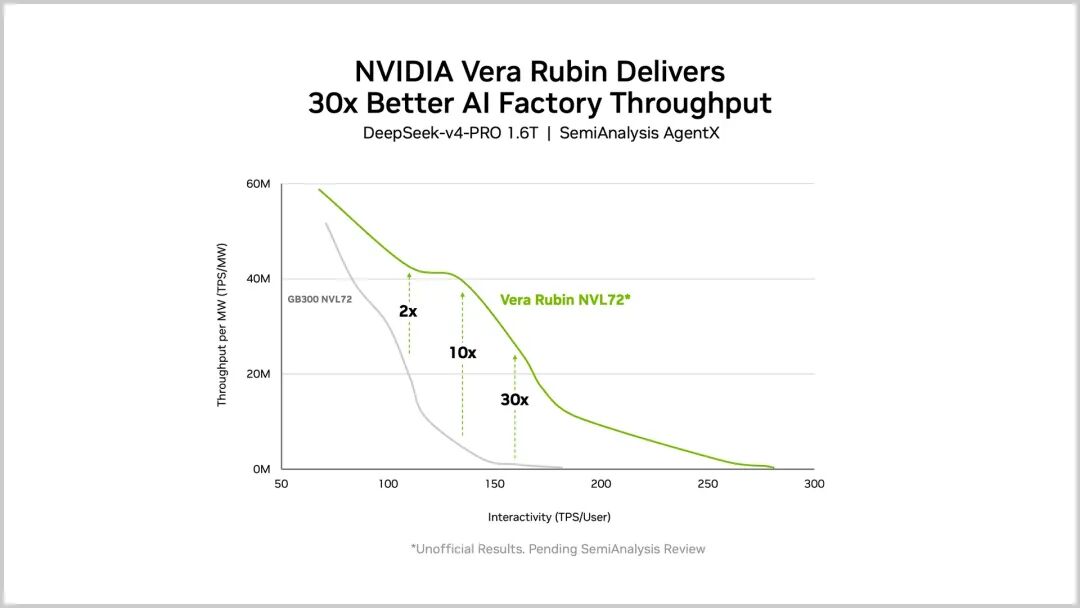
NVIDIA最新公布的Vera Rubin NVL72平台标志着AI基础设施进入新阶段。在基于SemiAnalysis开发的AgentX工作负载测试中,该平台相较上一代GB300 NVL72实现了每兆瓦吞吐量最高30倍的提升,同时将每个token的处理成本降低达35倍。这一突破并非单纯依赖GPU升级,而是源于整套rack-scale系统的协同优化。
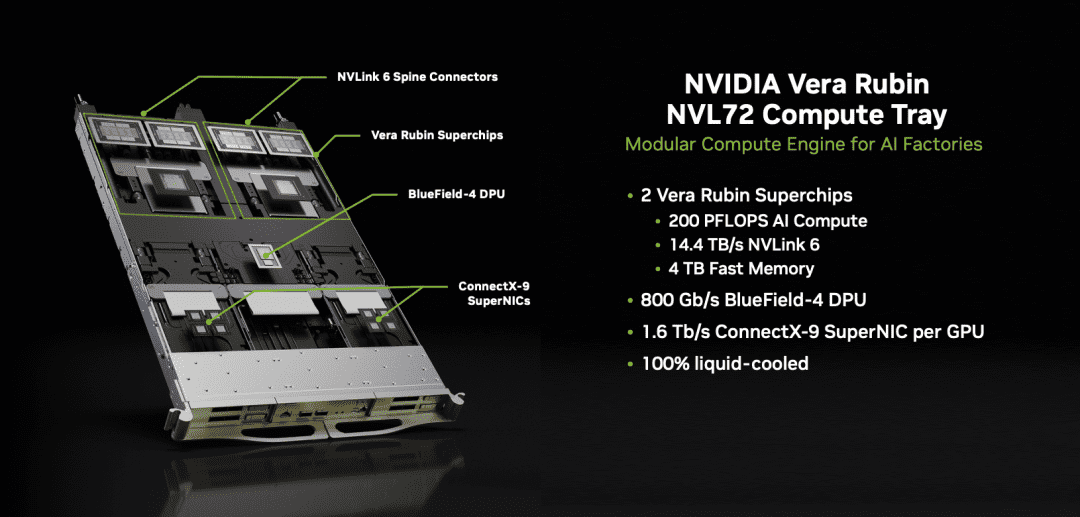
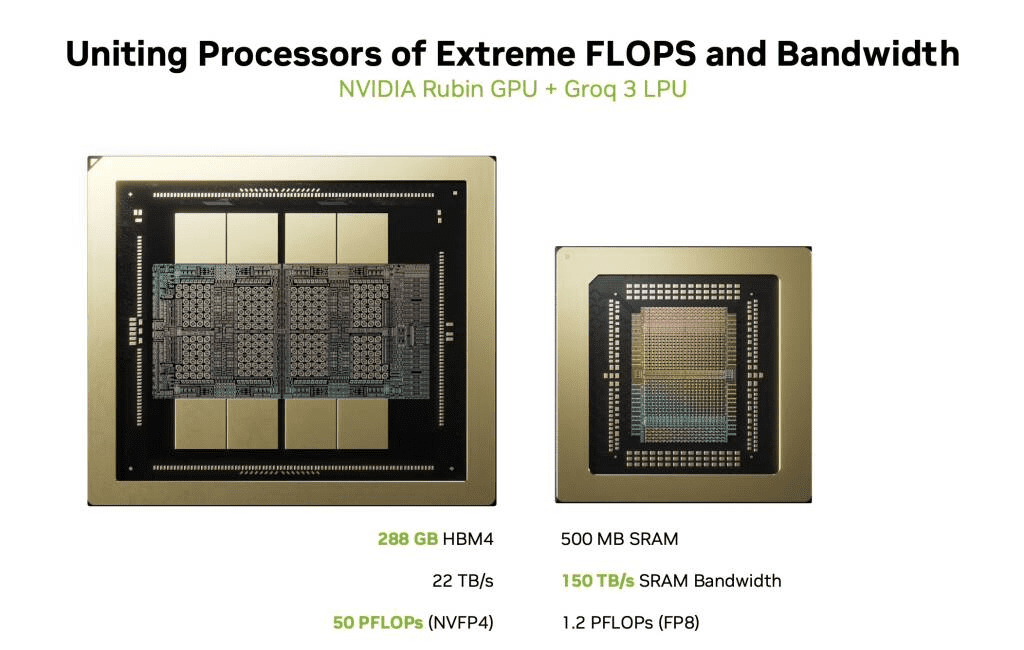
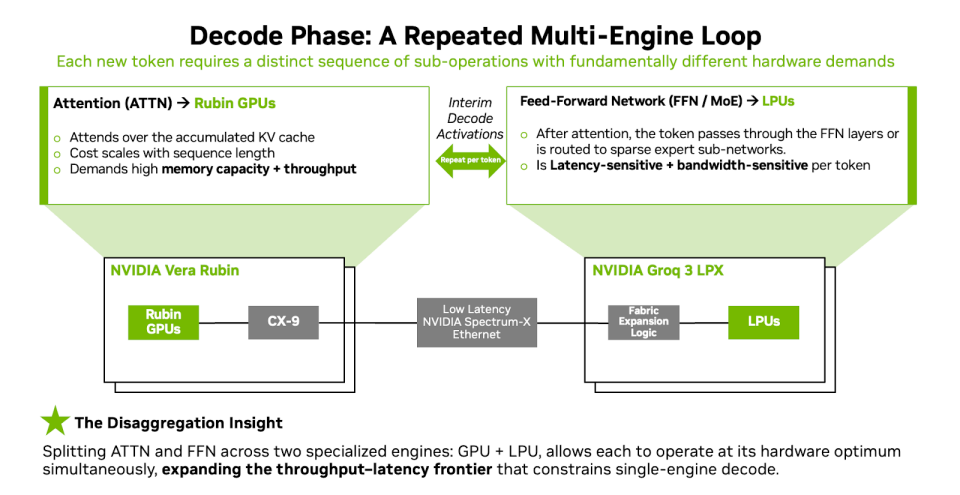
Vera Rubin的核心创新在于构建了一个面向Agent特性的异构计算体系。其中,Rubin GPU继续承担大规模Transformer计算,配备288GB HBM4高带宽内存(带宽达22TB/s);新推出的Vera CPU则专为任务编排设计,集成88个Olympus核心与1.2TB/s LPDDR5X内存带宽,负责代码执行、工具调用及数据预处理;而新增的Groq 3 LPX加速器则聚焦低延迟token生成,特别适用于Decode阶段的高交互场景。
这种分工明确的架构解决了Agent运行中的关键矛盾:长上下文处理需要高吞吐内存与并行计算能力,而实时响应则要求极低的单token延迟。通过将不同计算阶段分配给最适合的处理器,系统整体效率显著提升。例如,在Gemma 4 31B模型、10万token上下文的测试中,Groq 3 LPX实现了3431 output tokens/s的生成速度,远超传统GPU在相同条件下的表现。
KV缓存管理:决定Agent效率的关键技术
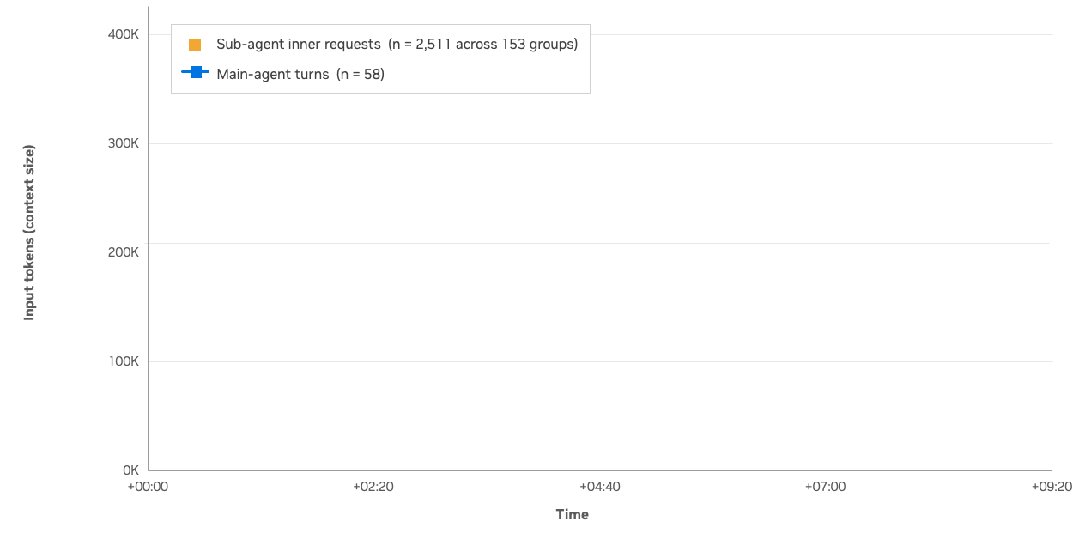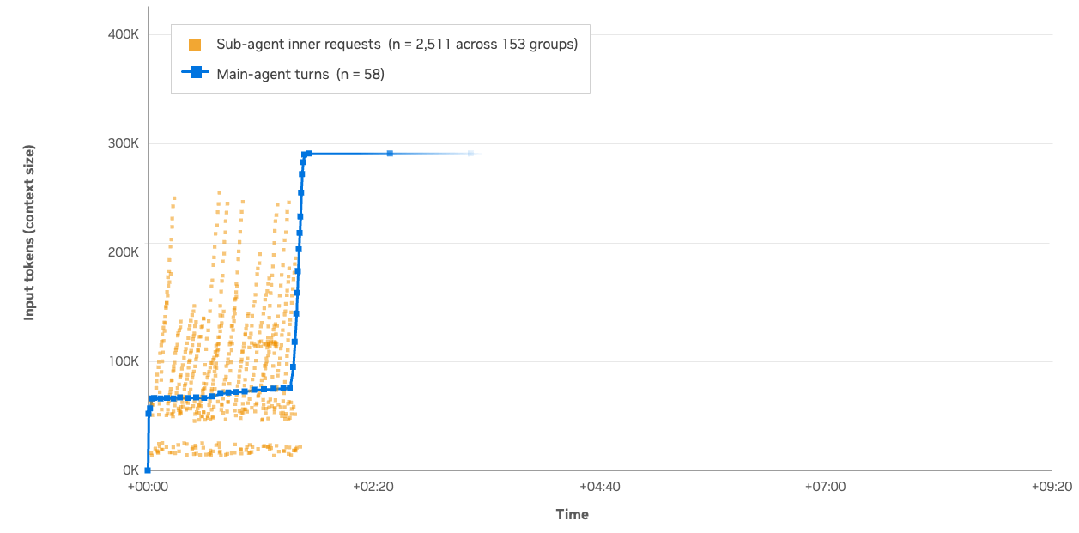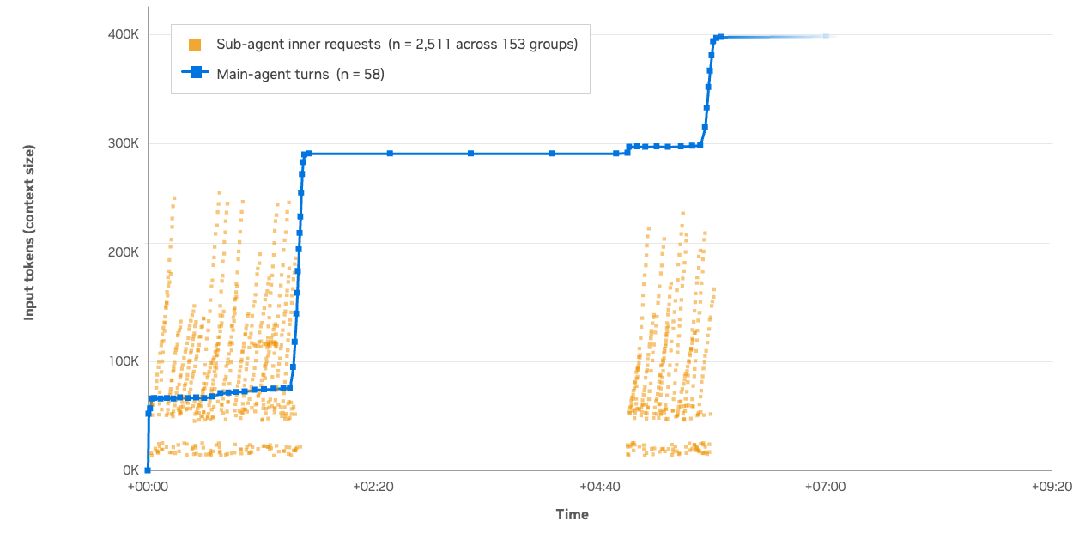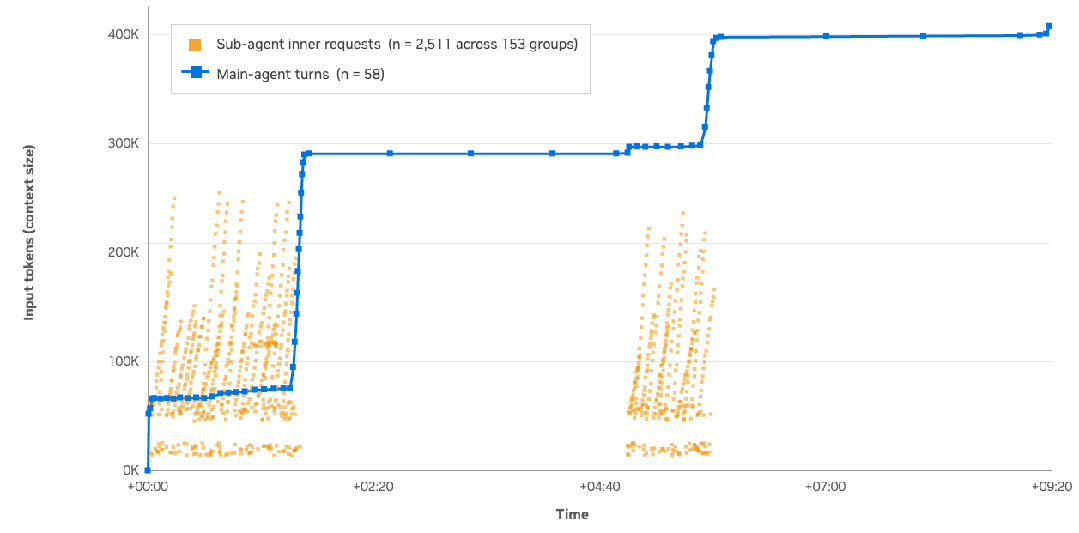
Agent会话的一个显著特征是上下文动态增长。NVIDIA展示的真实轨迹显示,主Agent的上下文可从6万token扩展至近40万token,并伴随多个子Agent请求。在此过程中,KV Cache(键值缓存)的管理成为影响性能的核心因素。
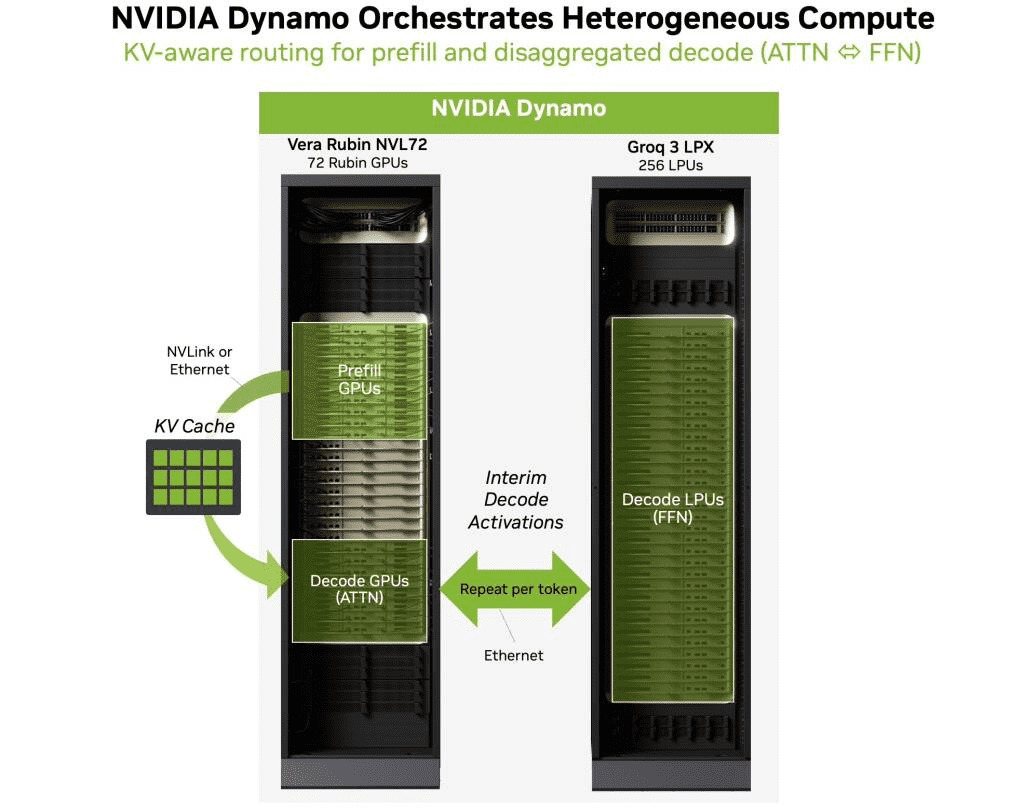
传统推理系统在每次新请求到来时往往需要重新加载整个上下文,导致大量重复计算。Vera Rubin引入的KV-aware routing机制改变了这一模式:系统会优先将新请求路由至已存储对应上下文缓存的GPU节点,避免冗余Prefill操作。对于持续增长的长上下文而言,这种缓存复用策略直接决定了吞吐量、延迟和能耗效率。
此外,Distributed KV Cache与KV Cache offloading技术进一步优化了内存使用。前者允许在72颗GPU组成的NVL72机架内分布式存储缓存,后者则支持将部分缓存卸载至高速存储层,在保证访问速度的同时缓解显存压力。配合NVLink 6提供的3.6TB/s双向scale-up带宽,整个系统能在统一地址空间内高效交换上下文状态与MoE专家参数。
软件栈的革新同样关键。Prefill/Decode分离架构使系统可根据任务阶段动态分配计算资源——Rubin GPU专注处理包含数十万token的Prefill阶段,而Groq 3 LPX则接管后续的连续token生成。这种流水线式处理大幅提升了硬件利用率,尤其在高并发Agent场景下优势明显。
轨道计算:极端环境下的架构验证
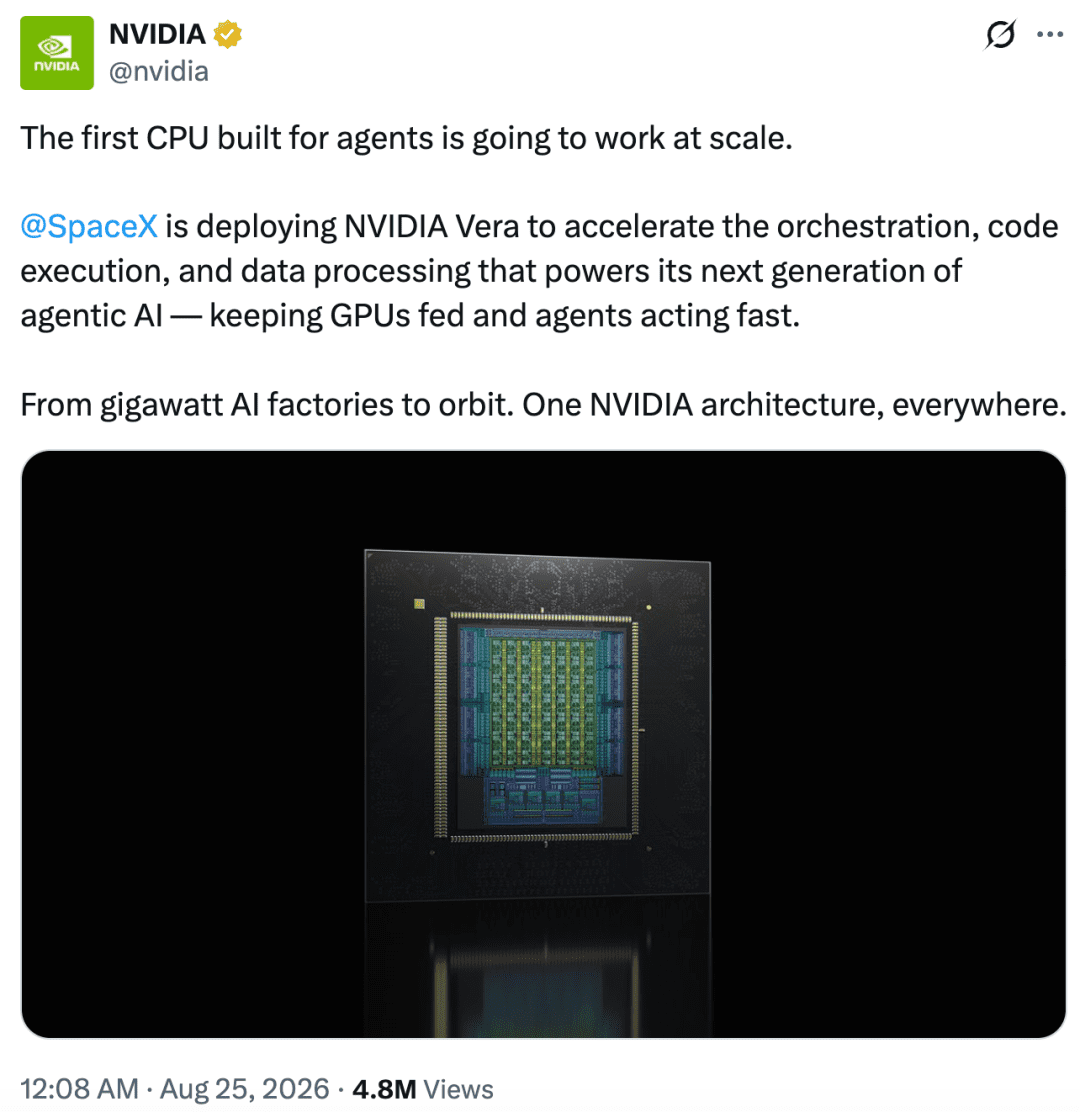
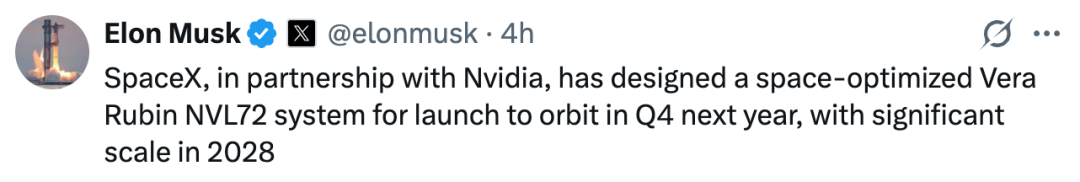
Vera Rubin的应用边界正被推向更极端的环境。SpaceXAI宣布将部署Vera CPU用于加速Grok模型的Agentic应用,并计划基于Rubin架构构建吉瓦级AI基础设施。更具突破性的是,双方已联合设计适用于太空环境的Vera Rubin NVL72系统,预计2025年第四季度首次发射入轨,2028年实现规模化部署。
轨道计算对硬件提出严苛要求:能源极度受限、散热条件恶劣、必须具备长期无人维护的可靠性。将地面AI工厂迁移至太空并非简单复制,而是需要在保持软件生态统一的前提下重构硬件设计。例如,Vera CPU的高能效比特性在此场景中尤为关键——其专为任务调度优化的架构可在有限功耗下维持Agent持续运行,避免频繁唤醒高功耗GPU。
这一探索不仅验证了Vera Rubin架构的适应性,更预示了未来AI基础设施的分布式演进方向。当地面数据中心与轨道计算节点形成协同网络,Agent或将具备跨域执行任务的能力——如实时处理卫星遥感数据、自主规划深空探测路径等。这种“天地一体”的计算范式将进一步模糊传统云计算与边缘智能的边界。
行业影响:AI竞争规则的根本性转变
Vera Rubin的推出标志着AI产业竞争逻辑的深层变革。过去,胜负手在于谁拥有更强的大模型;如今,优势更多取决于谁能构建高效支撑Agent持续行动的基础设施。这种转变带来三重影响:
首先,硬件厂商的角色从“算力供应商”升级为“系统架构定义者”。NVIDIA通过整合CPU、GPU、LPU及高速互联技术,实际上在定义下一代AI工厂的标准形态。其他厂商若仅聚焦单一芯片性能,恐难跟上系统级创新的步伐。
其次,能效比成为核心指标。30倍的每兆瓦吞吐提升意味着,在相同电力预算下可服务数十倍的Agent用户。对于追求规模化的云服务商而言,这直接关系到运营成本与商业可行性。未来数据中心选址或将更注重能源获取成本与散热条件,而非单纯追求网络延迟。
最后,软件生态的重要性空前凸显。无论硬件如何异构,统一的编程模型与调度框架才是释放性能的关键。NVIDIA通过CUDA-X AI、Triton推理服务器等工具链,确保开发者能无缝利用Vera Rubin的全栈能力。这种软硬协同的护城河,可能比单纯的技术参数更具长期竞争力。
值得注意的是,第三方测试机构Artificial Analysis的独立验证增强了这些性能声明的可信度。在标准化benchmark之外,基于真实Agent行为的AgentX测试更能反映生产环境的实际表现。这也预示着未来AI基础设施评测将从静态指标转向动态工作负载模拟。
综合来看,Vera Rubin不仅是一次产品迭代,更是对AI基础设施范式的重新定义。当Agent成为主流交互形态,计算系统必须从“响应式推理引擎”进化为“持续行动平台”。这场变革中,胜出者将是那些能够统筹芯片设计、系统集成与软件生态的全栈玩家。而SpaceX的轨道计算计划,则为这一新范式提供了最具想象力的应用场景——未来的AI或许不仅存在于数据中心,还将遨游于星辰大海之间。