Zetta ζ突破物理智能体局限:清华AIR与域变换联合打造闭环自进化系统
传统端到端策略模型在物理世界应用中频繁遭遇挫折,这一现象揭示了当前AI系统在动态物理环境中执行复杂任务时的根本性缺陷。研究者们逐渐意识到,单纯依赖大模型智能体加工具调用的策略虽然在理论上可行,但在实际物理环境中仍然面临巨大挑战。真实物理环境的高速变化特性使得现有物理智能体只能在任务失败后进行事后复盘,而无法在执行过程中根据实时状态变化做出快速判断、纠错和学习调整。
面对这一技术瓶颈,清华AIR与域变换联合推出了革命性的Zetta ζ系统,通过构建演进可高频执行的critics机制,成功闭环了物理智能体的在线学习过程。这一创新不仅让机器人摆脱了仅能事后总结失败的局限,更重要的是使其具备了在执行过程中持续观察环境、触发恢复机制并将rollout经验沉淀为可复用技能的能力。
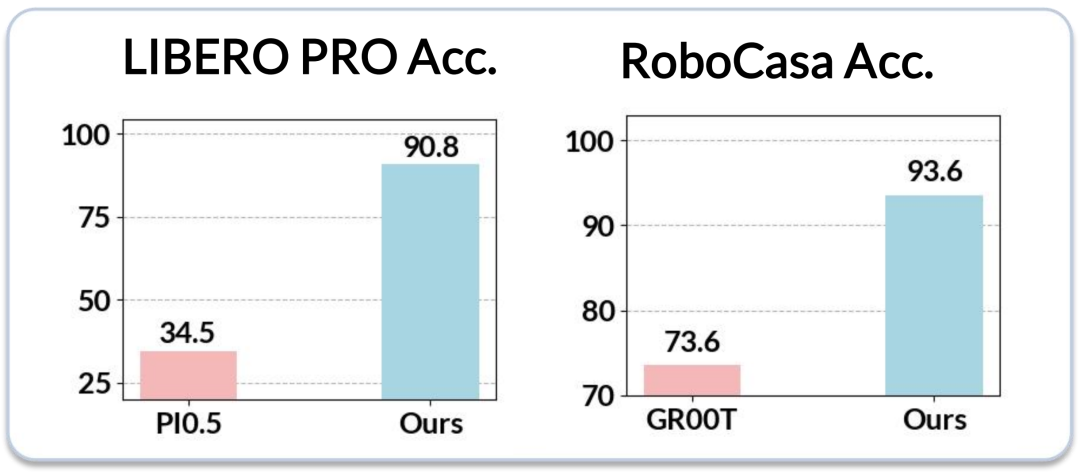
实验数据充分验证了Zetta ζ的卓越性能表现。该系统在任务成功率方面展现出随自探索经验持续提升的显著趋势,在有限rollout预算条件下,LIBERO PRO和RoboCasa分别取得了90.8%和93.6%的成功率,这一成绩远超现有其他方法。更为引人注目的是,研究者成功捕捉到了机器人的'Aha Moment'现象,这一发现为物理智能体scaling intelligence开辟了全新的研究起点。
传统的机器人失败场景往往源于系统设计的根本缺陷。以日常生活中常见的拿取水杯任务为例,尽管物理智能体系统能够理解指令并做出看似合理的抓取动作,但在实际执行过程中仍会出现各种问题。抓取力度过大导致水杯损坏、接近目标时姿态偏差无法准确放置、智能体缺乏在线反馈机制无法及时调整等问题频发。这些问题的根源在于现有具身智能系统大多采用静态开环设计,虽然能够执行固定技能,却难以在物理执行过程中实时感知异常、主动修复并转化失败经验为下次可复用能力。
物理世界的动态变化特性与大模型反思的滞后性形成了根本矛盾。智能体无法在线测试备选动作来验证反思结果的正确性,对完整轨迹进行信用分配存在较大难度,同时回溯分析往往无法获取故障发生瞬间的精确状态信息。Zetta ζ正是为了解决这一核心问题而设计。
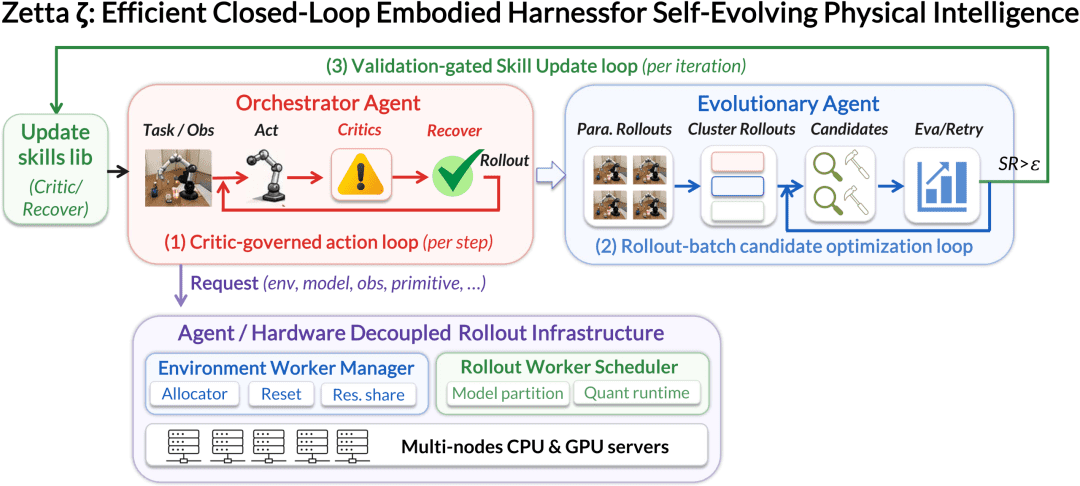
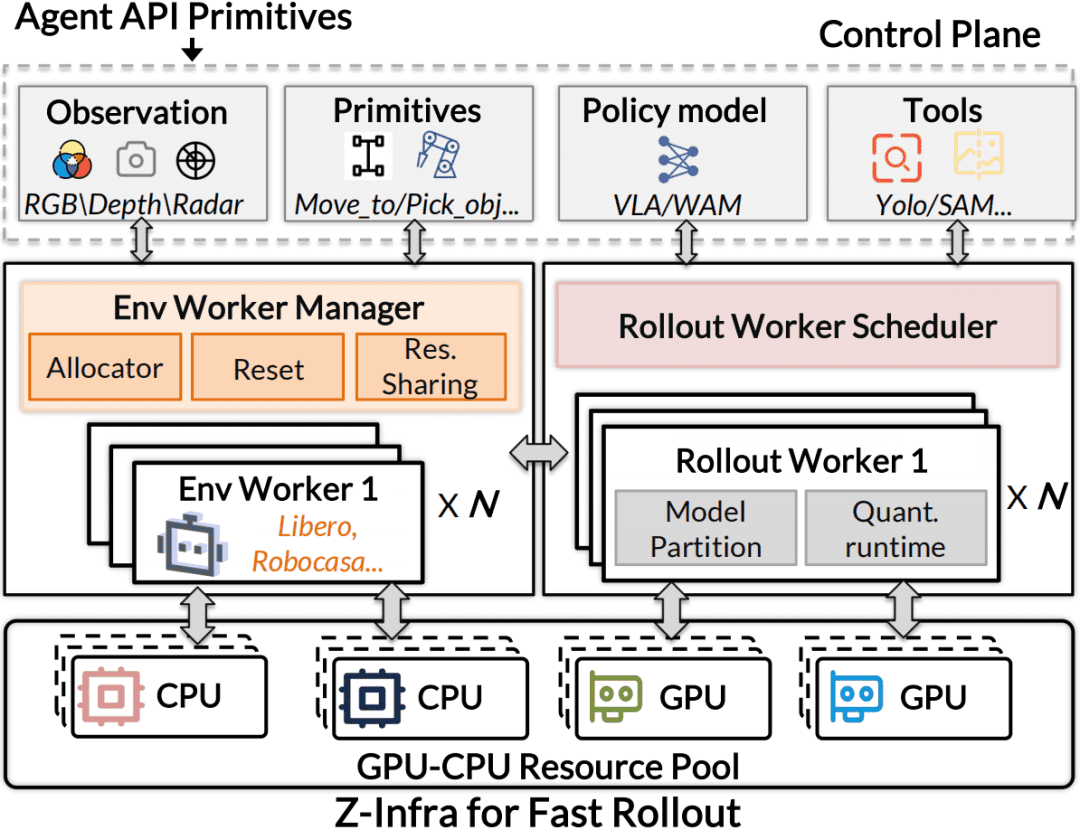
Zetta ζ作为闭环在线学习自进化物理智能体,具备监督机器人每一步动作执行、根据反馈生成下一步执行方案、渐进式学习监督和恢复技能、提炼可泛化可复用成功经验的核心能力。该系统让智能体能够持续改进,实现越做越好的良性循环。为了进一步加速进化过程,研究团队还专门开发了Z-Infra系统,这是首个专为物理智能体设计的rollout系统,通过解耦智能体和底层硬件,在各类异构设备上高效管理调度环境、模型、工具等资源需求,使自进化过程更加高效、经济且具备良好的可扩展性。
Zetta ζ的创新核心体现在三个不同时间尺度的闭环机制,这些闭环共同构成了强大的自进化飞轮系统。第一个闭环是Critic-Governed Action Loop,即动作级闭环。在动作执行频率层面,Zetta ζ的运行时批评者持续监控机器人的物理状态,一旦检测到异常情况如抓取滑落、接触丢失、运输停滞等,系统会立即触发恢复动作,而非等待整个episode失败后再进行反思。恢复完成后,系统还会执行严格的VLA Re-entry Contract验证,确保故障已清除且物理状态恢复稳定后才将控制权交还给原有VLA模型,这相当于为机器人配备了专业的在线监测安全员。
第二个闭环是Rollout-Batch Candidate Optimization Loop,即批量候选优化闭环。机器人完成一批任务后,Zetta ζ会对失败轨迹进行聚类分析和因果诊断。系统不仅关注任务最终是否成功,更重要的是精确定位最早偏离正常状态的时间点,并沿评估→批评者→状态表征→规划控制→恢复→参数的层级渐进式寻找真正需要修复的根因。随后,系统自动生成候选的critic、recovery和tool更新方案。
第三个闭环是Validation-Gated Skill Update Loop,即验证门控更新闭环。候选更新不能直接上线应用。Zetta ζ首先进行历史回归测试,然后在严格隔离的held-out数据上进行验证。只有那些真正提升成功率且能泛化到新场景的更新才会被写入技能记忆库,这一机制确保了机器人不会为了'背下某个失败样本'而出现过度拟合现象。
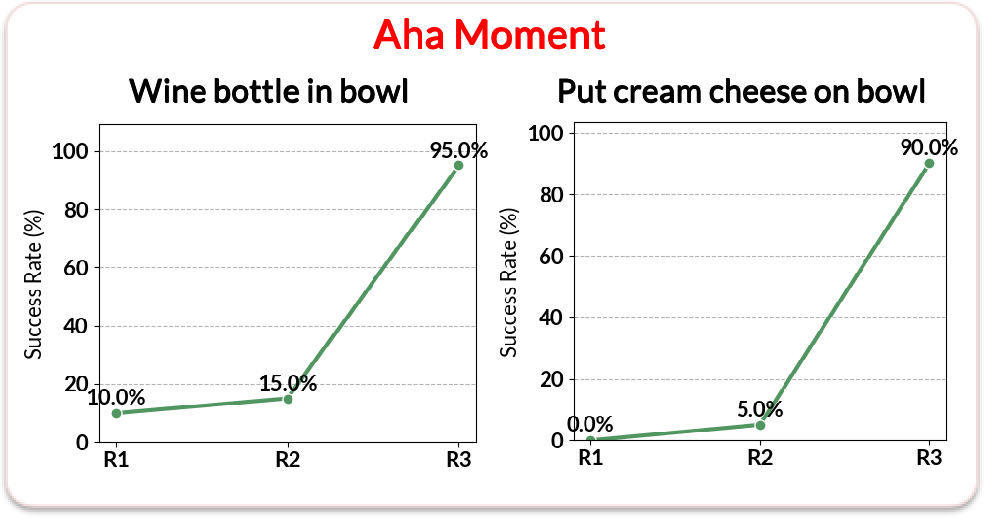
在Zetta ζ的进化过程中,研究者观察到了一个极其有趣且重要的现象:成功率并非呈现平滑上升趋势,而是先经历平台期,然后出现突然跃升。这种现象类似于人类解题时的突然顿悟,机器人同样会出现'Aha Moment'。在具体实验中,把酒瓶放进碗里的任务成功率从15%跃升至95%,把奶油奶酪放到碗里的任务成功率从5%跃升至90%。在RoboCasa具身基准测试中,开电水壶、推洗碗机抽屉、关烤箱门、放置咖啡壶等任务也表现出类似的跳跃式提升特征。
以放置咖啡杯任务为例,在Round0阶段,策略模型能够正确识别咖啡杯和咖啡机并开始执行运输操作,但在接近咖啡机时,由于缺少对抓取保持和碰撞间隙的持续检查,机械臂发生碰撞并丢失咖啡杯,策略模型未能及时识别这一局部物理异常,最终导致任务失败,此时成功率为70%。进入Round1阶段,Zetta ζ从失败中演化出接触感知操作skill,其critic持续监控抓取保持、物体漂移和碰撞风险,触发后recovery在保持安全间隙条件下运输咖啡杯,并在确认稳定放置后结束接管,成功率提升至86%。
在Libero-Pro具身基准测试中,推盘子到炉灶前任务同样展现了这一现象。Round0阶段遇到'抓住盘子后未保持抓取'的failure0而失败,成功率为0%。Round1阶段提出Critic1(retained-grasp)识别'盘子是否被稳定抓起',并用Recovery1(retained-object transport)接管搬运,解决failure0,但随后遇到'搬运过程中抓取丢失'的failure1而失败,成功率达到45%。Round2阶段在Critic1和Recovery1生效基础上,提出Critic2(carry-retention)识别'搬运中抓取抖动',并用Recovery2(robust-carry Retry)稳定抓取、降低搬运风险,解决failure1,最终成功,成功率提升至95%。
这些跃升并非通过训练模型、增加参数量或人为调参实现,而是Zetta ζ帮助机器人识别出决定成败的关键物理状态变量。例如运输前是否确认'抓取保持稳定'、接触目标时是否建立'足够稳定的物理接触'、接近目标前末端执行器是否处于VLA模型'熟悉'的几何范围内等。这些看似简单的发现,实际上是机器人从'偶尔成功'走向'稳定可靠'的关键分水岭。
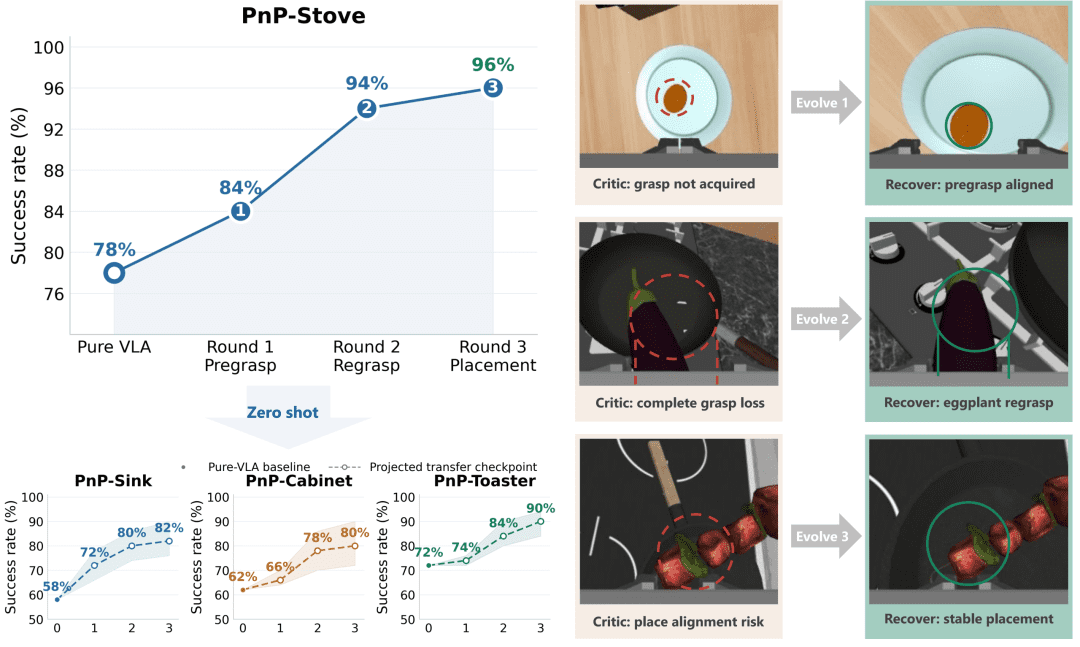
Aha Moment并非孤立的一次性突破现象。更值得关注的是,随着进化轮次不断增加,Zetta ζ的成功率呈现出持续、可复现的scaling趋势。在LIBERO-Pro测试中,纯VLA基线仅有34.5%的平均成功率,随着Zetta ζ不断积累Critic–Recovery,最终达到90.8%。在RoboCasa测试中,成功率从73.6%提升到93.6%。
每一轮进化都专注于识别并修复当前最主要的物理执行瓶颈,包括错误的接近几何、不稳定的抓取保持、过早释放、执行停滞或任务关系未完成等问题。随着这些'小机制'不断累积,机器人对物理世界的掌控力越来越强,任务成功率逐步逼近冻结VLA本身的能力上限。更为有价值的是,Zetta ζ学到的技能并非某个任务的'标准答案',而是具备可迁移性的物理能力。
在仿真基准测试中,Zetta ζ的表现远超现有方法。在LIBERO-Pro Goal测试中,平均成功率从34.5%提升至90.8%;在RoboCasa的18个Atomic-Seen任务中,平均成功率从73.56%提升至93.56%,绝对提升20个百分点,并且在接触丰富、长时程任务上提升尤为明显。这些提升全部来自执行系统的不断进化,且这些成果是在现有rollout迭代完成阶段取得的,预计持续的rollout将继续提升成功率。
Z-Infra作为Zetta ζ高效自进化的基础设施,发挥了重要作用。自进化需要大量rollout数据支持,环境是学习数据的重要来源,rollout运行速度直接影响进化效率。Z-Infra是首个面向自进化具身智能体的rollout基础设施,其设计理念是将'智能体逻辑'与'异构硬件资源'彻底解耦。
该架构分为三个层次:Control Plane负责统一调度、路由、生命周期管理;Environment Worker管理异构仿真环境、会话和物理状态;Rollout Worker负责VLA/WAM模型推理、动态batching、异步调度。Z-Infra还实现了模型分区部署,将VLM和Action Expert拆分成独立进程,配合CUDA IPC传输;量化插件按模块选择W8A8/W4A16/W4A8,平衡速度与成功率;资源共享组使多个仿真会话共享模型编译和渲染上下文,显著降低重复开销。
实际效果十分显著:有效rollout吞吐从1.7 episodes/min提升到35.1 episodes/min,提升20.6倍;对比HarnessVLA,吞吐提升12.8倍;单episode延迟降低11.9倍;π0.5模型分区部署后,平均推理延迟降低53%,goodput提升2.4倍。
Zetta ζ的价值在于提出了具身智能scaling的新路径。长期以来,具身智能的scaling思路主要集中在'堆数据、堆参数、堆算力训练更大模型',而Zetta ζ提出了另一条路径:不改变底层策略模型,而是持续进化其周围的执行系统。这一路径具有成本更低、部署更友好、持续进化、可迁移等显著优势。不需要反复训练微调大模型,可以在已有模型基础上直接增强可靠性,机器人可在部署后利用真实环境数据不断变强,一个任务上积累的物理技能可复用到相关任务。
这并不意味着端到端VLA/WAM不再重要,相反,Zetta ζ是在现有模型能力基础上,补上了物理世界最需要的'闭环治理能力'。研究团队计划将Zetta ζ规模化拓展到真实机器人领域,让真实机器人也能进行大规模并行rollout,弥合sim-to-real差距,将真实机器人作为Z-Infra中的'一等公民'工作节点。
从'事后反思'到'动作频率级闭环治理',从'静态执行'到'三环自进化',从'人工调试'到'自动发现物理瓶颈',Zetta ζ展现了具身智能进化的全新可能性。机器人同样拥有Aha Moment,而Zetta ζ的目标就是让这种顿悟和进化能够持续发生,为物理智能体的发展开辟了新的道路。