GLM-5.3发布:不换基座只炼后训,开源编程王座易主
智谱发布 GLM-5.3:不换底座、只炼后训,开源编程王座易主
智谱今日正式发布 GLM-5.3,与前代最大的不同在于——基座模型完全没变,提升全部来自后训练阶段的 Scaling。通过数十倍规模的长程任务环境、更丰富的环境类型以及超长的后训练时间,智谱在相同基座上把模型的智能上界显著抬高。公司内部评测显示,新模型的编程体感较 GLM-5.2 提升约 50%,一跃成为当前编程能力最强的开源模型。
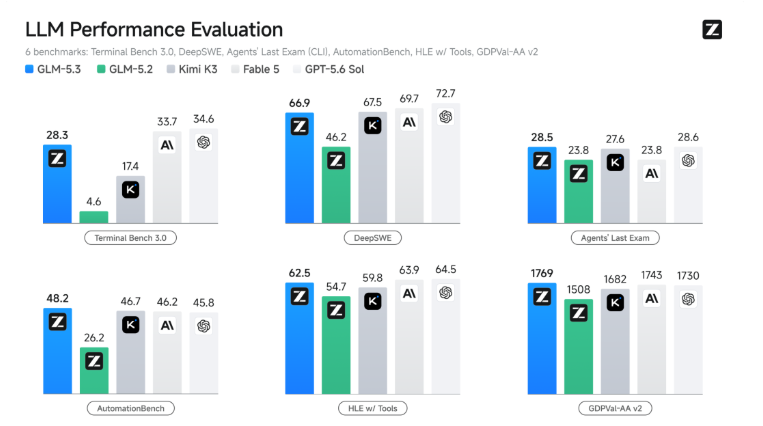
在公开基准上,GLM-5.3 也交出了亮眼答卷。Terminal-Bench 3.0 得分从 4.6 跃升至 28.3,DeepSWE v1.1 从 46.2 升至 66.9,Agents' Last Exam 从 23.8 提到 28.5,GDPval-AA v2 达到 1769 分。其在编程与智能体能力上已接近 Claude Fable 5,体感超过其他国产模型,在 Terminal Bench 3.0 与 Agents' Last Exam(CLI)两项测试中拿下开源第一。
后训练 Scaling:基座潜力远未触顶
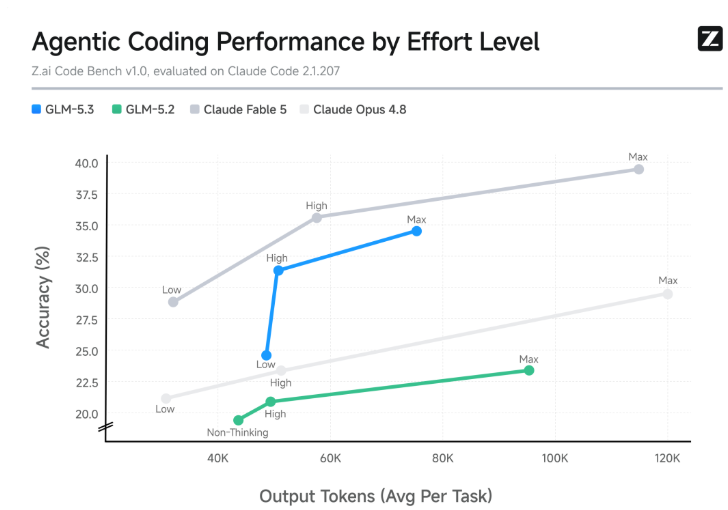
智谱强调,上述全部提升均来自后训练而非换模型。基于 IndexShare、SAO 以及持续演进的新一代 Slime 框架,团队在与 GLM-5.2 完全相同的基座上高效推进强化学习,并坦言"可能远未开发出这个基座的智能上界"。这一思路释放出明确信号:大模型竞争未必总要靠堆参数,把已有底座"练透"同样能逼近前沿水平。
在安全维度,GLM-5.3 在白盒代码审查与漏洞发现等任务中表现持平 Mythos 5,展现出面向网络防御场景的潜力。智谱将在发布两周后开放完整模型权重,但前提是完成安全评估与模型加固,以限制潜在攻击能力、保留防御价值。与此同时,新模型即日上线官方编程工具 ZCode、AutoClaw 及 GLM Coding Plan,并面向 Trae、扣子、WorkBuddy / CodeBuddy、Qoder 等编码平台开放抢先体验。当开源模型在编程赛道逼近闭源旗舰,国产大模型的下半场较量,正从"谁更会说话"转向"谁更会干活"。
技术解析:后训练如何撬动智能跃升
后训练(Post-training)是指在预训练完成之后,通过监督微调、人类反馈强化学习(RLHF)等技术对模型进行进一步优化的过程。传统上,后训练被视为对基座模型的"微调",主要目的是对齐人类偏好、提升指令遵循能力。然而,智谱此次的做法却将后训练提升到了与预训练同等重要的战略高度。
具体而言,GLM-5.3 的后训练采用了三大核心策略:
长程任务环境规模化:通过构建数十倍于以往的长程任务环境,让模型在更复杂的多步骤任务中进行强化学习。这种环境模拟了真实世界中的复杂问题,要求模型具备规划、推理和工具调用的能力。
环境类型多样化:除了传统的代码生成和数学推理,GLM-5.3 的后训练环境还涵盖了命令行操作、网页交互、API 调用等多种类型。这使得模型能够适应更广泛的智能体应用场景。
超长后训练时间:智谱团队投入了远超常规的后训练计算资源,使得模型能够在海量交互中充分探索和优化策略。这种"慢工出细活"的方式,让基座模型的潜力得以充分释放。
这种"不换底座"的做法,在业界引发了广泛讨论。一方面,它证明了基座模型的能力上限可能远超我们的预期,后训练并非简单的"锦上添花",而是可以成为核心竞争力的关键环节。另一方面,它也暗示着大模型竞赛的焦点正在从"拼参数"转向"拼算法",如何高效利用现有模型资源,将成为未来竞争的重要维度。
基准测试:编程与智能体能力全面飙升
GLM-5.3 在多个权威基准上的表现,直观地展示了后训练 Scaling 的威力。以下为关键数据对比:
| 基准测试 | GLM-5.2 | GLM-5.3 | 提升幅度 |
|---|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 | +515% |
| DeepSWE v1.1 | 46.2 | 66.9 | +44.8% |
| Agents' Last Exam | 23.8 | 28.5 | +19.7% |
| GDPval-AA v2 | - | 1769 | - |
其中,Terminal-Bench 3.0 的得分从 4.6 跃升至 28.3,提升超过 5 倍,这一测试主要评估模型在终端环境中的任务完成能力,包括文件操作、脚本编写、系统管理等。DeepSWE v1.1 则聚焦于软件工程场景,得分从 46.2 升至 66.9,表明模型在真实代码库上的问题解决能力显著增强。
值得注意的是,GLM-5.3 在 Agents' Last Exam(CLI)中取得了开源模型第一的成绩,这一测试模拟了智能体在命令行环境中的综合表现,涵盖了信息检索、代码执行、错误修复等多项能力。此外,GDPval-AA v2 达到 1769 分,这一基准主要评估模型在通用开发任务中的表现,分数的大幅提升进一步印证了其编程实力的飞跃。
安全与生态:兼顾防御与开放
在安全维度,GLM-5.3 在白盒代码审查与漏洞发现等任务中表现持平 Mythos 5,展现出面向网络防御场景的潜力。这意味着模型不仅能够生成高质量代码,还能识别代码中的潜在安全漏洞,这对于企业级应用和网络安全领域具有重要意义。
然而,强大的能力也伴随着潜在风险。智谱在发布策略上采取了谨慎的态度:将在发布两周后开放完整模型权重,但前提是完成安全评估与模型加固,以限制潜在攻击能力、保留防御价值。这种"先加固、后开放"的做法,体现了对 AI 安全的高度重视。
在生态布局方面,GLM-5.3 即日上线官方编程工具 ZCode、AutoClaw 及 GLM Coding Plan,并面向 Trae、扣子、WorkBuddy / CodeBuddy、Qoder 等编码平台开放抢先体验。这一举措旨在构建一个完整的开发者工具链,让模型能力能够快速落地到实际开发场景中。
行业影响:开源模型逼近闭源旗舰
GLM-5.3 的发布,标志着开源模型在编程能力上已经逼近甚至部分超越了闭源旗舰。在 Terminal-Bench 3.0 和 Agents' Last Exam(CLI)两项测试中,GLM-5.3 均拿下开源第一,且整体表现接近 Claude Fable 5。这一趋势对于 AI 行业具有深远影响:
- 降低使用门槛:开源模型的高性能使得中小企业和个人开发者能够以更低成本获得顶尖的 AI 编程能力,无需依赖昂贵的闭源 API。
- 促进技术民主化:开源模型的权重开放,使得研究者能够深入探索模型内部机制,推动 AI 技术的透明化和可解释性发展。
- 加剧市场竞争:开源模型的崛起对闭源厂商构成了巨大压力,迫使它们不断提升产品性能和服务质量,最终受益的是广大用户。
未来展望:后训练 Scaling 的潜力与挑战
智谱此次"不换底座"的尝试,为业界提供了一个全新的视角:在算力受限的情况下,通过优化后训练策略,同样可以挖掘模型的潜在能力。然而,这一路径也面临诸多挑战:
- 计算资源消耗:超长后训练时间意味着巨大的计算成本,并非所有团队都能承受。
- 环境设计难度:长程任务环境的构建需要深入理解任务本质,设计不当可能导致模型过拟合或泛化能力下降。
- 安全风险:更强的能力也意味着更大的滥用风险,如何在开放与安全之间取得平衡,是每个模型发布者必须面对的课题。
尽管如此,GLM-5.3 的成功无疑为行业指明了一条可行的发展路径。未来,我们或许会看到更多团队效仿这一思路,在已有基座上通过后训练 Scaling 实现能力跃升。而国产大模型的竞争,也将从"谁更会说话"转向"谁更会干活",真正以实际应用效果论英雄。
当开源模型在编程赛道逼近闭源旗舰,我们正站在一个技术变革的临界点。GLM-5.3 不仅是一个模型的发布,更是一种理念的宣言:在 AI 的进化之路上,创新不止于堆砌参数,更在于如何智慧地利用现有资源,释放每一份算力的价值。