AI速度革命:GPT-5.6 Sol超高速模式如何颠覆信息获取效率?
速度竞赛:AI 推理的新战场
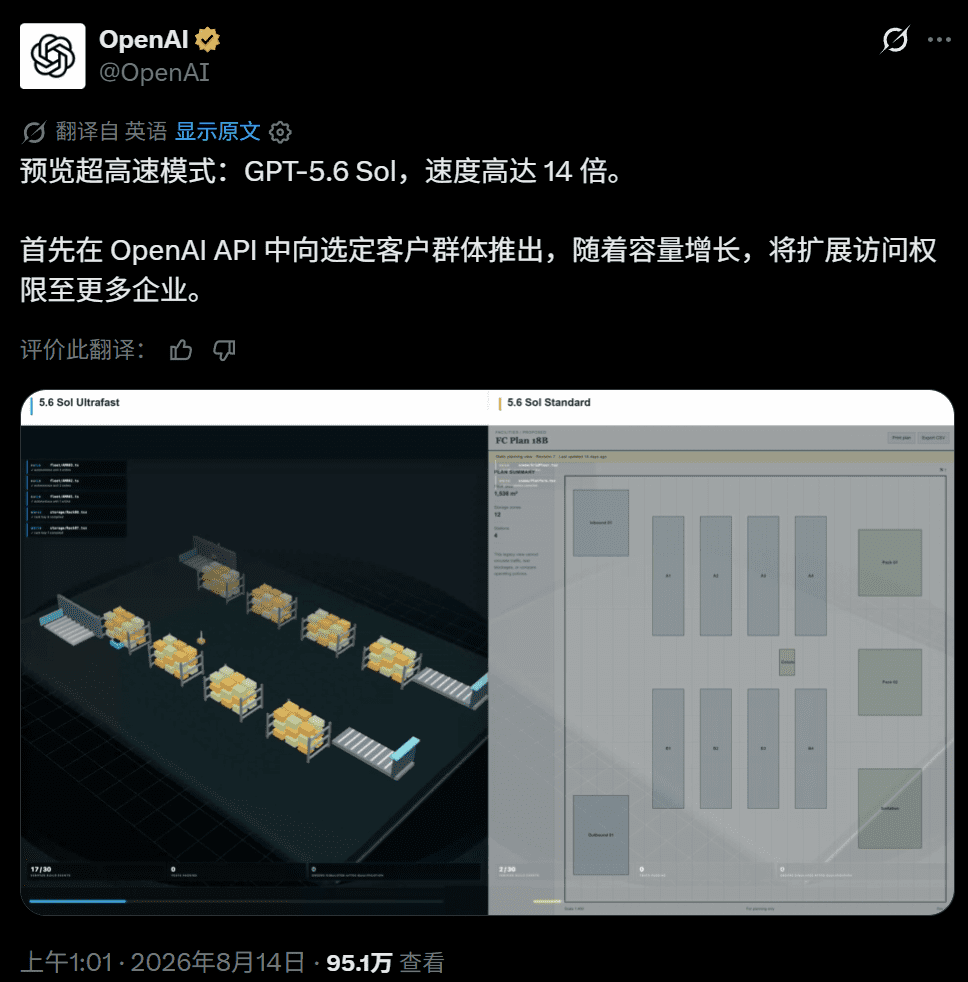
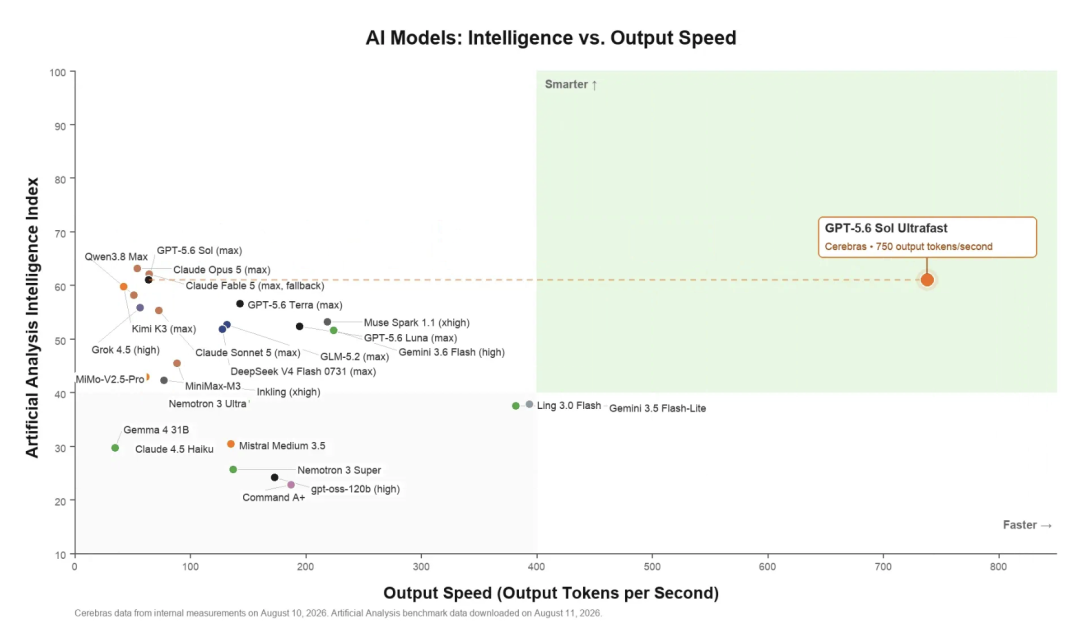
当各大厂商还在参数规模和智能水平上激烈角逐时,OpenAI 与芯片新贵 Cerebras 联手投下了一枚重磅炸弹——GPT-5.6 Sol 的“超高速模式”(Ultrafast Mode)。这一模式将旗舰模型的输出速度推至惊人的 750 tokens/s,较标准模式提升 14 倍,且质量分毫不减。这不仅是数字上的飞跃,更预示着 AI 应用范式的深刻变革。
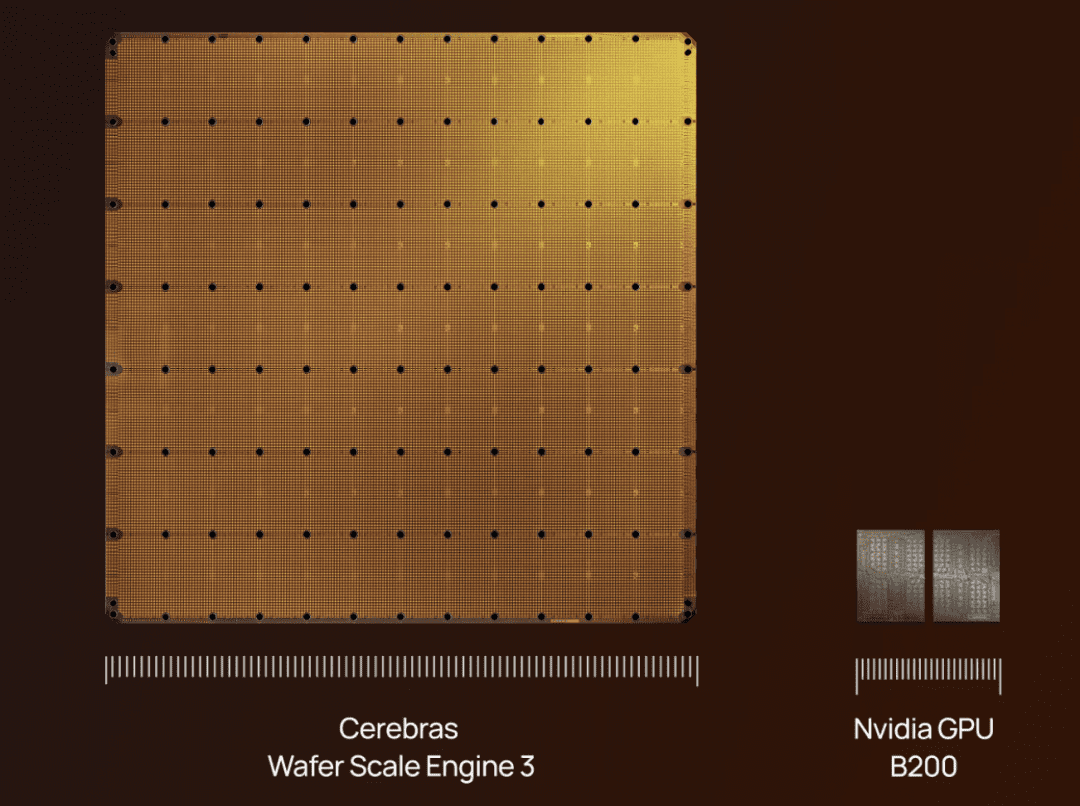
传统上,AI 模型的推理速度受限于硬件架构,尤其是内存带宽的瓶颈。GPU 集群在生成每个 token 时,都需要反复从外部显存加载庞大的模型权重,这一过程成为速度的“卡脖子”环节。Cerebras 的晶圆级芯片(WSE-3)则另辟蹊径,将 4 万亿晶体管、44 GB 片上 SRAM 集成于单一晶圆,使模型参数得以常驻于超高带宽的片上存储,彻底绕开了内存墙的限制。
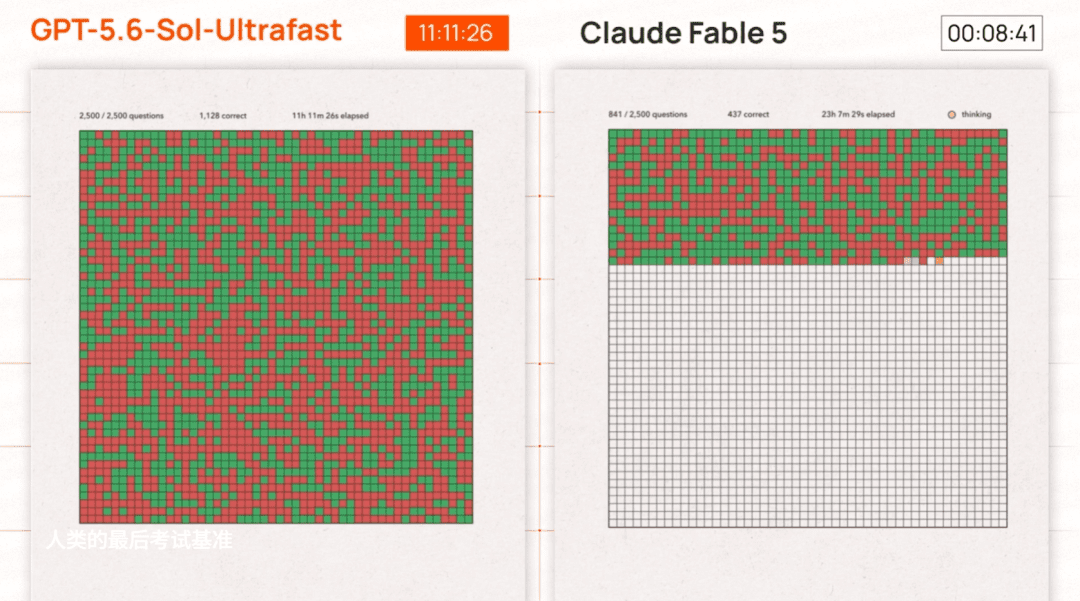
这种硬件层面的创新,使得 GPT-5.6 Sol 在保持前沿智能水平的同时,实现了近乎实时的响应。在“人类最后的考试”(HLE)基准测试中,超高速模式仅用 11 小时 11 分钟完成全部 2500 道博士级难题,而 Claude Fable 5 则需耗时 78 小时 27 分钟。速度提升近 7 倍,准确率却不相上下。
从“过夜实验”到“交互式研究”
速度的提升不仅仅是效率的改善,更从根本上改变了人机协作的节奏。以往,研究人员习惯于在夜间启动一批实验,次日清晨再查看结果。这种“批处理”模式源于模型推理的耗时性。而超高速模式将这一周期压缩至分钟级,使得“交互式研究”成为可能。
OpenAI 内部已开始实践这一新模式。在事件响应场景中,当警报触发时,工程师需要快速分析日志、追踪代码变更、汇总信息,并制定修复方案。借助超高速模式,AI 能在故障仍在发生时,实时提供洞察和建议,将“从观察到行动”的延迟降至最低。工程师仍保留最终决策权,但 AI 的即时辅助显著提升了响应速度。
类似地,在金融研究领域,市场信号瞬息万变,超高速模式能实时分析数据、评估交易风险、识别可疑活动,为交易员提供毫秒级的决策支持。客户支持场景中,AI 不再需要用户等待数秒才能获得答案,而是能在对话间隙完成多步骤推理,实现无缝的实时交互。
硬件革命:晶圆级芯片的威力
超高速模式的实现,离不开 Cerebras 独特的硬件架构。传统 GPU 在推理时,模型权重存储于片外 HBM 中,每次计算都需要通过带宽有限的总线传输数据,成为性能瓶颈。而 Cerebras 的 WSE-3 芯片将整个晶圆作为单一处理器,集成了海量计算核心和高速片上存储,使得模型参数可以完全驻留在 SRAM 中,访问延迟极低。
对于参数量远超芯片容量的旗舰模型,Cerebras 采用了“多晶圆流水线并行”技术,将模型的不同层分布在不同晶圆上,每层参数常驻于对应芯片的 SRAM,token 在晶圆间无缝流转。这种设计不仅消除了内存带宽瓶颈,还避免了多卡通信的开销,实现了线性扩展的推理性能。
应用场景的无限可能
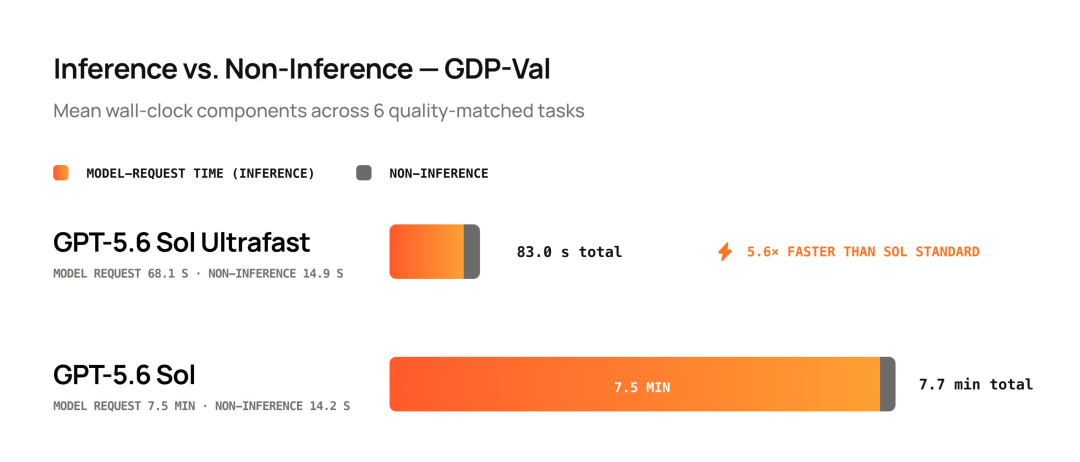
超高速模式为 AI 应用打开了新的大门。在 GDP-Val 基准测试中,该模式实现了 5.6 倍的端到端速度提升,且质量未受影响,这意味着经济价值高的知识工作(如法律文书、金融建模、工程报告)可以更快完成,直接加速商业决策。
更令人兴奋的是,它使得 AI 智能体能够部署到关键路径上。例如,在电商场景中,当购物者犹豫不决时,AI 可以实时回答产品问题、检查库存、提供个性化推荐,甚至解决结账问题,从而减少购物车放弃率。在实时研究实验中,团队可以在工作会议中即时测试假设、调整方法,无需中断流程。
未来展望:速度与智能的平衡
超高速模式的推出,引发了关于 AI 使用方式的思考。过去,为了追求速度,用户常常不得不降级使用较小的模型(如 Luna 或 Terra)。而现在,旗舰模型的超高速模式使得这些妥协变得不再必要。多轮工具调用、复杂代码生成、链式思考等任务,原本需要数小时,现在几分钟即可完成。
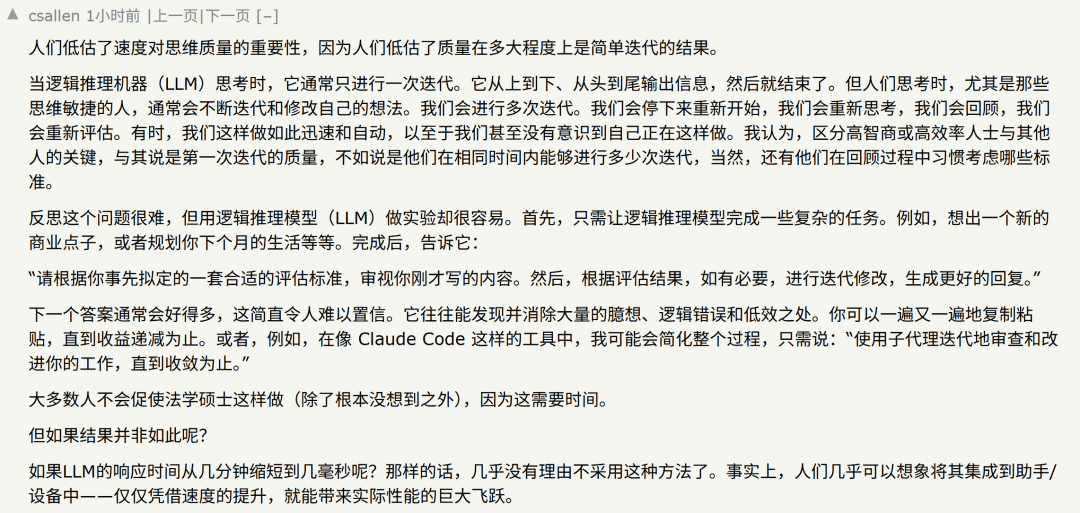
社区中,人们已经开始期待 Luna 和 Terra 版本的超高速模式,但 Cerebras 的芯片产能是否能跟上需求,仍是未知数。不过,这一技术突破无疑将推动整个行业重新审视硬件与算法的协同设计。
结语:即时智能的新纪元
GPT-5.6 Sol 超高速模式不仅是速度的胜利,更是 AI 从“智能”迈向“即时智能”的关键一步。它打破了推理延迟的束缚,让 AI 能够真正融入实时决策的流程中。随着晶圆级芯片技术的成熟和普及,我们有理由相信,未来的 AI 将不仅更聪明,而且更快、更即时,从而彻底改变我们与机器协作的方式。