PhyAI:统一推理运行时如何重塑Physical AI部署边界?
从原型到生产:Physical AI 部署的碎片化困境
Physical AI 模型的部署早已走出实验室,进入真实世界的复杂场景。从离线基准测试到云端强化学习,从端侧实时控制到工厂级 MaaS 服务,每个环节都对推理系统提出了截然不同的要求。然而,当前的技术栈却呈现出一种令人担忧的碎片化趋势:针对不同场景,开发者往往需要维护多套代码,这不仅增加了迁移成本,还导致工程开发重复劳动,更使得推理效率在不同场景下参差不齐。
以典型的四类部署场景为例:Benchmark 评测场景追求复现的准确性,云端 RL 后训练 Rollout 场景关注多 Batch 吞吐和 GPU 利用率,端侧部署场景则对推理时延极为敏感,而边缘或工厂 MaaS 场景需要同时处理多请求吞吐、网络排队和批处理带来的时延波动。这些场景在 Batch 大小、模型精度和执行设备上存在显著差异,但图像预处理、模型推理逻辑、缓存和动作输出等核心环节却可以复用,且必须保持一致。
遗憾的是,现有工作往往针对每个场景单独优化,导致同一模型在不同场景下需要不同的代码实现。这种“四套代码”的模式不仅浪费了宝贵的开发资源,还使得跨场景迁移变得异常困难。例如,一个在云端验证过的模型,要部署到端侧,可能需要重写推理逻辑;而一个在端侧优化的模型,要扩展到工厂 MaaS,又需要重新设计批处理策略。这种碎片化不仅拖慢了产品迭代速度,也阻碍了 Physical AI 技术的规模化落地。
PhyAI:一套代码,端边云全场景覆盖
针对上述问题,北京邮电大学联合北京大学、清华大学、南京大学、明体科技和面壁智能等机构,共同提出了 PhyAI——一个面向 Physical AI 的统一推理运行时。PhyAI 的核心设计理念是:将模型语义与底层执行细节彻底解耦。具体而言,模型语义被封装在 Model Adapter 中,而调度、缓存、算子、图执行和并行等复杂逻辑则交由运行时统一管理。这种设计使得同一套模型运行代码,能够无缝迁移到 Benchmark、云端 RL、端侧控制和工厂 MaaS 等所有典型场景。
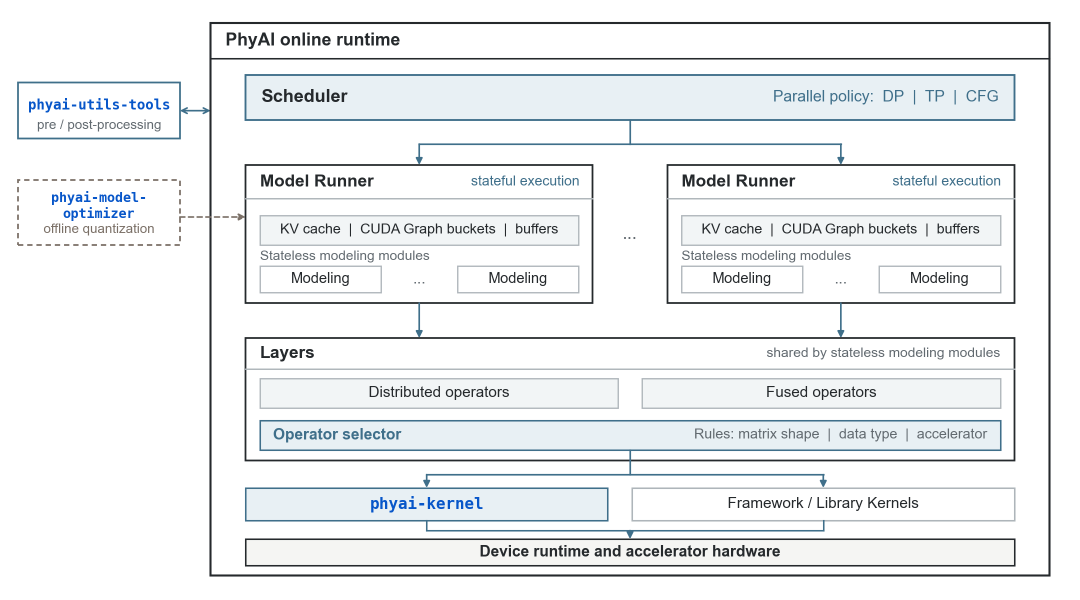
PhyAI 的架构包含几个关键组件:Model Runner 负责保存视觉语言条件、Action Expert 或视频动作生成、Solver、状态复用与动作转换;Scheduler 负责选择数据并行(DP)、张量并行(TP)、CFG(Classifier-Free Guidance)以及设备组;Runner 管理 KV Cache、Buffer、CUDA Graph 和请求状态;Layers 则根据 Shape、Dtype 和硬件选择融合或分布式算子。这种分层设计使得同一模型路径可以运行在单卡、边缘和云端多卡环境中,无需修改任何模型代码。
推理瓶颈的量化分析:Control-Time Roofline 的提出
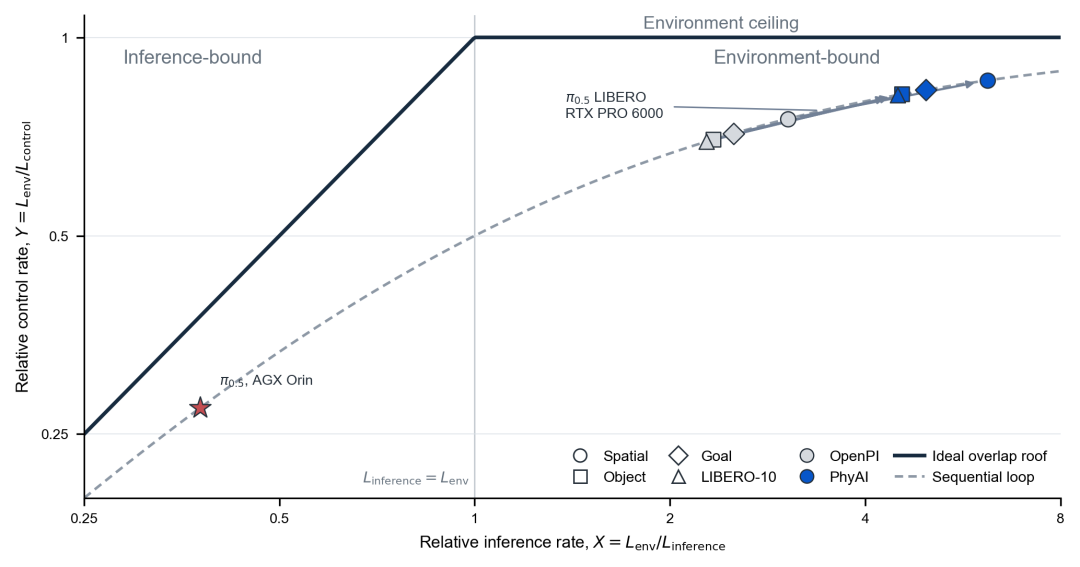
为了深入理解推理性能的瓶颈,研究团队对不同模型的不同模块进行了细致的性能测量,并提出了 Control-Time Roofline 这一分析工具。传统的 Roofline 模型主要关注计算强度与硬件峰值性能的关系,但 Physical AI 场景中,机器人控制周期不仅受模型推理速度影响,还受到物理环境、网络通信、图像前后处理等多种因素制约。因此,Control-Time Roofline 将推理性能与控制周期直接关联,帮助开发者判断当前瓶颈究竟来自模型推理还是物理环境。
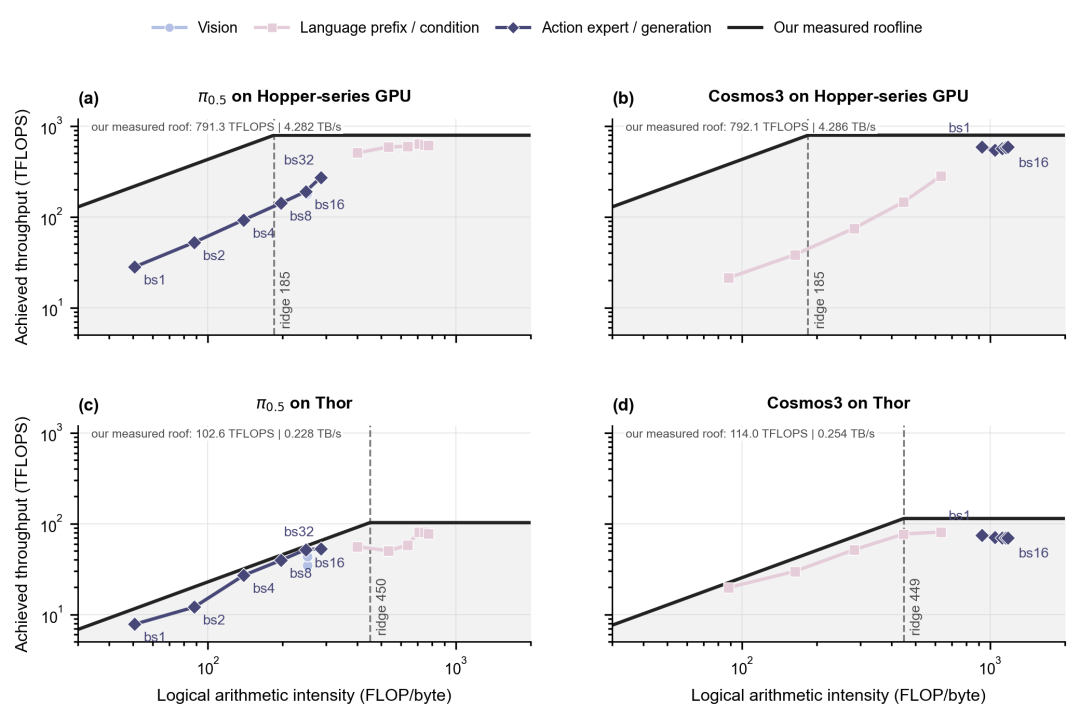
实验数据揭示了几个关键现象。以 PI0.5 模型为例,在 Batch=1 时,Action Expert 仅占估算 FLOPs 的 8.8%,却占据了 57.2% 的推理延迟;当 Batch 增加到 32 时,其占比降至 13.5%,吞吐约为 100 samples/s。这表明 Action Expert 在低 Batch 下存在严重的计算效率问题。而 Cosmos3 模型在 Batch 从 1 增加到 16 时,吞吐仅提升 14.3%,已接近计算受限状态。这些测量结果清晰地展示了不同模块在不同硬件上的性能特征。
进一步地,研究团队在 AGX Orin 和 RTX Pro 6000 上对 PI0.5 进行了测试。结果显示,在 AGX Orin 上,主要瓶颈是模型推理;而在 RTX Pro 6000 上,主要瓶颈则变成了物理环境。这个看似简单的结论却具有深远意义:在算力充足的设备上,继续降低推理延迟并不会按比例提高理想控制频率。这意味着算法、硬件和基础设施需要协同设计,框架优化节省出的时间应该用于支持更大模型、较慢设备或更多并发,而不是盲目追求更低的延迟。
Benchmark 与 RL Rollout 的实测性能提升
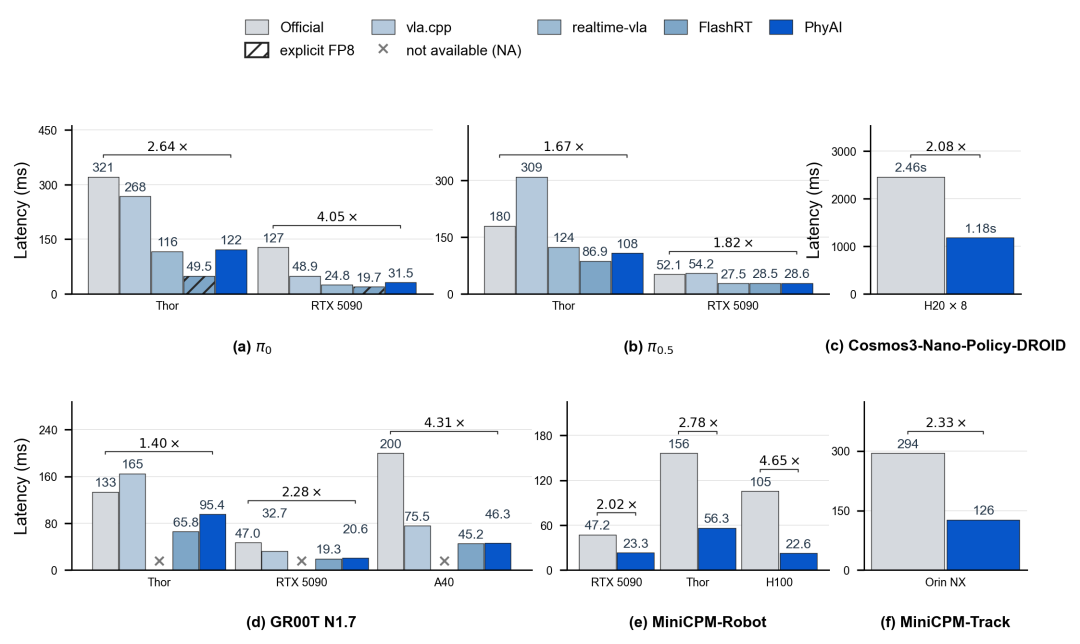
PhyAI 的实际效果在多个基准测试中得到了验证。在 11 组同模型、同设备的单请求对比中,PhyAI 相对官方实现实现了 1.40x 至 4.65x 的加速。例如,MiniCPM-Robot 在 H100 上的推理时延从 105.38 ms 降至 22.64 ms;Cosmos3-Nano-Policy-DROID 在 8 张 H20、CFG=2、TP=4 的配置下,时延从 2.46 s 降至 1.18 s。这些数据充分证明了 PhyAI 在推理性能上的显著优势。
推理速度的提升不仅直接降低了时延,还为云端 RL Rollout 带来了可观的收益。在 RLinf 框架中,PI0.5 GRPO 使用 4 张 A800 和 32 个环境进行训练,其中推理时间为 955.8 s,占 RL 总时间的 15.9%。通过 PhyAI 将推理速度提升 2.55x 后,在其他条件不变的情况下,RL 中的推理时间估算降至 863.2 s,减少了 9.7%。这表明 PhyAI 不仅适用于单次推理,还能显著加速整个强化学习训练流程。
统一推理栈:Physical AI 的未来基石
PhyAI 的提出,标志着 Physical AI 推理系统从碎片化走向统一的重要一步。它将 Benchmark、云端 RL Rollout、端侧部署和工厂 MaaS 等场景的推理需求整合到同一套运行时中,使得模型适配、算子优化和多卡支持不再需要沿四条路径重复实现。这种统一推理栈不仅降低了工程复杂度,还提高了跨场景的迁移效率,为具身智能的大规模部署奠定了坚实基础。
更重要的是,Control-Time Roofline 的引入为开发者提供了一个全新的视角:机器人的运行不仅受到推理速度的制约,还受到环境因素的制约,且二者的瓶颈会随着设备计算能力和模型大小的变化而变化。因此,未来的算法和硬件设计必须考虑这种动态平衡,而 PhyAI 正是实现这种协同设计的理想平台。
随着 Physical AI 技术的不断演进,统一推理运行时将成为连接算法创新与硬件能力的桥梁。PhyAI 的实践表明,通过精心设计的抽象层和运行时优化,我们完全有可能在多样化的部署场景中实现高性能与高灵活性的统一。这不仅是技术上的突破,更是 Physical AI 走向产业化的关键一步。