多参考图视频理解新突破:RefCaptioner如何实现精准语义绑定?
多参考图视频理解的新挑战
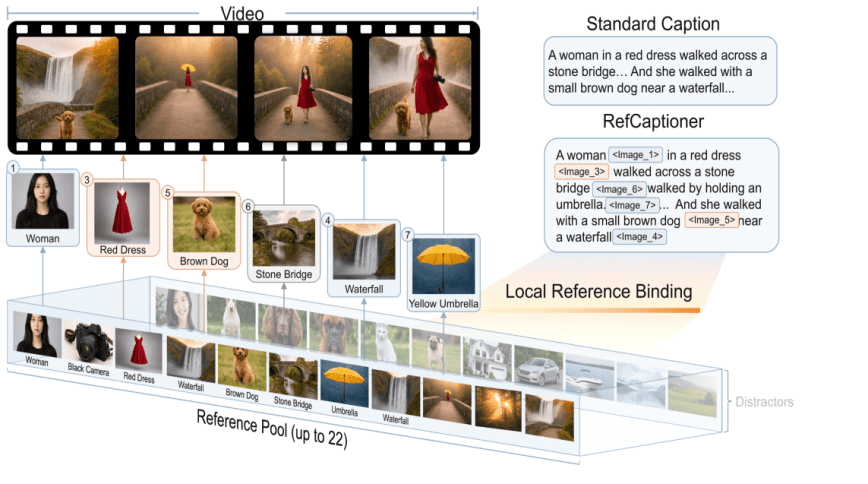
近年来,多模态大模型在视频理解领域取得了显著进展,能够生成详尽的视频描述。然而,随着多参考图视频生成与编辑技术的兴起,模型常常需要同时处理人物、服装、场景等多张参考图,并建立参考图与视频内容的对应关系。实验发现,几乎所有多模态大模型在参考图数量增加时,其对应能力都会大幅下降。这暴露了现有视频描述范式的盲区:普通描述只要求文本忠实于视频,而多参考图场景还要求模型在候选图之间做出选择,将每张有效参考图落到正确的局部短语上,并理解同一主体多张不同视角的图片可能属于同一实体。因此,问题从“生成一段好的描述”转变为“在生成描述的同时建立可用的视频对象-参考图对应关系”。
RefCaptioner:端到端绑定参考图与视频语义
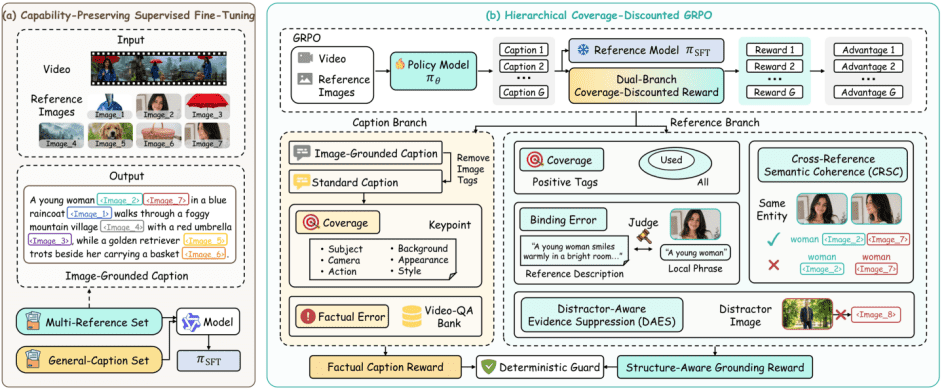
针对上述问题,北京大学与可灵团队提出了RefCaptioner,一种通过后训练强化模型对参考图识别和感应能力的方法。RefCaptioner以Qwen3-VL-8B-Instruct为基座,在SFT阶段采用多参考图数据与通用视频描述数据1:1均衡采样,前者教授参考图选择和局部绑定,后者保留事实性、覆盖度与细节表达能力。这种混合方式避免了模型退化为只会“贴参考图”的系统。
仅靠SFT,模型虽能学会输出格式,但难以在复杂样本中兼顾事实描述、参考图召回和错误抑制。为此,RefCaptioner设计了双层自适应奖励函数HCD-GRPO,将奖励拆分为两个互补分支:事实描述奖励和正确绑定覆盖奖励。事实描述奖励先去除回答中的图像标签,再从主体、外观、动作、背景、镜头和风格六个维度检查关键事实覆盖,并借助视频问答库识别事实错误。正确绑定覆盖奖励则要求只有被正确选择且放在正确局部短语后的参考图才能贡献正向覆盖信号,单纯增加标签数量不会获得额外收益。
此外,HCD-GRPO还包含两个关键机制:Distractor-Aware Evidence Suppression(DAES)和Cross-Reference Semantic Coherence(CRSC)。DAES在训练样本中随机插入无关图片,模型不知道哪些是干扰项,一旦引用视频中没有对应内容的图片就会受到额外惩罚。CRSC则对于同一实体的多张不同视角图片,评估器从回答中抽取“事件-实体-参考图组”关系,检查这些图片是否被聚合到同一局部描述,而不是被错误拆分。这些设计使得模型无法依靠“多贴标签”提高覆盖率,也不能靠“少贴标签”规避错误,而是促使模型在有效绑定的基础上提高对干扰图的识别能力。
MRVBench:将“描述正确”与“图文对应”分开评测
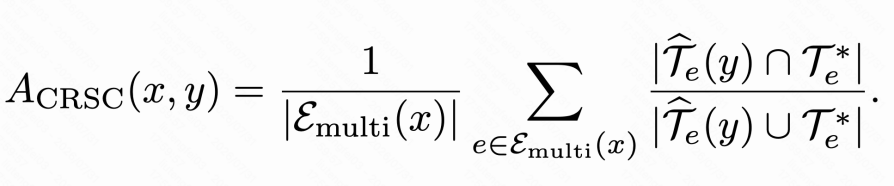
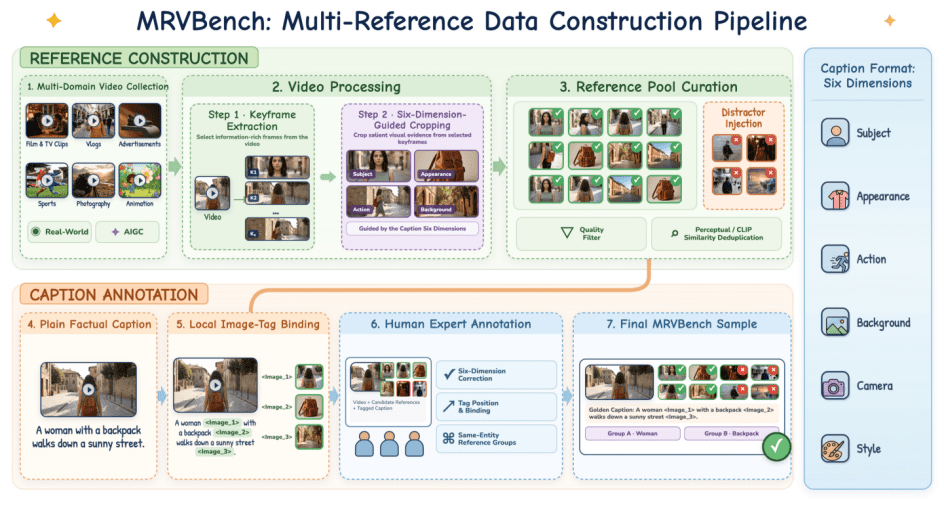
现有视频描述基准通常只判断文本是否覆盖视频内容,却无法回答模型是否选对参考图、标签是否落在正确短语后,以及是否误用干扰项。为此,研究团队构建了MRVBench,用统一协议同时评估视频事实性与多参考图grounding。MRVBench包含462个与训练语料完全隔离的视频,其中185个为AIGC视频、277个为真实视频,共配有3,831张候选参考图。单个样本最多包含22张参考图,约60%的样本具有多图对应同一主体的复杂映射,约40%的样本包含人为注入的干扰图。评测拆分为五个方面:视频事实覆盖与正确性、参考图选择、局部短语绑定、干扰图鲁棒性,以及同一主体多参考图的一致性。所有模型接收相同的视频、任务指令和有序参考图,评分依赖冻结的关键事实、问答库与结构化标注,尽量把“写得像”与“对应得准”区分开。
实验结果:参考图越多,优势越明显
论文将RefCaptioner与多种7B-38B开源模型进行比较,并加入Gemini-3.1-Pro和GPT-5.4作为闭源参考。8B参数的RefCaptioner在所有多参考图grounding指标上取得了开源模型最佳表现,综合结果接近Gemini-3.1-Pro,并高于GPT-5.4。在核心的reference grounding上,RefCaptioner同时保持较高的选图精度、召回和局部绑定质量,并在干扰图排除与多视角主体归组上明显优于其他开源模型。值得注意的是,多参考图训练并没有牺牲普通视频描述能力。在细粒度视频描述评测基准VDC Bench上,短描述、背景、主体和细节等多个维度,RefCaptioner均取得最高准确率;在VCapsBench上,其描述覆盖和一致性也超过Qwen3-VL-8B基座。
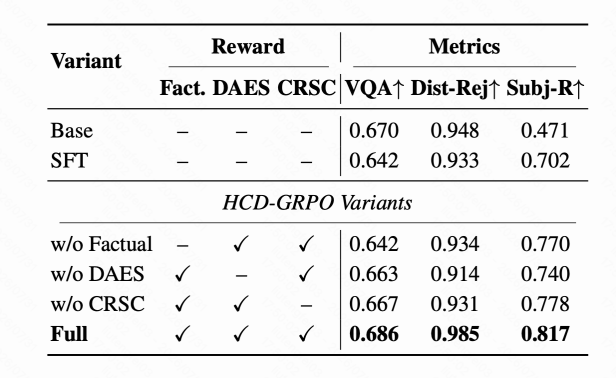
消融实验显示,SFT能显著提高主体参考图召回,但会暂时影响视频问答表现;加入完整HCD-GRPO后,事实描述能力得到恢复,干扰图排除和主体一致性也进一步改善。三个奖励组件分别对应事实性、错误引用抑制和跨参考图一致性,作用相互补充。
为了观察模型面对复杂参考图池时的稳定性,论文按参考图数量将样本划分为2-4、5-8、9-12和13+四组,并将参考图召回、局部绑定准确率和干扰图排除率相乘,得到一个对任何短板都敏感的鲁棒性分数。RefCaptioner在四个区间均保持领先,在最困难的13+参考图时仍高于GPT-5.4。
人工评测与视频重建:Grounding真的有用吗?
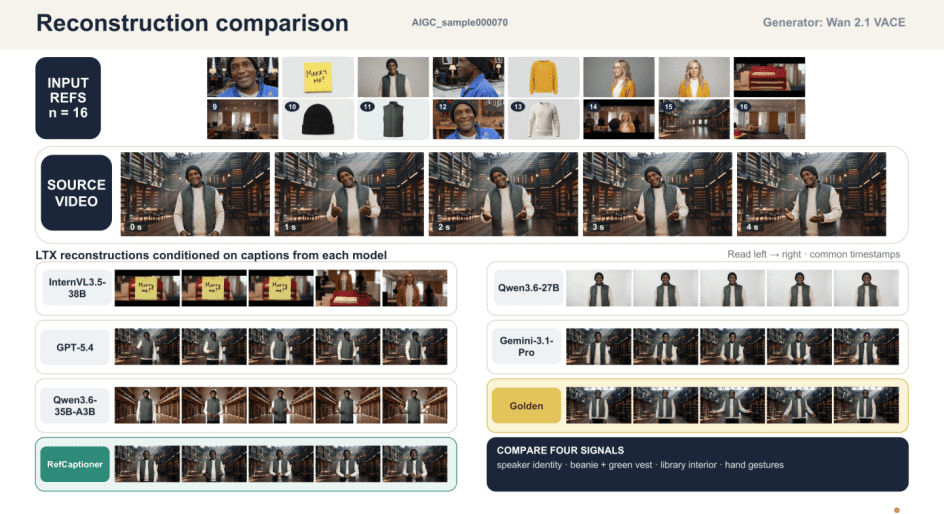
为了检验grounded caption的下游价值,论文使用“模型生成的描述+该描述实际引用的参考图”重建原视频。基于开源视频生成模型Wan2.1-VACE-14B,保持生成参数不变,仅替换输入prompt(即不同VLM提供的原视频Caption和参考图集合)。三名多模态专家采用成对Good/Same/Bad(GSB)协议,对RefCaptioner与各基线生成的重建视频进行匿名比较。结果显示,RefCaptioner在所有成对比较中都获得更多Good而非Bad,说明其输出的描述和参考图组合保留了更多源视频中的主体、外观、动作与场景信息。
总结:多参考图Caption需要的不只是文本质量
RefCaptioner处理的不是在普通Caption后追加图片引用,而是让模型在生成描述的同时回答三个问题:哪些图真的与视频相关、每张图对应哪个局部视觉事实,以及相似但无关的图片是否应该被拒绝。随着多参考图视频生成、编辑的发展,Multi-reference grounding将成为连接参考图与视频语义的一个关键接口。RefCaptioner提供了一个多参考图视频理解的有效算法,而MRVBench提供了一套评测多参考图视频caption准确性的基准,二者共同为更准确、更可控的多参考图视频理解奠定了基础。