扩散语言模型规模化新突破:LLaDA MoE v2如何用定律指引实现高效扩展
扩散语言模型的规模化挑战
近年来,扩散语言模型凭借双向上下文建模与多词元并行解码的独特优势,逐渐成为大语言模型领域的重要技术路线。与传统的自回归模型不同,扩散模型通过掩码去噪目标进行训练,监督信号仅落在被掩码的位置,每个预测都基于受损序列而非因果前缀。这种差异使得自回归模型上成熟的扩展定律无法直接迁移,导致大规模扩散语言模型的训练在很大程度上依赖经验与试错。
随着模型规模与训练算力的不断增大,如何高效地扩大规模成为亟待回答的问题:最优超参数如何随算力调整?有限算力在模型与数据之间如何分配?稀疏专家架构如何随规模演进?这些问题都需要扩展定律给出科学的答案。
首次系统刻画混合专家扩散语言模型的扩展定律
针对上述挑战,中国人民大学高瓴人工智能学院李崇轩、文继荣教授团队与蚂蚁集团联合开展研究,首次系统刻画了混合专家扩散语言模型的扩展定律。研究团队在158M至3.6B的模型规模与10^17至10^19 FLOPs的算力跨度上,系统搜索了批量大小与学习率,拟合出扩散语言模型专属的超参数扩展定律。
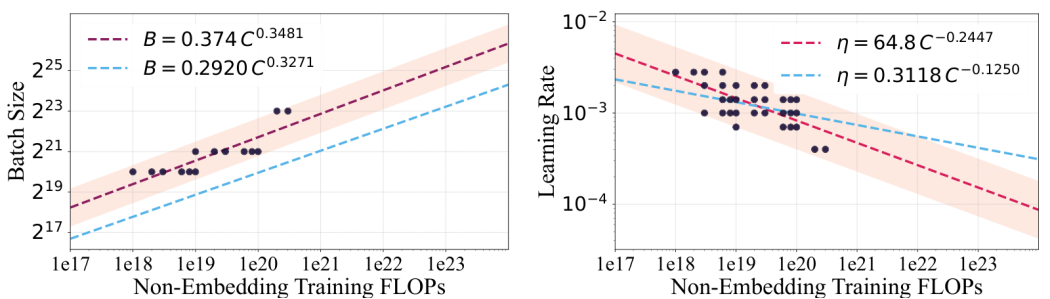
研究发现,最优批量大小随算力的增长比自回归模型更陡,最优学习率随算力的衰减更快。例如,在10^19 FLOPs算力下,自回归定律预测的最优批量大小约为102万词元,而新定律给出343万词元。这一差异源于掩码去噪目标下,名义词元仅在被掩码时才贡献监督信号,有效监督强度的下降改变了梯度噪声水平与优化稳定性。该定律在10^20 FLOPs的外推验证中与实测最优配置高度吻合,为大规模训练提供了可靠的超参数标尺。
算力分配:模型与数据的权衡
在算力分配方面,团队通过IsoFLOP分析刻画了固定算力下模型规模与训练数据的最优权衡。研究发现,最优模型侧算力随总算力以0.475次幂增长,最优训练词元数以0.525次幂增长,整体接近均衡并略微偏向数据一侧。与已有稠密扩散模型的扩展定律相比,混合专家扩散模型的分配前沿是迄今最偏向数据侧的,稀疏激活与扩散建模各自带来的“亲数据”倾向在其中叠加显现,意味着边际算力投向训练词元比投向模型侧计算更为划算。
这一发现对于实际训练具有重要指导意义:在算力有限的情况下,应优先增加训练数据而非模型参数,以获得更好的性能提升。
架构设计:稀疏激活的扩展规律
在架构设计方面,团队沿激活比例、专家粒度与共享专家比例三个关键维度解析了混合专家架构的扩展规律。研究发现,随着规模扩大,更低激活比例、即更大的路由专家池愈发占优;8至16的中等专家粒度在各规模下均保持稳健;共享专家承载约三分之一激活容量(33.3%)在所有规模下恒为最优,与自回归混合专家模型惯用的25%甚至不设共享专家的经验形成鲜明对比。
这些发现为扩散语言模型的稀疏激活架构设计提供了专属准则,打破了以往直接借鉴自回归模型经验的做法。
LLaDA MoE v2:定律指引下的实践
在上述扩展定律的指引下,联合团队从头训练了LLaDA MoE v2 30B-A3B模型:总参数30B、每词元激活3B参数,采用128个细粒度路由专家,激活比例9.09%、专家粒度8、共享专家比例33.3%,落在扩展定律给出的最优区间。模型经五阶段预训练累计学习23.5T词元,全程消耗约46万NVIDIA B200 GPU小时。
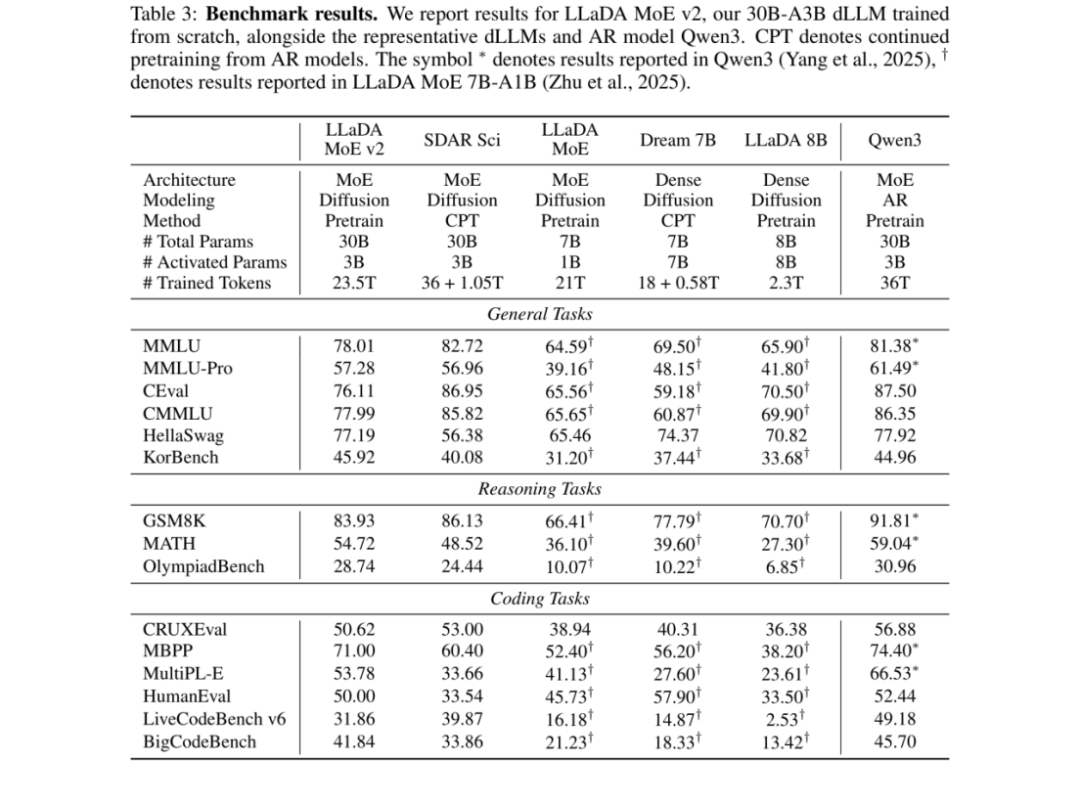
在15项基准测试中,LLaDA MoE v2取得扩散语言模型中的最高平均分58.60,较同规模扩散模型SDAR Sci高出3.78分,其中HumanEval与BigCodeBench分别领先16.46分与7.98分。与自回归模型Qwen3相比,模型在OlympiadBench、HumanEval等多项推理与代码基准上的差距不足3分,而预训练词元用量仅为其约65%。
算力效率的显著提升
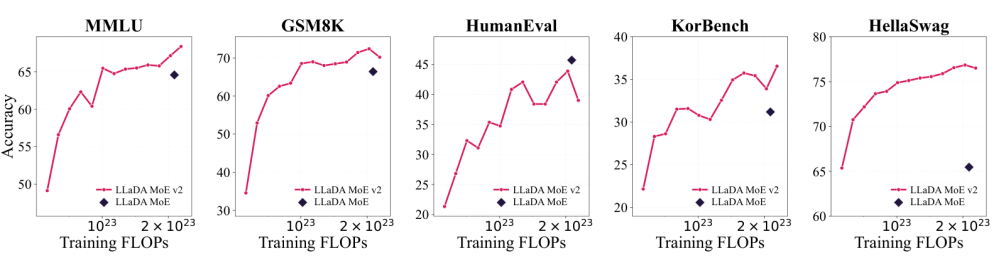
扩展定律的指导价值在算力效率上体现得尤为直观:与未受扩展定律指引的上一代LLaDA-MoE 7B-A1B相比,LLaDA MoE v2在MMLU、GSM8K和KorBench上仅以约一半的训练算力便实现超越,展现出“定律指引”将预训练算力高效转化为下游性能的路径。
微调后的卓越表现
在有监督微调方面,团队使用700万条指令数据进行训练,所得模型即在8项数学推理与代码生成基准中的7项上超越同规模扩散模型SDAR Chat,并在AIME 2024/2025、MBPP、LiveCodeBench等基准上逼近经历额外强化学习阶段的Qwen3,更在多语言代码生成基准MultiPL-E上实现反超,表明扩展定律指引的基座模型经简单微调即可释放扎实的指令遵循与复杂推理能力。
展望
LLaDA MoE v2首次为混合专家扩散语言模型建立了覆盖超参数、算力分配与架构设计的系统性扩展定律,突破了非自回归模型规模化依赖经验迁移的瓶颈。通过定律指引的稀疏架构与掩码去噪训练,模型以更少的预训练词元与更低的激活开销逼近同规模领先自回归模型,为扩散语言模型的规模化提供了“定律指引”,为进一步扩大模型规模、探索智能上限铺平了道路。
团队预计近期将开源推理代码以及LLaDA MoE v2模型权重,这将进一步推动扩散语言模型的研究与应用。