鸿蒙AI菜谱应用开发:如何让大模型稳定输出结构化JSON并渲染原生UI
从“今天吃什么”到AI菜谱应用
“今天吃什么?”——这大概是当代人每天最高频、也最令人头疼的问题之一。冰箱里躺着几样食材,却不知道能凑出什么菜;想做点新花样,又懒得翻菜谱App一页页找。
大语言模型的出现,让这个问题有了优雅的解法:把你有的食材告诉AI,让它帮你想菜谱。这听起来简单,但要做成一款体验好的应用,中间隔着一个关键的技术鸿沟——
大模型天生输出的是自然语言文本。如果我直接把它返回的一大段文字丢给用户,体验和在聊天框里问没什么区别:食材、步骤、用量混在一起,没有结构、无法交互、不能收藏。而一款真正的菜谱应用,需要的是结构化的数据:菜名、难度、耗时、用料清单(还要区分“你已有的”和“需要买的”)、分步做法、采购清单……
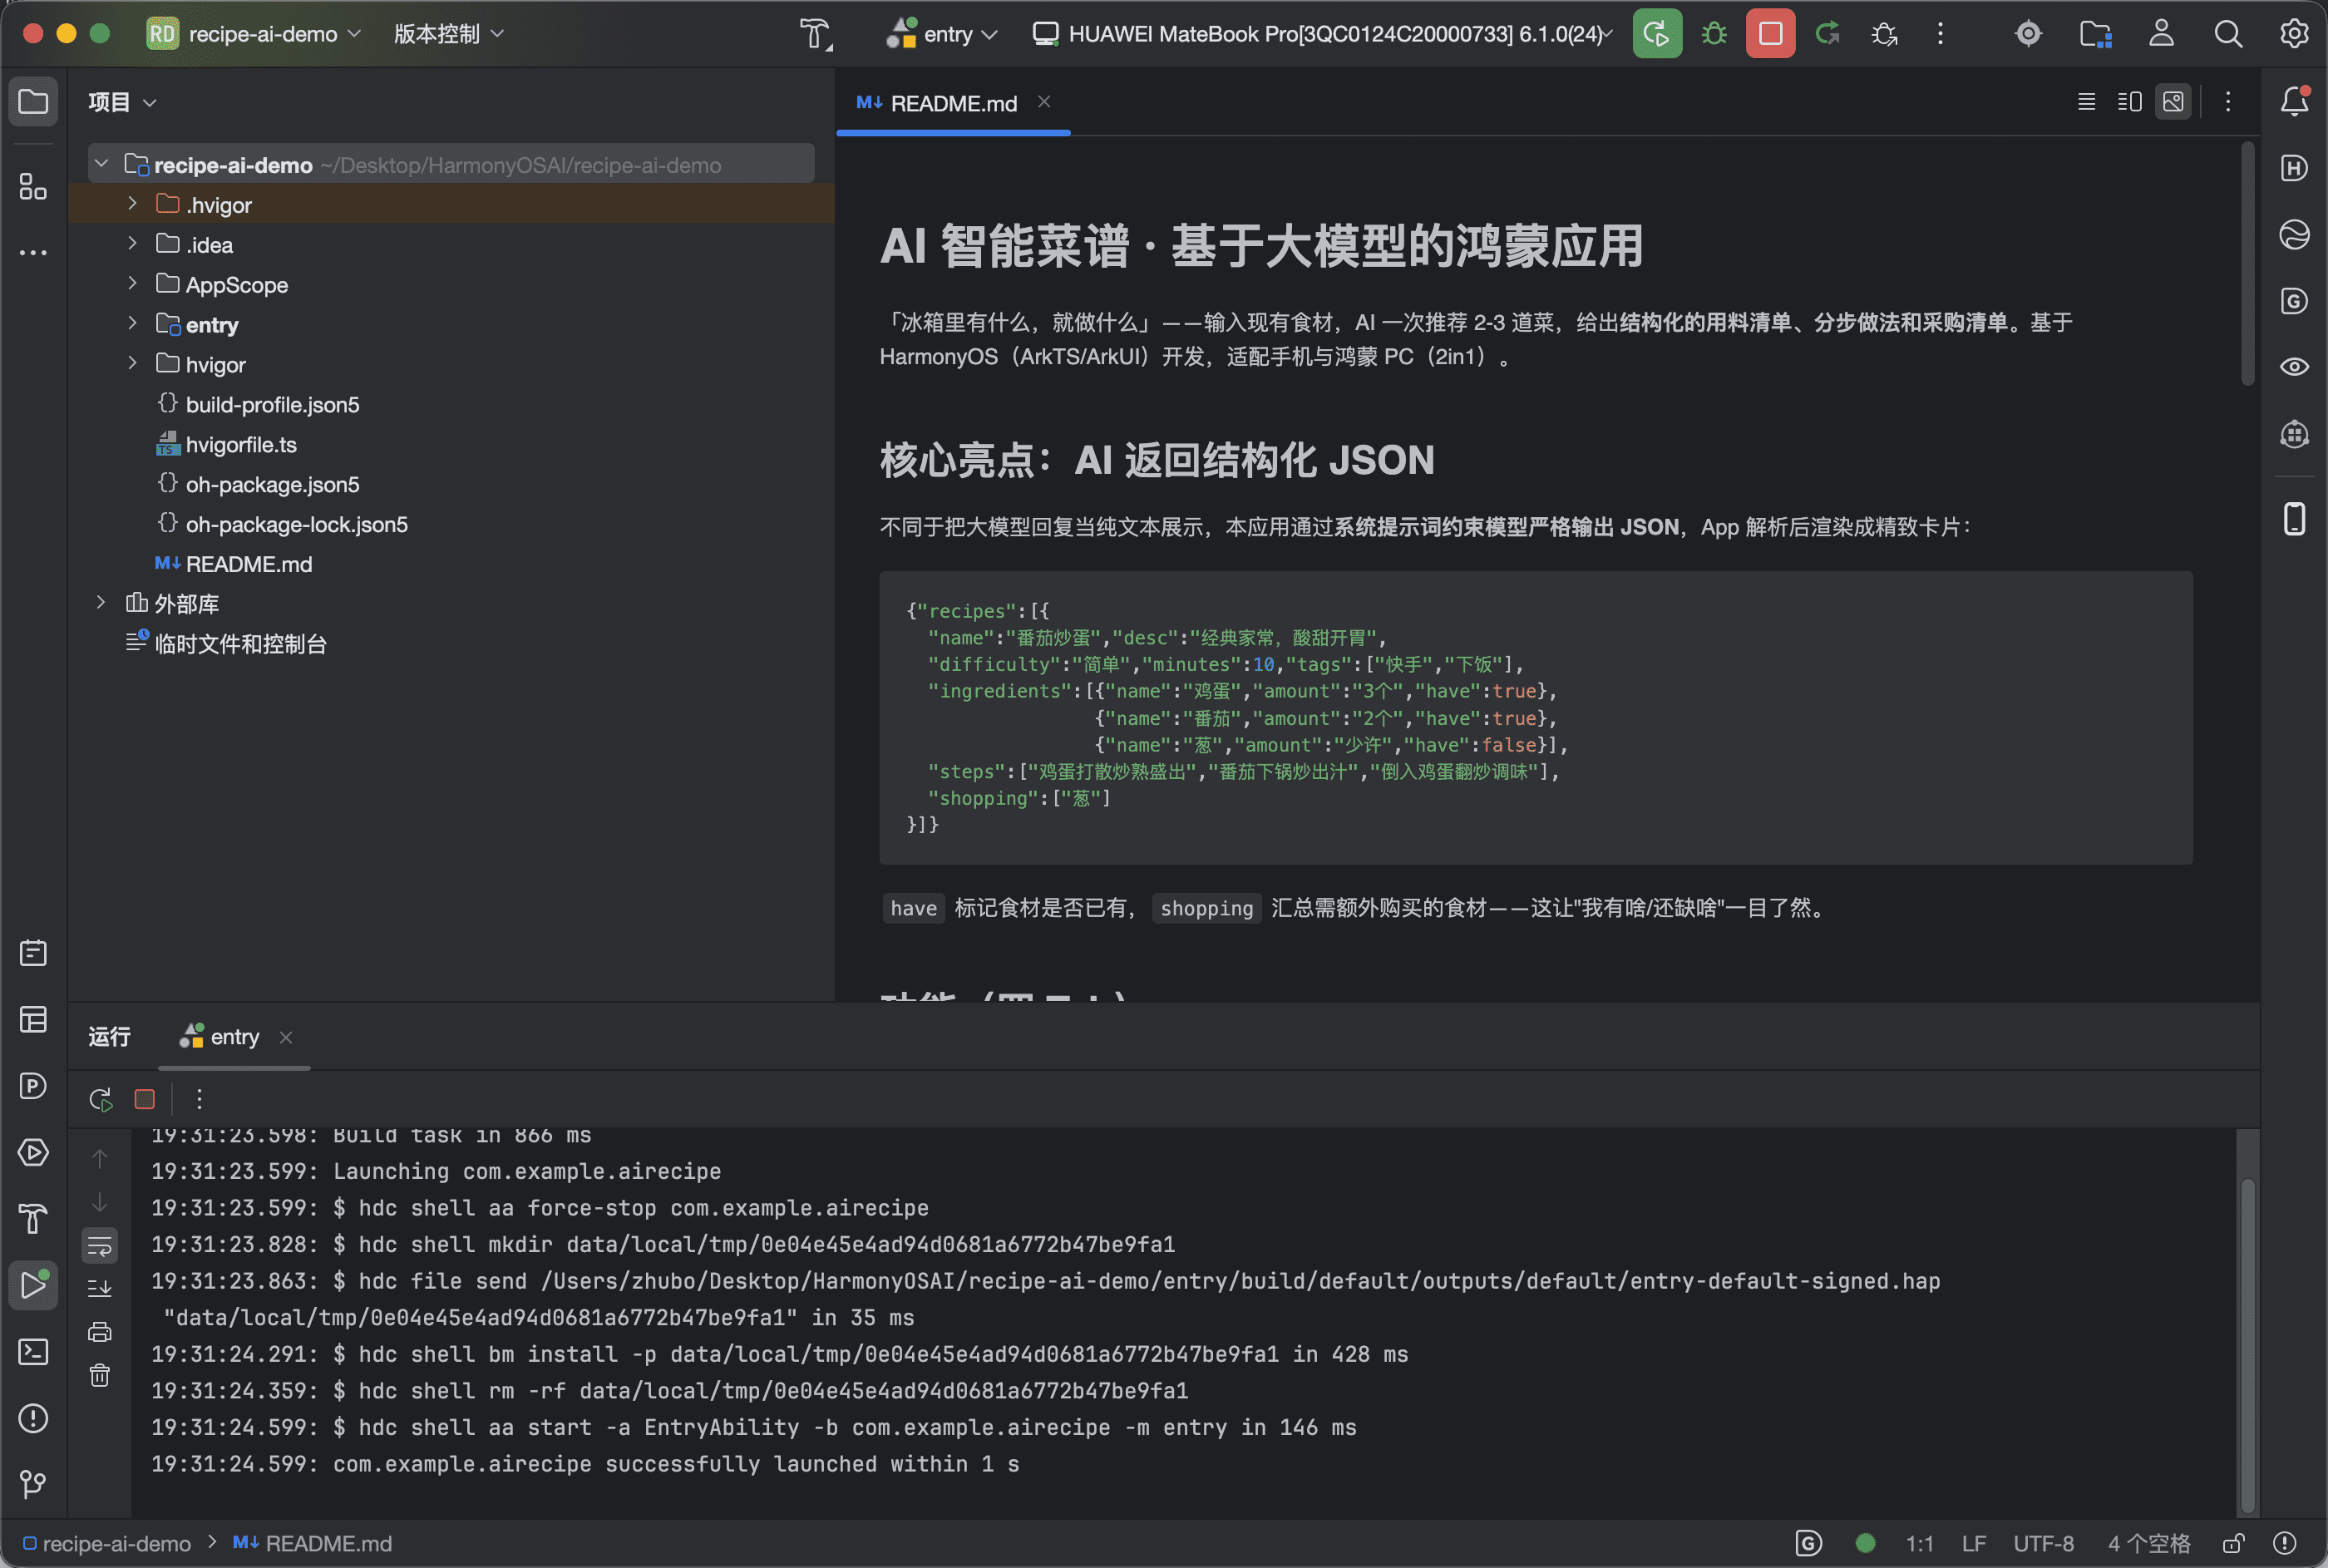
所以这篇文章的核心,不是“怎么调用大模型API”(那只是基础),而是:如何驯服大模型,让它稳定地吐出结构化JSON,再把这份JSON渲染成体验精致的鸿蒙原生界面。 这是AI应用从“能用”到“好用”的分水岭。
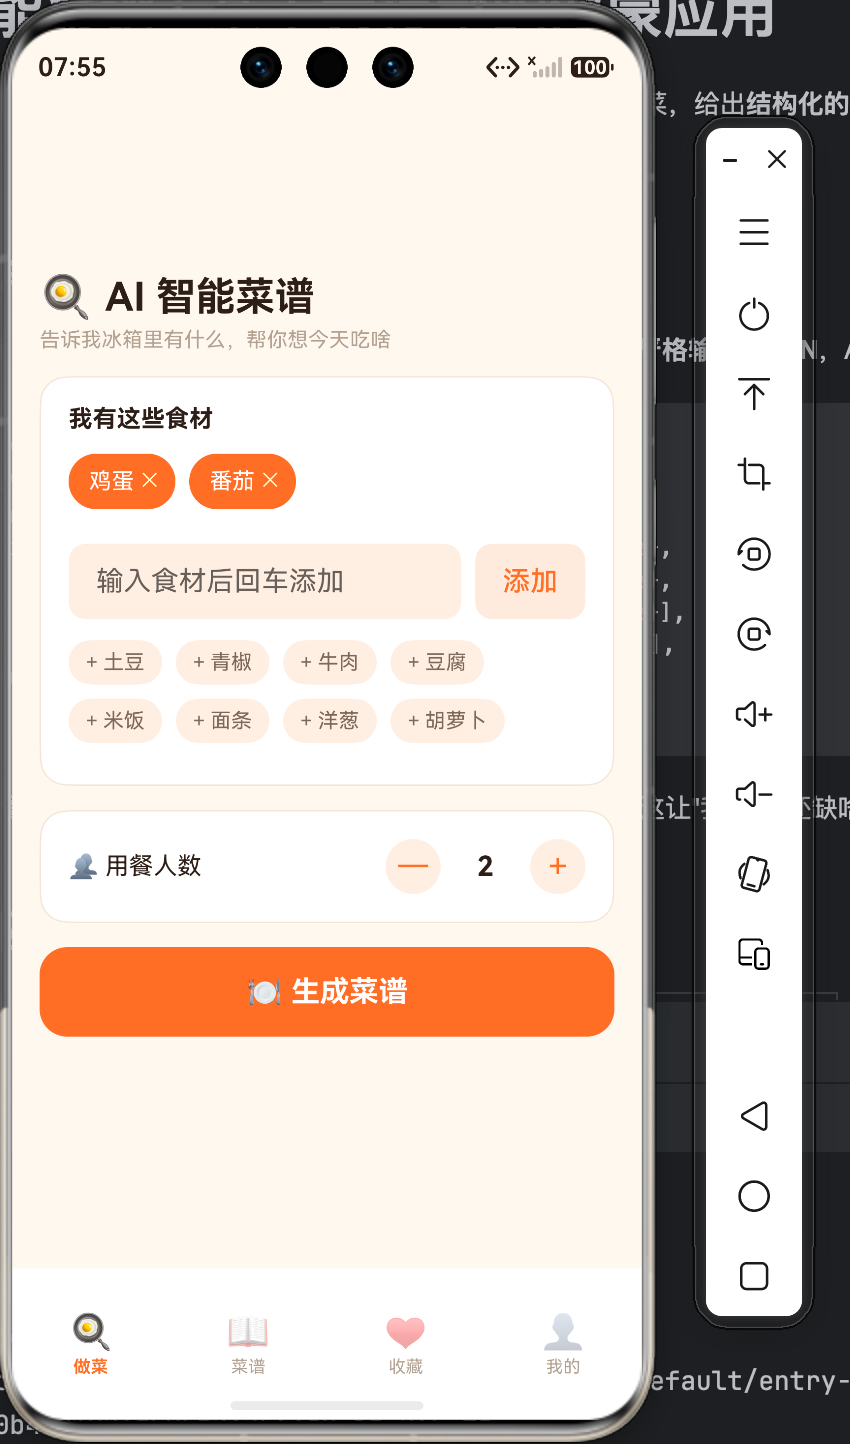
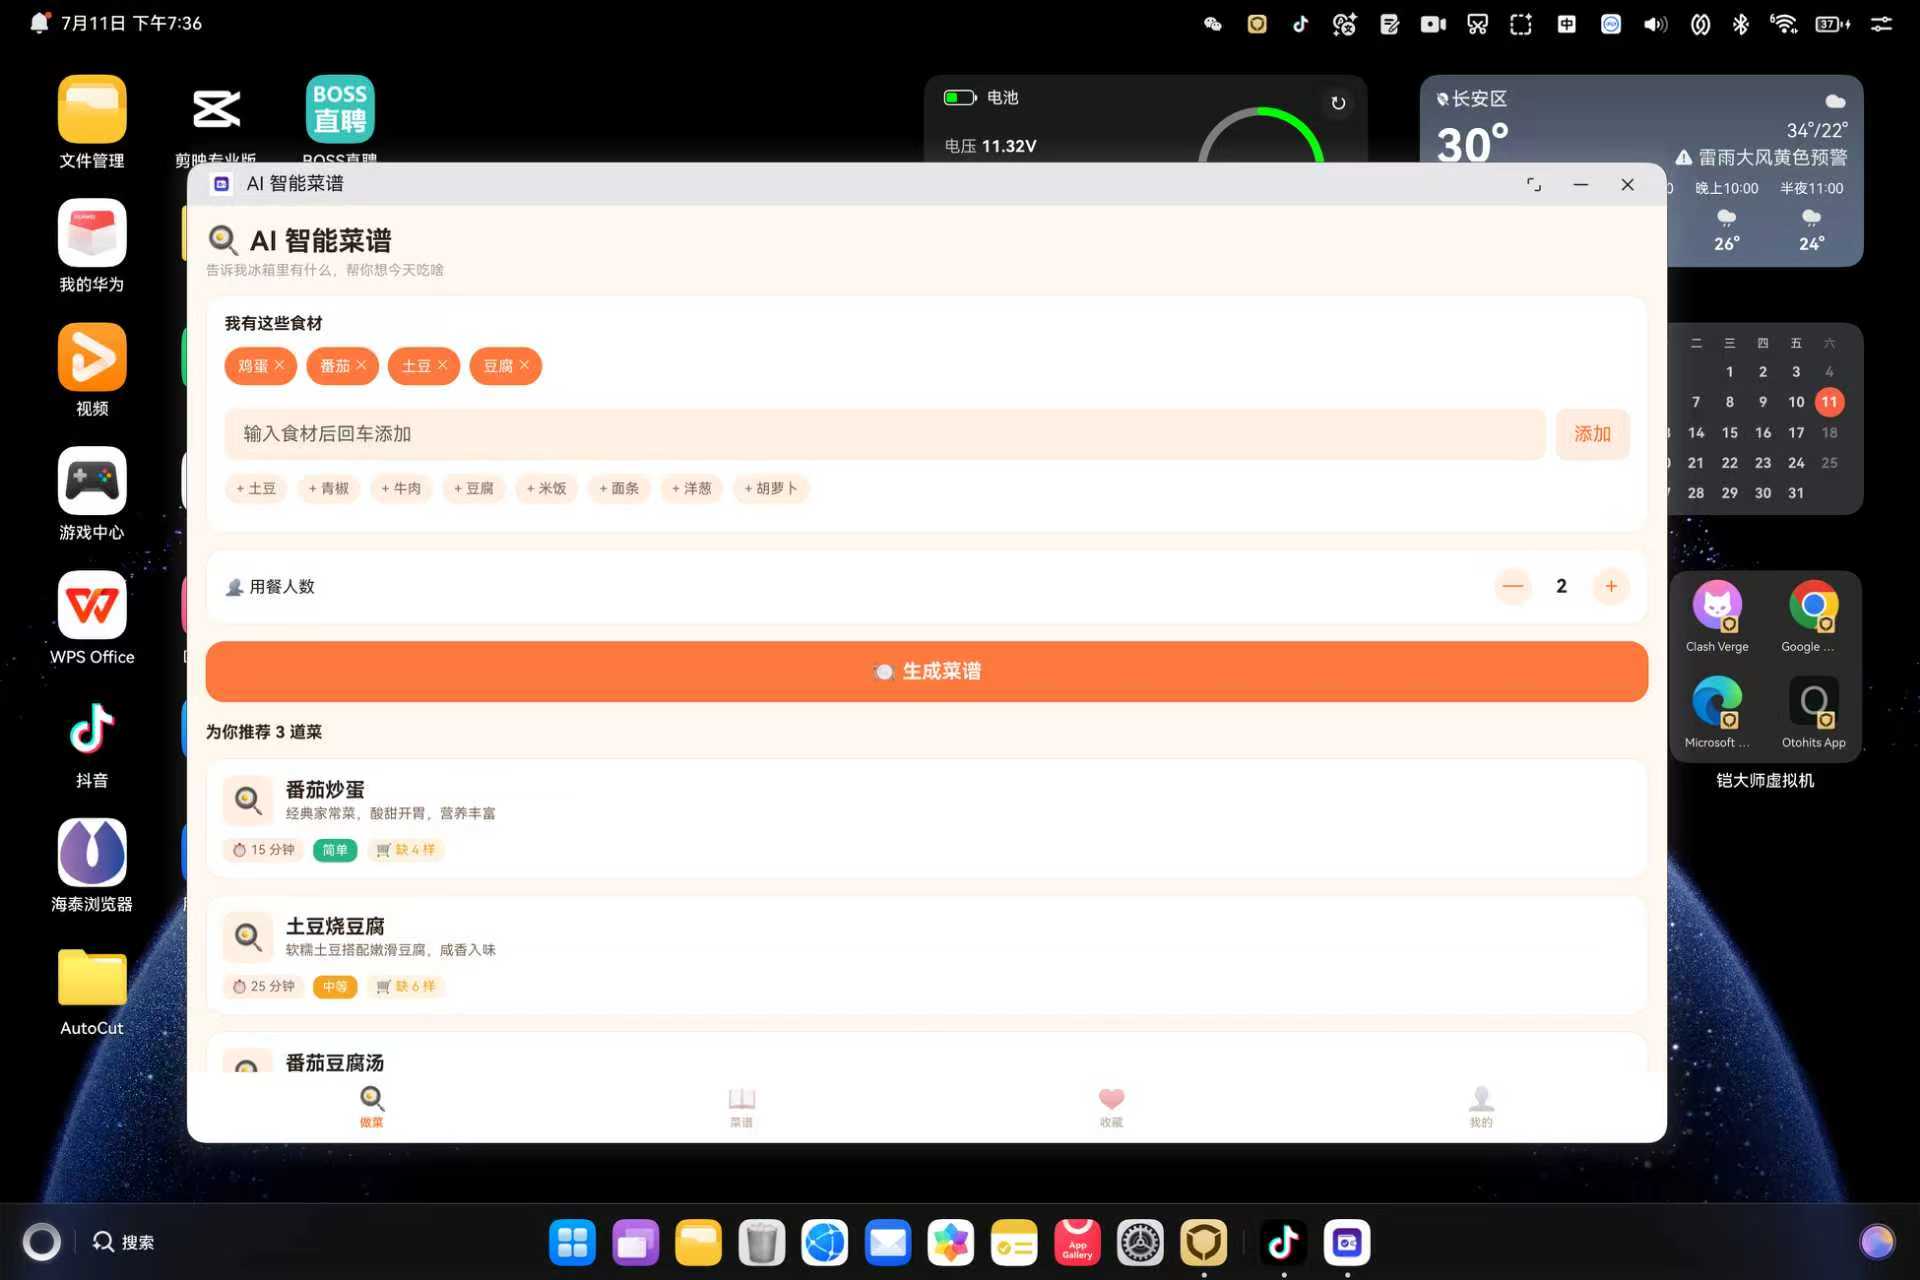
我用HarmonyOS(ArkTS/ArkUI)实现了这款应用,全程在鸿蒙PC(HUAWEI MateBook Pro)上开发运行。先看成品——这是应用的主界面,用户添加了“鸡蛋、番茄、土豆、豆腐”,AI立刻推荐了番茄炒蛋、土豆烧豆腐、番茄豆腐汤三道菜。
可以看到,AI的输出不是一段文字,而是三张结构清晰的菜谱卡片,每张都带着耗时、难度、以及“缺几样食材”的智能提示。这正是“结构化输出+原生渲染”的效果。下面我完整拆解它是怎么实现的。
架构设计:一个AI应用的分层
在写代码前先做架构。一款接入大模型的应用,最容易犯的错是把“网络请求、JSON解析、业务逻辑、UI渲染”全揉在一个页面里。这样的代码改一处牵一发,无法维护。
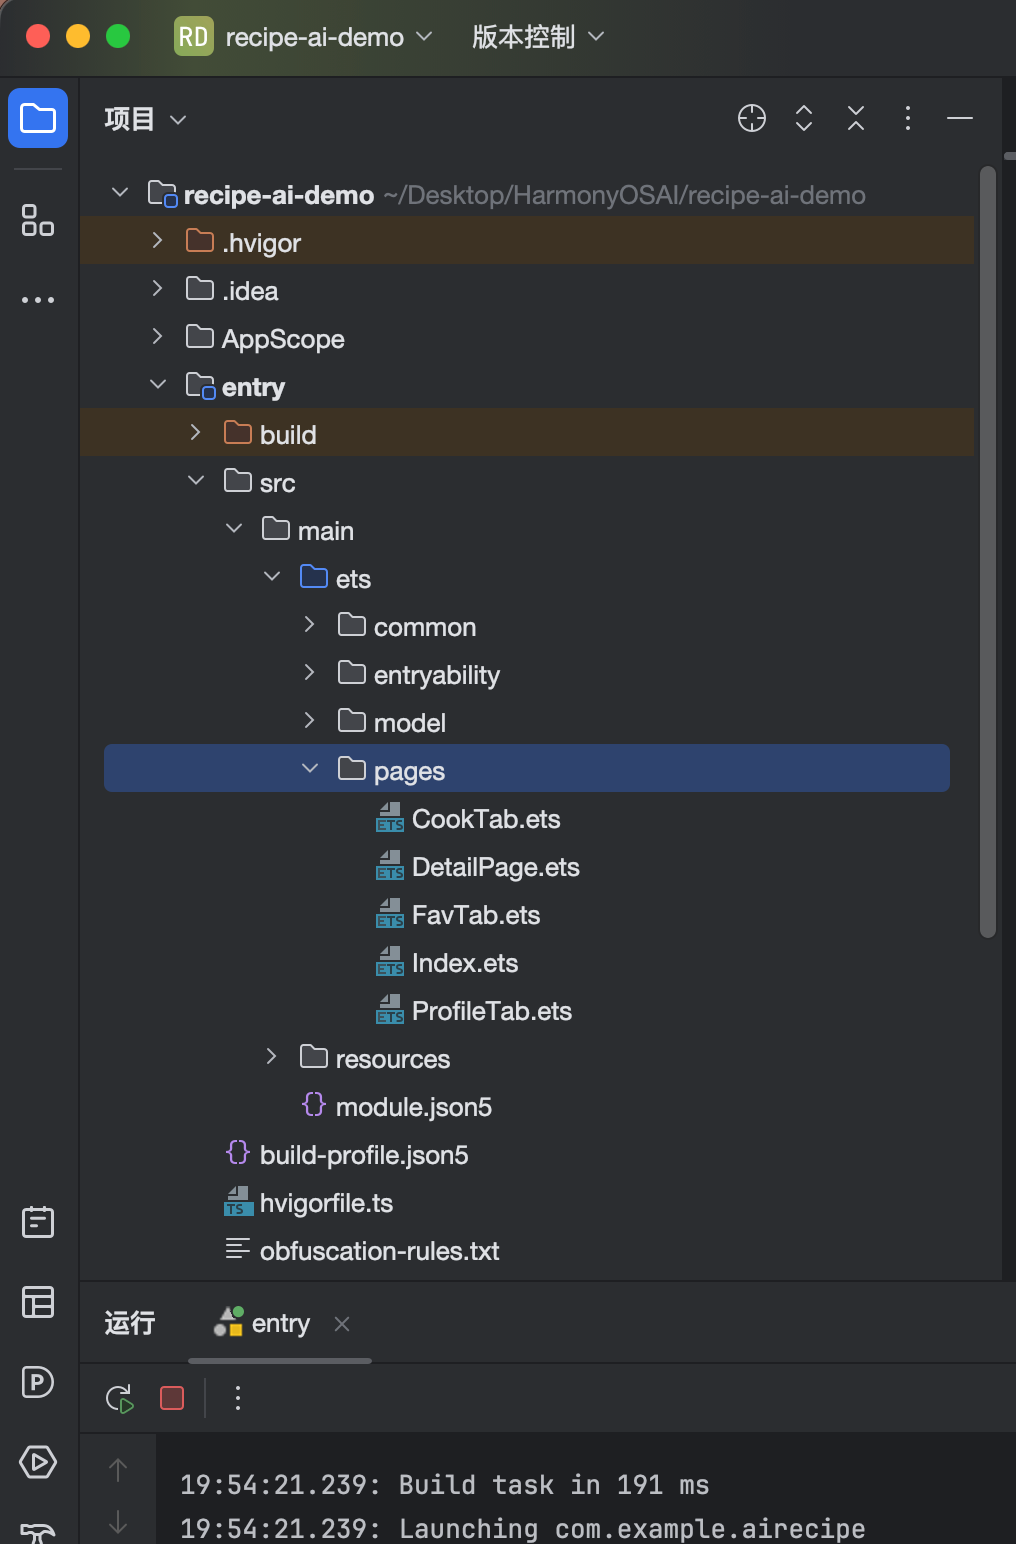
我把工程分为清晰的四层:
entry/src/main/ets/
├── entryability/ 应用入口(生命周期、窗口、安全区)
├── common/ 通用层(主题、AI配置、复用组件)
├── model/ 数据与服务层(AI服务、数据模型、会话态)
└── pages/ UI层(四个功能页)具体到文件:
├── common/
│ ├── Theme.ets 温暖美食橙主题
│ ├── AIConfig.ets ★AI服务配置+结构化输出提示词
│ └── RecipeCard.ets 菜谱卡片组件(推荐/收藏复用)
├── model/
│ ├── Recipe.ets 菜谱数据模型+收藏/偏好持久化
│ ├── RecipeAI.ets ★AI服务:请求+JSON解析(核心)
│ └── RecipeSession.ets 页面间的菜谱传递
└── pages/
├── Index.ets 四Tab主壳
├── CookTab.ets 做菜首页(食材输入+推荐)
├── DetailPage.ets 菜谱详情
├── FavTab.ets 收藏
└── ProfileTab.ets 我的/设置
分层的核心思想是单一职责:UI层只管展示和交互,绝不直接碰网络;所有与大模型的交互收敛在RecipeAI;数据结构和持久化在Recipe;配置集中在AIConfig。这样当我要调整提示词、换模型、或改UI时,改动都被限制在一层里。
核心中的核心:让大模型输出结构化JSON
这是全文最重要的部分。我们的目标是:让大模型不要返回“番茄炒蛋做法:首先……”这样的散文,而是返回一个我们能直接解析的JSON对象。
用提示词定义数据契约
实现这一点的关键,是在系统提示词里把JSON的结构(schema)明确地“喂”给模型,并强硬要求它只输出JSON。我把这段提示词放在AIConfig里:
export class AIConfig {
static readonly endpoint: string =
'https://xxxxxxxx/compatible-mode/v1/chat/completions';
static readonly apiKey: string = 'sk-****************';
static readonly model: string = 'qwen-plus';
/** 系统提示词:约束模型只输出结构化菜谱JSON */
static readonly systemPrompt: string =
'你是一位专业的家常菜大厨兼营养师。用户会告诉你现有的食材和偏好,' +
'你需要基于这些食材推荐2到3道菜,尽量充分利用已有食材。' +
'必须严格只输出JSON,不要输出任何多余文字、解释或markdown代码块标记。' +
'JSON格式如下:' +
'{"recipes":[{' +
'"name":"菜名",' +
'"desc":"一句话简介",' +
'"difficulty":"简单|中等|困难",' +
'"minutes":预计分钟数(整数),' +
'"tags":["标签1","标签2"],' +
'"ingredients":[{"name":"用料名","amount":"用量","have":true或false}],' +
'"steps":["步骤1","步骤2"],' +
'"shopping":["需要额外购买的食材1","食材2"]' +
'}]}' +
'其中have字段:用户已有的食材标true,需要额外买的标false;' +
'shopping列出所有have为false的食材。';
static readonly temperature: number = 0.8;
static readonly maxTokens: number = 1500;
static readonly timeoutMs: number = 40000;
}这段提示词有几个精心设计的点,值得逐条说明:
其一,给出完整的JSON骨架。 我没有含糊地说“请返回结构化数据”,而是把每一个字段、每一层嵌套都写清楚。大模型对这种“填空题”式的明确schema遵循度非常高——你越具体,它越听话。
其二,明令禁止多余输出。 “必须严格只输出JSON,不要输出任何多余文字、解释或markdown代码块标记”——这一句至关重要。大模型有个习惯,喜欢在JSON外面裹一层json…代码块,或者在前面加一句“好的,这是为你推荐的菜谱:”。这些都会破坏JSON解析,必须明确禁止。(当然,禁止了也不能全信,代码侧还要兜底,后面讲。)
其三,用字段承载业务语义。 have字段是这个应用的灵魂——它让模型在推荐时就判断“哪些食材用户有、哪些要买”,shopping则汇总要买的。这把“我有啥/还缺啥”这个业务逻辑,直接交给模型在生成阶段完成,而不是等数据回来后我再去比对。善用字段设计,把业务语义嵌入数据契约,是提示工程的高级技巧。
其四,temperature: 0.8。 菜谱推荐希望有一定创意和多样性(同样的食材,多点几次能有不同建议),所以温度设得比问答类应用略高。
组织请求
有了配置,RecipeAI.generate负责把用户的食材、人数、偏好组织成请求。这里要注意ArkTS的强类型约束——所有对象字面量都必须有显式的interface,否则编译报arkts-no-untyped-obj-literals:
interface ChatMessage {
role: string;
content: string;
}
interface ChatRequest {
model: string;
messages: ChatMessage[];
temperature: number;
max_tokens: number;
}
static async generate(ingredients: string[], servings: number, pref: string): Promise<RecipeResult> {
// 把用户输入拼成一句自然语言
const userMsg =
`我现在有这些食材:${ingredients.join('、')}。` +
`用餐人数:${servings}人。` +
(pref !== '' ? `我的偏好/忌口:${pref}。` : '') +
`请推荐2-3道菜。`;
const req: ChatRequest = {
model: currentModel(),
messages: [
{ role: 'system', content: AIConfig.systemPrompt }, // schema约束
{ role: 'user', content: userMsg } // 用户诉求
],
temperature: AIConfig.temperature,
max_tokens: AIConfig.maxTokens
};
// ... 发起请求
}注意这里的分工:system消息负责“你要输出什么格式”,user消息负责“我要什么内容”。这种职责分离让提示词清晰、可复用——换个应用场景,只要改system里的schema就行。
发起网络请求
用鸿蒙@kit.NetworkKit的http模块发POST请求,采用OpenAI兼容协议:
const client = http.createHttp();
try {
const resp = await client.request(AIConfig.endpoint, {
method: http.RequestMethod.POST,
header: {
'Content-Type': 'application/json',
'Authorization': 'Bearer ' + currentKey()
},
extraData: JSON.stringify(req),
connectTimeout: AIConfig.timeoutMs,
readTimeout: AIConfig.timeoutMs
});
if (resp.responseCode !== 200) {
return { ok: false, recipes: [], error: `请求失败(${resp.responseCode})` };
}
const content = RecipeAI.extractContent(`${resp.result}`);
const recipes = RecipeAI.parseRecipes(content);
if (recipes.length === 0) {
return { ok: false, recipes: [], error: '未能解析出菜谱,请换个食材再试' };
}
return { ok: true, recipes: recipes, error: '' };
} catch (e) {
return { ok: false, recipes: [], error: '网络异常,请检查连接后重试' };
} finally {
client.destroy(); // 释放资源,避免泄漏
}菜谱生成通常比普通问答耗时更长(要生成多道菜的完整结构),所以我把超时设到40秒,max_tokens也给到1500。返回结果统一封装成RecipeResult { ok, recipes, error },让UI层能优雅地处理成功和失败两种情况。
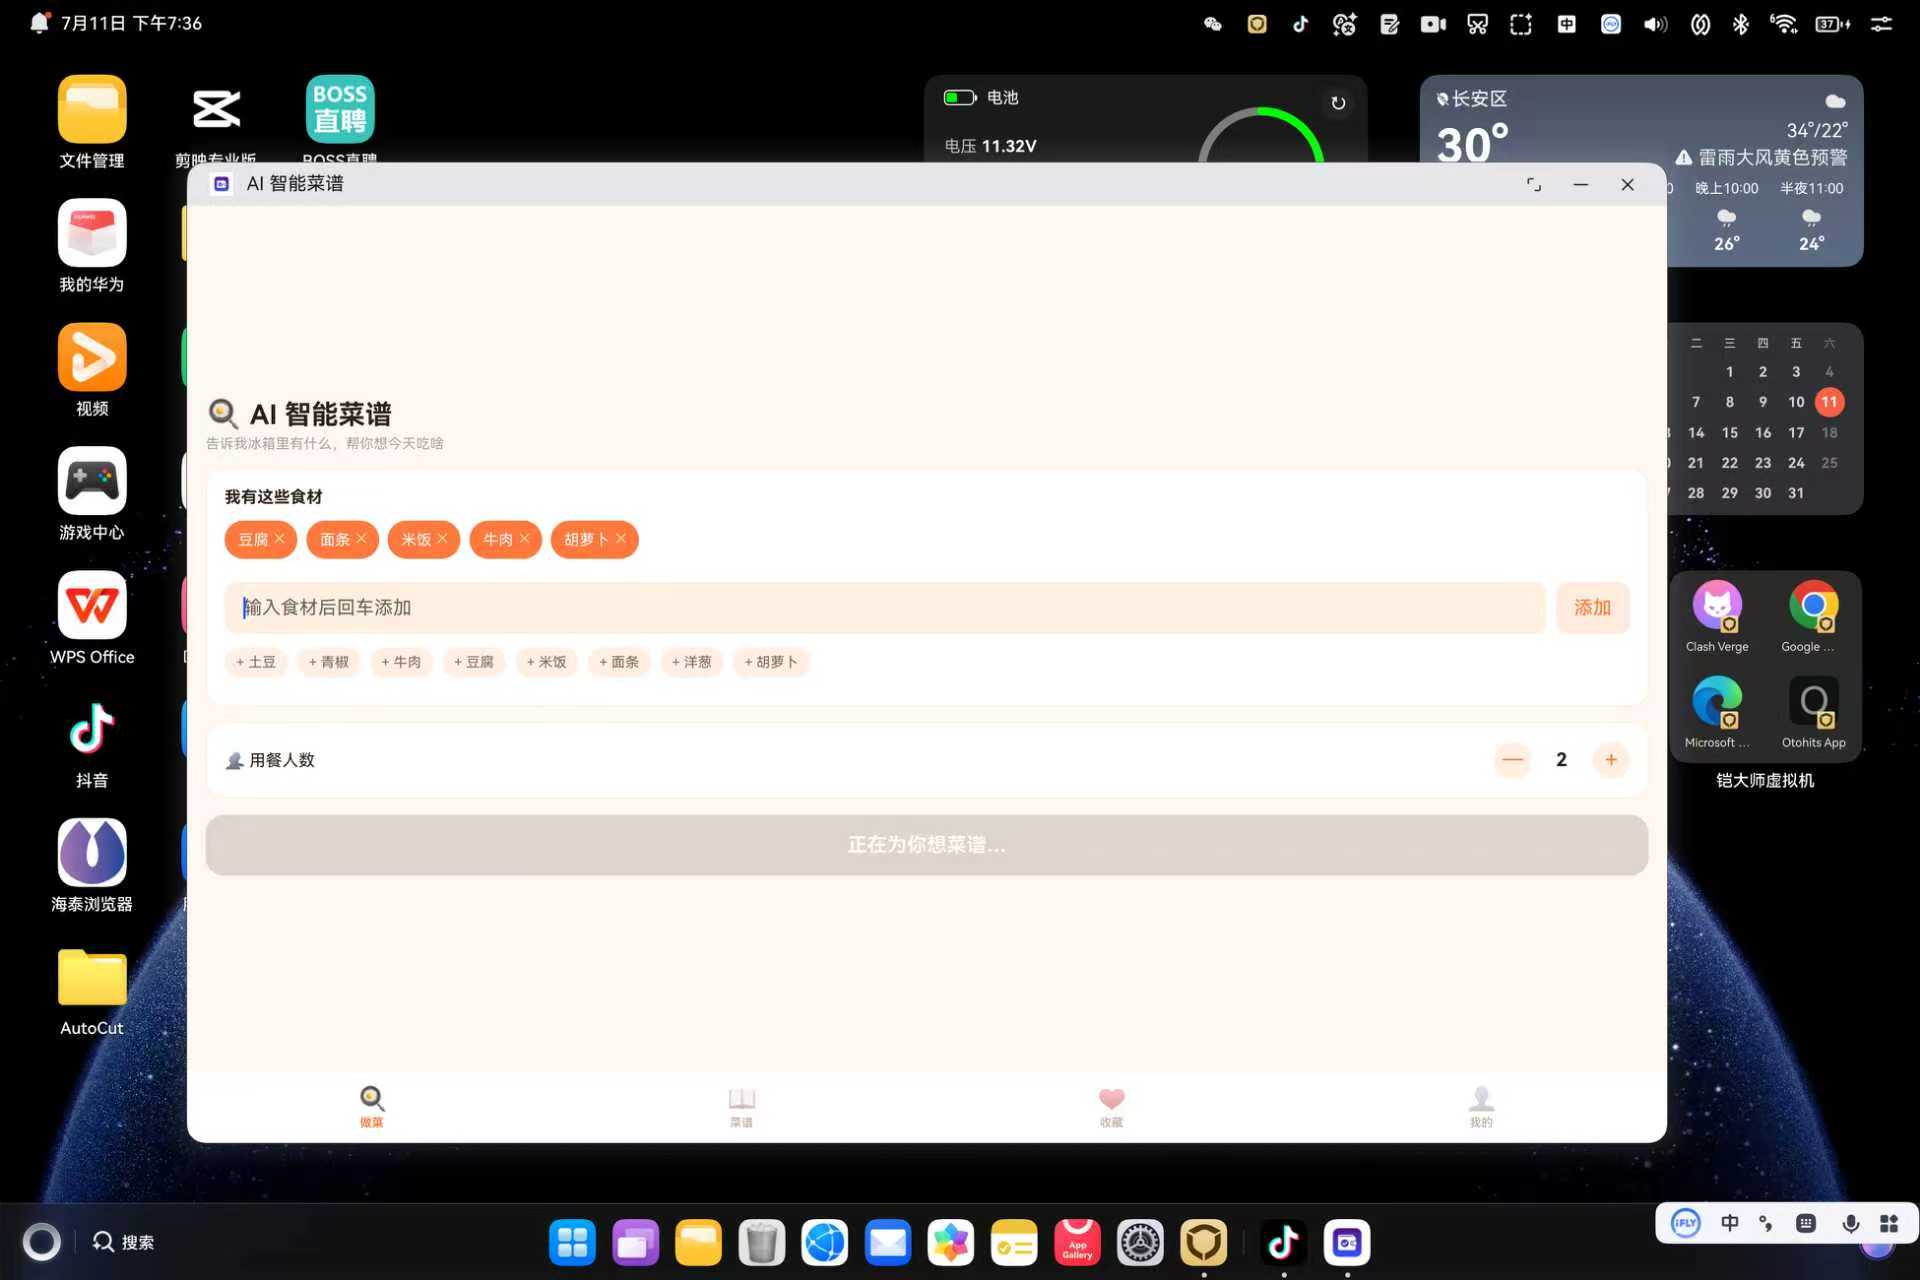
下图是点击“生成菜谱”后的加载状态——按钮变为“正在为你想菜谱…”并禁用,防止重复提交。
驯服大模型:JSON解析的容错艺术
拿到模型返回的文本后,要把它解析成Recipe[]。这一步看似简单(JSON.parse一下嘛),实则是整个应用最容易翻车的地方。
因为大模型再怎么被约束,也不是100%听话。实践中它可能:
- 在JSON外面裹一层
json…markdown代码块; - 在JSON前面加一句“好的,为你推荐:”;
- 某个字段偶尔缺失或类型不对。
如果直接JSON.parse(rawText),遇到上面任何一种情况都会抛异常、整个功能崩溃。所以解析层必须做足容错。
先提取纯净的JSON
我的策略是:不管模型返回什么,只截取第一个{到最后一个}之间的内容,把外层的markdown标记、寒暄语全部剥掉:
private static parseRecipes(content: string): Recipe[] {
let text = content.trim();
// 剥离```json```包裹、前后寒暄——只留JSON主体
const start = text.indexOf('{');
const end = text.lastIndexOf('}');
if (start >= 0 && end > start) {
text = text.substring(start, end + 1);
}
try {
const obj = JSON.parse(text) as Record<string, Object>;
const arr = obj['recipes'] as Object[];
if (arr === undefined) { return []; }
const result: Recipe[] = [];
for (const item of arr) {
result.push(RecipeAI.toRecipe(item as Record<string, Object>));
}
return result;
} catch (e) {
return []; // 解析失败返回空,由上层提示用户重试
}
}这个“截取首尾大括号”的技巧很朴素但极其有效,能挡掉绝大多数模型不听话的情况。
逐字段安全提取
即使JSON能解析,也不能假设每个字段都完美存在。所以toRecipe里对每个字段都做了兜底:
private static toRecipe(r: Record<string, Object>): Recipe {
const ings: Ingredient[] = [];
const rawIngs = r['ingredients'] as Object[];
if (rawIngs !== undefined) {
for (const it of rawIngs) {
const o = it as Record<string, Object>;
ings.push({
name: `${o['name'] ?? ''}`,
amount: `${o['amount'] ?? ''}`,
have: o['have'] === true // 严格判断布尔
});
}
}
return {
name: `${r['name'] ?? '未命名菜品'}`, // 缺失给默认名
desc: `${r['desc'] ?? ''}`,
difficulty: `${r['difficulty'] ?? '简单'}`, // 缺失给默认难度
minutes: Number(r['minutes'] ?? 20),
tags: RecipeAI.toStrArr(r['tags']),
ingredients: ings,
steps: RecipeAI.toStrArr(r['steps']),
shopping: RecipeAI.toStrArr(r['shopping'])
};
}
每个字段都用?? 默认值兜底,数组字段用统一的toStrArr转换。这样即使模型漏了某个字段,应用也只是显示一个默认值,而不会崩溃。“永远不要相信外部输入”这条工程铁律,在AI应用里要升级为“永远不要完全相信模型输出”。
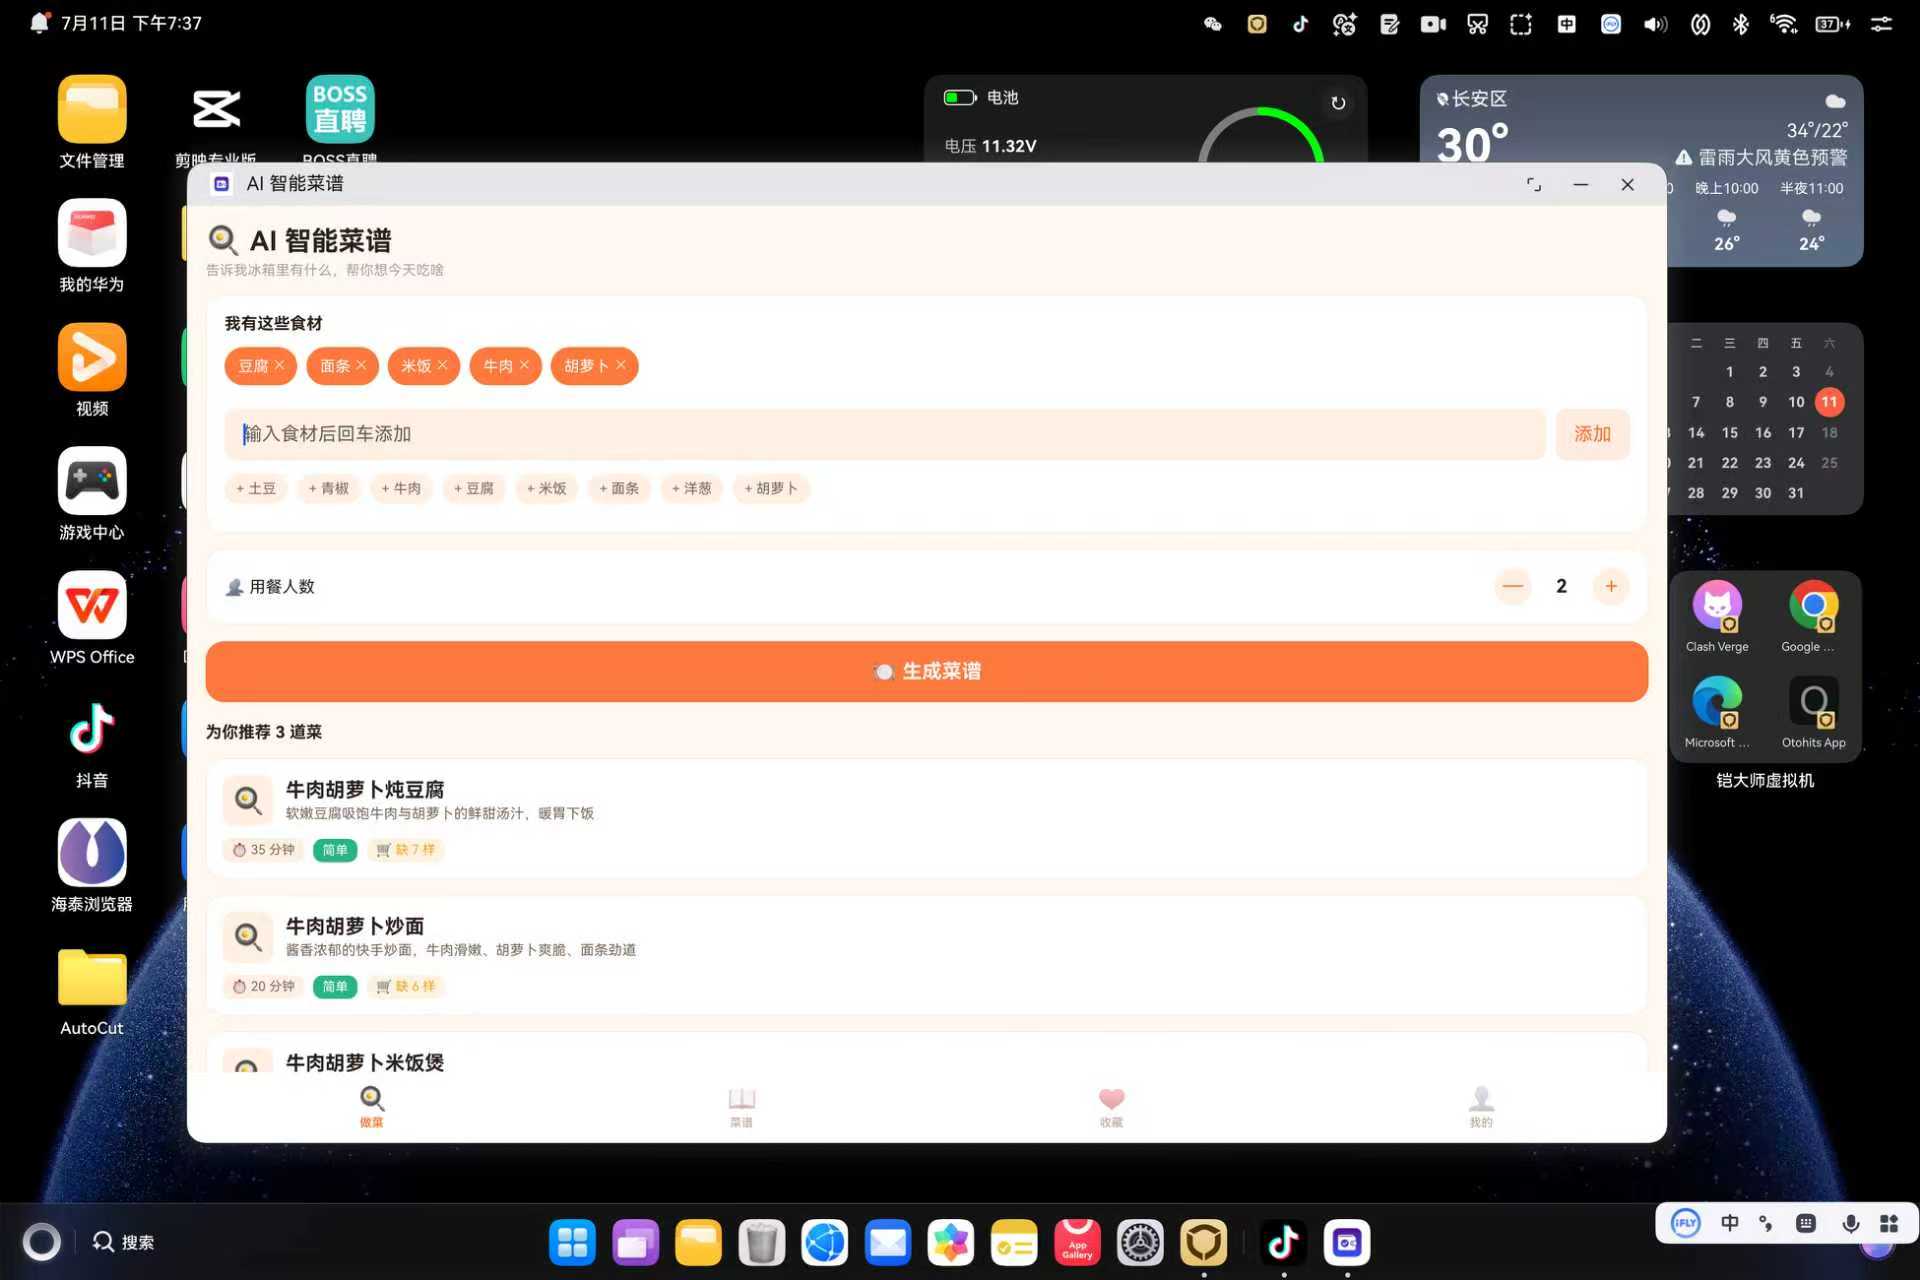
正是这套“提示词约束+解析容错”的组合拳,让应用能稳定地把AI的输出变成可靠的结构化数据。下图展示了另一组食材(豆腐、面条、米饭、牛肉、胡萝卜)的推荐结果,可以看到即使食材组合完全不同,输出结构依然稳定:
牛肉胡萝卜炖豆腐、牛肉胡萝卜炒面、牛肉胡萝卜米饭煲——AI很聪明地围绕这几样食材做了不同的组合,每道菜的描述也生动到位(“软嫩豆腐吸饱牛肉与胡萝卜的鲜甜汤汁”)。
功能页一:做菜首页
首页承担“输入食材→触发生成→展示推荐”的完整流程。
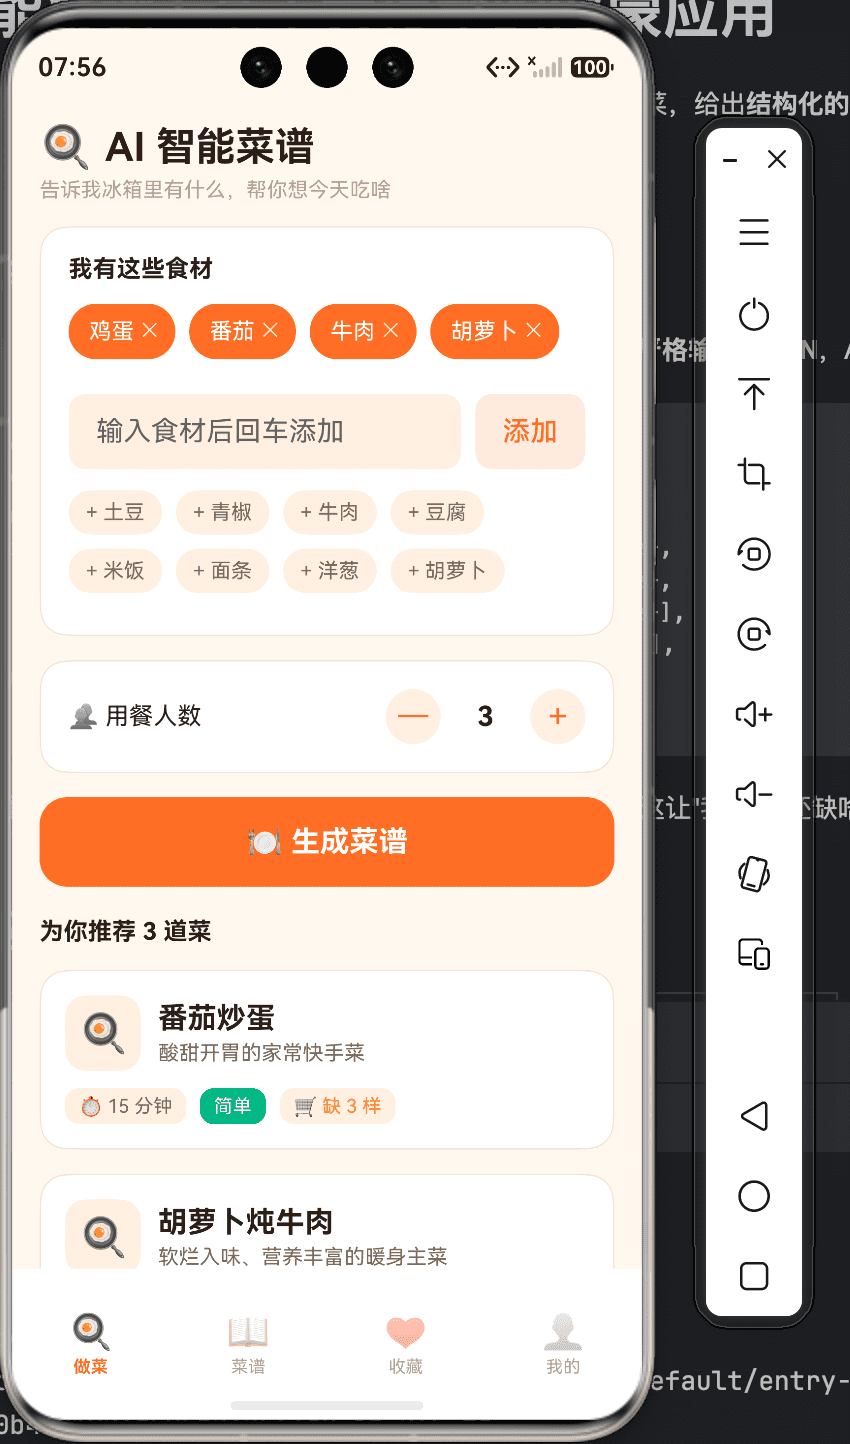
标签式食材输入
食材用标签(chip)的形式管理,可点击删除,还提供常见食材的快捷添加。核心是一个@State ingredients: string[],配合Flex自动换行布局:
@State ingredients: string[] = ['鸡蛋', '番茄']; // 内置示例,开箱即用
@State input: string = '';
addIng(): void {
const v = this.input.trim();
if (v === '' || this.ingredients.includes(v)) { return; } // 去重
this.ingredients.push(v);
this.ingredients = this.ingredients.slice(); // 触发UI刷新
this.input = '';
}这里this.ingredients = this.ingredients.slice()是ArkUI的关键技巧——对@State数组做浅拷贝赋值才能可靠触发重渲染,直接push有时不生效。
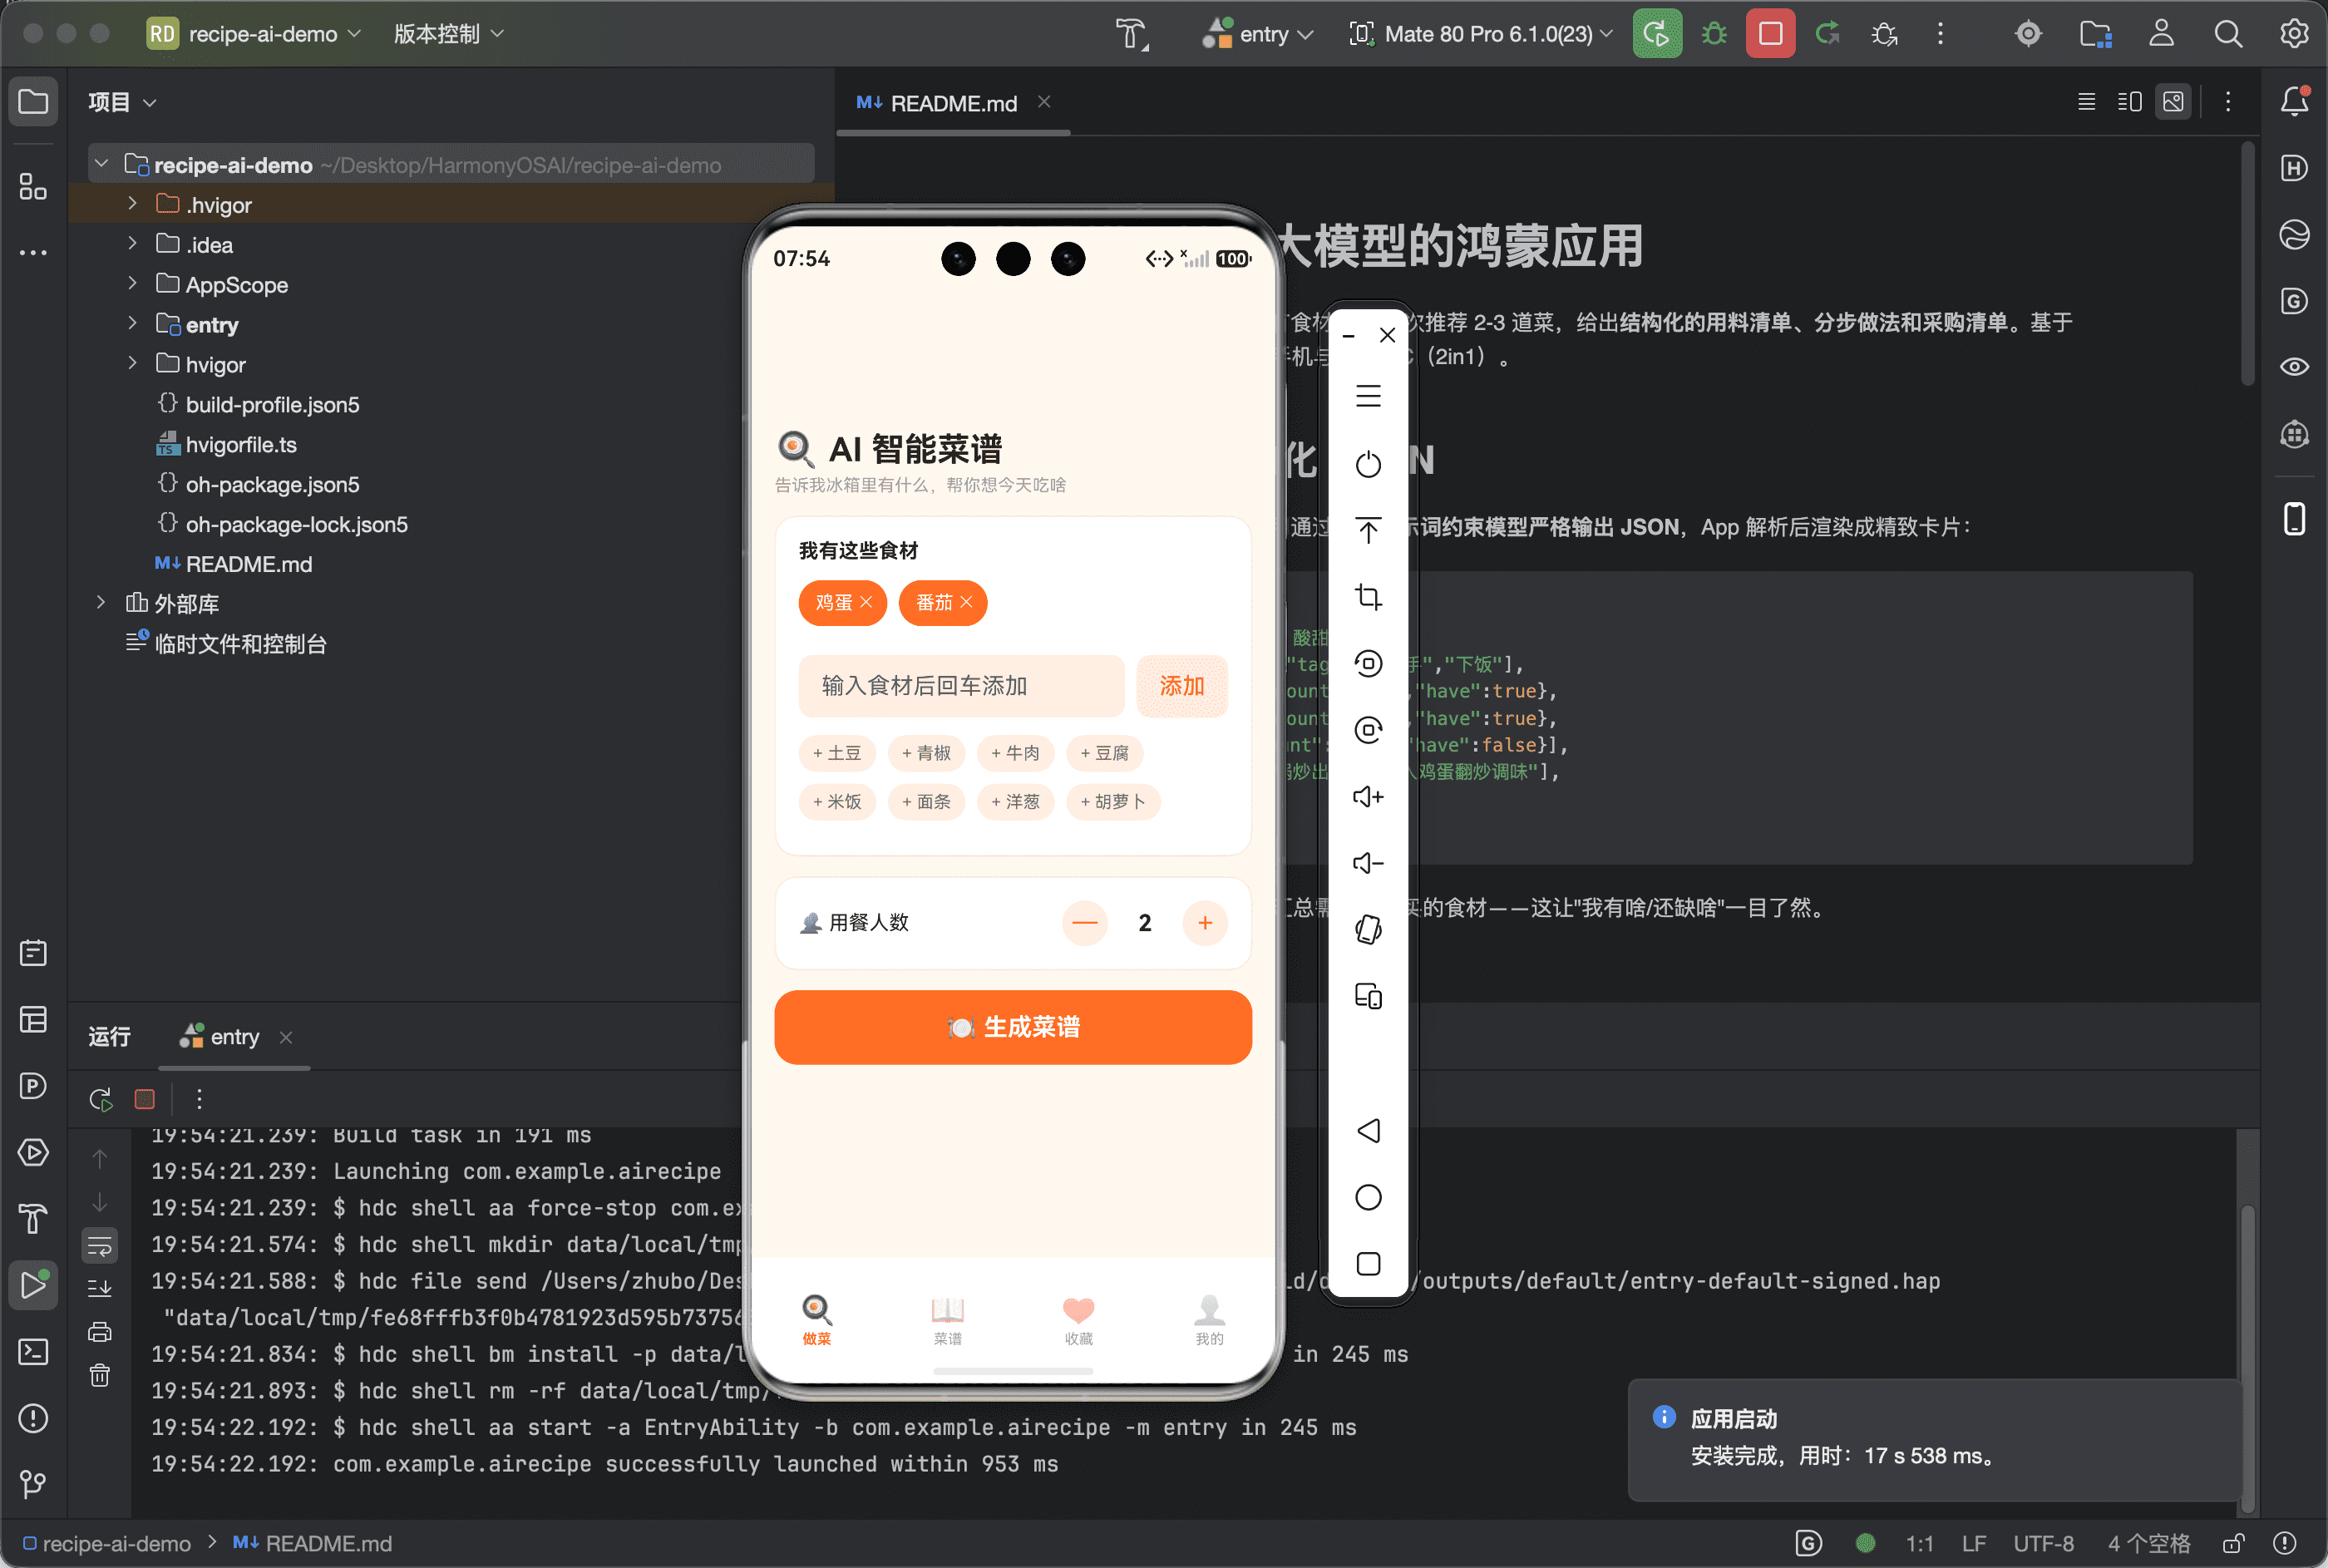
UI上,已添加的食材是橙色可删标签,下方是快捷添加区(土豆、青椒、牛肉……点一下即添加)。这种设计降低了输入成本,用户不用一个个手打。
触发生成与结果展示
点击生成按钮,调用RecipeAI.generate,根据返回结果更新UI:
async onGenerate(): Promise<void> {
if (this.ingredients.length === 0) {
promptAction.showToast({ message: '请先添加至少一种食材', duration: 1500 });
return;
}
this.loading = true;
this.results = [];
const res = await RecipeAI.generate(this.ingredients, this.servings, this.pref);
this.loading = false;
if (!res.ok) {
promptAction.showToast({ message: res.error, duration: 2000 });
return;
}
this.results = res.recipes;
RecipeSession.setResults(res.recipes);
}loading状态驱动按钮文案与禁用,results一旦有值就渲染成菜谱卡片列表。成功、失败(网络/解析错误)都有对应处理,不会让用户面对无响应的界面。
功能页二:菜谱卡片与详情页
复用的菜谱卡片组件
推荐列表和收藏列表都要展示菜谱卡片,所以我把它抽成独立组件RecipeCard,通过@Prop接收数据、回调传递点击:
@Component
export struct RecipeCard {
@Prop recipe: Recipe;
onTap?: (r: Recipe) => void;
// ... 展示菜名、简介、耗时、难度、缺料提示
}卡片上有个体现细节的设计——根据shopping数组动态显示食材状态:
if (this.recipe.shopping.length > 0) {
Text('🛒 缺' + this.recipe.shopping.length + '样') // 缺料,橙色提示
} else {
Text('✓ 食材齐全') // 齐全,绿色提示
}难度也用颜色区分(简单绿、中等黄、困难红),用户扫一眼就能判断这道菜适不适合现在做。
详情页:结构化数据的完整呈现
详情页是“结构化输出”价值的集中体现。因为数据是结构化的,我可以把它渲染成层次分明的几个区块:标题标签区、用料清单、采购清单、分步做法。
用料清单里,have字段的价值就体现出来了——已有的食材标绿色✓,需要买的标橙色🛒:
ForEach(this.recipe.ingredients, (ing: Ingredient) => {
Row() {
Text(ing.have ? '✓' : '🛒')
.fontColor(ing.have ? C.accent : C.gold) // 已有绿/待买橙
Text(ing.name).layoutWeight(1)
Text(ing.amount).fontColor(C.textSub)
}
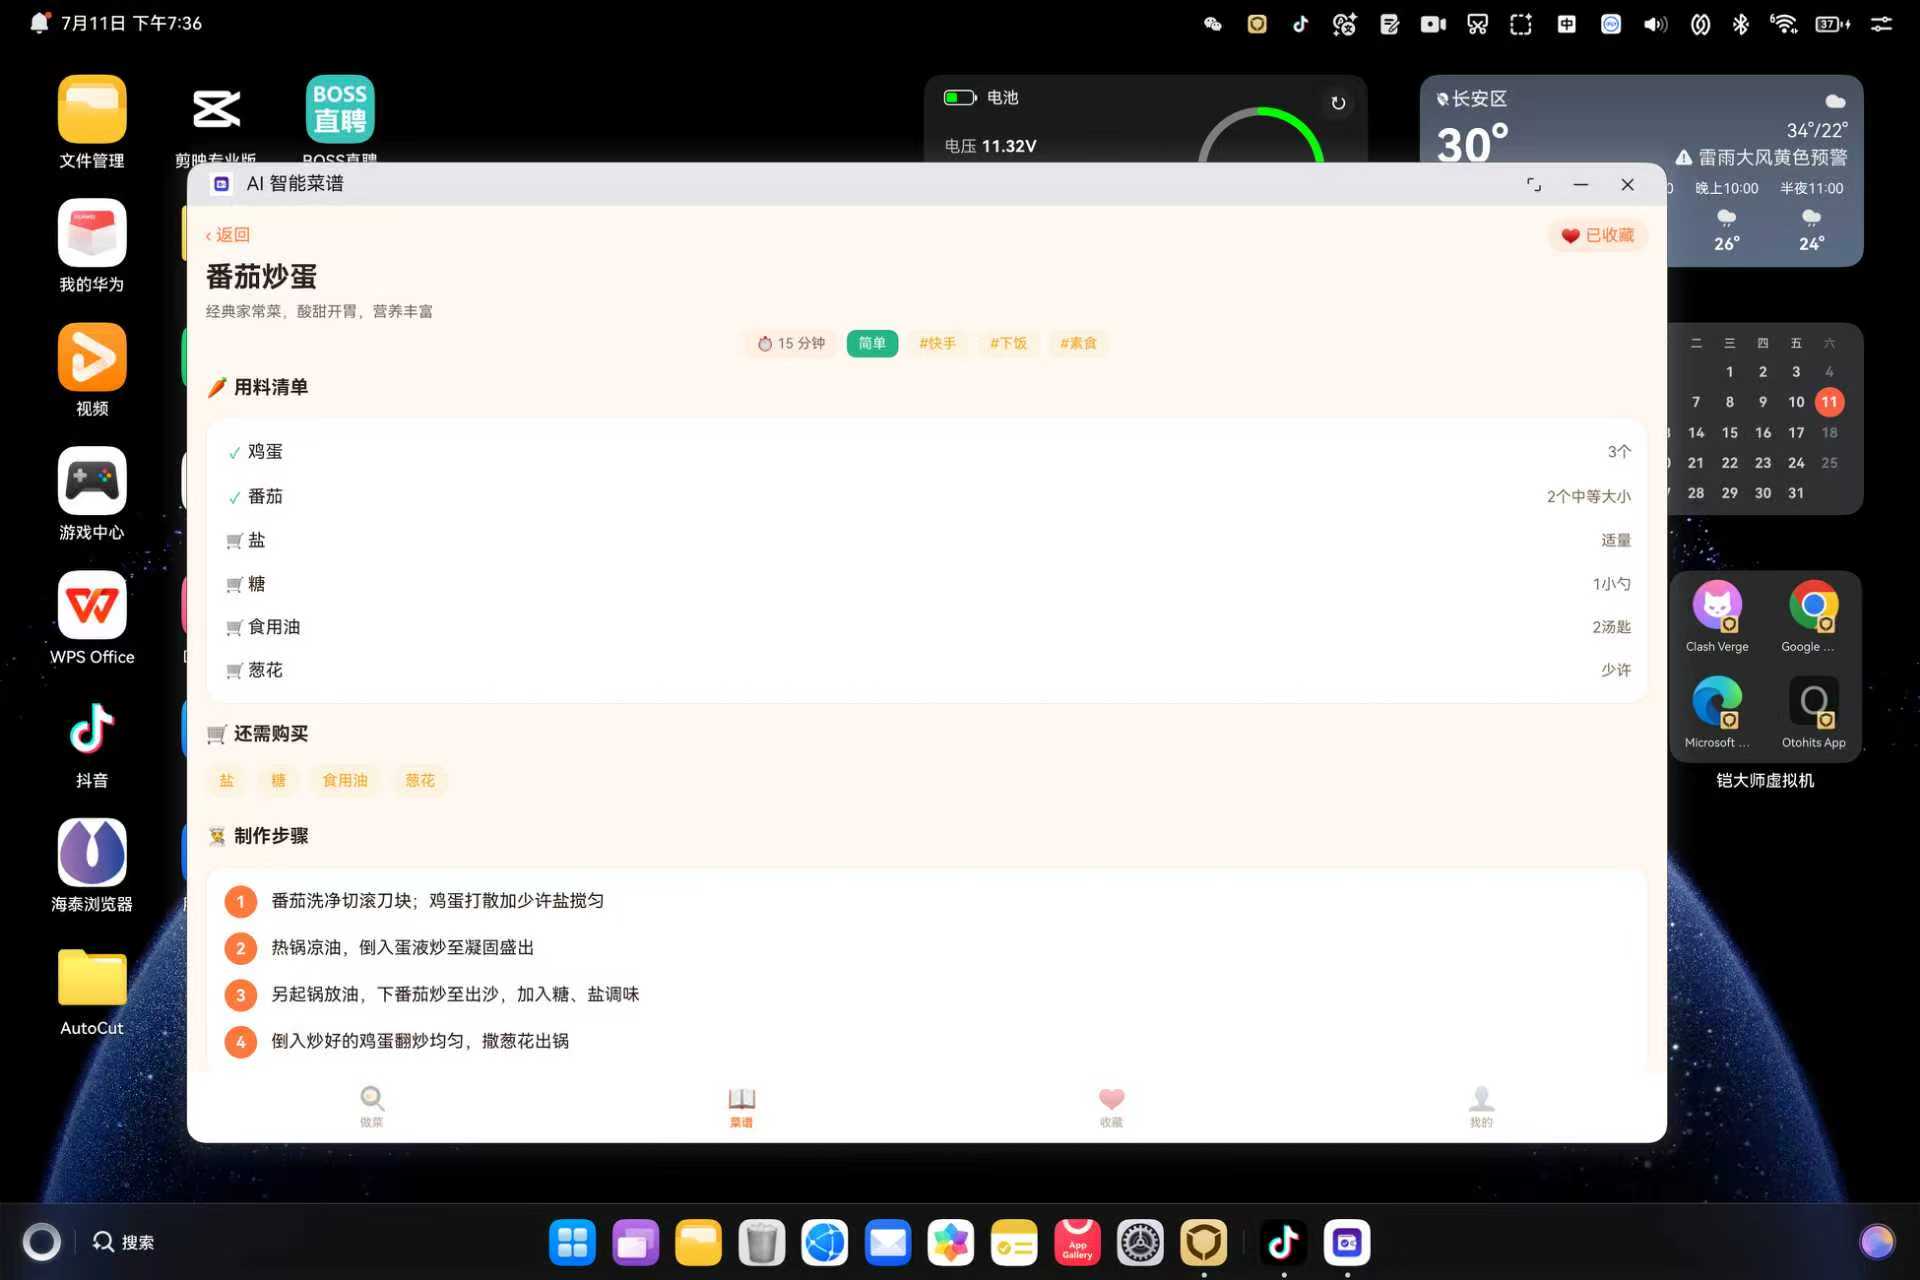
}, (ing: Ingredient) => ing.name)制作步骤则用带序号圆标的列表,清晰易读。下图是“番茄炒蛋”的完整详情页:
可以看到,一份原本是AI文本的菜谱,被完整地结构化呈现:15分钟、简单、#快手#下饭#素食标签,用料清单区分了已有的鸡蛋番茄(✓)和需买的盐糖油葱(🛒),下方是“还需购买”的采购清单和四步做法。右上角还能一键收藏。这就是结构化输出相比纯文本的降维打击——数据可以被精确地摆放、着色、交互。
页面间的数据传递
从首页/收藏点击某道菜进入详情,我用一个轻量的RecipeSession单例来传递当前菜谱,避免复杂的路由传参:
export class RecipeSession {
private static current: Recipe | null = null;
static setCurrent(r: Recipe): void {
RecipeSession.current = r;
AppStorage.setOrCreate('currentRecipeName', r.name); // 触发详情页@Watch刷新
}
static getCurrent(): Recipe | null { return RecipeSession.current; }
}配合Tab切换(点击卡片切到“菜谱”Tab),实现了流畅的浏览体验。
功能页三、四:收藏与个性化设置
收藏:本地持久化
喜欢的菜谱可以收藏,用Preferences存到本地。RecipeStore封装了收藏的增删查:
static async addFav(r: Recipe): Promise<void> {
const list = await RecipeStore.listFavorites();
if (!list.some((x: Recipe) => x.name === r.name)) { // 去重
list.unshift(r);
await RecipeStore.saveFav(list);
}
}收藏页展示所有收藏,支持左滑删除。收藏的是完整的菜谱结构,所以离线也能查看已收藏菜谱的完整做法——这是结构化存储的又一好处。
设置:让偏好影响AI
“我的”页最有价值的是饮食偏好功能。用户勾选“清淡少油、无辣、素食、低卡”等标签,或自定义输入,这些偏好会被拼进发给AI的请求里:
const userMsg = `我现在有这些食材:${ingredients.join('、')}。` +
`用餐人数:${servings}人。` +
(pref !== '' ? `我的偏好/忌口:${pref}。` : '') + // 偏好注入
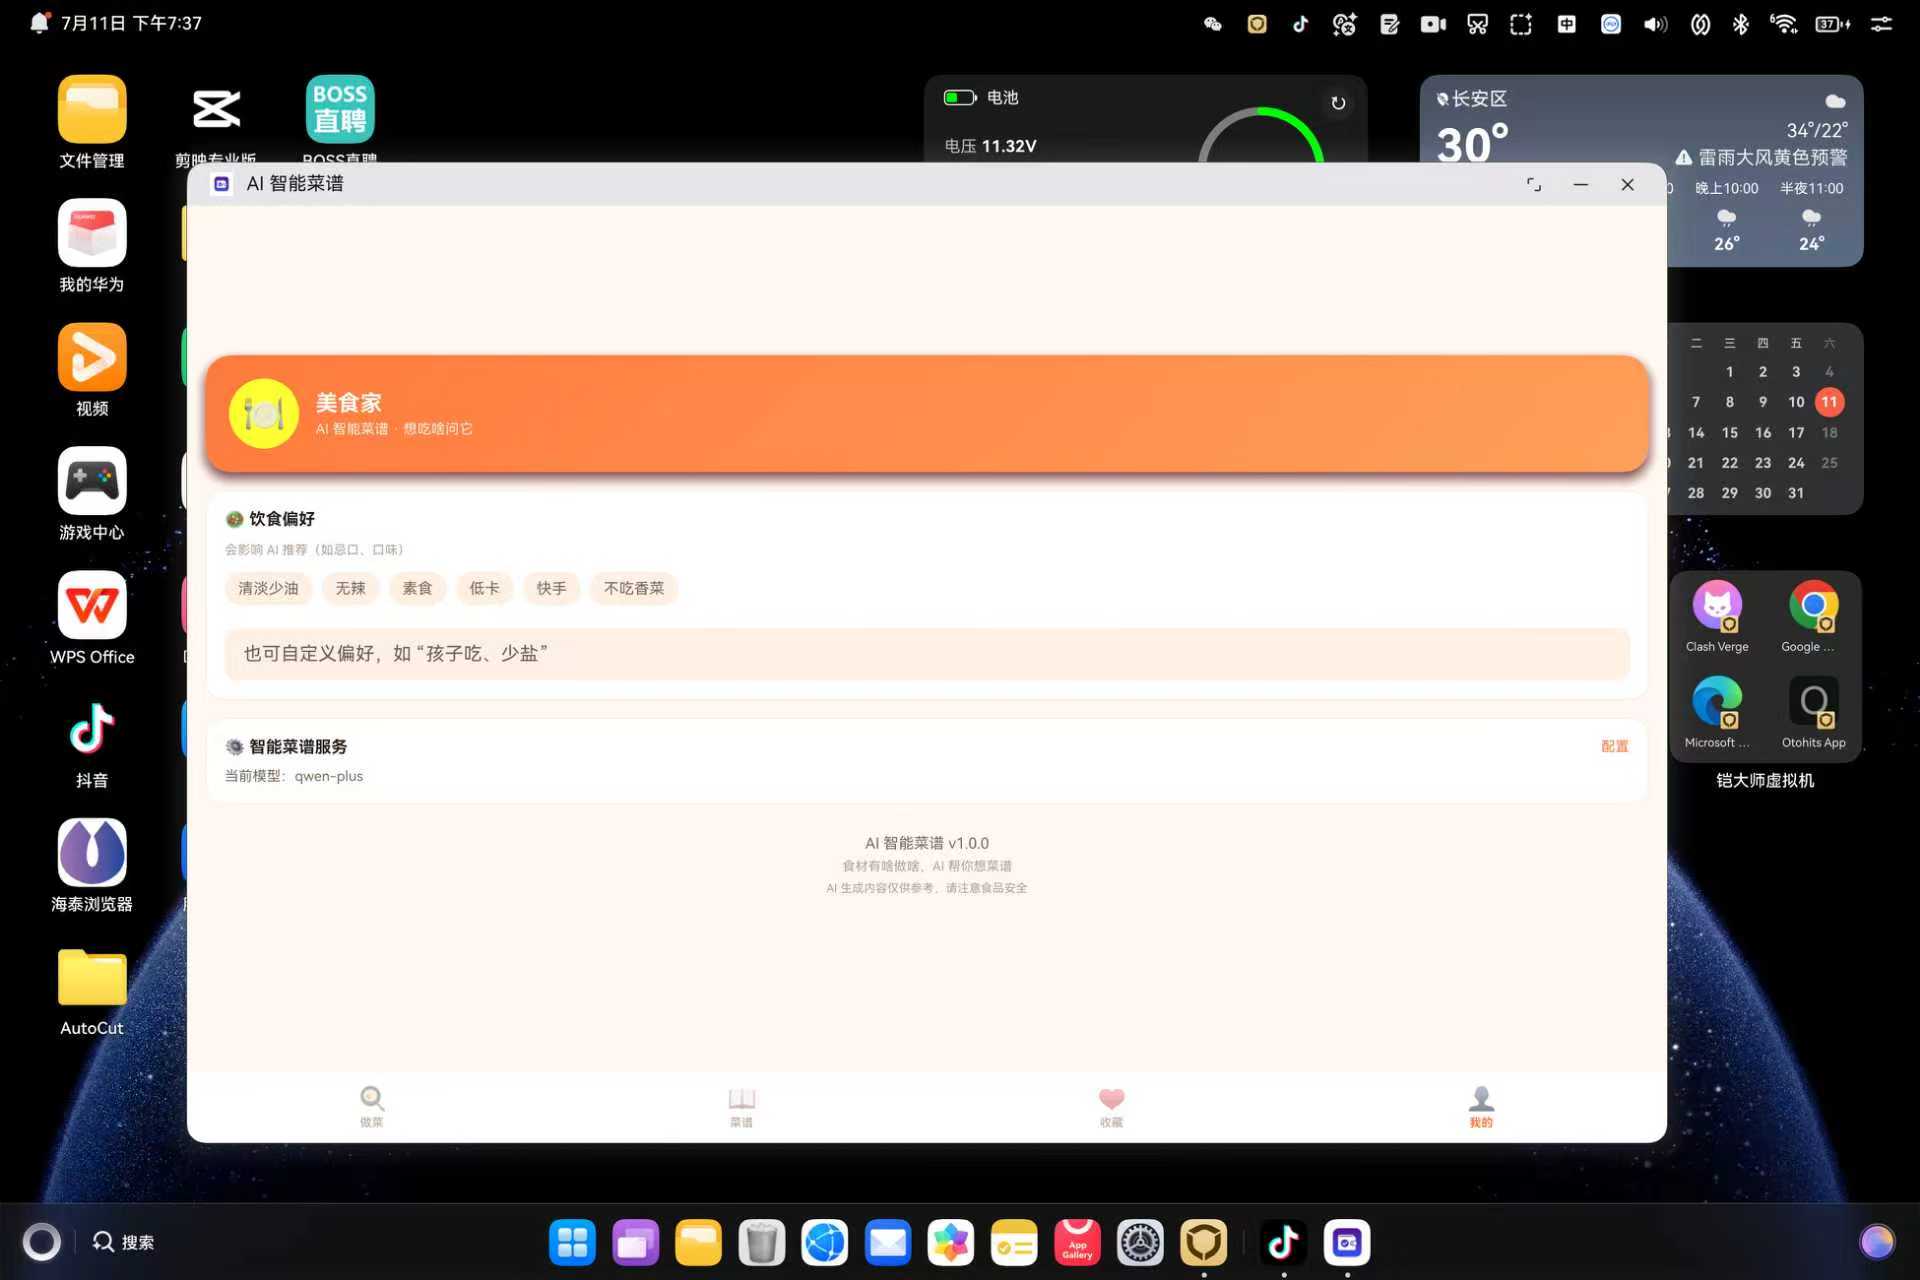
`请推荐2-3道菜。`;这样AI推荐就会考虑用户的忌口和口味——素食者不会被推荐红烧肉,怕辣的不会收到麻辣香锅。用一个简单的偏好字段,就让推荐从“通用”变成“个性化”,这正是大模型灵活性的体现。设置页还提供模型服务配置(可运行时覆盖密钥和模型)。下图是设置页:
顶部橙色渐变的“美食家”卡片,下面是饮食偏好标签、智能菜谱服务配置(显示当前模型),整体延续了温暖的美食橙色调。
应用入口与鸿蒙PC适配
入口初始化
EntryAbility在onWindowStageCreate里初始化存储、配置沉浸式全屏、计算安全区:
async onWindowStageCreate(windowStage: window.WindowStage): Promise<void> {
await RecipeStore.init(this.context);
windowStage.loadContent('pages/Index', (err) => {
if (err.code) { return; }
const win = windowStage.getMainWindowSync();
win.setWindowLayoutFullScreen(true);
const top = win.getWindowAvoidArea(window.AvoidAreaType.TYPE_SYSTEM);
const bottom = win.getWindowAvoidArea(window.AvoidAreaType.TYPE_NAVIGATION_INDICATOR);
AppStorage.setOrCreate('safeTop', px2vp(top.topRect.height));
AppStorage.setOrCreate('safeBottom', px2vp(bottom.bottomRect.height));
});
}鸿蒙PC上的表现
本文所有截图都是在华为MateBook Pro(鸿蒙PC)上运行的。应用以窗口形式跑在电脑桌面,同一套ArkTS代码无需修改就能适配PC大屏。
能做到这一点,靠的是几个原则:module.json5里声明"deviceTypes": ["phone", "tablet", "2in1"]把PC形态纳入;UI全程用弹性布局(layoutWeight、百分比、Flex换行),不写死尺寸;安全区逻辑统一处理手机刘海与PC窗口边框。
对菜谱这类应用来说,PC大屏其实体验更好:食材输入用物理键盘更顺手,菜谱详情的多区块内容在大窗口里一览无余,做菜时把电脑架在厨房台面上看菜谱也很实用。
四Tab主壳
最后用Tabs把四个页面组织起来。这里有个巧妙设计——“菜谱”Tab就是详情页,从做菜或收藏点击某道菜时,通过回调切到该Tab展示:
Tabs({ barPosition: BarPosition.End, index: this.current }) {
TabContent() { CookTab({ onOpenDetail: () => { this.current = 1; } }) }
.tabBar(this.bar('做菜', '🍳', 0))
TabContent() { DetailPage({ onBack: () => { this.current = 0; } }) }
.tabBar(this.bar('菜谱', '📖', 1))
TabContent() { FavTab({ onOpenDetail: () => { this.current = 1; } }) }
.tabBar(this.bar('收藏', '♥', 2))
TabContent() { ProfileTab() }.tabBar(this.bar('我的', '👤', 3))
}
.scrollable(false) // 禁用滑动切换,避免与页面内滚动冲突踩坑与经验小结
开发过程中的几个关键经验,供参考:
坑一:大模型不老实输出JSON。 这是AI结构化应用最大的坑。解决靠“提示词强约束+解析层截取首尾大括号+逐字段兜底”三重防线,缺一不可。只靠提示词,模型偶尔还是会加markdown包裹;只靠解析,提示词不给力时JSON结构会乱。
坑二:ArkTS严格类型。 所有对象字面量必须有显式interface,ChatRequest、Recipe、Ingredient都得定义好,否则arkts-no-untyped-obj-literals编译不过。这比普通TypeScript严格得多。
坑三:@State数组刷新。 增删食材、更新结果列表时,要this.arr = this.arr.slice()触发刷新。
坑四:AI请求要给足超时。 生成多道完整菜谱比普通问答慢,readTimeout给到40秒,否则容易超时失败。
坑五:网络与解析都要兜底。 把结果统一封装成{ ok, recipes, error },任何失败都返回友好中文提示,绝不让用户对着空白或崩溃的界面。
可扩展方向与总结
这款应用已经是一个四页齐全、可真机运行的完整作品。继续深化的方向:
- 食材图像识别:拍一张冰箱照片,用多模态大模型识别出食材,自动填入——彻底免去手动输入。
- 营养分析:让模型额外返回每道菜的热量、蛋白质等,做健康管理。
- 一键生成采购清单:把多道菜的
shopping合并去重,生成一份完整购物清单。 - 流式输出:菜谱逐字生成,减少等待焦虑。
- 本地菜谱缓存:把生成过的菜谱缓存,相同food组合直接复用,省token。
回顾整个项目,它虽然是个“想吃啥”的小工具,却完整演示了AI应用开发最核心的一课——如何把大模型不确定的自然语言输出,转化为确定的、结构化的、可交互的应用数据。这套“提示词定义schema+解析层容错+结构化渲染”的方法论,适用于几乎所有需要AI生成结构化内容的场景:不只是菜谱,还有行程规划、简历生成、数据报表、表单填充……
如果你也想在HarmonyOS上做一款AI应用,我最想强调的一句话是:大模型给你的是“可能性”,而工程给你的是“确定性”。把提示词写扎实、把解析层做健壮,才能把AI的灵光一现,变成用户手里稳定好用的产品。
希望这篇实战对你有帮助。如果你也在鸿蒙上探索AI应用,欢迎交流。