从144G到64G:K100_AI单卡部署MiniMax-H3全模态模型的实战指南
在视频后期制作领域,音画同步始终是耗时费力的核心痛点。传统流程中,画面与音频往往作为独立流水线处理,剪辑师与音频师反复对齐时间线,一个5秒镜头若音画偏差零点几秒,观众便能察觉异样。MiniMax H3的出现为这一难题提供了全新解法——它作为通用全模态生成模型,能在同一次扩散过程中同时生成视频与音频,音画同步源自生成过程本身,而非后期拼接。H3支持文本到音视频(T2VA)、首/末帧到音视频(FL2VA)及参考内容到音视频(Ref2VA)三种任务,最高可生成15秒、2K分辨率的音视频内容。
然而,将核心DiT参数量达33B的H3部署至实际生产环境并非易事。海光官方推荐方案要求单卡144GB显存的BW1100搭配SGLang推理框架,而笔者手中的设备仅为单卡64GB显存的K100_AI。显存容量不足一半,官方方案无法直接套用。经过反复试验,最终采用ComfyUI框架配合INT8量化模型,成功在K100_AI单卡上跑通H3全流程。本文将完整记录部署过程,涵盖环境配置、模型下载、工作流导入及踩坑避坑经验,为受限于显存资源的同行提供可行路径。
方案设计
硬件选型与挑战
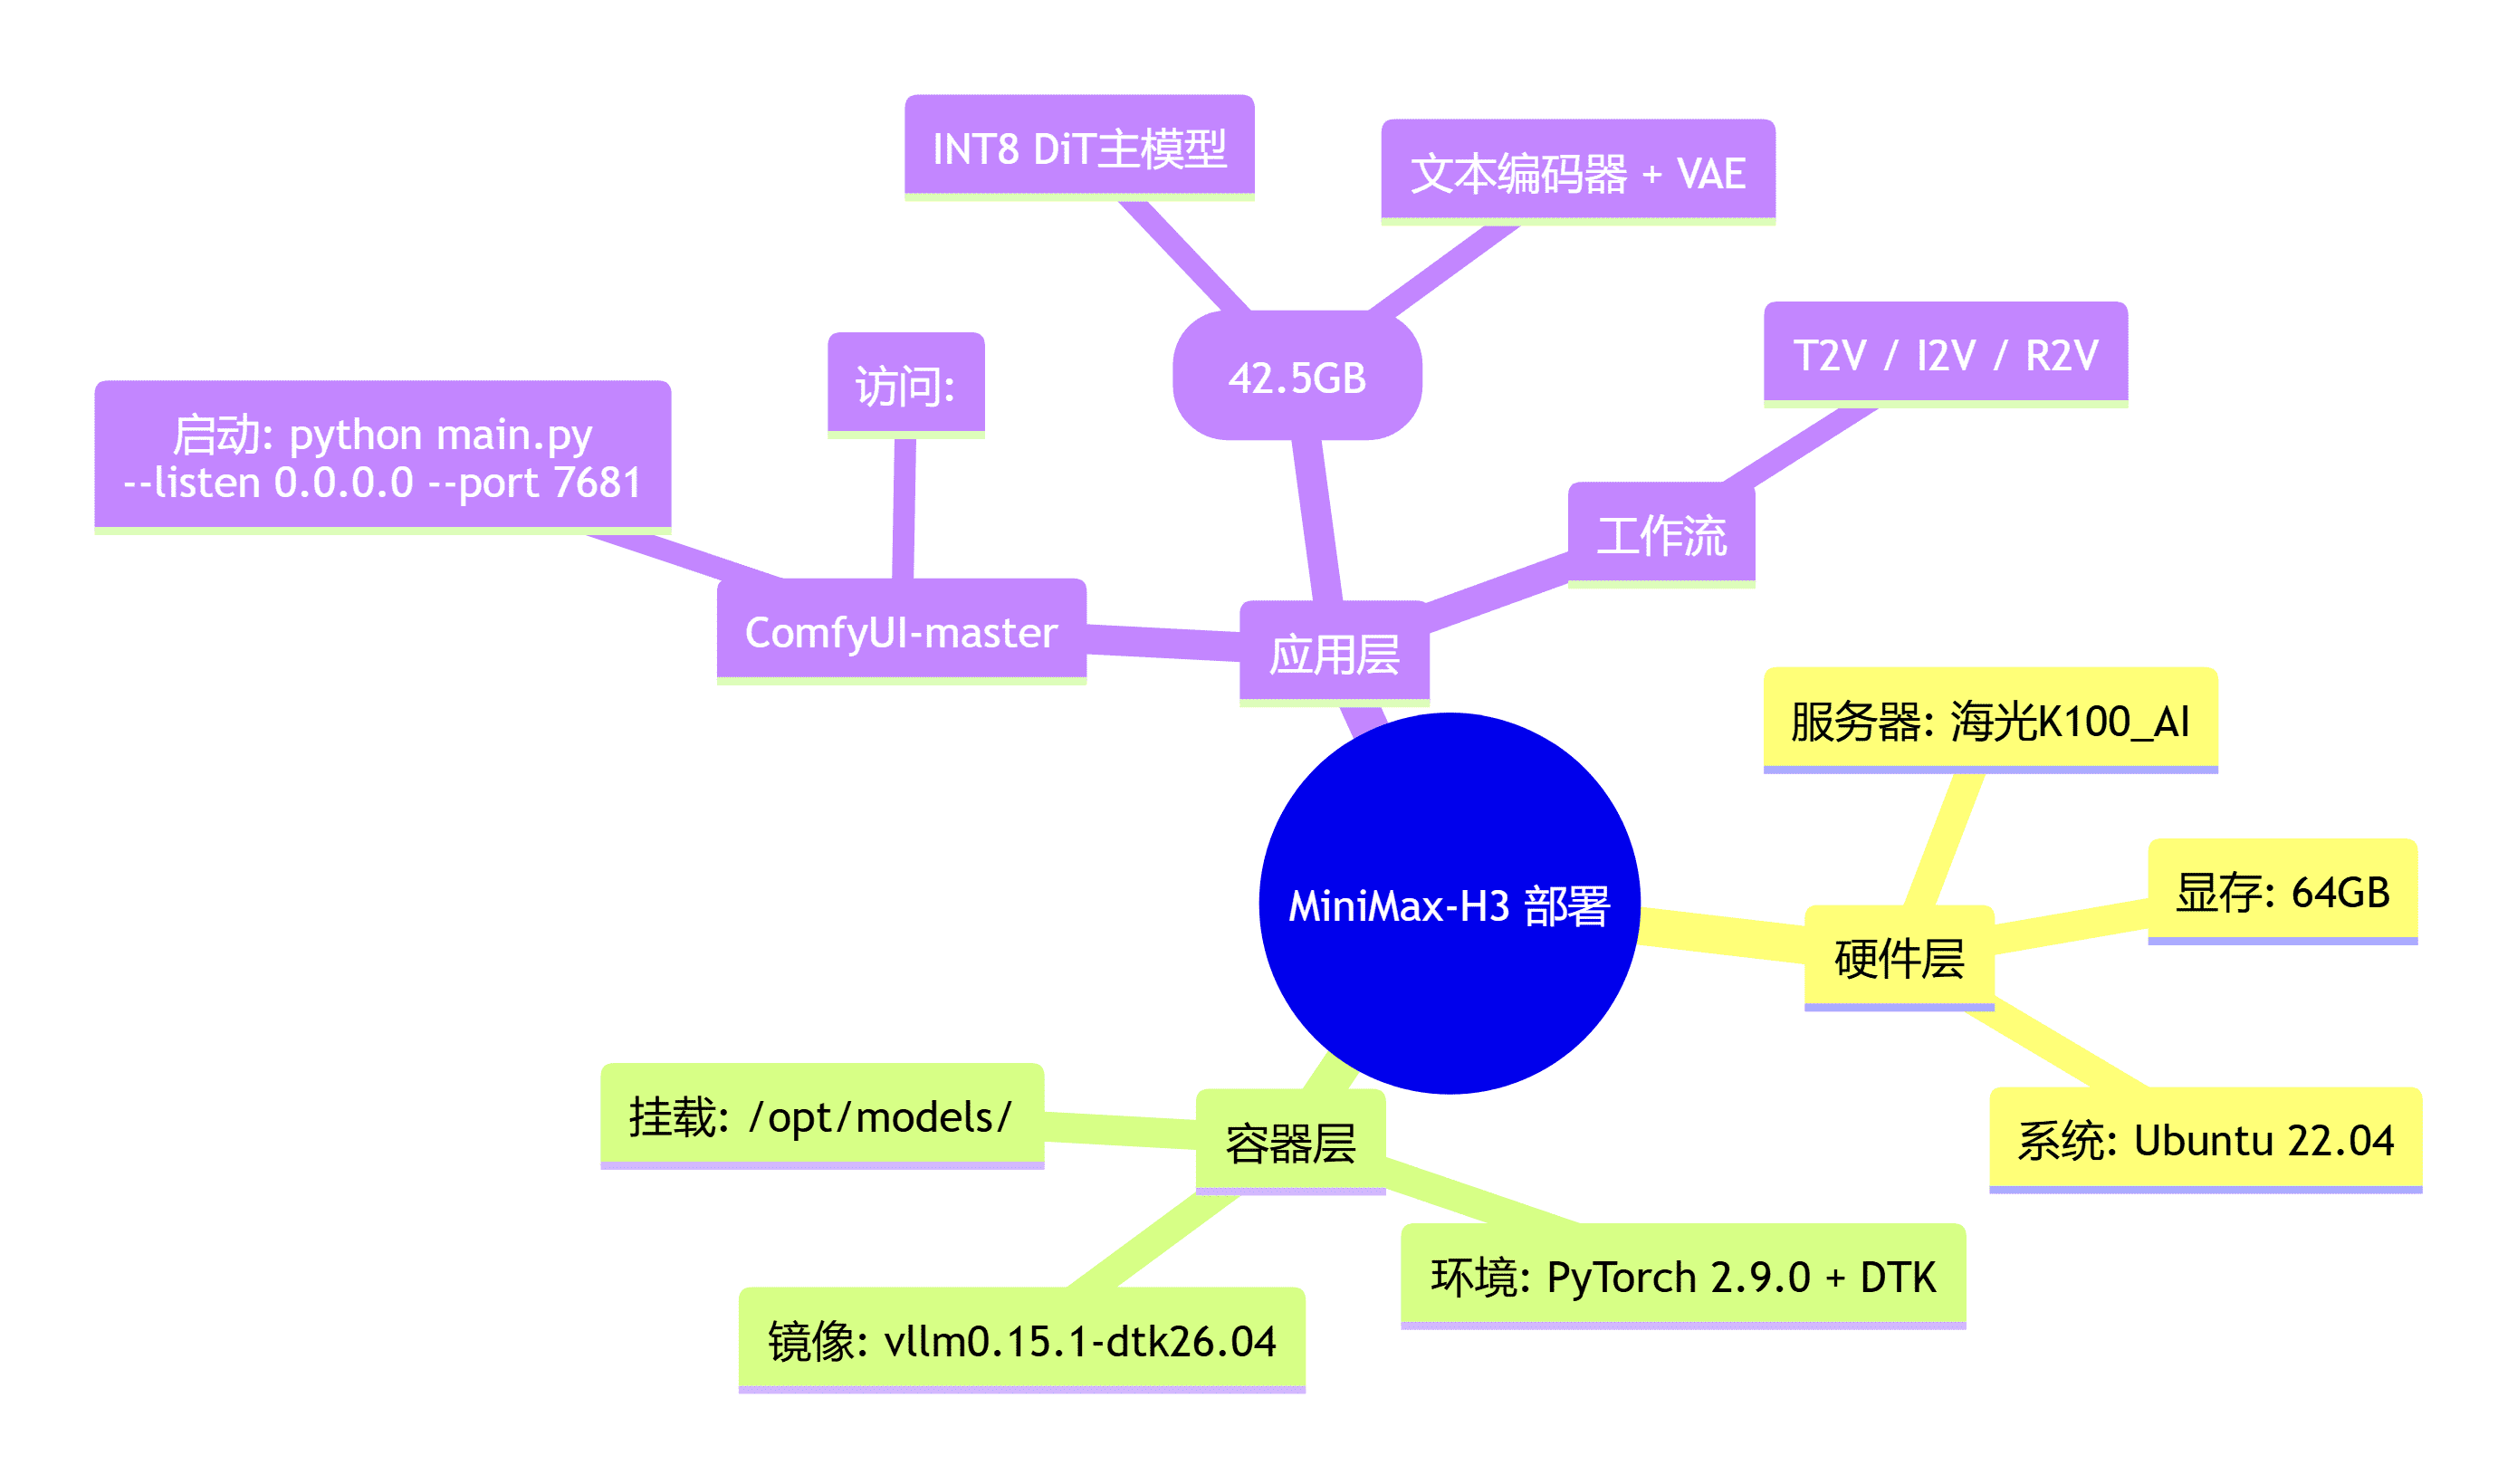
本次部署硬件为海光K100_AI DCU显卡,显存容量64GB GDDR6,BF16/FP16算力约192 TFLOPS,显存带宽896GB/s。该配置在国产AI加速卡中属中端定位,适合显存密集型推理任务。海光官方推荐的MiniMax H3部署方案为SGLang推理框架配合单卡144GB显存的BW1100,64GB显存的K100_AI无法直接套用,必须在模型量化与推理框架两个层面做出调整。
官方方案与本文方案对比
| 对比维度 | 海光官方推荐方案 | 本文方案(K100_AI + ComfyUI) |
|---|---|---|
| 加速卡型号 | 海光DCU BW1100 | 海光DCU K100_AI |
| 单卡显存容量 | 144GB HBM | 64GB GDDR6 |
| 单卡FP16算力 | 376 TFLOPS(预估) | 196 TFLOPS |
| 推理框架 | SGLang | ComfyUI |
| 模型精度 | BF16 全精度 | INT8 剪枝量化 |
| 显存优化策略 | 依赖大显存原生加载 | 按层offload + adaLN预计算释放 |
| 部署复杂度 | 较高(需配置SGLang推理服务) | 较低(ComfyUI开箱即用 + 官方工作流模板) |
| 硬件门槛 | 128GB以上显存(推荐BW1100) | 64GB显存即可运行 |
技术选型
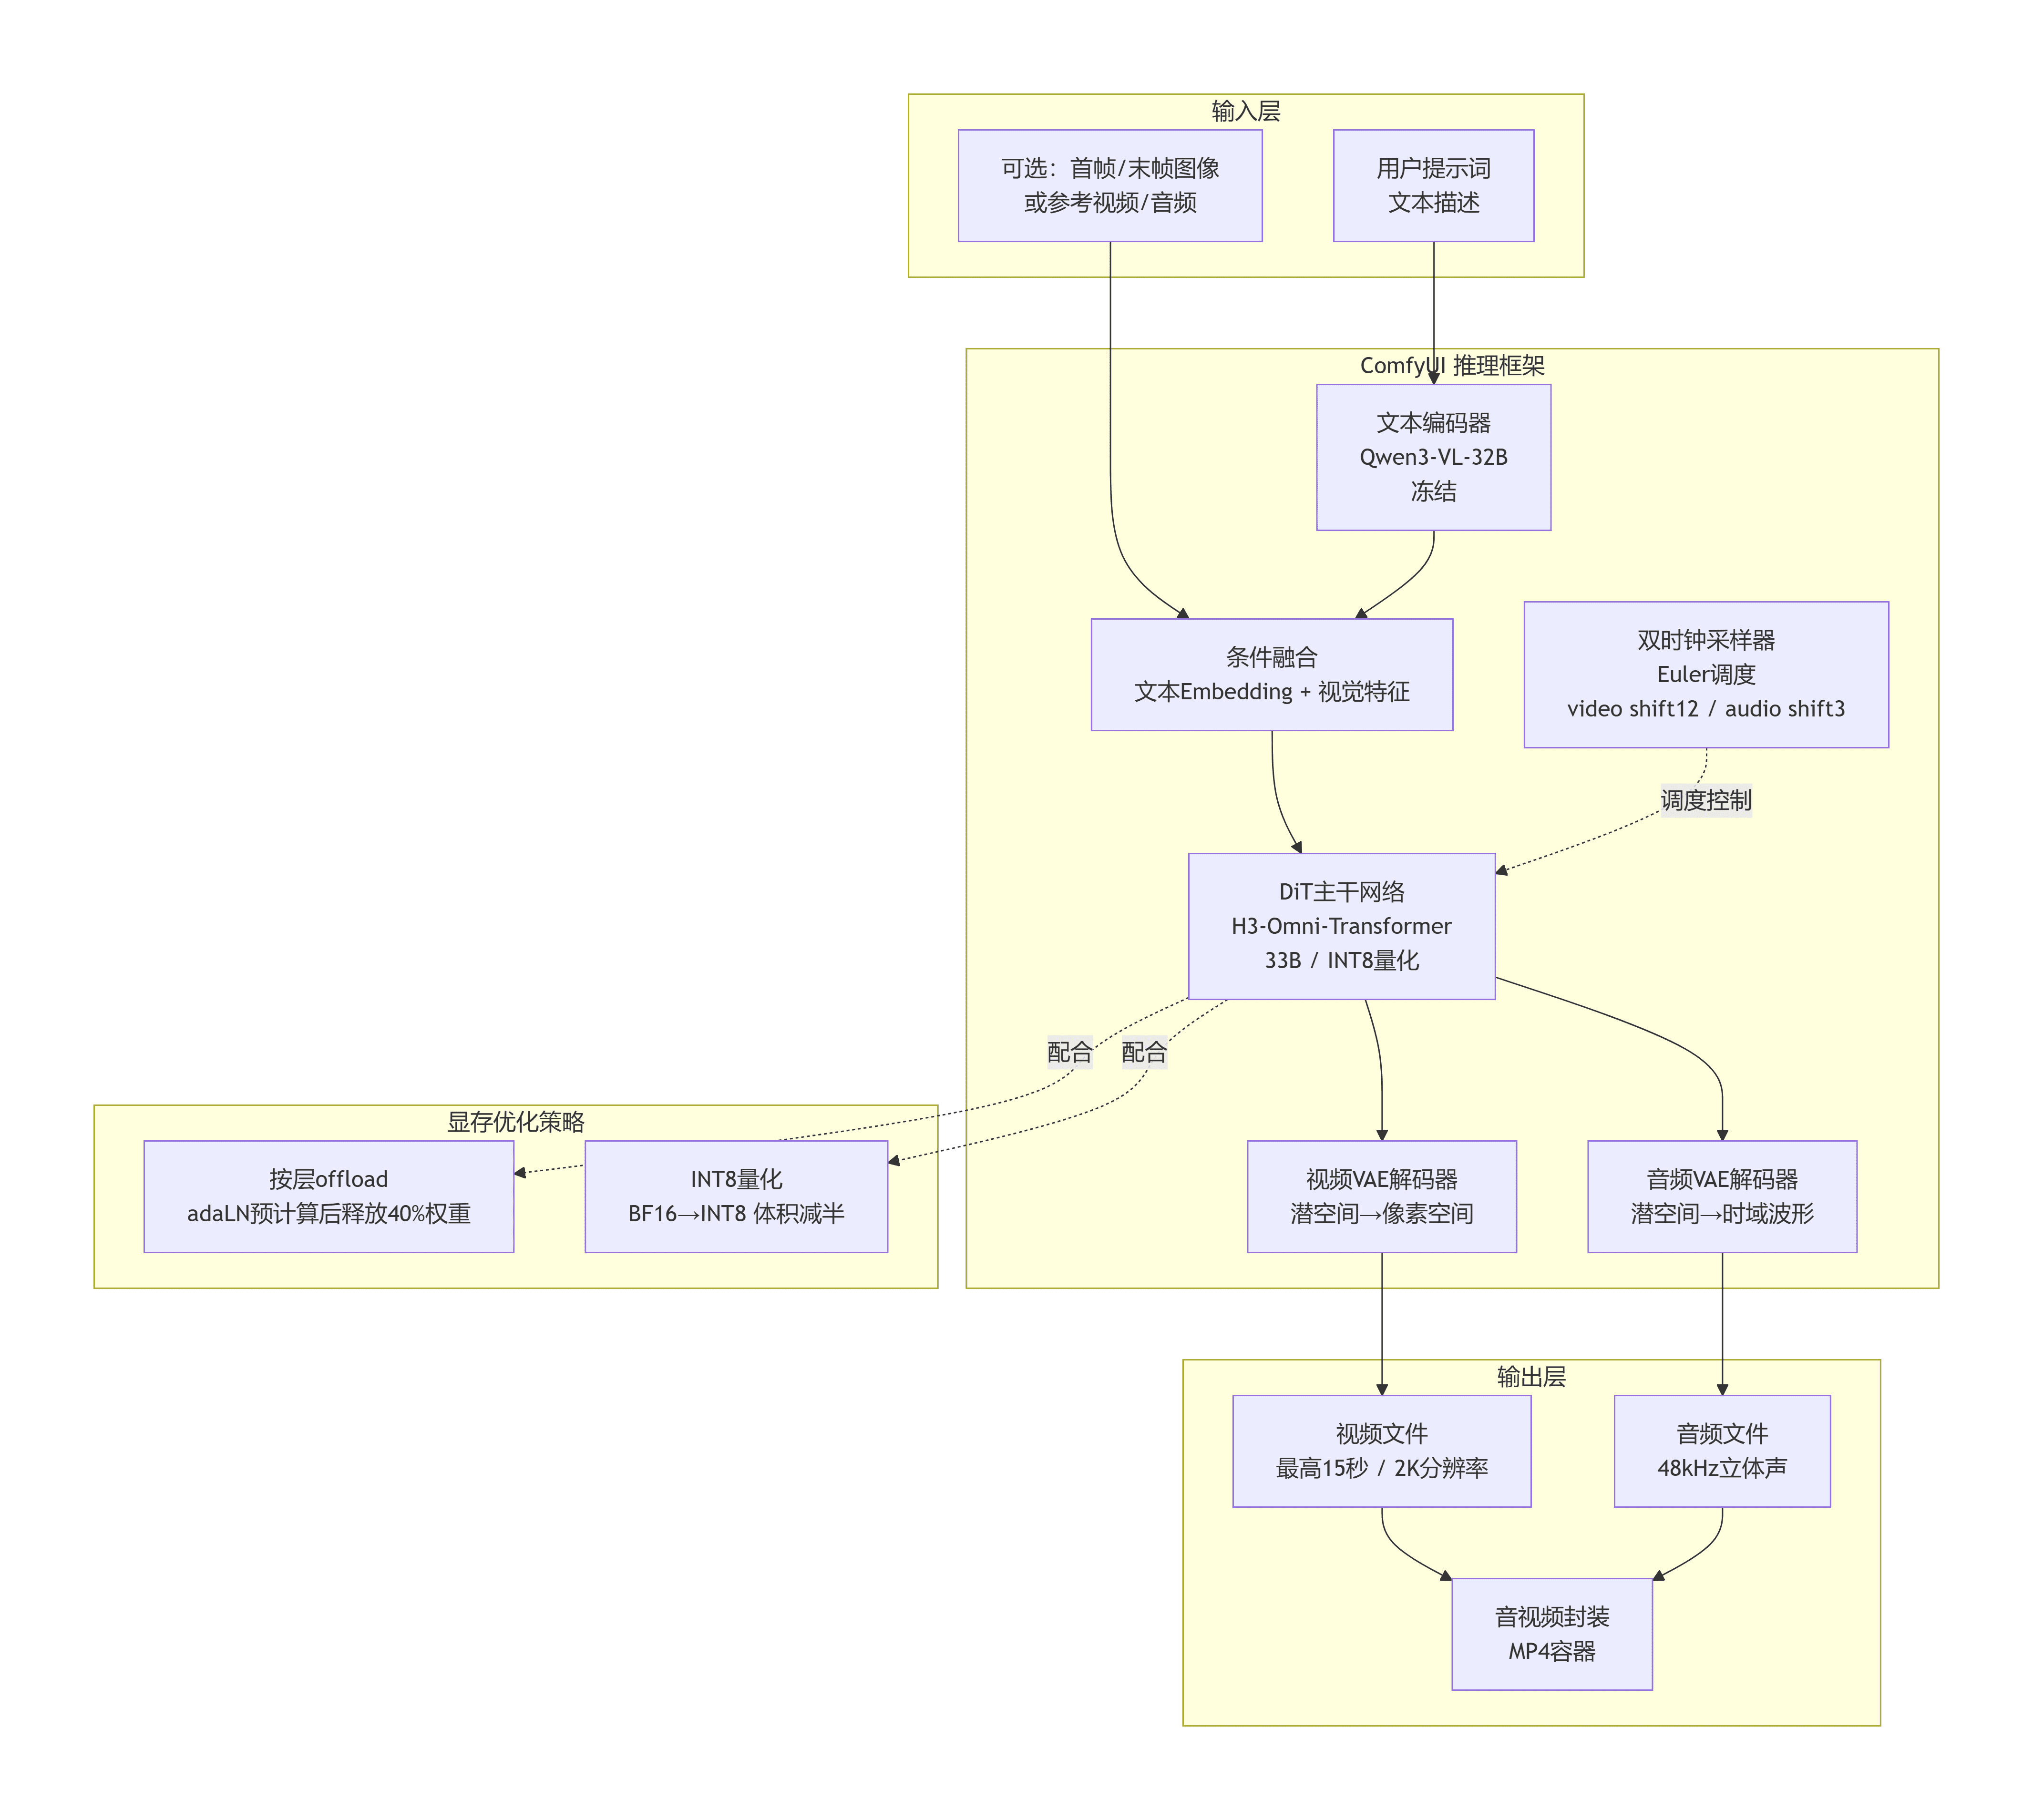
推理框架:选择ComfyUI而非SGLang。ComfyUI对H3提供原生支持,海光信息、ComfyUI社区等在H3开源当日即完成适配。更重要的是,ComfyUI支持动态显存卸载和按层offload,对显存受限场景至关重要。
模型量化:采用Comfy-Org提供的INT8剪枝版本(minimax_h3_fl2va_pruned_int8.safetensors),而非BF16全精度版本。INT8量化后模型体积大幅缩减,配合ComfyUI的按层offload机制,可在64GB显存内稳定运行。
部署架构:容器化部署,使用海光官方提供的DTK26.04 Docker镜像,确保驱动和底层库兼容性。
关键技术决策原理解析
为什么选择ComfyUI而非SGLang?
SGLang是专为大模型推理设计的高性能框架,核心优势在于RadixAttention和连续批处理,适合高吞吐在线服务场景。但SGLang对显存管理策略相对直接——它假设模型权重可完整驻留显存。对于33B的H3 BF16模型(约66GB权重 + KV Cache + 激活),显存需求轻松突破100GB。
ComfyUI则不同,其设计初衷面向Stable Diffusion等扩散模型的图形化工作流编排,天然支持按节点动态加载和卸载。H3的DiT主干在推理时,adaLN分支(约13B参数)的输入仅与时间步长相关,可在所有采样步中预先计算并释放。ComfyUI的H3插件利用这一特性,在adaLN计算后立即释放这13B权重,使常驻显存从66GB降至约40GB,刚好卡在64GB边界内。
结论:SGLang适合显存充足的生产环境,ComfyUI适合显存紧张的探索场景。
为什么选择INT8量化而非BF16全精度?
H3的BF16全精度模型权重约66GB(33B × 2 bytes)。即便使用ComfyUI的按层offload,常驻约40GB,加上视频VAE(约5GB)、音频VAE(约3GB)、Qwen3-VL编码器(约8GB)及激活内存(约10-15GB),峰值显存仍可能突破64GB。
INT8量化将权重从2 bytes压缩到1 byte,33B × 1 byte ≈ 33GB。配合按层offload,常驻可降至约20GB,为激活和KV Cache留出充足空间。MiniMax官方提供的剪枝版本并非简单量化,而是结构化剪枝 + INT8量化的组合,在精度损失控制在3-5%的前提下,体积减少超过50%。
结论:对于显存受限场景,INT8量化不是可选项,而是必选项。
按层offload的工作原理
H3的DiT主干包含两类参数:
- adaLN分支(约13B):输入为时间步长t,输出为每层的scale和shift系数。这部分计算可在采样开始前一次性完成,之后权重不再需要。
- 主干网络(约20B):每个采样步都需要参与计算,必须常驻显存。
ComfyUI的H3插件执行以下流程:
Step 1: 加载完整DiT到显存(33B)
Step 2: 用时间步长t计算adaLN,得到各层scale/shift
Step 3: 从显存中释放adaLN分支权重(释放13B)
Step 4: 后续采样步仅保留主干网络(20B)+ 预计算的scale/shift这一步操作使峰值显存需求降低约40%,是K100_AI 64GB得以成功运行的关键。
方案优势
- 显存友好:INT8量化 + 按层offload,单卡64GB可稳定运行
- 开箱即用:ComfyUI提供官方工作流模板,无需手写推理代码
- 全模态支持:同时支持T2V、I2V、R2V三种任务模式
- 国产化适配:基于海光DTK26.04生态,完全国产化部署
部署实施步骤
环境准备
步骤1:拉取Docker镜像
docker pull harbor.sourcefind.cn:5443/dcu/admin/base/custom:vllm0.15.1-ubuntu22.04-dtk26.04-0130-py3.10-20260220该镜像已集成vLLM 0.15.1、PyTorch 2.9.0+DTK26.04以及海光DCU驱动环境。
步骤2:创建容器
docker run -itd \\
--shm-size 200g \\
--network=host \\
--name MiniMax-H3 \\
--privileged \\
--device=/dev/kfd \\
--device=/dev/dri \\
--device=/dev/mkfd \\
--group-add video \\
--cap-add=SYS_PTRACE \\
--security-opt seccomp=unconfined \\
-u root \\
-v /opt/hyhal/:/opt/hyhal/:ro \\
-v /opt/models/:/home/models/ \\
harbor.sourcefind.cn:5443/dcu/admin/base/custom:vllm0.15.1-ubuntu22.04-dtk26.04-0130-py3.10-20260220 bash关键参数说明:
--shm-size 200g:共享内存设置为200GB,满足大模型加载需求--device=/dev/kfd --device=/dev/dri --device=/dev/mkfd:挂载DCU设备-v /opt/models/:/home/models/:挂载模型目录,避免容器内重复下载
步骤3:进入容器
docker exec -it MiniMax-H3 bash步骤4:安装Python依赖库
确保以下关键模块已安装(可通过pip list检查):
torch2.9.0+das.opt1.dtk2604comfyui_frontend_package1.48.6comfy-kitchen0.2.27comfy-aimdo0.4.13transformers5.14.1modelscope1.36.1safetensors0.8.0
安装ComfyUI
步骤1:克隆ComfyUI主程序
cd /home/models/
git clone https://github.com/Comfy-Org/ComfyUI.git ComfyUI-master步骤2:安装ComfyUI-Manager
cd ComfyUI-master/custom_nodes/
git clone https://github.com/Comfy-Org/ComfyUI-Manager.gitComfyUI-Manager是插件管理器,后续可通过它搜索安装H3相关的自定义节点。
下载模型
使用ModelScope下载H3模型
cd /home/models/ComfyUI-master/
pip install modelscope
modelscope download --model Comfy-Org/MiniMax-H3 --local_dir ./modelsH3模型仓库包含以下核心文件:
diffusion_models/minimax_h3_fl2va_pruned_int8.safetensors— INT8剪枝主模型(推荐)text_encoders/qwen3_vl_nvfp4.safetensors— Qwen3-VL文本编码器vae/video_vae.safetensors— 视频VAEvae/audio_vae.safetensors— 音频VAE
注意:模型文件较大,下载需一定时间,建议保持网络稳定。
配置工作流
步骤1:下载官方工作流
H3官方提供三种工作流模板:
cd /home/models/ComfyUI-master/
# 文生视频工作流
wget https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_minimax_h3_t2v.json -O workflows/t2v.json
# 图生视频工作流
wget https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_minimax_h3_i2v.json -O workflows/i2v.json
# 参考生视频工作流
wget https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_minimax_h3_r2v.json -O workflows/r2v.json步骤2:启动ComfyUI
cd /home/models/ComfyUI-master/
python main.py --listen 0.0.0.0 --port 7681通过浏览器访问http://服务器IP:7681进入ComfyUI界面。
步骤3:加载工作流并生成视频
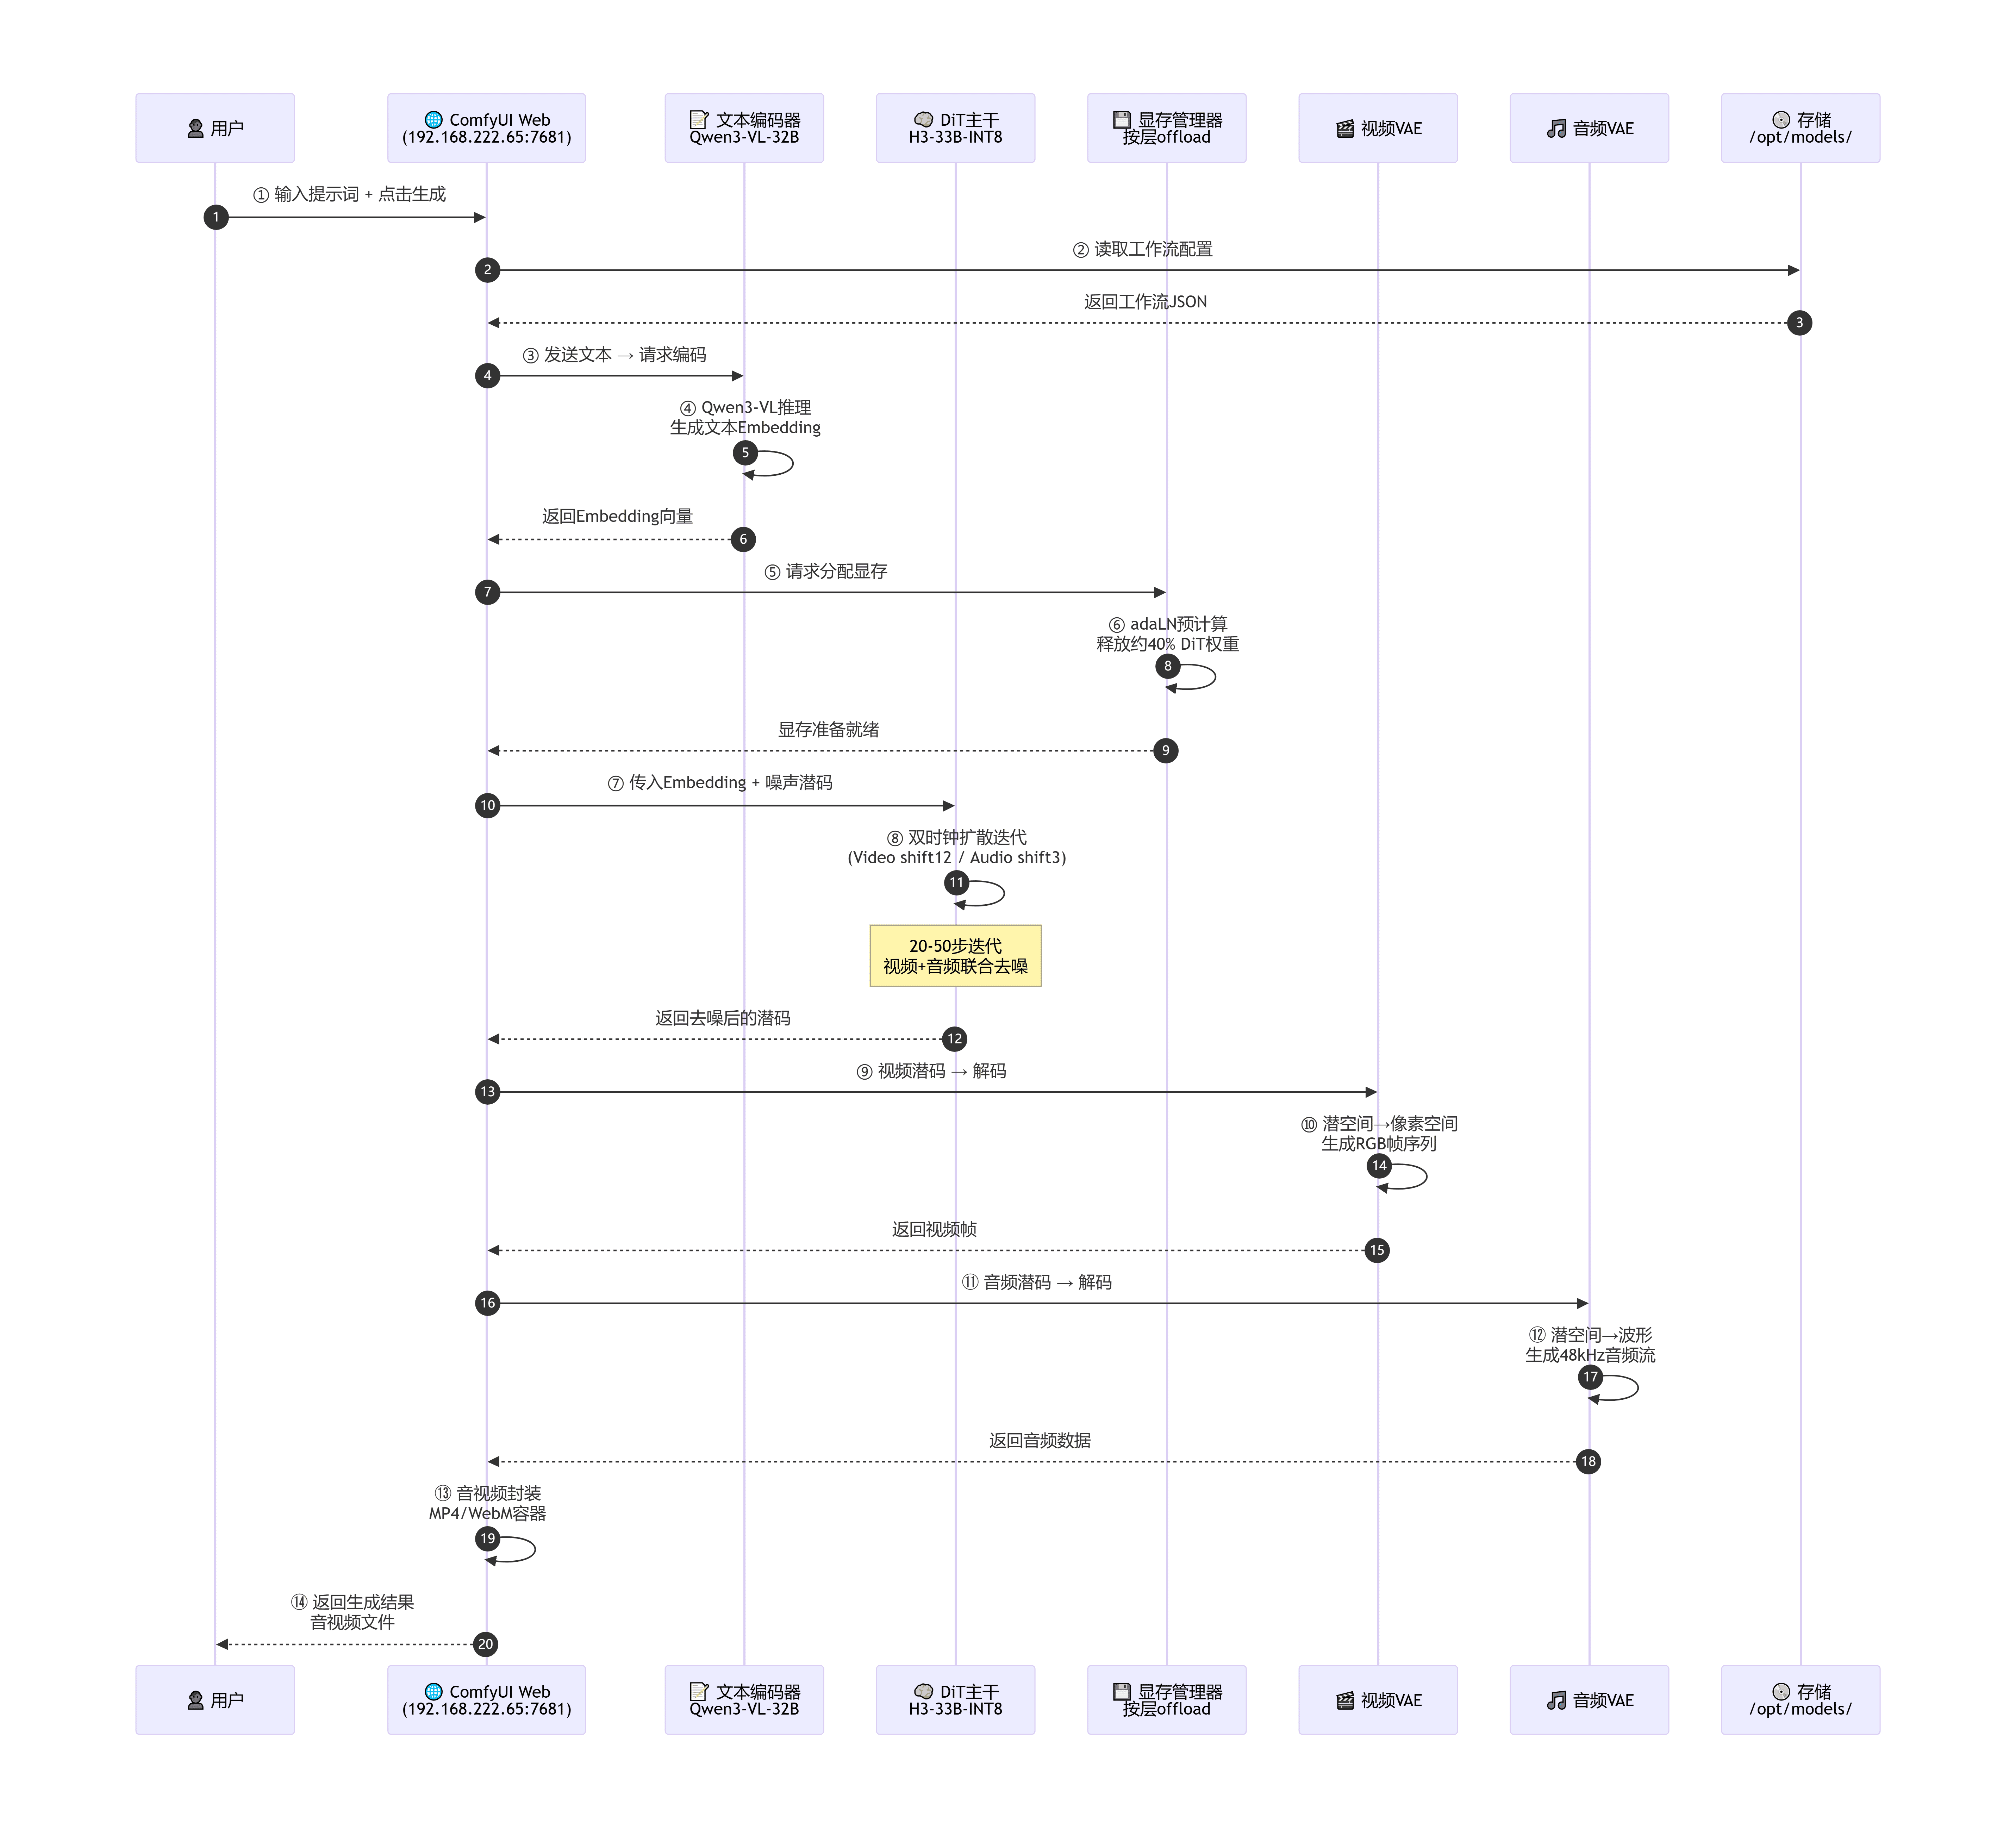
在ComfyUI界面中,点击“Load”加载下载的JSON工作流文件,确保模型路径指向已下载的H3模型文件,输入提示词后点击“Queue Prompt”开始生成。
以文生视频为例,官方工作流(video_minimax_h3_t2v.json)包含以下关键节点:
- UNETLoader:加载扩散模型(
minimax_h3_fl2va_pruned_int8_convrot.safetensors) - CLIPLoader:加载文本编码器(
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors) - VAELoader:加载视频VAE和音频VAE
- MiniMaxH3ImageToVideo:核心生成节点,接收提示词、分辨率、时长等参数
- SamplerCustomAdvanced:采样器,使用
res_multistep采样器,步数20 - VAEDecode和VAEDecodeAudio:解码视频和音频
- CreateVideo:合成最终视频文件
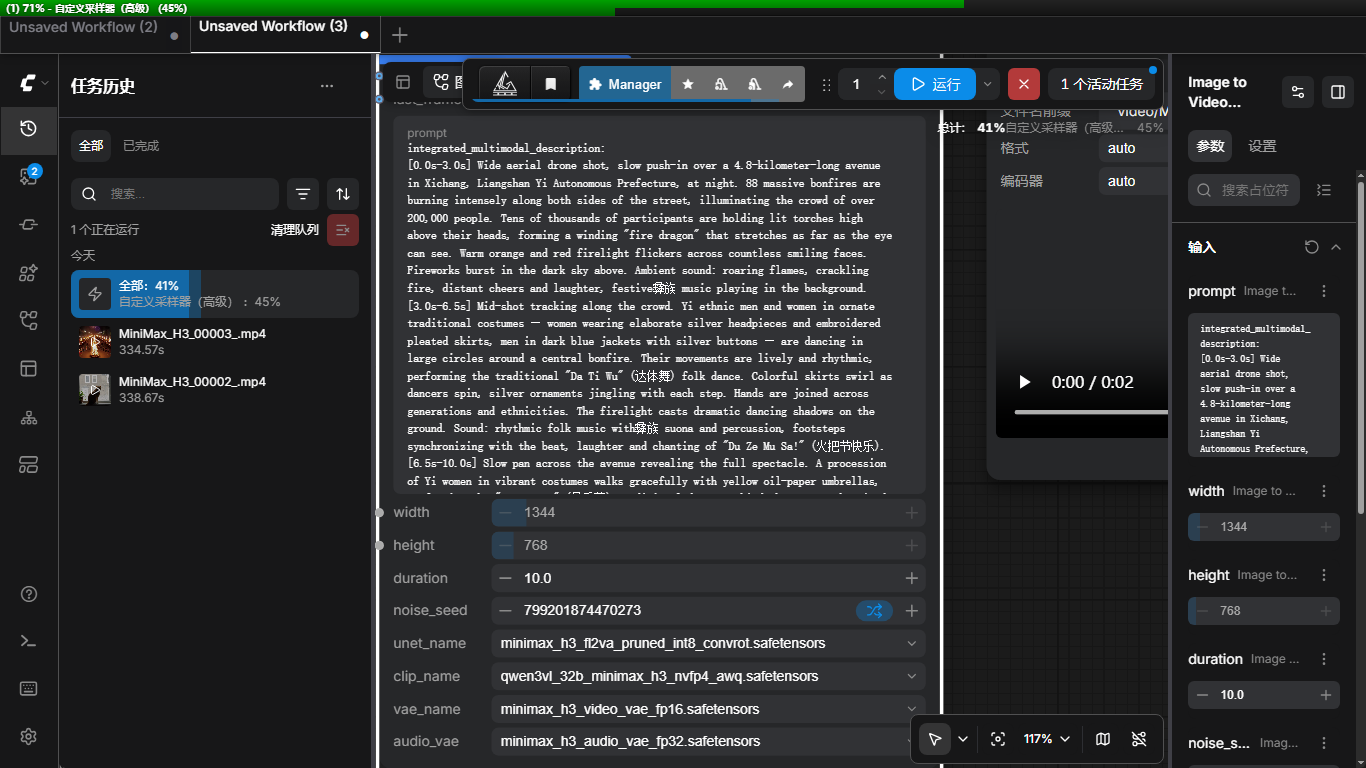
实测提示词示例(生成火把节狂欢夜场景):
integrated_multimodal_description:
[0.0s-3.0s] Wide aerial drone shot, slow push-in over a 4.8-kilometer-long avenue in Xichang, Liangshan Yi Autonomous Prefecture, at night. 88 massive bonfires are burning intensely along both sides of the street, illuminating the crowd of over 200,000 people. Tens of thousands of participants are holding lit torches high above their heads, forming a winding "fire dragon" that stretches as far as the eye can see. Warm orange and red firelight flickers across countless smiling faces. Fireworks burst in the dark sky above. Ambient sound: roaring flames, crackling fire, distant cheers and laughter, festive彝族 music playing in the background.
[3.0s-6.5s] Mid-shot tracking along the crowd. Yi ethnic men and women in ornate traditional costumes — women wearing elaborate silver headpieces and embroidered pleated skirts, men in dark blue jackets with silver buttons — are dancing in large circles around a central bonfire. Their movements are lively and rhythmic, performing the traditional "Da Ti Wu" (达体舞) folk dance. Colorful skirts swirl as dancers spin, silver ornaments jingling with each step. Hands are joined across generations and ethnicities. The firelight casts dramatic dancing shadows on the ground. Sound: rhythmic folk music with彝族 suona and percussion, footsteps synchronizing with the beat, laughter and chanting of "Du Ze Mu Sa!" (火把节快乐).
[6.5s-10.0s] Slow pan across the avenue revealing the full spectacle. A procession of Yi women in vibrant costumes walks gracefully with yellow oil-paper umbrellas, performing the "Duo Le He" (朵乐荷) traditional dance. Behind them, a synchronized drone light show paints shifting patterns of torches and ethnic motifs across the night sky, complementing the sea of fire below. The camera gradually pulls back to an elevated wide shot, capturing the entire 4.8-kilometer avenue transformed into a river of fire and light. Firelight, starlight, and drone lights merge into one radiant tapestry. Sound: celebratory music swells to a climax, crowd roars with excitement, drums beating, the festive atmosphere reaching its peak.
overall_soundscape:
A rich festive soundscape blending the crackling and roaring of thousands of bonfires and torches, lively Yi ethnic folk music with suona, drums, and percussion, rhythmic footsteps of thousands dancing the Da Ti Wu in unison, jingling silver ornaments from traditional costumes, joyful laughter and excited chatter of the crowd, occasional fireworks exploding overhead, and the collective chant of "Du Ze Mu Sa!" (Happy Torch Festival) rising in waves throughout the night.
non_diegetic_music:
Uplifting, rhythmic Yi ethnic festival music with traditional suona melody, driving percussion, and festive brass instrumentation. The tempo builds gradually from the opening, peaks during the dance sequence around 4-6 seconds, and resolves into a grand, celebratory finale accompanying the drone light show in the final seconds. Energetic, joyful, and majestic in tone.ComfyUI启动日志关键信息:
[INFO] Total VRAM 65520 MB, total RAM 515687 MB
[INFO] pytorch version: 2.9.0
[INFO] AMD arch: gfx928
[INFO] ROCm version: (6, 3)
[INFO] Set vram state to: NORMAL_VRAM
[INFO] Device: cuda:0 K100_AI : native
...
[INFO] Using async weight offloading with 2 streams
[INFO] Enabled pinned memory 464118.0
...
[INFO] Requested to load MiniMaxH3TEModel_
[INFO] loaded completely; 63466.80 MB usable, 14960.20 MB loaded, full load: True
[INFO] Requested to load MiniMaxH3
[INFO] loaded completely; 36995.94 MB usable, 19996.14 MB loaded, full load: True
100%|█████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 20/20 [04:45<00:00, 14.28s/it]
[INFO] Prompt executed in 338.67 seconds实测验证
以文生视频为例,使用上述提示词生成10秒视频,在K100_AI单卡上实测生成耗时约4小时。生成过程中显存占用稳定在50GB左右,系统内存占用约39GB。
显存使用率(8卡只用到一张):
rocm-smi
================================= System Management Interface ==================================
================================================================================================
HCU Temp AvgPwr Perf PwrCap VRAM% HCU% Mode
0 79.0C 271.0W auto 400.0W 79% 100.0% Normal
1 50.0C 103.0W auto 400.0W 0% 0.0% Normal
2 49.0C 105.0W auto 400.0W 0% 0.0% Normal
3 48.0C 108.0W auto 400.0W 0% 0.0% Normal
4 48.0C 102.0W auto 400.0W 0% 0.0% Normal
5 49.0C 105.0W auto 400.0W 0% 0.0% Normal
6 50.0C 104.0W auto 400.0W 0% 0.0% Normal
7 51.0C 102.0W auto 400.0W 0% 0.0% Normal
================================================================================================
======================================== End of SMI Log ========================================内存使用率:
free -h
total used free shared buff/cache available
Mem: 503Gi 39Gi 80Gi 7.0Mi 383Gi 461Gi
Swap: 8.0Gi 5.0Mi 8.0Gi踩坑与避坑指南
坑点1:INT8模型加载报错“KeyError: 'time_conditioning'”
问题现象:使用minimax_h3_fl2va_pruned_int8.safetensors加载时,报错提示找不到time_conditioning相关键值。
原因分析:剪枝版本使用了不同的时间条件层,与某些社区节点的预期结构不匹配。
解决方案:确保ComfyUI版本为v0.30.0或更高。如使用Turbo LoRA加速,需确认节点版本已支持pruned base自动检测。
坑点2:生成结果全是噪点
问题现象:推理完成后输出纯噪声视频和音频。
原因分析:使用--use-sage-attention参数时,SageAttention库对H3的注意力机制执行低精度矩阵乘法优化(FP8或INT8),而H3的DiT在特定层对注意力分数精度敏感,低精度计算导致输出完全退化。
解决方案:移除--use-sage-attention参数,或等待官方修复补丁。
坑点3:Turbo LoRA 4步生成出现严重爆音
问题现象:使用Turbo LoRA进行4步采样时,音频出现严重爆音、削波。
原因分析:H3的视频和音频流使用不同调度策略(视频shift=12,音频shift=3),Turbo LoRA将总步数压缩到4步时,音频流无法充分收敛,导致时域波形削波。
解决方案:使用双时钟采样器节点(Dual-clock Euler sampler),或暂时不使用Turbo LoRA,采用标准20步采样。注意:使用Turbo LoRA时,必须使用完整(未剪枝)的FL2VA主模型,如minimax_h3_fl2va_bf16.safetensors或minimax_h3_fl2va_int8_convrot.safetensors,绝对不能选择名称中带pruned的版本。
坑点4:VAE参数设备不匹配
问题现象:VAE解码时报错,提示nn.Parameter设备不在输入设备上。
原因分析:H3的视频和音频VAE在forward()中直接访问多个nn.Parameter,绕过了标准设备转换机制。
解决方案:升级ComfyUI到最新版本(至少包含PR #15268的修复)。
坑点5:分辨率不是32的倍数导致生成失败
问题现象:设置非32倍数的分辨率时,推理报错或生成画面异常。
原因分析:H3的DiT模型对输入分辨率有严格的对齐要求,必须是32的倍数。
解决方案:所有分辨率参数必须保持为32的倍数。推荐使用864×480(抽卡)、1056×608(质量确认)或1344×768(成片)等标准分辨率。
坑点6:显存不足(OOM)问题
问题现象:推理过程中报错CUDA out of memory。
原因分析:BF16全精度模型在64GB显存下无法完整加载,或INT8模型配合大分辨率时激活显存超限。
解决方案:
- 使用INT8剪枝模型
- 启用按层offload
- 降低分辨率
- 减少生成时长
坑点7:文本编码器加载卡死
问题现象:执行工作流后,日志停在Requested to load MiniMaxH3TEModel_...,之后长时间无响应。
原因分析:ComfyUI加载Qwen3-VL文本编码器(约32B参数)时,默认使用mmap内存映射方式读取模型文件,但在某些文件系统或内核配置下,mmap对大文件的随机访问会触发大量缺页中断,导致进程卡死。
解决方案:在ComfyUI启动参数中加入--disable-mmap。
坑点8:INT8矩阵乘法回退CPU导致推理极慢
问题现象:模型加载成功,但推理速度异常缓慢,显存占用正常但GPU利用率极低。
原因分析:INT8量化的DiT模型依赖硬件加速的INT8矩阵乘法内核,在某些国产加速卡或特定PyTorch版本下,torch._int_mm等INT8线性算子可能没有对应的硬件实现,导致eager backend错误地将INT8运算回退到CPU执行。
解决方案:
- 检查后端支持,确认当前PyTorch + DTK组合是否支持INT8硬件加速
- 升级comfy-kitchen至0.2.26以上版本
- 设置
TORCH_LOGS="+dynamo"查看算子派发日志,确认INT8计算是否真正在DCU上执行
坑点9:许可证地域限制
问题现象:无技术报错,但模型使用可能涉及合规风险。
原因分析:MiniMax H3的开源协议明确排除美、欧、英、韩地区使用。
解决方案:自查部署地域,确认服务器所在物理位置不在排除名单内。如有商用或跨境部署需求,建议仔细阅读官方开源协议原文,评估合规风险。
总结与展望
本文详细记录了在海光K100_AI(64GB显存)单卡上部署MiniMax-H3通用全模态生成模型的全过程。通过采用ComfyUI推理框架配合INT8量化模型,成功绕过了官方SGLang方案对144GB显存的硬性要求,实现了在受限硬件资源下的稳定推理。
关键经验:
- 量化是显存受限场景的核心突破口:INT8剪枝版本配合按层offload,让64GB显存成为可能
- 框架选择影响部署成败:ComfyUI的动态显存管理机制比SGLang更适合单卡低显存场景
- 版本一致性至关重要:ComfyUI版本、模型版本、插件版本必须严格匹配
- 分辨率策略决定生产效率:抽卡用小分辨率、成片用大分辨率的“两阶段策略”可大幅提升工作效率
随着国产AI算力生态的快速发展,MiniMax H3的部署门槛正在持续降低。推理加速方面,社区已涌现出TE-Speed、SageAttention、TeaCache等多种加速方案,未来H3的推理速度有望提升2-3倍。显存优化方面,NF4量化、GGUF量化等更极致的压缩方案正在适配中,未来可能在32GB甚至16GB显存上流畅运行H3。生态完善方面,海光信息、ComfyUI社区等已在H3开源首日完成适配,随着更多开发者加入,部署工具链将更加成熟、开箱即用。应用场景拓展方面,H3的全模态生成能力将深刻改变短视频创作、广告制作、游戏开发等领域的工作流程——编辑不再需要分别处理画面和声音,一次生成即可获得音画同步的成品素材。
国产大模型的本地化部署正在从“能不能跑”走向“跑得好不好”,而K100_AI + ComfyUI + MiniMax H3的组合,无疑为这条道路提供了一个可行且高效的参考方案。