AI数学突破24小时被复现:验证能力成核心瓶颈
数学首发的“保质期”危机
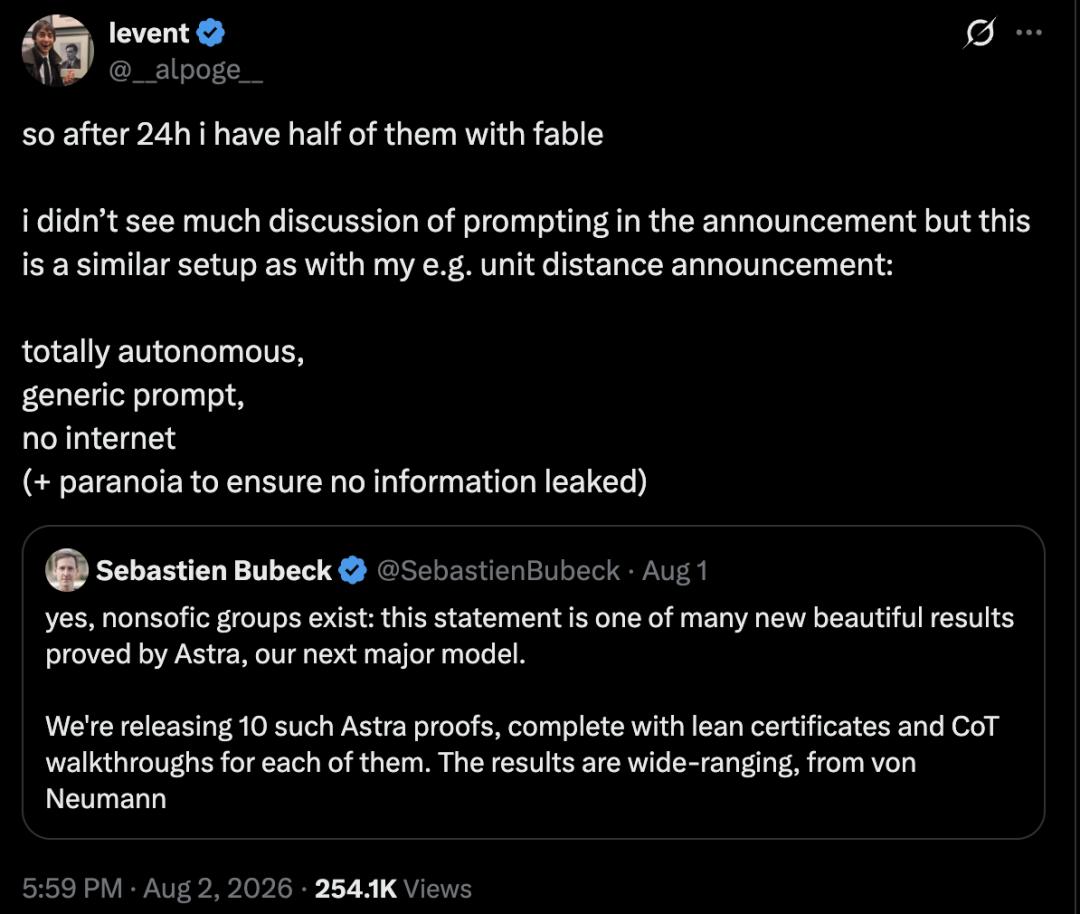
在人工智能与基础科学的交汇点上,一场关于“优先权”的定义正在被重写。2026年8月初,OpenAI研究员Sébastien Bubeck宣布,其未公开的下一代主力模型Astra成功证明了10项前沿数学成果,并附带了10份Lean证书及详细的思路复盘。这一消息在学术界引发了剧烈震动,甚至有人惊呼“数学奇点”已至。然而,戏剧性的一幕发生在不到24小时后,Anthropic的研究员Levent Alpöge在公开平台上声明,其模型Fable在完全自主、无网络且防止上下文泄漏的条件下,独立复现了其中5项成果。
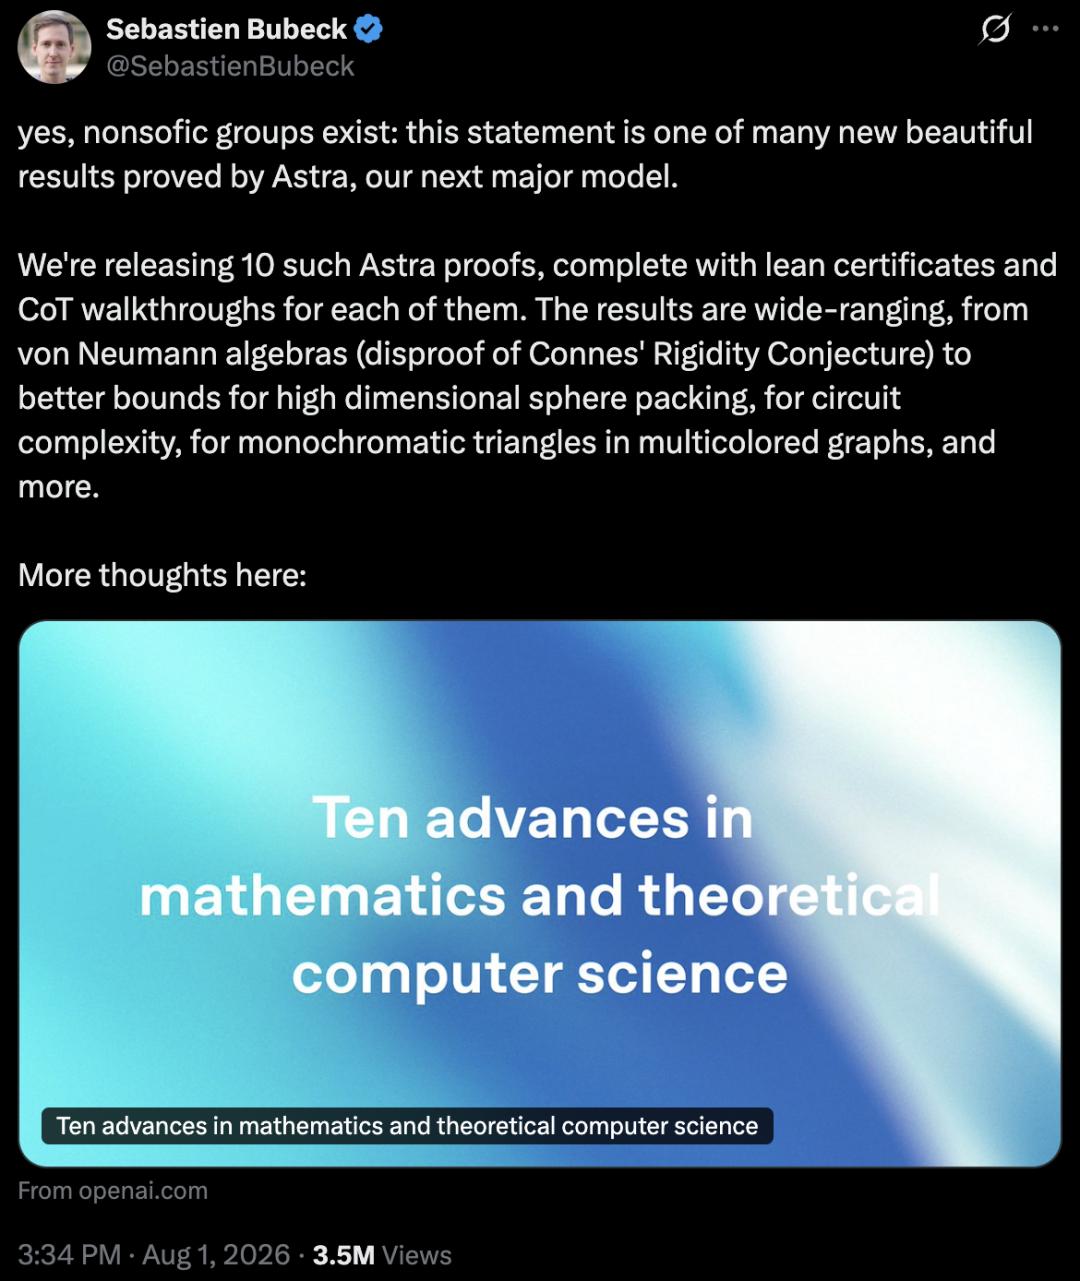
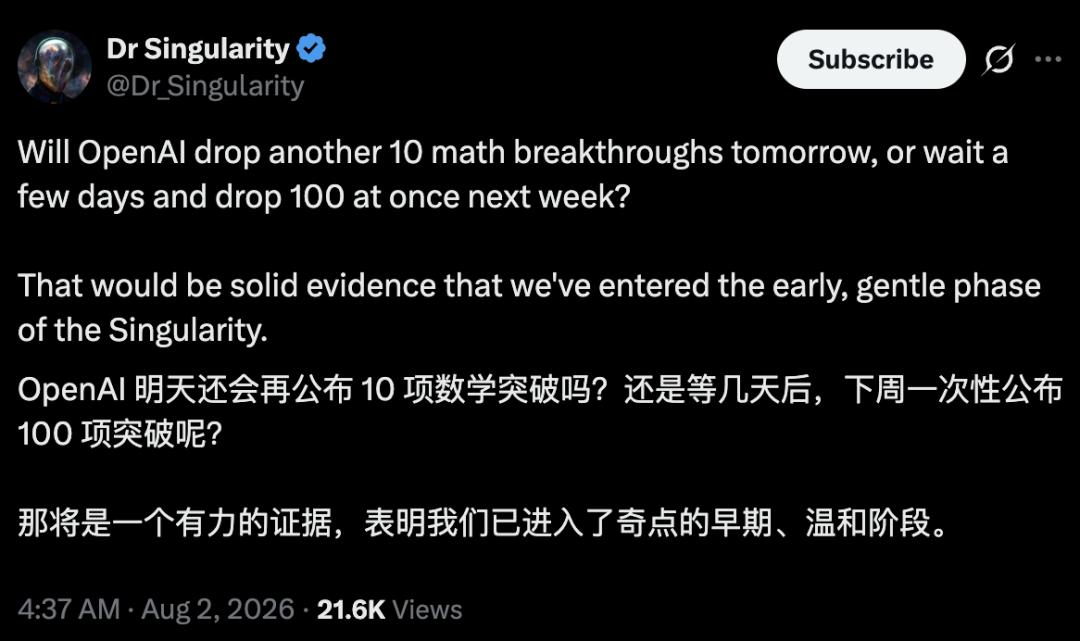
这一事件的核心意义远超出了模型性能的简单对比。在传统学术体系中,一项数学成果的优先权之争往往以年为单位,涉及漫长的投稿、审稿与修改周期。Astra的“首发”优势,在Fable的快速跟进面前,其含金量虽未受损,但“保鲜期”却急剧缩短至24小时。这种极速的追赶表明,AI在数学证明生成上的能力已不再是稀缺资源,而是成为了可快速复制的基础设施。对于OpenAI而言,这不仅是技术实力的展示,更是一次对现有学术发表机制的冲击测试。
边际成本与隐性成本的博弈
OpenAI在宣布成果时,特别强调了其边际推理成本不到2000美元。这一数字由研究员Noam Brown提供,基于生成这些解法所需的Token数量及Sol API价格折算。这一数据极具冲击力,它将AI解出一道前沿数学难题的边际成本打到了“地板价”。然而,这一数字仅涵盖了成功跑出解法那一刻的算力消耗,并未包含研发、试错、形式化及审查等隐性成本。
事实上,Astra的研发涉及巨大的训练投入,且OpenAI在尝试其他重大问题(如千禧年大奖难题)时并未成功。此外,将非形式化的数学论证转化为249页的Lean形式化证明,需要大量人类专家工时。外部数学家的审查成本同样高昂。因此,2000美元仅代表了“生成”环节的边际成本,而非“验证”与“确认”环节的全部成本。这一成本结构的分离,揭示了AI在科学发现中的真实定位:它极大地降低了假设生成的成本,但并未消除人类在验证与理解上的投入。
从“刷榜”到“验货”:验证机制的重构
Fable对Astra成果的复现,其意义在于从传统的“刷榜”转向了“验货”。传统基准测试(Benchmark)通常基于已知答案,旨在评估模型在封闭环境下的表现。而Astra与Fable在无网络、防泄漏条件下的独立解题,本质上是一种去中心化的同行评审。这种模式测试的是结果的可复现性与可靠性,而非单纯的解题技巧。
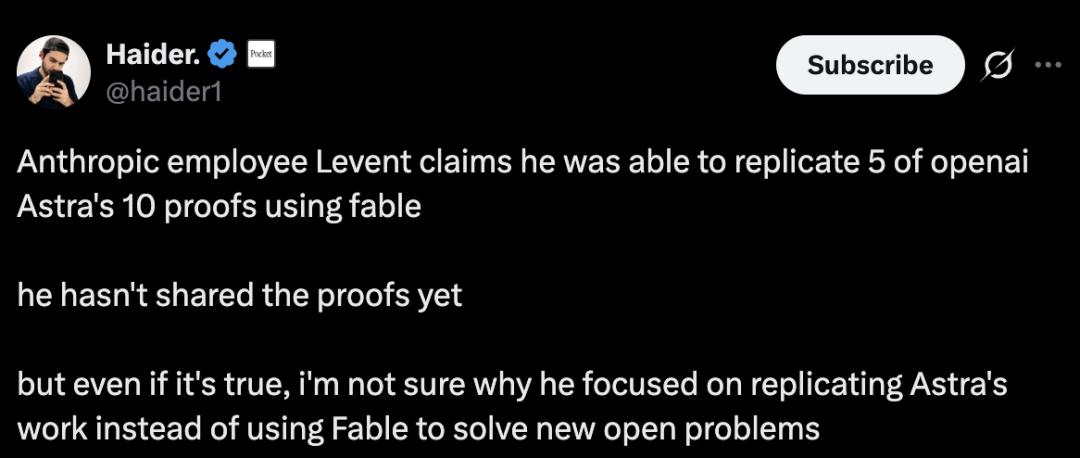
然而,这种“验货”机制目前仍存在透明度缺口。Levent Alpöge仅声明了复现结果,尚未公开完整的证明细节、提示词、运行日志或Lean证书。这种不透明性引发了社区质疑:为何选择复现Astra的题目,而非直接解决新的开放问题?事实上,Fable此前已成功给出Jacobian猜想的三维反例,并经过代数验证,证明其具备解决新问题的能力。此次复现更多是一种对Astra成果可信度的快速压力测试,而非能力的全面展示。
信任链的延伸:当成果超出人类理解范围
随着AI生成的数学成果日益复杂,公众与专家面临的共同挑战是“理解鸿沟”。Ethan Mollick指出,对于绝大多数人而言,非索菲克群的存在、Connes刚性猜想的反例等成果,已超出个人理解能力。我们只能依赖专业数学家的判断,形成一条长长的“信任链”。这种“连惊叹都无从惊叹”的状态,正在科学前沿领域普遍发生。
数学家Thomas Bloom提醒,AI的证明并非凭空产生,而是建立在百年积累的数学理论与形式化系统之上。简单地将AI描述为“取代数学家”并不诚实。真正的衡量标准在于:这份证明是否提供了新的洞察?是否推动了该领域的认知边界?当AI能低成本批量生产证明时,稀缺能力正从“生成证明”转向“看懂并验收证明”。验证能力的滞后,可能成为制约AI科学发现潜力的最大瓶颈。
验证能力的滞后与未来展望
AI在数学领域的突破,暴露了人类验证能力的相对滞后。当证明的生成速度远超理解与验证速度时,学术界需要建立新的评估体系。这一体系应包含:
- 形式化验证的普及:Lean等工具应成为数学证明的标准附件,确保每一步逻辑可机器核查。
- 分布式验证网络:借鉴区块链思想,建立去中心化的数学验证社区,提高验证效率与透明度。
- 人机协作新范式:人类专家从“证明者”转向“验证者”与“方向指引者”,专注于高价值的概念创新与逻辑审查。
OpenAI与Anthropic的这场“24小时竞赛”,并非终点,而是新范式的起点。它表明,AI已具备在数学前沿进行高强度探索的能力,但这一能力的价值,最终取决于人类能否跟上验证的步伐。未来的数学突破,将不再仅仅属于那些能生成证明的模型,更属于那些能高效验证、理解并整合这些证明的人类与AI协作系统。在这场竞赛中,验证能力将成为比生成能力更核心的竞争力。