MiniMax H3开源:16家生态首日适配,有声视频编辑登顶揭秘
全模态视频生成的新标杆:MiniMax H3的技术突破与生态布局
在人工智能内容创作领域,多模态融合正成为下一代生成式AI的核心竞争点。2026年8月,MiniMax正式开源其新一代通用视频模型MiniMax H3,这一举动迅速在技术社区引发广泛关注。与以往仅专注于视觉生成的模型不同,H3是一个真正的通用型全模态生成系统,能够统一理解文本、图像、视频和音频组成的多模态上下文,并生成最长15秒、最高2K分辨率并带有原生立体声音频的视频。
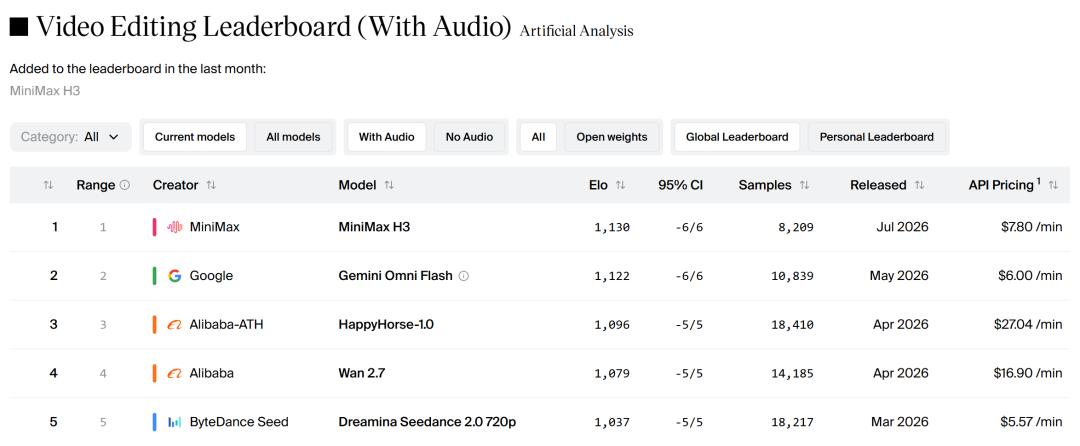
此次开源不仅是一次技术发布,更是一场生态协同的展示。在Artificial Analysis发布的有声视频编辑榜单中,MiniMax H3以1130分的Elo成绩位列全球第一,超越了Gemini Omni Flash、HappyHorse-1.0以及Wan 2.7等国内外知名视频模型。更值得注意的是,模型发布首日,华为昇腾、摩尔线程、沐曦、海光信息、昆仑芯、天数智芯、壁仞科技、AMD、Intel等16家芯片厂商及平台,加上Hugging Face、魔搭ModelScope等开发社区,均完成了适配支持。这种速度与广度,标志着国产AI模型在底层算力兼容性和应用生态建设上迈出了关键一步。
架构解析:三大模块协同工作的底层逻辑
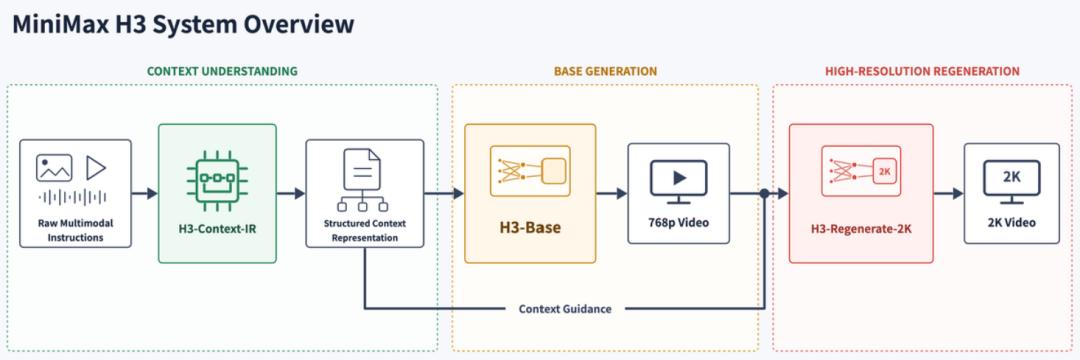
MiniMax H3的系统架构设计体现了其对多模态复杂性的深入思考。整个系统由三个核心模块组成:负责理解与编排指令的H3-Context-IR、负责生成音视频的H3-Base,以及负责生成2K画面的H3-Regenerate-2K。这种分工明确的设计,使得模型能够更精准地处理用户的多维需求。
H3-Context-IR是一套托管式的预处理与编排系统,它是整个工作流的“大脑”。该模块内部工作流包括指令解析、跨模态关联、时序理解和复杂逻辑推理。它能够理解文本、图像、音频和参考视频之间的关系,以及这些素材与预期生成结果之间的关联。虽然该模块暂未开源,但MiniMax提供了相应的API和提示词指南,允许开发者搭建自己的多模态预处理系统。
H3-Base则是实际的生成引擎。文本通过H3-Encoder编码,视觉素材同时经过H3-Encoder和H3-VisualVAE处理,音频则由H3-AudioVAE编码。不同模态的信息随后被组织成统一序列,输入H3-Omni-Transformer进行处理。这种架构允许模型在生成过程中充分融合多种感官信息,从而实现音画同步的高质量输出。
对于2K分辨率的输出,H3并未采用传统的专用超分辨率模块,而是通过H3-Regenerate-2K,让基础模型结合原始文本及多模态参考素材,对已经生成的768p视频进行重新生成。这种方式的优势在于可以再次利用原始上下文,有助于还原小文字和精细纹理等仅凭低分辨率画面难以补全的信息。尽管该模块同样未开源,但开发者可通过官方API复现完整的2K生成流程。
生成能力实测:自然度与一致性的平衡艺术
从实际效果来看,MiniMax H3在处理不同类型的视频生成任务时表现出了较高的完成度。在画面自然度、镜头组织和整体风格一致性方面,模型表现较为出色,但在画面真实感和镜头编排的精细化程度上仍有提升空间。
在风光摄影航拍视频的生成测试中,模型生成的15秒视频中,雪山、草地等自然景观较为真实,色彩、光影和航拍镜头运动也比较自然,长镜头整体保持了较好的视觉连贯性。然而,画面中的寺庙建筑仍呈现出较明显的AI生成感,细节处的纹理处理略显生硬。这表明模型在自然景观的宏观表现上优于人造物体的微观细节还原。
在商业广告视频生成测试中,模型生成了一段奶茶和游戏IP联动的广告视频。该视频包含6个分镜头,整体叙事顺序较为清楚,画面风格和广告氛围基本统一。但在多镜头编排方面,模型出现了一处较明显的重复错误:店员向顾客递出奶茶的动作被连续呈现了两次。这一案例反映出当前模型在复杂叙事逻辑和多镜头连贯性控制上,仍需通过更精细的上下文理解能力来优化。
部署与应用:从本地推理到云端API的灵活选择
为了降低开发者的使用门槛,MiniMax为H3提供了两种主要的验证和部署方式:本地部署H3-Base和完整2K工作流API调用。
H3-Base以FL2VA和Ref2VA两个独立模型仓库发布,均包含处理器、分词器、文本编码器、Omni Transformer、Visual VAE和Audio VAE等推理组件。开发者可以通过SGLang、vLLM、diffusers和ComfyUI等框架或工作流进行本地部署,并支持多GPU并行推理。
在本地部署模式下,开发者可以生成短边为768像素的音视频。其中,FL2VA版本支持文生音视频及首尾帧生成,最多可输入两张图像,不输入图像时执行文生视频任务,输入首尾帧则可生成对应中间内容。Ref2VA版本支持全模态参考生成,最多可输入9张图像、3段视频和3段音频,适用于角色与场景保留、动作和嘴型编辑、音色参考等复杂任务。
对于需要2K分辨率输出的场景,开发者需要结合本地模型与官方API。首先由H3-Context-IR理解并扩展用户输入,随后由本地部署的H3-Base生成768p音视频,最后通过H3-Regenerate-2K结合原始上下文重新生成2K视频。这种混合部署模式既利用了本地算力进行初步生成,又借助云端高精度模型提升画质,平衡了成本与效果。
生态共振:芯片与平台的共同演进
MiniMax H3的开源之所以能引发行业震动,很大程度上得益于其强大的生态协同能力。16家生态伙伴首日完成适配,涵盖了从底层芯片到上层推理框架的全链条。
在芯片层面,华为昇腾、摩尔线程、沐曦、海光信息、昆仑芯、天数智芯、壁仞科技等国产芯片厂商,以及AMD、Intel等国际巨头,均完成了对H3的支持。这意味着开发者可以根据自己的算力基础设施,灵活选择最优的部署方案,不再受制于单一的硬件环境。
在软件和平台层面,Hugging Face、魔搭ModelScope、ComfyUI、RunningHub、fal等开发社区和云推理平台,以及vLLM-Omni、SGLang等推理框架,均提供了相应的支持。这种全方位的适配,不仅加速了技术的落地应用,也为全模态视频模型的标准化和普及化奠定了基础。
行业展望:从单一画质到多模态生态的竞争升维
MiniMax H3的发布,标志着AI视频生成领域进入了一个新的阶段。竞争焦点已从单一的画质分辨率、帧率,延伸至声音生成、复杂指令理解、多模态上下文管理以及产业生态建设的综合较量。
随着H3-Context-IR等模块对跨模态关系的深入理解,未来的视频生成将不再是简单的“文字转视频”,而是真正的“多模态意图实现”。开发者可以更精确地控制视频的叙事节奏、情感表达和感官细节,从而在广告、影视制作、游戏开发等领域释放更大的创作潜力。
同时,开放生态的建设使得中小开发者和企业也能低成本地接入前沿AI能力。通过本地部署与API调用的灵活结合,模型可以在保证隐私和数据安全的前提下,满足多样化的商业需求。MiniMax H3的开源,不仅是一次技术开放,更是推动整个行业向更高效、更通用、更包容的方向发展的重要一步。未来,全模态视频模型有望成为像文本生成一样的基础设施,重塑内容创作的底层逻辑。