AI基础设施新范式:无问芯穹Agentic Infra如何重塑算力效率?
算力困局与范式转移:从线性堆叠到智能原生
人工智能的发展正站在一个关键的十字路口。随着模型从预训练向后训练、从推理时扩展向智能体扩展演进,计算需求呈现出指数级攀升的态势。传统的AI基础设施模式,即依靠产能的线性增长来堆叠算力,已经远远无法弥合供需之间持续扩大的缺口。这种“大力出奇迹”的时代正在终结,取而代之的是对极致效率与规模协同的极致追求。
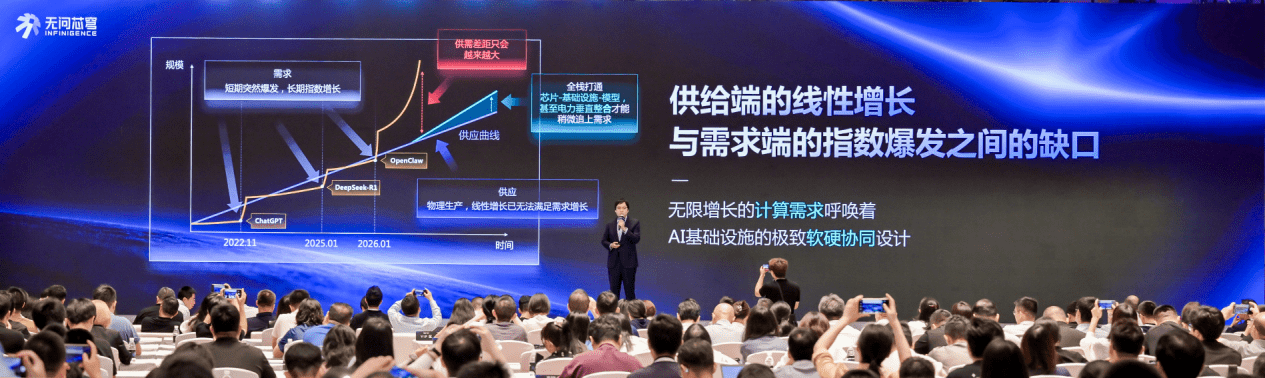
在这一背景下,无问芯穹联合创始人兼CEO夏立雪在2026年世界人工智能大会上提出了Agentic Infra(智能体基础设施)的全新定义。这不仅仅是一次技术升级,更是一场基础设施范式的革命。其核心逻辑在于,AI基础设施必须以极致的效率服务更大规模,通过“智能资源规模 × Token转化效率 × AI生产力转化效率”这一公式,重新定义AI生产力的生成路径。

“前店后厂一中心”:重构AI基础设施的三大支柱

无问芯穹提出的Agentic Infra战略布局,形象地概括为“前店后厂一中心”。这一架构并非简单的业务拼凑,而是基于底层资源向上支撑模型与应用的全栈协同优化体系。

首先,“算力集散中心”即Agentic Infra自主式基础设施平台,旨在解决全球性的算力异质化与碎片化难题。它通过多元异构、软硬协同的技术,将散落的、跨区域的算力资源统一汇聚、弹性调度。这不仅是算力的物理聚合,更是逻辑上的统一编排,为Agentic AI时代提供坚实且可扩展的算力底座。

其次,“Token工厂”即Agentic MaaS大模型服务平台,核心目标是实现Token的规模化、高质量生产。在Token经济时代,效率即利润。该平台通过首创的推理系统优化技术,大幅降低推理成本,提升响应速度,形成“优化即利润”的增长飞轮。

最后,“AI生产力商店”即Agentic Infra行业解决方案,致力于将高效的计算资源转化为行业认可的高质量AI生产力。通过赋能文娱、医疗、法律、能源等垂直领域,实现从技术到商业价值的闭环转化。

破解异构算力聚合难题:跨域协同的硬核实力

算力资源的异质化与碎片化是制约AI发展的全球性痛点。无问芯穹通过“多元异构、软硬协同”技术,打造了面向异构集群的大模型跨域训练系统,并在实际生产中经受住了三大类场景的考验。

在超远距离聚合方面,无问芯穹联合中国电信完成了国内首例超4000公里距离的大模型跨域混训。在新疆哈密与广东深圳两地集群间,通过计算通信重叠的流水编排与自适应通信流调度,实现了联合训练性能提升165%。这一突破验证了超远距离跨域集群协同训练的可行性,打破了地理空间的限制。

在多数据中心聚合场景中,系统打通了4个不同代际、不同型号的GPU集群,联合训练近百亿参数大模型,四集群协同性能提升41%。这不仅有效盘活了不同批次的存量异构算力,更证明了系统对复杂异构环境的强大适应能力。

在混合云算力聚合方面,系统实现了本地私有集群与公有云算力的安全互通混训,整体性能提升68%。这一能力帮助众多企业客户解决了本地算力不足、云上资源闲置的错配痛点,实现了算力的灵活调配与高效利用。

目前,这套跨域训练系统已在全国部署触达超37,000P算力,覆盖16种主流芯片。更重要的是,针对下一代AI进步的重要手段——强化学习,无问芯穹重点布局了跨集群强化学习场景。通过优化计算通信重叠技术,跨域通信效率直接提升3-4倍,实现了通信开销100%全掩盖。同时,搭建的故障无感训练机制,成功实现了跨域强化学习训练连续一周0中断稳定运行,让大规模跨域强化学习不仅“跑得通”,更能“跑得快、跑得稳”。

Token工厂的极致效率:PD分离架构与成本革命

在推理侧,无问芯穹的Agentic MaaS平台通过技术创新,推动了推理成本的显著下降。智能体推理需求具有上下文极长、交互轮次极多、缓存命中率极高的“三极”特征,这对吞吐、时延、缓存复用的要求远高于传统对话场景。

为此,无问芯穹首创了跨集群异构PD分离架构(Prefill-RelayDecode-MainDecode, PDD)。这一架构将传统的PD分离链路解构为三级分离式推理架构,相当于为“超级管线”加装了“精密增压阀”。通过让算力强的集群做Prefill任务,显存带宽高的集群做Decode任务,实现了“偏科”硬件的最优利用。

针对跨集群KV Cache传输的带宽和延迟瓶颈,系统创新性地迁移了Decode Radix Cache技术,将跨集群KV Cache传输数据量降低一个数量级。同时,RelayDecode机制先行输出Token,掩盖了以太网传输延迟,使得首Token延迟(TTFT)降低51.5%,单Token成本降低37.5%。

这一系列原始技术创新,推动了过去一年推理成本的10倍下降。随着跨集群异构PD分离架构的规模化落地,夏立雪判断推理成本依然有10倍的下降空间。通过与Kimi、智谱、Minimax等头部大模型企业的合作,平台单日Token调用量实现了40倍的爆发增长,形成了“业务带技术,技术提效率,效率促增长”的正向循环。

智能体蜂群:基础设施的自主进化与运维革命

基础设施本身也需要智能化。无问芯穹打造了基础设施智能体蜂群,包含平台管家、集群运维、算子生成三个子集,实现了从用户交互到硬件优化的全链路自主迭代。

平台管家智能体系统作为全局统筹者,通过自然语言交互,帮助用户完成复杂的资源运营、管理和答疑排障,能够独立解决80%的日常问题。智算集群运维智能体系统则作为7×24小时全天候值守的“运维专家团”,实现了从“人找问题”到“问题自己解决”的转变。经过验证,该系统可实现运维人效提升5倍以上,关键故障处理效率提升6倍。

在算子生成方面,KernelMind系统通过“需求分析—智能调度—内核生成—沙箱验证—评审沉淀”五步闭环工作流,稳定交付高质量工业级算子。在GLM5.2模型的实测中,该系统在NVIDIA旗舰卡中实现了端到端7.3%的性能提升,在AMD旗舰卡中更是带来了39%的整体性能跃升,全面超越了行业基线。

迈向物理世界:具身智能的云边端协同

无问芯穹的视野并未局限于云端,而是延伸至物理世界。针对具身智能,无问芯穹公布了首个面向大规模具身任务的云边端一体化管理与调度平台,首次将云端GPU集群、边缘算力节点和机器人真机设备统一接入。

在训练框架RLinf V0.3中,系统支持具身智能大规模真机、跨域端云协同的强化学习训练。通过首创的HotSwarm与端云协同训练模式,支持真机设备1000+次在线上下线,训练0中断,并将近百台真机规模的专线需求降至2Gbps以下,大幅拉低了具身智能规模化训练的成本门槛。

在推理部署方面,Mizar-Robo体系依托流水线调度、算子内核、量化压缩、计算图四层协同优化,全方位释放端侧硬件潜力。在与自变量机器人WALL-OSS系列模型的联合优化中,实现了7.14倍的推理性能提升,端侧推理时延从500ms压缩至70ms,降幅达86%,为机器人产品从实验室走向规模化商用落地提供了有力支撑。

结语:用智能进化智能,用生产力加速生产力

从“算力集散中心”做大资源总盘,到“Token工厂”深挖效率红利,再到“AI生产力商店”循环造血向产业输出价值,无问芯穹始终锚定“规模与效率”两大支点。Agentic Infra不仅是无问芯穹的战略蓝图,更代表了AGI时代基础设施的发展方向:为未来数字与物理世界的所有AI生产力的运行构筑基础设施。

正如夏立雪所言:“让智能无所不能,是AGI,而让智能无处不在,是AGI Infra。”在AI基础设施的决胜点上,唯有通过Agentic Infra实现自主迭代与自我优化,才能真正支撑起下一代AI的持续进化,实现“用智能进化智能,用生产力加速生产力”的愿景。

