AI幻觉背后的真相:为何超级编辑在重塑大模型的知识地基?
隐形基石:被忽视的人类智力投入
在2025年的AI版图上,模型参数的竞赛仍在继续,从千亿级参数到万亿级上下文窗口,算力与算法的突破构成了大众视野中的技术主流。然而,在这层光鲜亮丽的技术外壳之下,隐藏着另一套更为古老且基础的知识基础设施。如果说大语言模型是互联网的“大脑”,那么维基百科及其背后的志愿者群体,则是这座大脑的“海马体”——负责存储、整理和索引那些经过验证的结构化记忆。
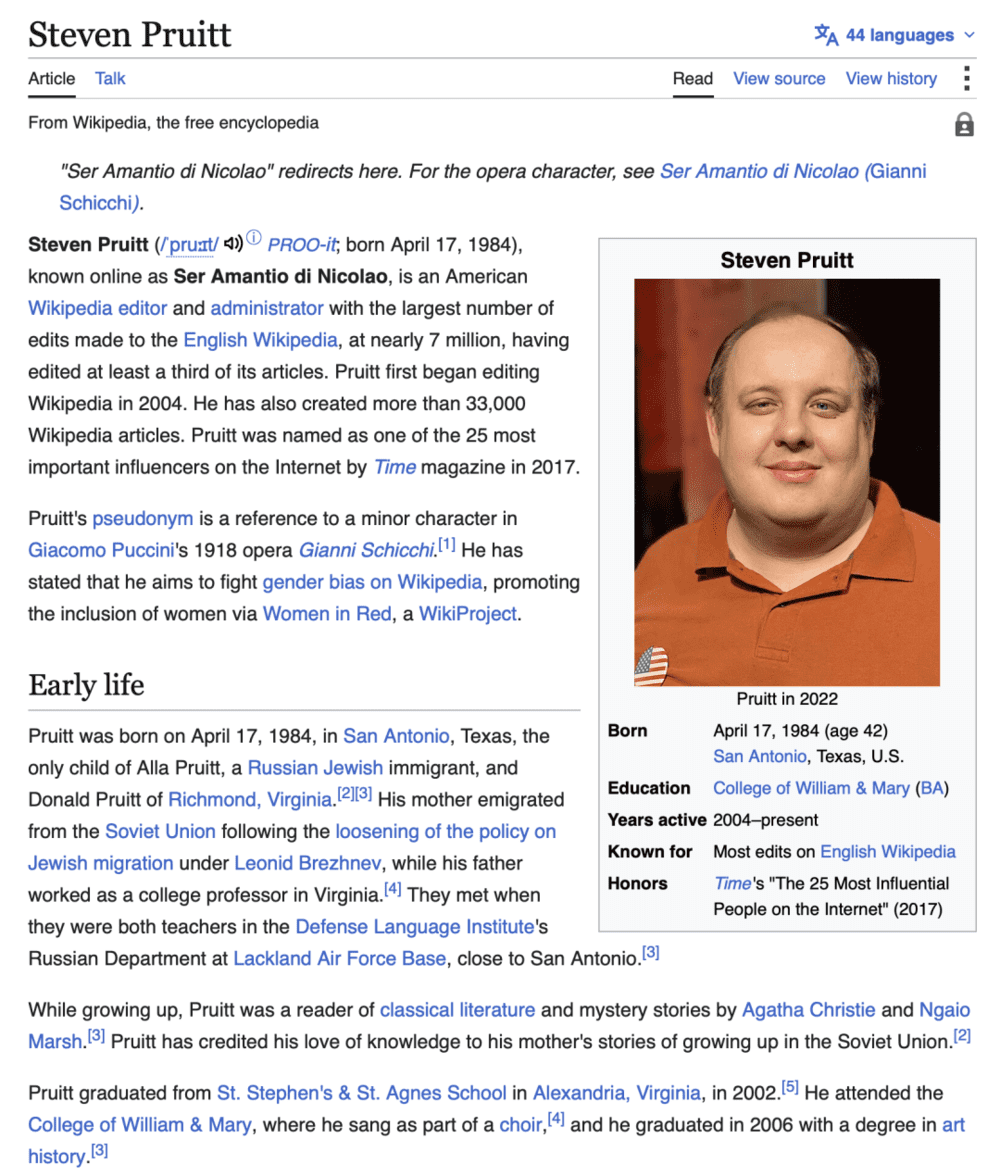
以Steven Pruitt为代表的“超级编辑”群体,构成了这一基础设施的核心支柱。Pruitt在维基百科上完成了超过600万次编辑,创建了数万篇词条。作为一名白天为联邦政府管理档案的普通职员,他在夜晚将精力投入到另一个庞大的数字档案库中。他的工作并非创造宏大的叙事,而是进行最为琐碎却至关重要的基础工程:修正日期、修复断裂链接、统一分类标签、核对引用来源。这些操作在人类读者眼中几乎不可见,因为它们不产生新的内容,只优化已有的结构。
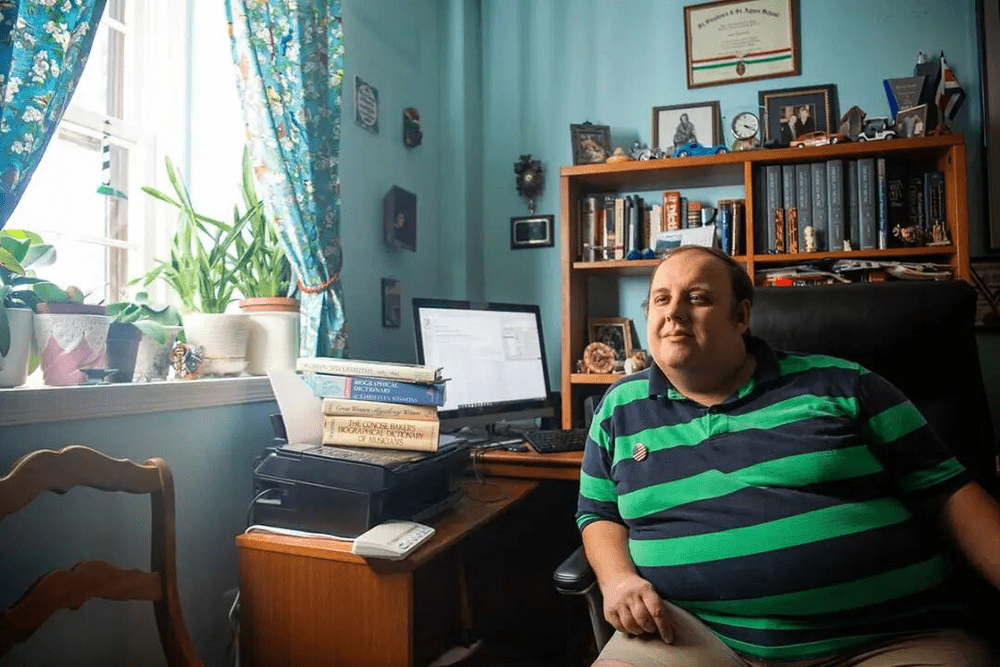
这种“清洁工”般的工作,恰恰是大模型能够高效运转的前提。大模型需要的是高质量、结构化、彼此关联且带有明确来源的数据。互联网早期的网页充满了噪声、死链和主观偏见,而维基百科的编辑者通过社区协作和严格的引用规范,将混乱的互联网信息提炼成了机器可理解的语义网络。正如《纽约客》所言,这群人无意中成为了“互联网大脑的意外缔造者”。没有他们建立的索引和秩序,AI面对的海量数据将只是一座杂乱无章的仓库,而非有序的图书馆。
秩序的重建:从UGC到知识资产
回顾互联网发展史,2001年维基百科的诞生标志着“用户生成内容”(UGC)的一种理想主义形态。在那个时代,人们相信知识可以由陌生人共同编写,成果可以免费共享。这种协作模式产生了一个独特的产物:它既保留了开放网络的广度,又引入了专业编辑的严谨性。
数据显示,在维基百科的前十年中,约77%的词条编辑来自仅1%的活跃编辑者。这群被称为“超级编辑”的人,包括了披萨店员工、电话接线员和退休教师。他们不为流量,不为署名,甚至不为报酬。Justin Knapp,这位英语维基百科首位完成百万次编辑的用户曾坦言,他们并不在意排行榜,因为编写百科全书的动力源于对知识本身的尊重。这种利他主义的协作,构建了一个独特的知识生态系统:每一个判断都必须有来源支持,每一个争议都必须在讨论页公开辩论,每一次修改都留有完整的审计痕迹。
这种高度结构化的知识形态,对于后来的机器学习具有不可估量的价值。与社交媒体上情绪化、碎片化的文本不同,维基百科的数据具有清晰的语义边界和逻辑关联。当ImageNet通过亚马逊众包任务为计算机视觉奠定基础时,维基百科同样通过人工智力为自然语言处理铺设了轨道。AI模型在训练过程中“吞下”的,不仅是文本,更是人类编辑者花费数十年时间建立的分类体系、实体关系和事实校验机制。
认知寄生:AI对公共知识的重构
然而,随着生成式AI的爆发,这种基于开放共享的知识体系面临着前所未有的张力。AI公司需要海量数据来训练模型,而维基百科因其高质量和高覆盖率,成为了首选的数据源。维基媒体基金会推出的Wikimedia Enterprise服务,直接向Amazon、Meta、Microsoft等科技巨头提供大规模、实时且结构化的数据接口。这一举措在逻辑上是将公共知识货币化以维持运营,但在伦理上却引发了关于“知识剥削”的争议。
问题在于,AI对维基百科的利用是一种单向的抽取,而非双向的协作。模型可以在极短时间内蒸馏出维基百科的核心知识,用于生成流畅的回答,但维护这套知识体系所需的服务器成本、带宽消耗以及人工审核工作,却依然主要依靠捐款和志愿者维持。更令人担忧的是,AI的普及正在改变用户获取信息的路径。数据显示,2025年部分月份,维基百科的人类浏览量同比下降了8%。用户不再访问维基百科本身,而是通过AI摘要获取信息。这意味着,知识的生产者(编辑者)和知识的消费者(读者)逐渐与知识本身脱节。
这种脱节导致了“认知寄生”现象:AI依赖于公共知识生长的土壤,却在输出端将其封闭在商业模型的“黑盒”中。当用户得到答案时,他们往往无法追溯信息来源,无法查看修改历史,更无法对错误的信息进行修正。知识从开放的公共领域,变成了封闭的产品属性。杜克大学法学者James Boyle曾提出的“第二次圈地运动”,在AI时代以一种更隐蔽的形式重现:围墙不再筑在知识的入口,而是筑在知识变成答案之后。
真实性的危机:当流畅取代准确
AI模型的“幻觉”问题,本质上是结构化知识缺失的体现。Steven Pruitt在评估xAI推出的Grokipedia时指出,许多词条看似正确,实则充满了微妙的偏差。例如,将一个人生命中的七年概括为“短暂”,这在文学上是流畅的,但在事实记录中却是主观的判断。哲学家Harry Frankfurt在《论扯淡》中区分了谎言与胡扯:说谎者知道真相,而胡扯者只关心话语的效果,对真假漠不关心。大模型在缺乏明确事实约束时,倾向于生成高概率但低准确性的文本,用流畅的语言掩盖逻辑的裂缝。
相比之下,维基百科的可追溯性是其对抗虚假信息的最大武器。在维基百科上,一个错误的日期可以被任何人修正,一个有争议的陈述必须附上参考文献。这种机制强制编辑者承担责任,也允许用户进行验证。2026年3月,英语维基百科通过新规,原则上禁止使用大模型生成或改写词条正文,仅允许有限的人工复核。Pruitt对此表示支持,他强调:“你无法与一个不承担责任的东西协作。”
在AI时代,答案变得廉价,但求证变得奢侈。当生成信息的成本趋近于零,验证信息的成本却急剧上升。用户需要花费更多精力去核对AI给出的结论是否遗漏了关键语境,是否基于可靠的来源。此时,维基百科编辑者的角色显得尤为珍贵。他们守护的不仅是知识,更是一种严谨的求真精神:敢于承认未知,敢于修正错误,敢于为每一个事实承担责任。
重建知识主权:迈向负责任的AI生态
要解决AI与公共知识之间的结构性矛盾,不能仅靠技术自律,更需要制度创新。首先,AI公司应当承担起知识维护者的责任。既然商业模型从开放知识中获利,就应当通过公平的资金支持或技术贡献,回馈维基百科等基础设施。这不仅是经济补偿,更是对知识生产劳动的尊重。
其次,需要建立更透明的知识溯源机制。未来的AI产品应当能够明确标注其生成内容的来源,允许用户点击链接直达原始文档,甚至参与到知识的更新与纠错中。这种“人机协作”的闭环,才能打破封闭模型的垄断,重建用户对数字信息的信任。
最后,社会需要重新审视“超级编辑”的价值。在算法主导的时代,人类的判断力、伦理考量和责任感是机器无法替代的。Steven Pruitt们的工作提醒我们,知识的准确性不仅依赖于算力,更依赖于人的耐心与严谨。如果未来的AI继续依赖人类共同积累的知识,那么它必须学会尊重这些知识的来源,保护开放知识生长的土壤,否则,AI越强大,其赖以生存的地基就越脆弱。
在这个意义上,保护维基百科及其编辑者,不仅仅是保护一个网站,更是保护数字时代真理存在的空间。只有当开放、可验证、可协作的知识体系得到充分尊重和支持,我们才能确保AI不仅是信息的搬运工,更是人类智慧的可靠延伸。