AI训练销毁书籍引争议:马斯克倡导无损扫描,出版业迎来价值重估
随着生成式人工智能技术的指数级迭代,互联网上由人类原创的高质量文本正逐渐被AI生成的合成数据所淹没。这种“数据污染”现象迫使各大科技巨头将目光重新投向了物理世界,尤其是那些尚未被数字化、未受AI算法浸染的纸质书籍。近期,一则关于AI公司批量购买并销毁实体书以获取训练数据的报道,再次将技术效率与文化伦理的冲突推至风口浪尖。这不仅是一场关于数据获取方式的技术辩论,更是一次对知识产权边界、文化遗产保护以及出版业未来价值的深刻重构。
所谓“干净语料”,指的是在2022年之前出版、未经过大型语言模型训练或生成的文本数据。对于追求模型推理能力突破的AI企业而言,这类数据被视为提升模型智能水平的“黄金矿藏”。然而,获取这些数据的成本正在急剧上升。独立媒体404 MediaX的报道揭示了一种极端且具争议的操作模式:部分AI公司通过中间商批量采购珍稀书籍,利用工业级液压切割机切除书脊,以便高速平板扫描仪快速读取内页内容。在完成数据采集后,这些失去装订结构的书籍往往被直接粉碎销毁,以防止其重新流入二手市场或被他人再次扫描。据报道,Anthropic执行的这项被称为“巴拿马计划”的行动,涉及数百万册实体书,其中包括许多存世量极少的绝版古籍。尽管美国联邦法院裁定这种“合法购买后破坏性扫描”的行为属于合理使用范畴,但其在文化界引发的道德谴责并未因此平息。
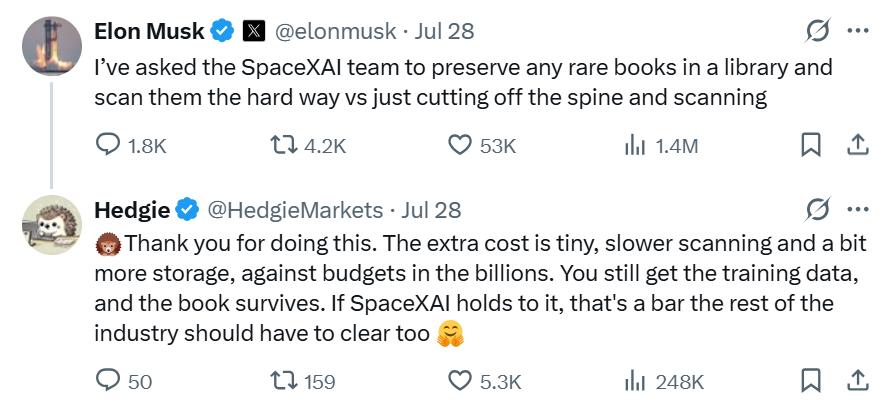
面对舆论的强烈反弹,科技界领袖迅速做出了反应。埃隆·马斯克在社交媒体平台上明确表态,已指令SpaceXAI团队采取截然不同的策略:保存图书馆中的所有珍贵书籍,并采用无损扫描方式进行数字化处理。虽然无损扫描的速度远低于破坏性切割,且对设备精度和操作环境要求更高,但这种方式完整保留了书籍的物理形态和历史价值。马斯克的这一举措不仅是对公众关切的回应,更可能成为行业新的合规标杆。如果头部企业能够坚持这一高标准,其他追随者将面临巨大的道德压力和技术升级需求,从而推动整个AI数据采集行业向更文明、更可持续的方向转型。
在这场数据争夺战中,出版业的角色正在发生微妙而深刻的变化。过去,出版商常被视为传统媒体的守门人,而在AI时代,他们手中持有的版权清晰、内容优质的图书资源,突然变成了极具战略意义的核心资产。ISBNdb等图书数据库服务商转型为AI企业的“数据供应商”,以及Better World Books与Anthropic的合作,都表明一条从旧书回收到大模型训练的隐秘产业链已经形成。然而,这条链条并非没有裂痕。新闻集团指控Brave Software未经授权抓取其旗下媒体内容用于AI训练,以及多家出版商联合起诉谷歌非法使用受版权保护书籍构建Gemini模型,均显示出版权方对于自身资产被无偿或低价攫取的强烈不满。谷歌内部评估面临的潜在罚款高达数百亿美元,这足以让任何一家科技公司在数据合规问题上慎之又慎。
从产业经济学的角度审视,这场纠纷的本质是优质内容供给与AI算力需求之间的结构性矛盾。大模型的训练不仅需要海量的数据,更需要高质量、高逻辑密度、低噪声的数据。互联网公开数据中充斥着重复、低质甚至虚假的信息,而经过编辑、校对、审核出版的图书,天然具备更高的信息信噪比。中信证券研报指出,预计2026年文化IP数字化运营有望为出版业带来约700亿元的增量空间。这一预测并非空穴来风,而是基于出版企业所拥有的内容资产在AI生态中的稀缺性溢价。当通用数据趋于饱和,垂直领域、专业性强、版权归属清晰的图书内容将成为模型差异化竞争的关键。
然而,单纯依靠诉讼并不能解决根本问题。出版业需要思考的是,如何从被动的版权防御者转变为主动的数据资产运营商。首先,建立标准化的数字授权机制至关重要。出版机构可以联合成立数据联盟,制定统一的数据定价、授权范围和收益分配标准,避免个体在面对科技巨头时的议价劣势。其次,探索“数据入股”或“模型分成”等新型合作模式,使出版方能够分享AI技术发展带来的长期红利,而非仅一次性出售数据使用权。此外,利用区块链技术进行版权确权和数据溯源,可以有效防止数据被滥用或二次转售,保障内容创作者的合法权益。
对于AI企业而言,转向无损扫描和合规授权不仅是道德选择,更是长期的商业理性。破坏性获取数据虽然短期成本低、效率高,但面临着巨大的声誉风险和潜在的法律诉讼成本。随着全球范围内对AI监管的加强,如欧盟《人工智能法案》等法规的实施,数据来源的合法性将成为模型上市的前置条件。SpaceXAI所倡导的无损扫描模式,虽然初期投入较大,但能够建立与图书馆、博物馆及出版机构的信任关系,获得更稳定、更高质量的数据来源。这种合作关系的建立,有助于AI企业在未来的竞争中占据道德和合规的高地。
同时,技术进步也为平衡数据获取与文化保护提供了新的解决方案。高分辨率非接触式扫描技术的发展,使得在不损伤书脊的情况下快速数字化成为可能。自动化翻页机器人结合光学字符识别(OCR)和自然语言处理(NLP)技术,可以大幅提高无损扫描的效率,缩小其与破坏性扫描在成本和时间上的差距。此外,联邦学习等隐私计算技术的应用,允许模型在不直接获取原始数据的情况下进行训练,进一步降低了数据泄露和版权侵权的风险。
出版业的数字化转型不应仅仅停留在电子书层面,更应深入到数据要素的价值挖掘。中泰证券分析认为,相关出版公司内容版权归属较清晰,垂类内容优势明显,有望跨越互联网、AI等多个技术周期,成为持续发展的底层核心资产。这意味着,出版企业需要重新审视自身的资源禀赋,将传统的编辑出版能力转化为数据清洗、标注和管理的能力。通过构建专业的垂直领域知识库,出版业可以为特定行业的AI应用提供高精度的训练数据,从而在细分市场中建立竞争壁垒。
值得注意的是,这场关于书籍命运的讨论,也折射出人类社会在智能化进程中对知识载体的态度变迁。书籍不仅是信息的容器,更是文化的象征和历史的见证。大规模销毁书籍的行为,即便在法律上被认定为合理,在文化情感上也是难以接受的。它提醒我们,在追求技术效率的同时,不能忽视对人类文明成果的尊重。无损扫描不仅是一种技术手段,更是一种文化态度的体现。它表明,我们可以既享受AI带来的便利,又守护好人类知识的物理根基。
未来,随着AI模型的不断进化,对数据质量的要求将越来越高。简单的文本堆砌已无法满足需求,结构化、语义化、多模态的数据将成为主流。出版业若能抓住这一机遇,积极参与到AI数据生态的建设中,不仅能实现自身的价值重估,还能为人工智能的健康发展提供坚实的内容支撑。而对于监管机构而言,需要在鼓励技术创新和保护知识产权之间找到平衡点,制定更加细化、可操作的数据使用规范,引导行业走向良性竞争。
综上所述,AI巨头对实体书的“掠夺”与“保护”之争,实际上是人工智能发展进入深水区的一个缩影。它揭示了数据稀缺时代的资源焦虑,也展现了技术与人文碰撞时的复杂张力。马斯克的介入和出版业的觉醒,预示着行业规则正在重塑。在这个过程中,无损扫描技术的推广、版权授权模式的创新以及出版资产的数字化运营,将是决定各方利益格局的关键变量。唯有在尊重文化价值的前提下,通过技术革新和制度完善,才能实现人工智能与人类文明的和谐共生,让每一本书籍都能在数字时代找到其应有的位置和价值。