算力围墙内的架构突围:中国AI如何重写全球智能成本账单?
算力围墙与数据高墙的双重夹击
在2026年的今天,回顾中国人工智能大模型的发展历程,最引人注目的并非单纯的性能指标追赶,而是一场由外部限制倒逼出的底层架构革命。2022年10月,美国对华出口管制将A100、H100等高端AI芯片列入清单,这道被称为“算力围墙”的高墙,旨在遏制中国AI算力的增长速度。然而,讽刺的是,这道墙并没有阻断创新,反而促使中国模型开发者对沿用近十年的Transformer架构进行了彻底的重构。这种重构并非在应用层的小修小补,而是深入到了模型的最底层逻辑:注意力机制、残差连接、优化器以及参数组织方式,无一幸免地被重新设计与优化。
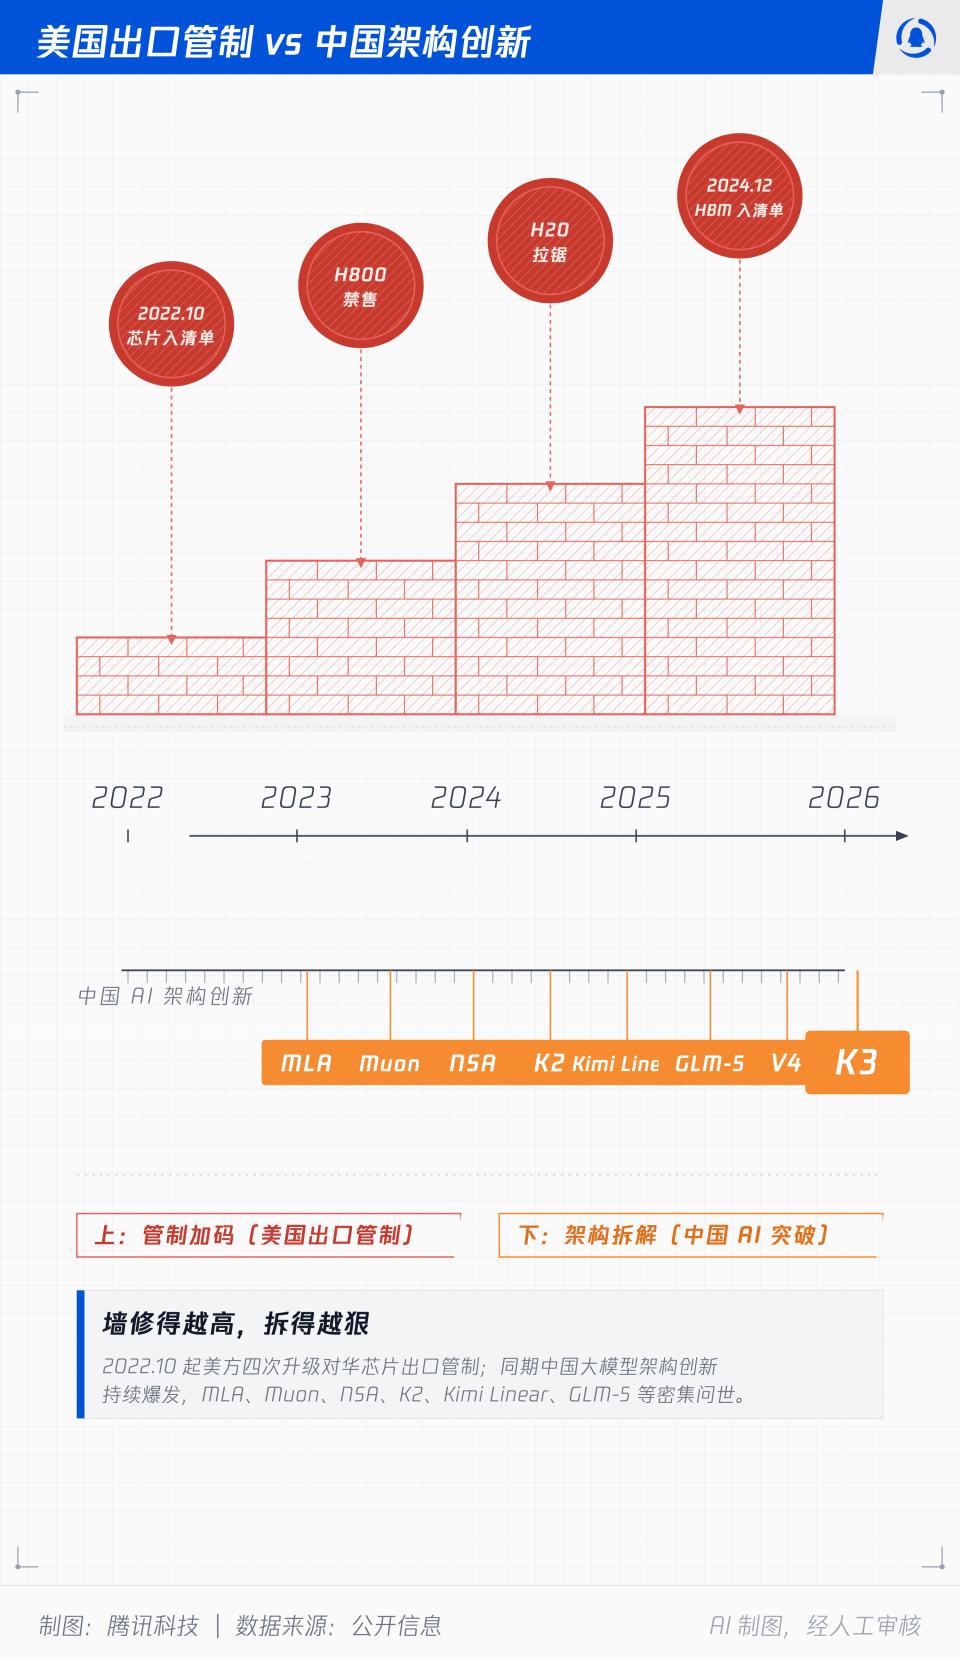
与此同时,所有AI研究者还面临着另一堵无形的墙——“数据墙”。随着高质量训练数据的日益枯竭,单纯堆砌数据量的边际效应急剧递减。正如月之暗面创始人杨植麟在GTC大会上所言,token效率不仅关乎成本,更决定了智能的上限。当数据无法无限获取时,模型能从每一个token中提取多少信息,成为了突破智能瓶颈的关键。在算力受限于硬件出口管制、数据受限于质量瓶颈的双重压力下,中国大模型公司走出了一条独特的技术路线:通过极致的架构优化,在有限的硬件资源下榨取最大的智能密度。这条被围墙逼出的路径,如今正反向改写全球算力与存储的经济账单。
拆解Transformer:三大核心组件的重塑
要理解这场架构革命的意义,首先需要明确传统Transformer架构中的“三大件”:注意力机制、残差连接和优化器。在过去九年里,这三大组件构成了大模型的基础骨架,但在算力受限的背景下,它们成为了必须被优化的痛点。
首先是注意力机制的重构。传统的全注意力机制(Softmax Attention)在处理长上下文时,其Key-Value缓存(KV Cache)的开销呈线性增长。以Llama 3.1-70B为例,在128K上下文窗口下,单个会话就需要约40GB的显存来存储KV缓存;若上下文长度延长至百万token,所需显存将激增至320GB,这甚至超过了英伟达旗舰GPU的单卡显存容量。为解决这一瓶颈,中国模型开发者率先引入了混合线性注意力(如KDA)和门控机制。以Kimi K3为例,其采用了3:1的混合架构,即在93层中,约四分之三采用低维度的KDA线性层,四分之一采用门控MLA层。这种设计使得KV缓存的最大节省比例达到75%,在百万token场景下,吞吐能力提升了6倍。尽管K3拥有2.8万亿参数,其缓存体积反而比参数量小得多的Llama 3.1-70B还要小13倍。
其次是残差连接的优化。传统Transformer中,每一层的输出都会无条件地叠加回主干网络。而Kimi K3引入了注意力残差(AttnRes),允许深层网络通过注意力机制选择性地从前面各层聚合信息。这种“按需回取”的机制,不仅减少了无用信息的传递,还使得模型在训练过程中节省了约20%的算力。此外,通过将全层折分为8个块进行记账,进一步降低了显存开销。
最后是优化器的革新。传统的AdamW优化器在大规模训练中效率受限。杨植麟团队引入了由OpenAI前研究员Keller Jordan开发的Muon优化器,并将其改良为按注意力头独立调节的MuonClip。在百亿参数级别的验证中,Muon展现了约为AdamW两倍的算力效率。这一优化直接降低了训练所需的FLOP(浮点运算次数),使得在有限算力下训练万亿参数模型成为可能。
参数的两本账:MoE与精度的极致压榨
在架构优化的同时,中国模型在参数管理上也走出了差异化的道路,核心在于区分“总参数”与“激活参数”,从而分别应对知识容量与算力账单的双重挑战。
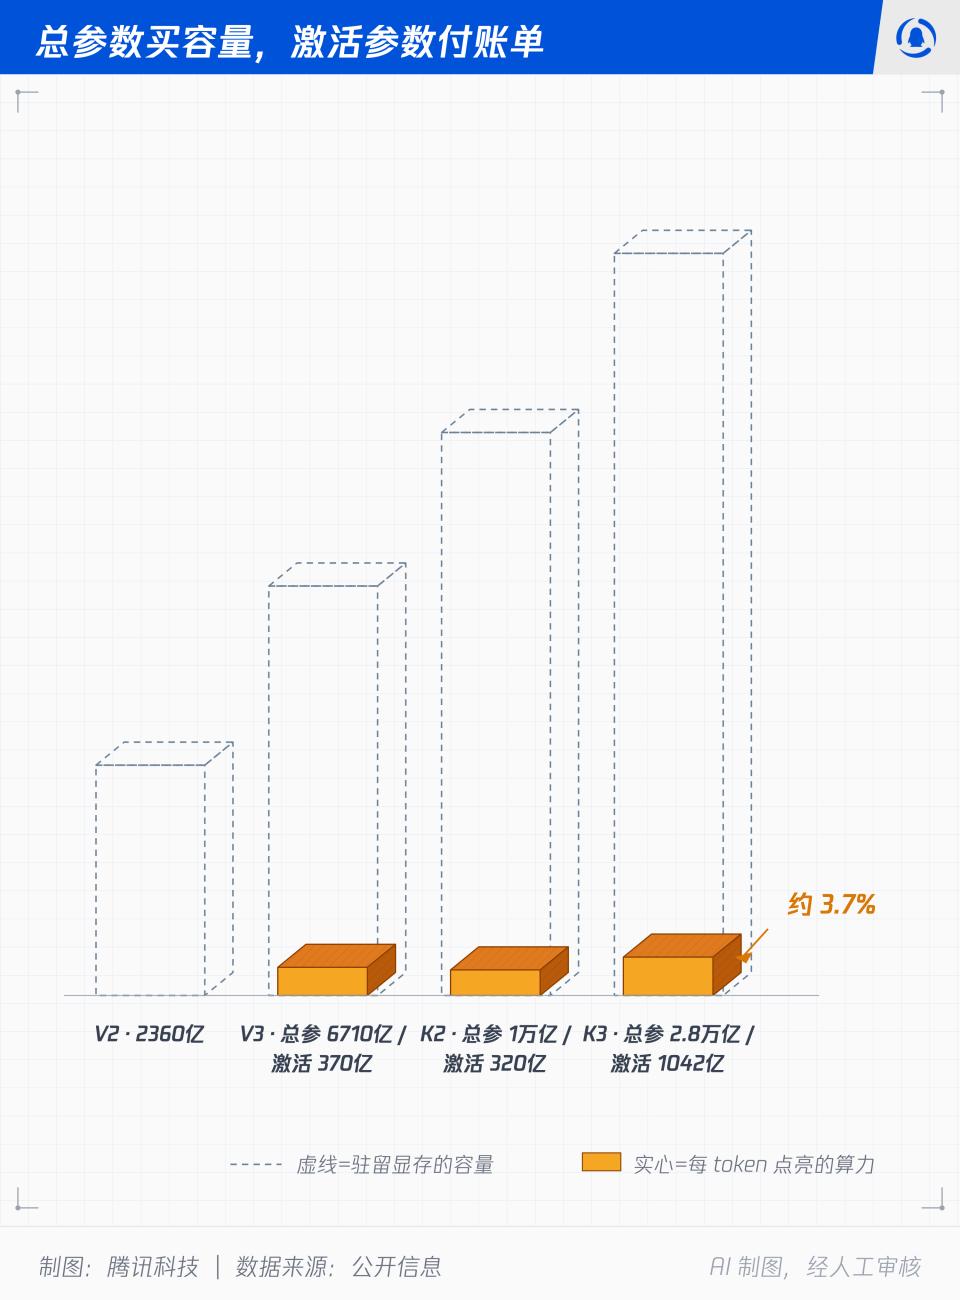
MoE(混合专家模型)是这一策略的典型代表。DeepSeek V3与Kimi K2/K3均采用了极端的稀疏MoE架构。DeepSeek V3拥有6710亿总参数,但每个token仅激活370亿;Kimi K3更是将总参数推至2.8万亿,激活参数为1042亿。这种架构使得模型能够容纳海量的知识储备,而在推理时仅消耗少量算力,实现了“存储容量”与“计算成本”的解耦。
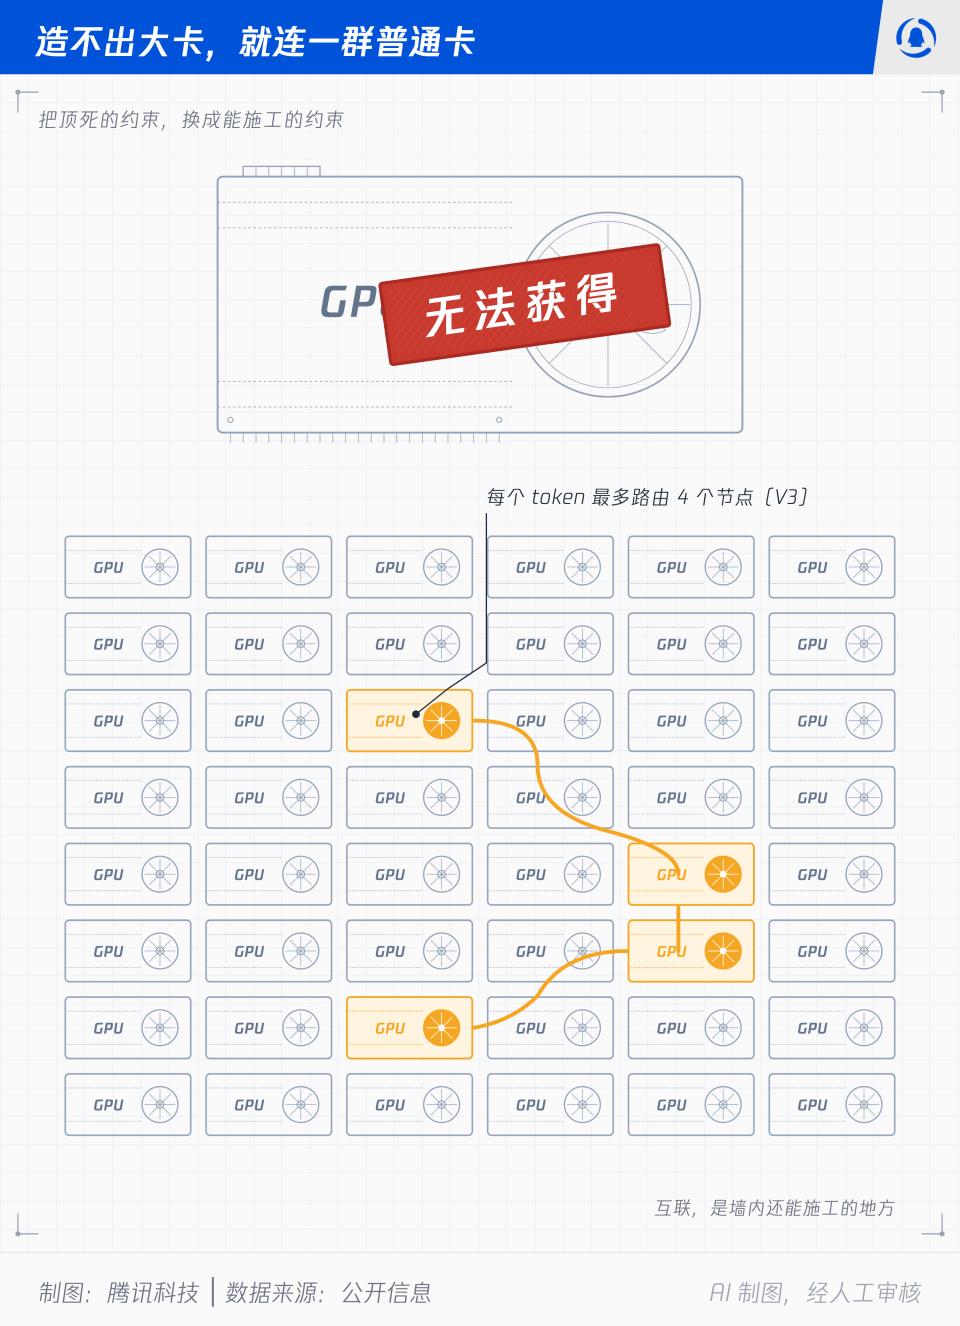
然而,MoE并未解决权重本身的存储问题。随着总参数规模的爆炸式增长,模型权重的物理大小成为新的瓶颈。Kimi K3在MXFP4精度下,权重仍高达1.4TB左右。为满足专家并行通信的需求,官方建议至少64张卡起步。为了进一步压缩空间,中国模型在量化技术上走在了前列。DeepSeek V3在2024年底率先跑通FP8训练,而Kimi K3则进一步将推理权重降至MXFP4,并结合从监督微调(SFT)阶段开始的量化感知训练。精度每降低一档,同等显存下可装载的参数规模便翻倍,从而在不增加硬件成本的前提下,大幅提升了模型的知识密度。
这种优化路径揭示了一个核心逻辑:算力围墙迫使开发者不再追求“全员上岗”的暴力美学,而是转向“按需激活”与“极致压缩”的精细化管理。每一比特字节、每一次权重搬运,都被赋予了更高的价值密度。
从笔记本到白板:记忆机制的范式转移
长上下文处理是大模型应用落地的关键场景,也是中国模型突围的重点方向。传统的Transformer通过KV Cache记录历史状态,这如同在一本越写越厚的笔记本上逐字记录,导致上下文越长,读取和写入的速度越慢,显存压力越大。
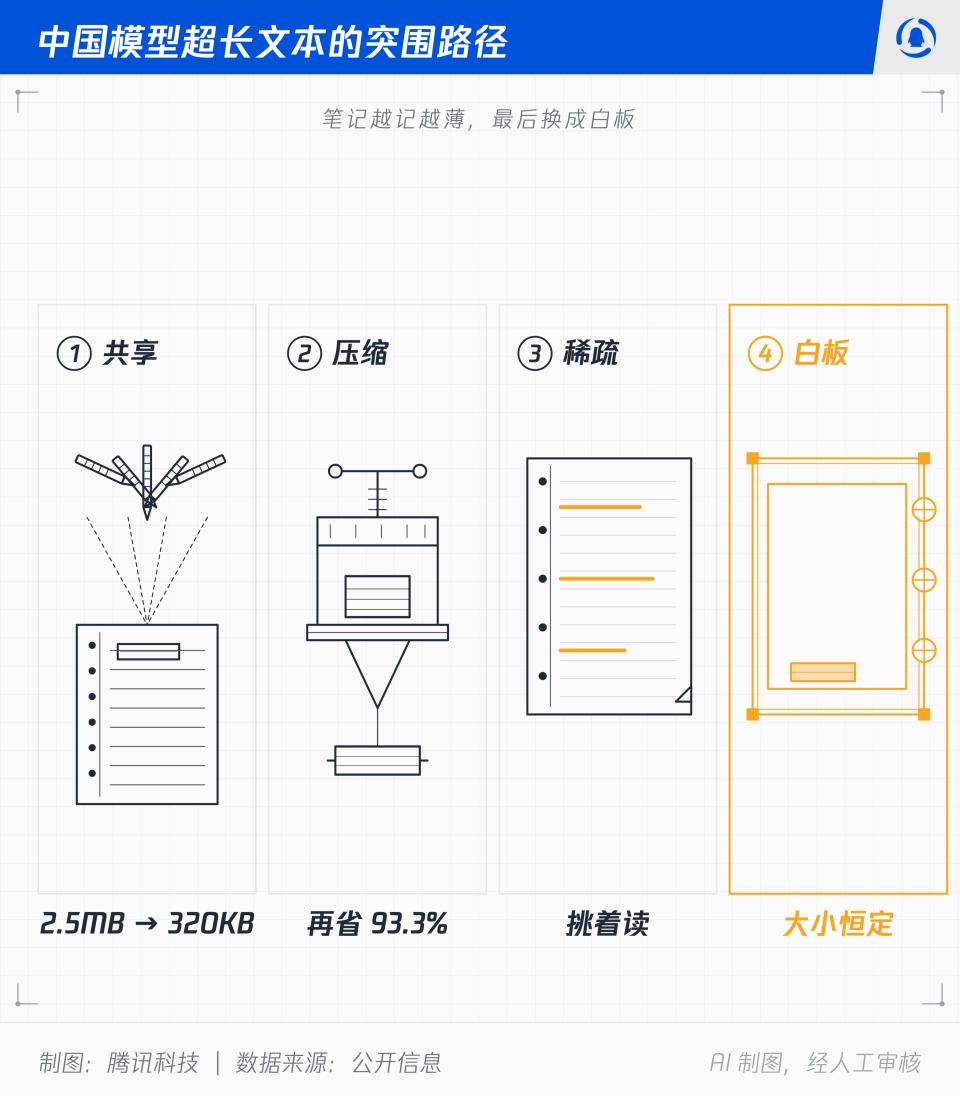
中国模型在这一领域经历了从“共享”到“压缩”,再到“重写记忆机制”的四步演进。初期通过MQA/GQA技术共享KV缓存,将单token缓存从2.5MB降至320KB。随后,DeepSeek推出的MLA(混合低秩注意力)将上下文映射到低维存储,推理时再还原,使得KV开销再降93.3%。
更进一步,Kimi K3引入了KDA(关键依赖注意力),这是一种线性注意力的变体。与传统KV Cache不同,KDA使用固定维度的矩阵状态来代表记忆。这意味着记忆不再随上下文长度线性增长,而是保持在一个固定的“白板”大小。这种机制不仅解决了长文本的显存瓶颈,还通过门控机制,使得模型能够区分哪些信息需要全局注意力,哪些可以通过线性近似处理。
然而,这种“白板矩阵”也带来了新的挑战:由于状态是累积的,无法像传统KV缓存那样按前缀拆分复用。为此,Kimi团队重写了vLLM的缓存逻辑,并采用了差异化的定价策略:命中复用状态的用户每百万token收费0.3美元,而未命中需重新计算的用户则收费3美元。这一策略不仅解决了技术难题,更揭示了长文本时代的真正成本结构——token只是表面单位,状态的生、存、复用才是决定账单的关键。
行业分岔与杰文斯悖论:效率提升后的需求爆炸
尽管优化方向一致,但各家厂商在具体实现上走出了不同的技术路线,形成了鲜明的“分岔”现象。DeepSeek坚持稀疏压缩路线,Qwen与Kimi采用混合线性架构,智谱GLM-5则尝试重新组合MLA与DSA零件,甚至调整头数以适应非H800硬件。这种分歧表明,随着AI芯片多元化的趋势加剧,同一套架构通吃所有硬件的时代正在终结。模型将像软件程序一样,针对不同硬件特性进行“编译”,分化出不同的头数、专家布局与精度方案。
MiniMax的路线曲折而具有代表性。其M1采用混合架构,M2转向全注意力,M2.5延续全注意力,直到M3才回归稀疏注意力。这表明,全注意力虽然在短文本上表现优异,但在大规模多跳推理中,其全局依赖特性难以被完全替代。行业共识逐渐清晰:全注意力不会消失,但将从“固定主干”转变为“按需精确能力”,即在大多数场景使用低成本路径,仅在复杂推理时唤醒全局注意力。
这种架构优化带来了显著的“杰文斯悖论”现象。理论上,效率提升应导致总需求下降,但在AI领域,情况恰恰相反。随着单token成本的降低,百万上下文、深度推理、常驻Agent等新需求迅速涌入,将节省下来的算力和内存迅速填满。Kimi K3就是一个典型例子:虽然KV压缩节省了空间,但这些空间被用于支持1M上下文和常驻思考模式,导致旗舰版本的定价反而比前代高出四倍,每百万token收费15美元。月之暗面商业化负责人明确表示,开源模型不再贴上低价标签,而是通过提供更高质量的智能服务来定价。
全球生态重构:谁在给AI未来背书?
这场由算力围墙引发的架构革命,其影响早已溢出中国,深刻重塑着全球AI生态与商业逻辑。2026年7月,Kimi K3完整权重上传Hugging Face,三天前,黄仁勋在X上转发支持“开放权重、维护美国AI领导地位”的联名信。这一举动并非偶然,而是英伟达深思熟虑后的战略选择。
英伟达的逻辑在于:权重越开放,模型越像公共零件,购买算力的用户就从少数科技巨头扩展到更广泛的开发者和企业,芯片生意基本盘更稳。相反,OpenAI与Anthropic等巨头自研芯片的趋势,才真正威胁到英伟达的垄断地位。开源中国模型在海外的成功,反而拉动了全球对英伟达算力的需求,抵消了出口管制带来的部分损失。
然而,收益分配正在发生转移。随着架构优化使得单卡性能的重要性下降,互联带宽与存储容量的重要性上升。DRAM合约价的暴涨印证了这一点:省下的显存压力转化为对主存和固态硬盘的巨大需求。创新发生在中国,标准沉淀在开源社区,但利润可能被存储厂商、云平台和下游应用拿走。为避免这一结果,中国模型公司必须从单纯的权重与Token供应商,转向托管运行时与长运行Agent的生态构建者。
结语:未竟之路与智能定价权
回顾过去四年,中国AI大模型在算力围墙内完成了一场静默而深刻的解剖学手术。从Transformer的拆解到MoE的极限应用,从KV Cache的重构到优化器的革新,每一条技术路线的探索,都是在为每一笔算力账单寻找最优解。这种优化并非为了降低价格,而是为了在有限的资源下,最大化智能的密度与可用性。
未来两年,混合架构将成为主流,全注意力将根据任务难度动态分配,模型将具备更复杂的记忆与路由能力。随着Mamba-3、RWKV-7等无注意力架构的规模扩张,以及扩散语言模型并行生成技术的突破,现有的投机解码机制可能退化为过渡方案。TTT(Test-Time Training)等新型记忆机制,有望让模型在推理期间动态更新参数,实现真正的个性化智能。
黄仁勋的背书与Kimi K3的开源,标志着全球AI竞争进入新阶段:从硬件算力的封锁,转向软件架构与创新速度的较量。算力围墙并未拦住中国AI的突围,反而逼出了一条更高效、更智能、更具经济性的技术路径。在这场重塑全球智能成本账单的博弈中,握笔的人,正是那些曾被围墙困住的人。