K3参数碾压海外巨头,月之暗面凭何构建2.8万亿参数护城河?
参数规模的重定义:从“量变”到“质变”的技术跃迁
当2.8万亿参数的K3模型正式亮相,人工智能行业再次被推至聚光灯下。这不仅是数字上的刷新,更是对“基础大模型已近瓶颈”这一悲观论调的有力回击。在具身智能、人形机器人等硬件应用热度攀升的当下,纯基础大模型赛道曾一度被视为缺乏想象力的红海。然而,K3凭借其在AA-Briefcase长周期知识工作中排名第二、在Arena前端开发榜以1677分登顶的成绩,证明了一个核心事实:基模的能力上限远未被触及,极致的参数规模依然能带来维度的碾压。
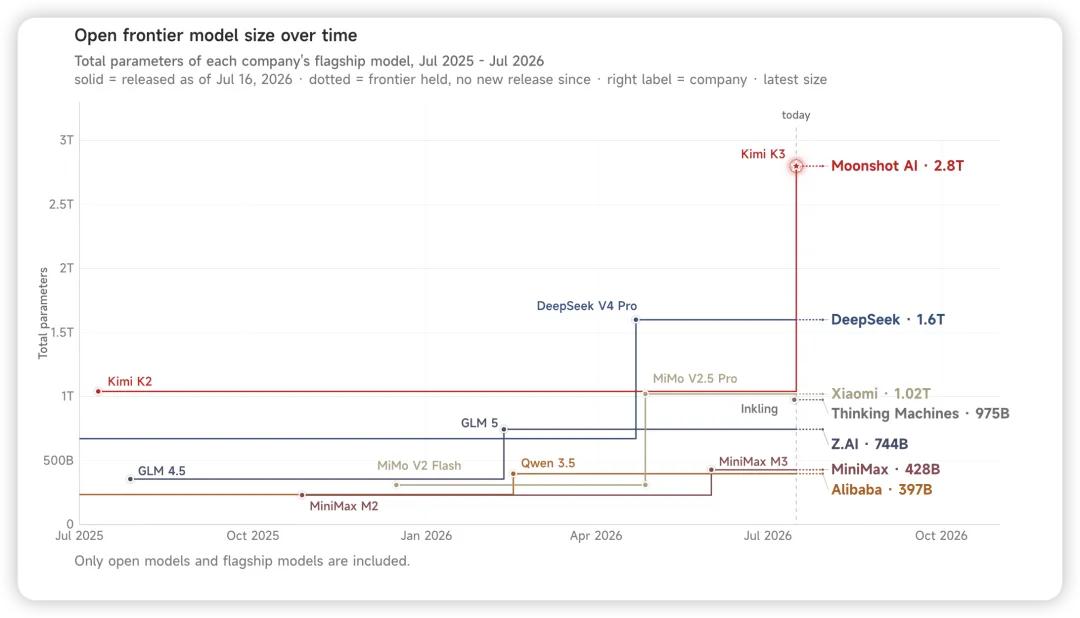
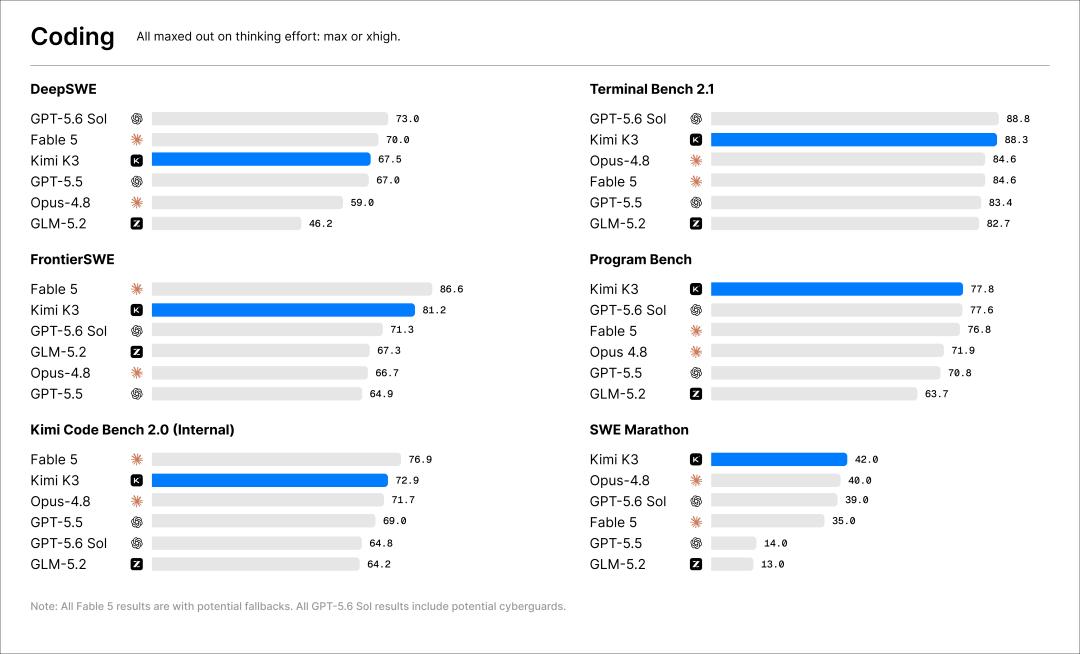
K3的核心竞争力并非简单的堆砌,而是源于其“原生”的智能特质。官方数据显示,K3拥有100万Token的超长上下文窗口和原生视觉理解能力。在OmniDocBench推理测试中,K3以91.1分的成绩超越了Claude Opus 4.8的89.8分。月之暗面企业业务负责人黄震昕指出,K3并非依赖后天大量技能学习打磨出的“特长生”,而是一个原生具备高难度长时程推理能力的“天才”。这种原生智能的特质,使其在处理复杂逻辑链条和多轮对话时,展现出远超同侪的稳定性和准确性。
更为关键的是,K3在算力效率上的突破打破了“参数越大,成本越高”的传统认知。通过优化模型容量、注意力机制及跨层信息流,K3将MoE(混合专家模型)的稀疏激活率推至惊人的1.79%(16/896)。这意味着在每次推理中,仅有极少量参数被激活,从而在容纳海量知识与技能的同时,实现了整体训练效率较上一代K2提升约2.5倍。这种将算力高效转化为能力的方式,使得K3在单任务成本0.94美元的定价下,具备了极具竞争力的性价比,为后续的商业化扩张奠定了技术底气。
创始人基因:学术积淀决定技术优先的战略定力
任何颠覆性技术的诞生,往往都能在创始人的履历中找到注脚。月之暗面创始人杨植麟的学术背景,为K3的技术卓越性提供了最有力的解释。作为清华大学计算机系本科、卡内基梅隆大学博士出身,杨植麟是Transformer-XL和XLNet这两篇经典论文的核心作者。这两篇论文对大模型序列建模和长程依赖处理的影响深远,累计引用量位居行业前列。
深厚的学术积淀,奠定了月之暗面“技术优先”的发展基调。与互联网大厂动辄数十亿营销预算、追求月活规模优势的打法不同,月之暗面选择了一条更为孤独却坚定的道路:依靠关键技术迭代赢得行业话语权。这种路径与DeepSeek创始人梁文锋的选择高度相似,二者均不依赖低价补贴抢占用户,而是依托硬核模型能力构建壁垒。这种“不着急赚钱”的表象下,实则是对产品力极致追求的自信。在行业追逐流量风口之际,沉下心打磨基础能力的玩家,往往能在技术验证完成后,掌握更稳固的博弈主动权。
马斯克对K3的“Impressive”评价,以及其团队表示下一代xAI模型“有可能超过Kimi”的言论,侧面印证了中国AI力量在全球版图中的崛起。美国领先的逻辑并非绝对,中国AI企业正通过原生创新,重新定义全球大模型的竞争格局。
商业化博弈:B端溢价与C端分层的精准切割
技术验证只是第一步,商业化落地才是检验企业生命力的试金石。月之暗面在商业化布局上展现出比DeepSeek更为主动和清晰的节奏,其B端与C端的双轮驱动策略,揭示了大模型厂商在“能力溢价”与“市场广度”之间的精妙平衡。
在B端市场,Kimi已渗透互联网、金融、制造、教育、医疗等核心领域,且海外市场增长迅猛,付费用户和API收入同比增长400%,产品覆盖200多个国家和地区。值得注意的是,大模型行业正迎来普遍的涨价潮。智谱GLM-5系列、DeepSeek V4均通过调整定价策略提升收益,Kimi亦将K2.7 Code的单价从4元上调至6.5元,涨幅约60%。K3的API混合定价为每百万Token 2.3美元,虽显著高于国内竞品如阿里Qwen3.7 Max(1.4美元)、智谱GLM5.2(0.9美元),但在全球市场,其输出价格约为Claude Opus 4.8的60%、GPT-5.6 Sol的50%。
这种定价逻辑符合“产品实力决定价格”的商业规律。华泰证券分析指出,K3智能的提高直接带来了Token定价权的提升。然而,这种高价策略并非永久可持续,其根基在于模型能力的持续迭代。一旦行业技术趋同,缺乏迭代能力的厂商将面临溢价崩塌的风险。
C端市场则呈现出截然不同的分层逻辑。Kimi提供4档付费服务(49-699元/月),跨度极大,最高档位远超字节跳动旗下的豆包。相比之下,豆包背靠字节数亿月活用户,采用3档平缓定价,基础聊天免费,重度功能付费。Kimi之所以敢定出天价顶配,是因为其核心筹码是稀缺的长文本与复杂推理能力,面向的是专业开发者、高阶办公人群等高净值用户。这种错位竞争策略,使得Kimi能够在用户体量不占优的情况下,通过能力溢价实现高客单价转化。但这也带来了隐患:当通用模型能力不断靠拢,依靠性能获取溢价的模式能否延续,将成为所有厂商的共同命题。
生存策略启示:从“参数竞赛”到“生态护城河”
K3的崛起再次点燃了基础大模型的热度,但也暴露出行业的周期性风险。智能手机和云计算赛道的发展史表明,当技术走向成熟,主流产品的基础体验差距会迅速缩小。大模型赛道正处于从“性能竞赛”向“能力趋同”过渡的阶段,当前的领先优势可能在数月内被追赶。
头部厂商已开始构建多层竞争防线。DeepSeek选择绑定国产算力生态,通过高效算法与本土硬件协同,叠加开源生态聚拢开发者,构建技术与供应链的双重屏障。月之暗面则选择深耕长上下文、复杂推理的特色赛道,优化办公与代码场景体验,依靠B端与C端双向商业化构建稳定现金流。尽管路线不同,但目标一致:在通用模型能力趋同前,建立性能之外的护城河。
资本市场的反馈也印证了这一趋势。月之暗面估值在半年内从43亿美元跃升至315亿美元,增长超过6倍。智谱、MiniMax等也已登陆港股,市值分化日益明显。拥有稳定造血能力和完整生态壁垒的企业将收获更高估值,而单纯追逐热点、无法跑通商业化的参与者将被逐步淘汰。
对于国内超过1500家大模型厂商中的中小玩家而言,月之暗面的生存逻辑具有深刻的启示价值。盲目跟随头部比拼通用参数已无可行性,算力、人才、数据的短板无法通过短期投入弥补。未来,中小厂商需跳出通用赛道内卷,挖掘专属生态位:或扎根医疗、工业、法律等垂直领域,沉淀行业专属数据;或聚焦模型微调、推理优化等工具层业务;亦或与硬件终端深度绑定,打造嵌入式解决方案。行业成熟后,市场不需要千篇一律的竞争者,各有所长才能长久共存。找到不可替代的定位,将优势无限放大,才是大模型耐心赛中的最终赢家。