AI重构基因剪刀:超越自然进化的精准编辑新范式
突破自然进化的边界
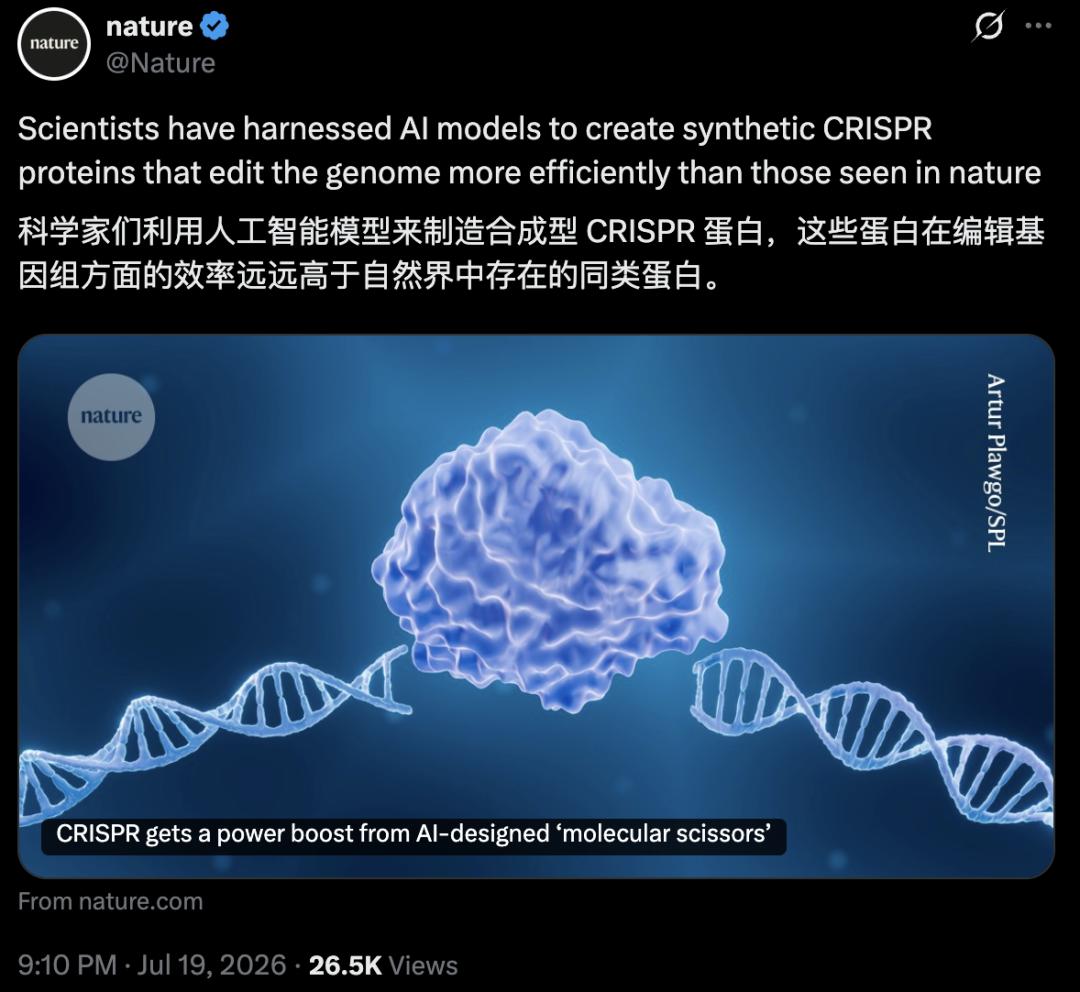
在生物学数十亿年的进化历程中,分子机器的优化往往受制于随机突变与自然选择的漫长筛选。然而,2025年7月的一系列科学发表,正在彻底改写这一规则。随着两项重磅研究成果分别在《Nature》和《Science》上发表,人工智能(AI)不再仅仅是辅助工具,而是成为了重新设计生命基础组件的核心引擎。
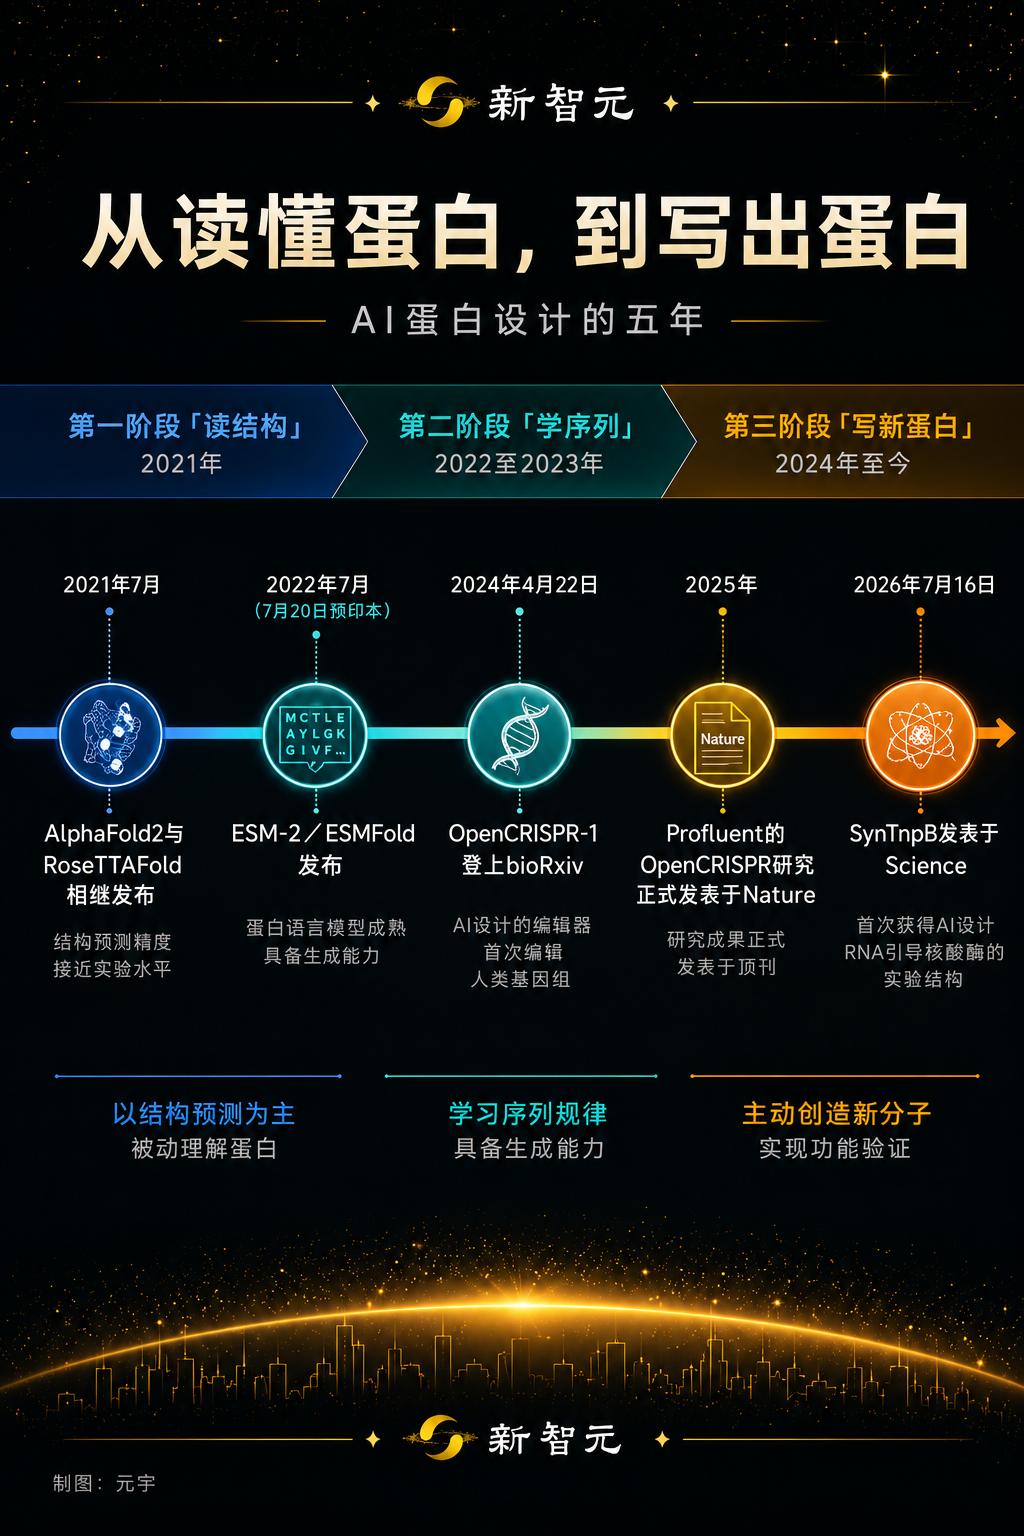
这两项研究分别由2020年诺贝尔化学奖得主Jennifer Doudna领衔的加州大学伯克利分校团队,以及生物计算公司Profluent主导。它们共同指向一个令人振奋的事实:通过算法生成的“基因剪刀”,在特异性、效率甚至多样性上,已经超越了自然进化产物。这不仅是技术的迭代,更是人类从“寻找自然工具”向“设计生命零件”跨越的标志。
从“借来的零件”到“量身定制”
CRISPR-Cas系统的发现是人类基因编辑史上的里程碑,但其底层机制源自细菌对抗病毒免疫的原始防御系统。这种“借用”的逻辑长期限制了其应用潜力。天然存在的Cas9或Cas12酶,虽然功能强大,但在尺寸大小、识别特异性、脱靶效应以及免疫原性等方面,往往并非最优解。
过去,科研人员试图通过传统的蛋白质工程手段改造这些酶,如定点突变或定向进化。然而,蛋白质序列空间极其庞大。以常见的SpCas9为例,其长度超过1000个氨基酸,理论序列空间为$20^{1000}$,这一数字远超可观测宇宙中的原子总数。在如此广袤的搜索空间中,有效的功能序列犹如沧海一粟。传统方法受限于计算能力和实验高通量,通常只能进行微小改动(1%-2%的序列变异),稍大范围的改动往往导致蛋白折叠错误而丧失功能。
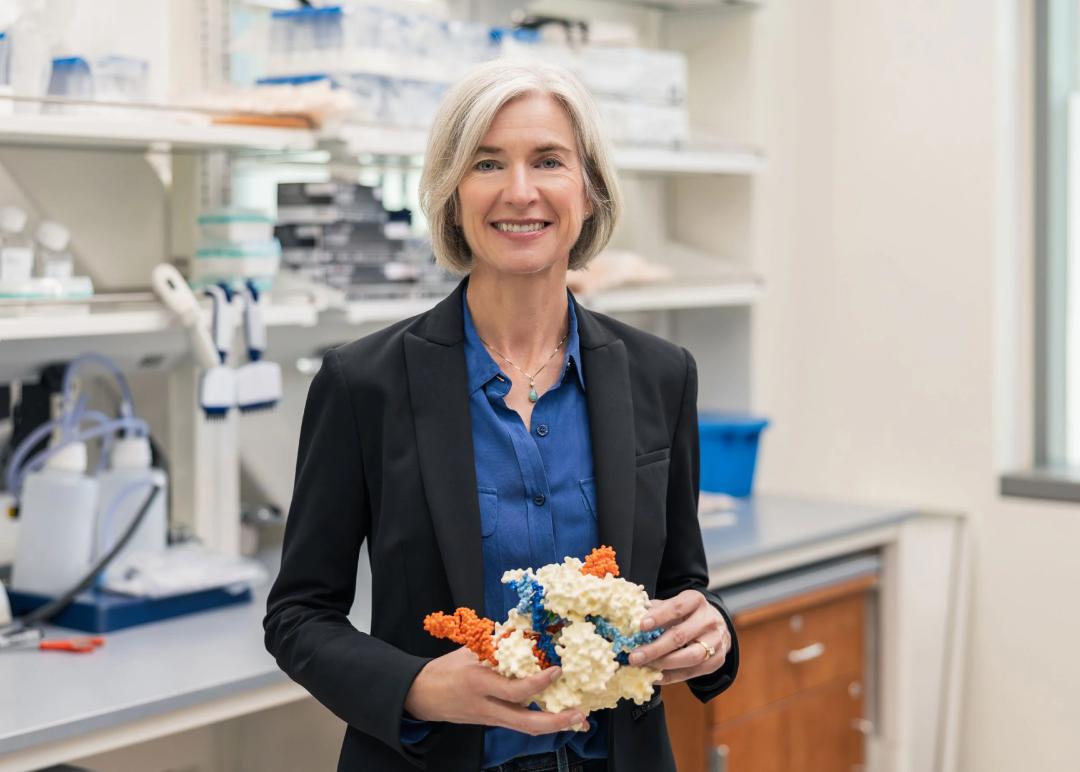
Doudna曾指出:“蛋白质是可以修改的,但一旦动手,往往它就失效了。”这一困境困扰领域十余年,直到AI模型展现了处理高维生物数据的独特优势。
Doudna团队的重构策略:结构与功能的解耦与重组
Doudna团队的研究聚焦于TnpB蛋白,这是一种微型核酸酶,被视作Cas12酶的进化祖先。团队的核心目标并非简单优化现有酶,而是探索TnpB序列的可塑性极限:在多大程度的序列变异下,蛋白仍能保持其折叠结构与催化活性?
这一过程被分解为两个关键的AI驱动步骤,体现了“结构-功能”分离设计的精妙逻辑。
首先,团队利用AlphaFold等结构预测模型,确定了目标蛋白的理想三维构象。接着,他们训练了一个生成式AI模型(ESM-IF1),反向推导能够折叠成该构象的氨基酸序列。这一步解决了“长得像”的问题,生成了数千种理论上结构稳定的新序列。
然而,结构稳定并不等同于功能存在。许多看似正确的序列可能在进化中从未被筛选过,或者存在细微的能量势阱陷阱,导致其在细胞环境中无法正常工作。因此,第二步引入了第二个AI模型,该模型基于海量的实验室实验数据(包括突变谱和功能测定结果)进行训练。它旨在捕捉蛋白内部复杂的残基相互作用网络,识别出维持活性的“关键位点”和“禁忌位点”。
通过这两个模型的协同过滤,团队筛选出了一批合成的TnpB变体。实验结果显示,这些变体在细菌、植物甚至人类细胞中均展现出编辑能力。更关键的是,其中部分变体的插入/删除效率优于天然版本,且序列差异高达30%。这一突破意味着,AI能够在保持功能的前提下,大幅重塑蛋白质序列,打破了“大幅修改即失效”的传统认知。
Profluent的路径:在序列空间中开辟新大陆
与Doudna团队修改现有酶不同,Profluent公司采取了更激进的策略:直接生成自然界中根本不存在的Cas9变体。
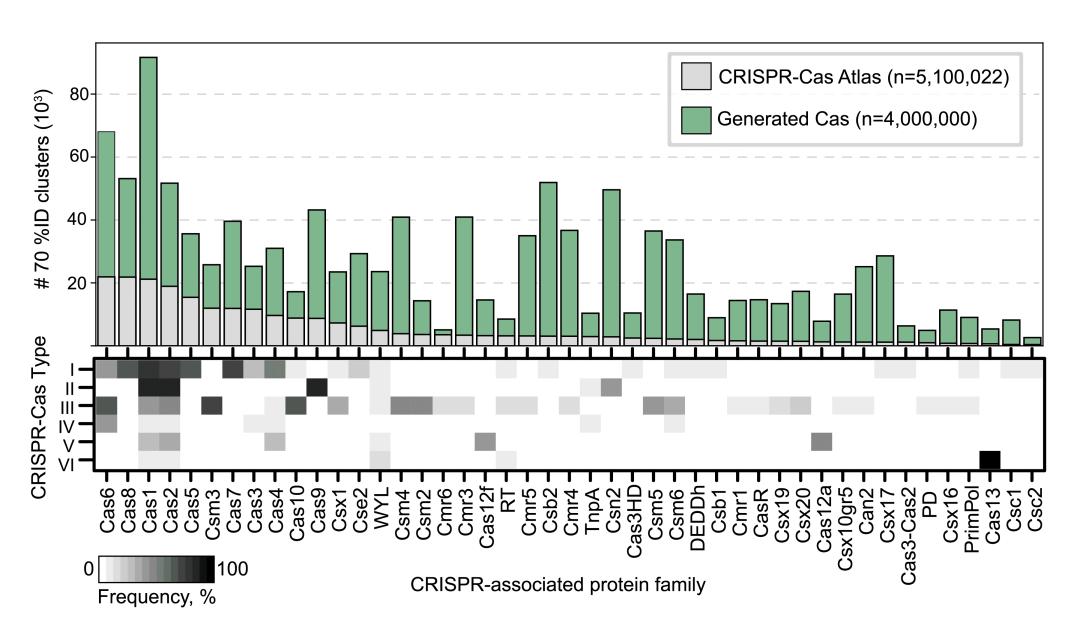
他们构建了一个包含510万个CRISPR-Cas蛋白的庞大数据库,数据源于对26TB基因组和宏基因组数据的系统挖掘。随后,利用蛋白语言模型(Protein Language Model, PLM),他们在高维序列空间中进行采样和生成。这种方法类似于大型语言模型在文本空间中的生成,但应用于生物分子的线性序列。
生成的序列多样性达到了自然界已知水平的4.8倍。从中筛选出的最优变体被命名为OpenCRISPR-1,并已开源。
数据揭示了其卓越性能:
- 靶向效率:OpenCRISPR-1的编辑效率为55.7%,显著高于主流的SpCas9(48.3%)。
- 特异性:其脱靶编辑率仅为0.32%,而SpCas9为6.1%。这意味着脱靶率降低了约95%。
- 新颖性:该序列与SpCas9存在403个突变位点,与数据库中任何天然蛋白也至少有182个突变。
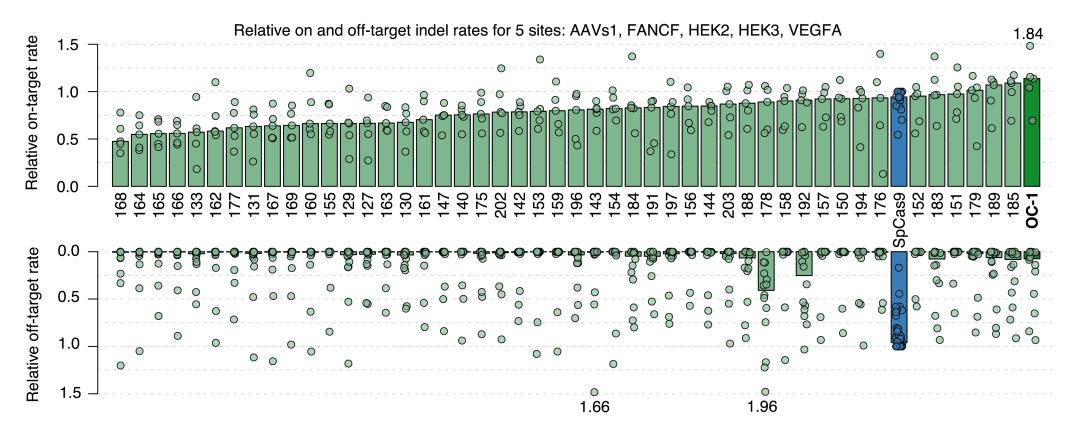
OpenCRISPR-1并非天然存在的亲属,而是AI在概念层面重新设计出的“全新剪刀”。尽管独立复现仍需时间验证,但其初步数据展示了AI在挖掘远距离同源序列和优化非天然序列方面的巨大潜力。
技术范式转移:从随机探索到逆向工程
这两项研究共同揭示了一个深刻的范式转移。过去,生物技术的进步很大程度上依赖于“运气”和“发现”。胰岛素源于狗的胰腺,CRISPR源于酸奶厂的细菌,肉毒毒素源于食物中毒事件。这些重大工具的出现,是人类在自然演化结果的偶然碎片中进行的拾荒式筛选。
现在,路径反转了。我们不再是从自然中寻找工具,而是从所需的功能出发,逆向推导分子结构,再通过AI生成实现它。
这一过程与文本大模型的学习机制惊人相似:
- 编码知识:蛋白语言模型学习了氨基酸序列中的“语法”和“语义”,即哪些残基组合是稳定的,哪些相互作用是功能必需的。
- 生成创新:模型可以在训练数据分布之外生成新的序列,只要这些序列符合学习到的约束条件。
进化用了数十亿年在巨大的序列空间中摸索,而AI模型在几小时内即可完成类似的搜索与优化。这种效率的跃升,使得定制化、高特异性、低毒性的基因编辑工具的大规模开发成为可能。
临床转化的现实考量与挑战
尽管实验室数据令人振奋,但将AI生成的基因剪刀推向临床应用,仍需跨越漫长的转化医学阶梯。
首先,目前的验证主要局限于细胞模型和体外系统。在复杂的动物模型中,AI生成的蛋白是否会引发预期的免疫反应?其在体内的药代动力学行为如何?这些问题尚待回答。特别是对于人类细胞,AI生成的序列可能包含隐藏的抗原表位,引发未知的免疫排斥。
其次,数据的依赖性。AI模型的性能高度依赖训练数据的质量与数量。Doudna团队强调,AI模型的快速迭代得益于过去几十年积累的庞大实验数据。如果缺乏高质量的基准测试数据,模型的泛化能力将受限。这意味着,基础生物学研究不能停,反而需要更加精细的高通量实验数据来反哺AI模型,形成“实验-计算-实验”的闭环。
此外,伦理与安全监管也需要同步更新。当我们可以“设计”出比自然更完美的基因剪刀时,如何确保其安全性?如何防止滥用?OpenCRISPR-1的开源策略值得肯定,但随之而来的生物安全风险管控也需要全球协作。
未来的生物设计时代
Jennifer Doudna指出,这项工作的意义在于展示了AI与生物学的融合形态:AI加速探索,人类提供机制理解。AI不是要取代生物学家,而是要赋予他们更强的能力。
随着AlphaFold、RoseTTAFold以及更先进的生成式模型的发展,我们正进入一个“生物设计时代”。在这个时代,蛋白不再是进化的被动产物,而是可以被编程、优化和创造的功能模块。
从基因编辑到酶催化,从疫苗开发到代谢工程,AI辅助的蛋白质设计正在重塑生物技术的边界。虽然短期内还不能宣称AI能直接攻克癌症或逆转衰老,但它正在为这些终极目标提供最精准的“手术刀”。
这场由AI驱动的分子革命,才刚刚拉开序幕。自然界几十亿年的积累固然珍贵,但人类运用智慧重新设计生命语言的能力,正在开启新的篇章。未来,我们或许不再需要等待进化的馈赠,而是可以直接为人类健康定制所需的分子工具。