CUDA护城河崩塌?Claude周末调通AMD GPU揭示AI原生开发新范式
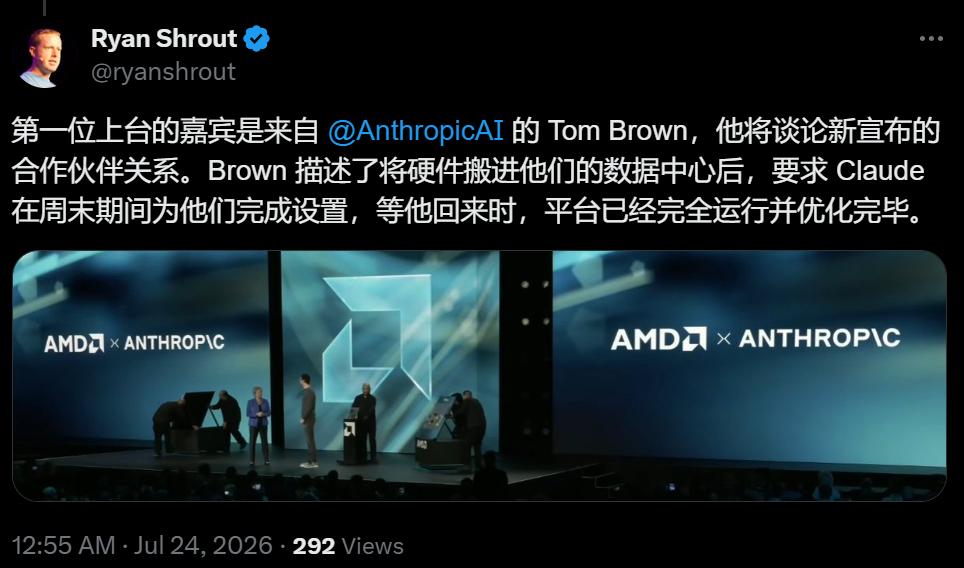
在高性能计算领域,英伟达的CUDA平台曾被视为不可逾越的技术高山。这不仅仅是一套软件库或编译器,而是经过二十年沉淀、由数百万行代码和无数工程师隐性知识共同构筑的复杂生态系统。然而,近期发生的一项实验正在动摇这一根基:Anthropic团队利用其前沿大模型Claude,在完全无人工代码修改介入的情况下,仅用一个周末的时间,便成功将模型部署并运行在AMD最新的MI355X GPU集群上。这一事件并非简单的硬件兼容新闻,它标志着计算产业底层逻辑的根本性转变——从“人适应机器”转向“机器适应机器”,即AI代理(Agent)正在成为连接硬件与算法的新桥梁。
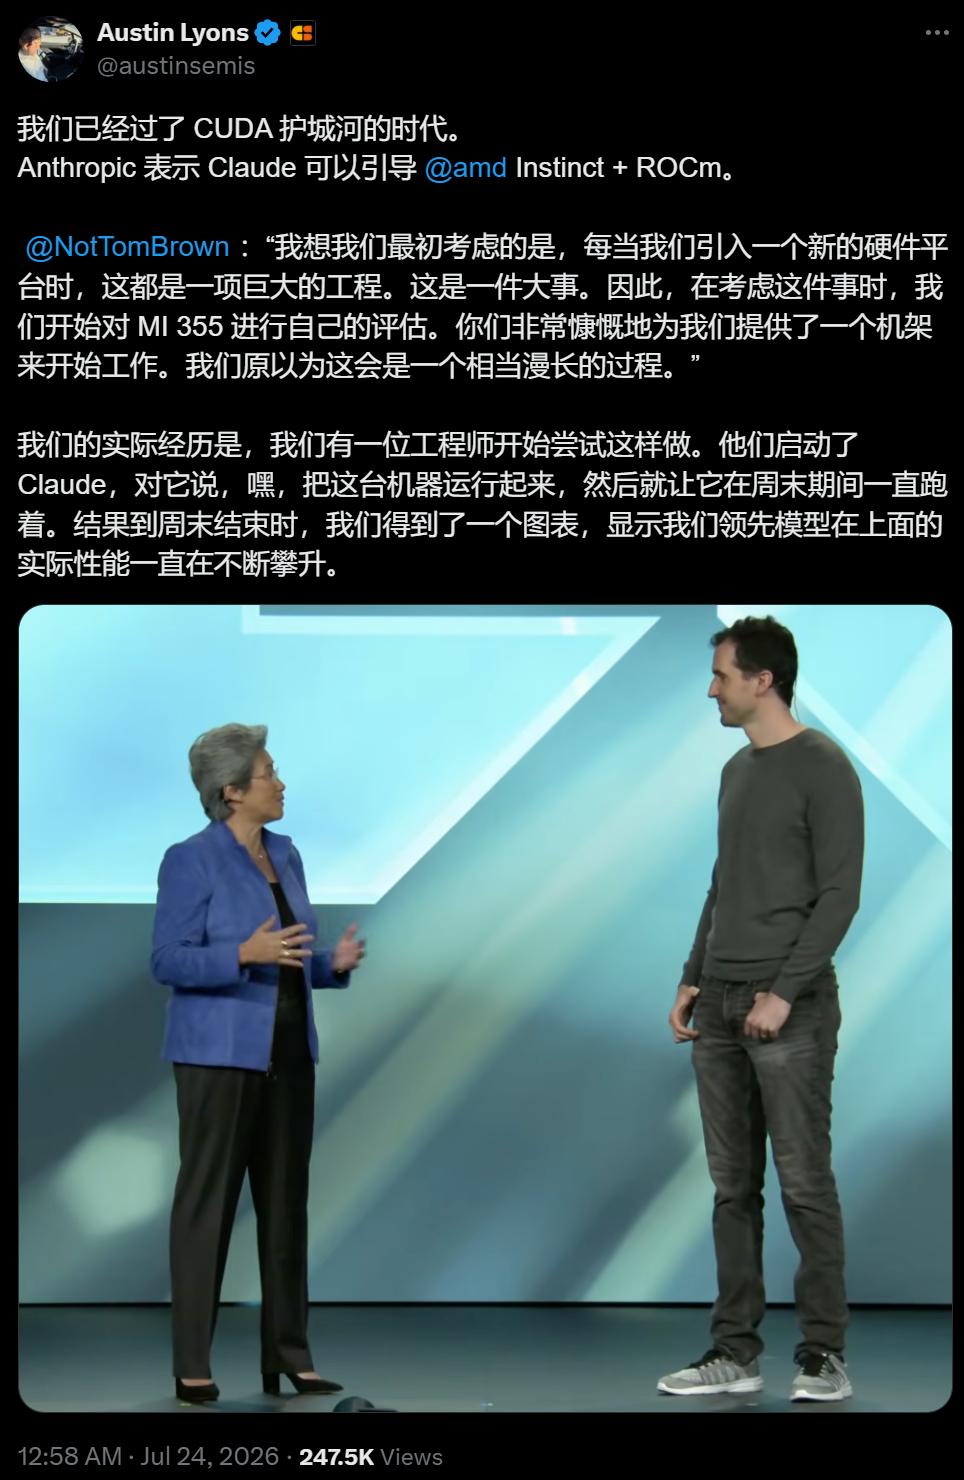
传统意义上,GPU软件的适配是一项极其繁琐且高门槛的工作。工程师需要深入理解硬件架构,处理复杂的依赖关系,调整内存分配策略,并针对特定算子进行手工优化。对于后来者如AMD而言,尽管其Instinct系列芯片在峰值算力和显存带宽上已具备与英伟达抗衡的实力,但ROCm软件栈的成熟度一直是制约其大规模商用的短板。开发者往往因为环境配置困难、文档缺失或社区支持不足而望而却步。然而,Claude的成功介入表明,当具备强大代码理解和执行能力的AI代理接入开发流程时,传统的“生态壁垒”可能被瞬间穿透。AI不再仅仅是被部署的对象,它变成了部署过程的执行者。
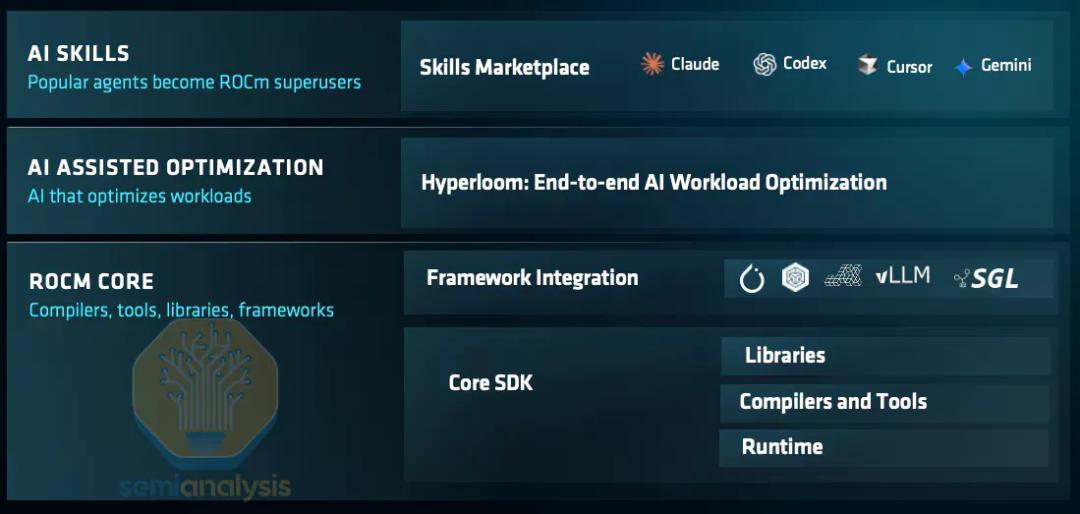
这一突破的核心在于AMD近年来在软件基础设施上的战略调整,特别是ROCm.AI工具的推出。AMD不再仅仅面向人类开发者提供文档,而是开始构建面向AI代理的知识体系。通过AMD Skills模块,ROCm将经过验证的知识库、命令行接口(CLI)操作指南以及故障排查逻辑结构化地呈现给AI模型。这意味着,当Claude接收到“让这台机器跑起来”的指令时,它并非盲目尝试,而是基于结构化的知识库进行推理、规划并执行。它能够自主安装环境、读取系统日志、识别错误代码,并调用相应的修复脚本。这种能力将原本需要数周甚至数月的调试周期压缩到了小时级别。
更为深远的影响体现在芯片指令集架构(ISA)的设计哲学变化上。AMD AI软件与解决方案副总裁Anush Elangovan透露,新一代AMD GPU不仅公开指令集,还提供了专门针对AI可读性优化的ISA描述。这一举措旨在让AI代理能够直接“阅读”芯片手册,理解底层硬件的行为模式,从而生成更高效的内核代码。在过去,芯片说明书是写给人类工程师看的,充满了自然语言的歧义和隐含假设;而现在,说明书正在变成机器可解析的数据结构。这种转变使得AI能够绕过人类认知的局限,直接探索硬件性能的极限。例如,在现场演示中,名为Hyperloom的自动化工具通过分析MiniMax M3模型的运行瓶颈,自动生成定制内核,将输出速度提升了38%。这种优化并非基于预设规则,而是基于大量实验数据的反馈循环。
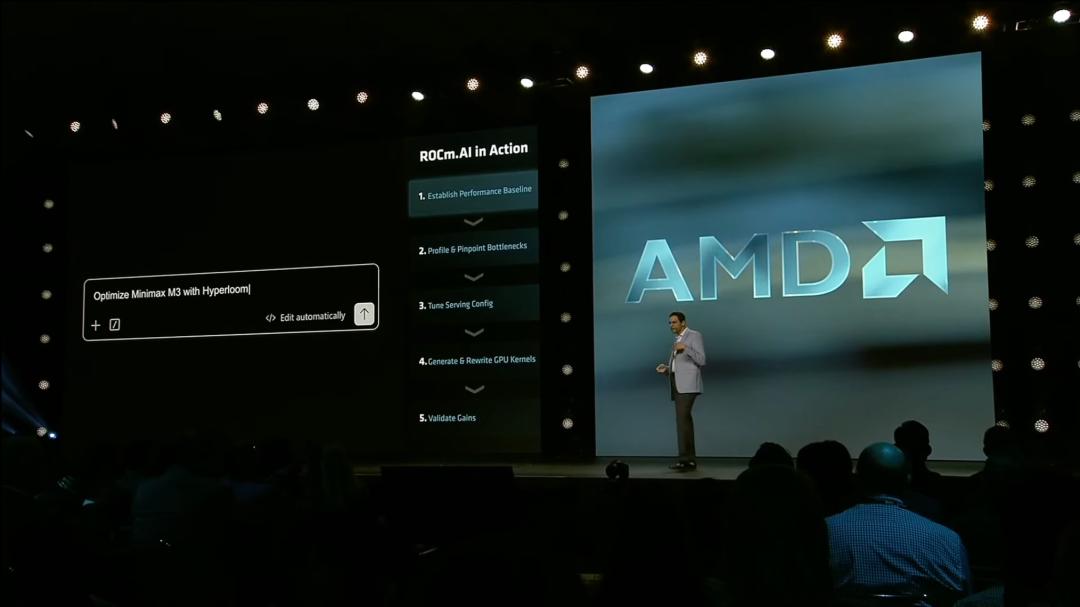
Hyperloom的工作机制代表了未来GPU软件优化的标准范式。它首先拉起推理服务建立基线性能,然后利用强化学习或贝叶斯优化算法,在CPU与GPU之间寻找资源分配的平衡点。它会测试不同的配置组合,生成候选内核,并在真实硬件上进行验证。如果性能提升,则保留该方案并作为后续优化的起点;如果失败,则记录错误信息以修正搜索策略。在这个过程中,AI代理不仅是在执行任务,更是在积累“经验”。一次跑通的配置、一个高效的算子实现,都会沉淀为知识库的一部分,供后续的Agent复用。这种知识的累积速度远超人类团队,因为AI可以并行启动成千上万个实验任务,昼夜不停地探索参数空间。
从产业竞争的角度来看,这是一种典型的“降维打击”。英伟达的护城河建立在庞大的人类工程师群体之上,这些工程师积累了大量的隐性知识,如“某个版本的驱动在特定网络拓扑下会出现延迟抖动”或“某种算子在混合精度训练时需要特殊的内存对齐”。这些知识难以文档化,也难以快速复制。然而,AI代理的出现改变了这一局面。只要硬件接口足够规范、文档足够结构化,AI就可以通过大规模的试错和学习,迅速掌握这些隐性知识。更重要的是,AI的学习成果可以瞬间复制到全球各地的数据中心,而人类经验的传递则需要漫长的师徒制或培训过程。因此,未来的硬件竞争将不再仅仅取决于晶体管的密度或时钟频率,更取决于硬件对AI代理的“友好程度”。
这一趋势对中国半导体产业具有重要的启示意义。长期以来,中国芯片厂商在追赶国际先进水平时,最大的障碍往往不是硬件设计本身,而是软件生态的匮乏。构建一个类似CUDA的完整生态需要数十年时间和巨额投入,这在快节奏的技术迭代中显得尤为艰难。然而,AI原生开发范式的出现提供了一条捷径。如果芯片厂商能够从设计之初就考虑到AI代理的需求,提供标准化的、机器可读的接口和文档,那么就可以借助全球领先的大模型能力来加速软件栈的成熟。中国拥有庞大的应用场景和丰富的工程数据,若能将这些底层经验转化为Agent可调用的能力,有望在新一轮算力竞争中实现弯道超车。
此外,这也重新定义了“开发者”的概念。未来的GPU开发者可能不再是坐在屏幕前敲击代码的人类程序员,而是由人类设定目标、由AI代理执行具体任务的混合团队。人类工程师的角色将从具体的代码实现转向架构设计、目标定义和质量把控。他们需要思考的是如何让AI更好地理解硬件意图,如何设计更鲁棒的测试框架,以及如何确保AI生成的代码在安全性和稳定性上符合生产环境的要求。这种角色的转变要求工程师具备更强的系统思维和AI协作能力,而非单纯的编码技巧。
当然,这一变革也伴随着挑战。首先,AI代理的决策过程往往是黑盒的,如何确保其生成的优化方案在所有边缘情况下都是正确且安全的,仍是一个亟待解决的问题。其次,过度依赖AI可能导致人类工程师对底层原理的理解退化,一旦AI系统出现故障,可能缺乏足够的人力进行紧急修复。最后,不同厂商的硬件接口标准化程度不一,如何实现跨平台的AI代理通用性,也是行业需要共同面对的课题。尽管如此,趋势已经不可逆转。随着大模型能力的不断提升和硬件接口的日益规范化,AI代理在软件开发中的地位将越来越重要。
Anthropic与AMD的合作只是一个开始。未来,我们可能会看到更多类似的案例:AI代理自动迁移遗留代码到新架构,自动发现并修复安全漏洞,甚至自动设计新的硬件加速器。在这个过程中,软件与硬件的界限将进一步模糊,形成一种紧密耦合的“硅基智能”形态。对于整个科技行业而言,这不仅是一次技术升级,更是一场认知革命。它提醒我们,在人工智能时代,最宝贵的资源不再是代码行数,而是能够将意图转化为行动的智能代理能力。那些能够率先拥抱这一变化、构建AI友好型基础设施的企业,将在未来的算力战争中占据主导地位。而曾经坚不可摧的CUDA护城河,或许终将被这股由硅基智能汇聚而成的洪流所淹没,取而代之的是一个更加开放、动态且由AI驱动的全新计算生态。