告别无效监控:AI驱动前端性能从RUM指标到自动优化闭环
在前端工程化的深水区,性能监控早已不再是简单的“接入SDK”和“查看报表”。许多团队面临着一种典型的困境:监控大盘上红灯闪烁,LCP(最大内容绘制)或 INP(交互到下一次绘制)严重超标,但开发人员面对这些抽象的数字却无从下手。知道“慢”并不等于知道“为什么慢”,更不等于知道“怎么改”。如果性能诊断系统只能提供昂贵的仪表盘而无法给出可执行的工程建议,那么它本质上只是一种成本负担,而非生产力工具。
真正的性能治理,必须完成从“指标感知”到“行动指引”的跨越。这意味着我们需要将孤立的 RUM(Real User Monitoring,真实用户监控)指标,与资源加载详情、主线程执行状态、路由上下文以及应用版本进行深度关联。只有当系统能够明确指出“某路由在低端安卓设备上 LCP 耗时 4.2 秒,原因是首屏 Banner 图片未压缩且优先级低”时,性能优化才具备了进入迭代 backlog 的价值。
构建多维度的性能诊断视图
传统的前端监控往往存在数据孤岛问题。Web Vitals 告诉我们要关注核心体验指标,Resource Timing 记录了每个资源的加载耗时,而 Long Task API 则揭示了主线程的阻塞情况。然而,单独看任何一类数据都是片面的。资源加载快但主线程被繁重的 JavaScript 计算阻塞,页面依然无法响应用户操作;接口响应迅速但关键图片体积巨大,LCP 依然会居高不下。
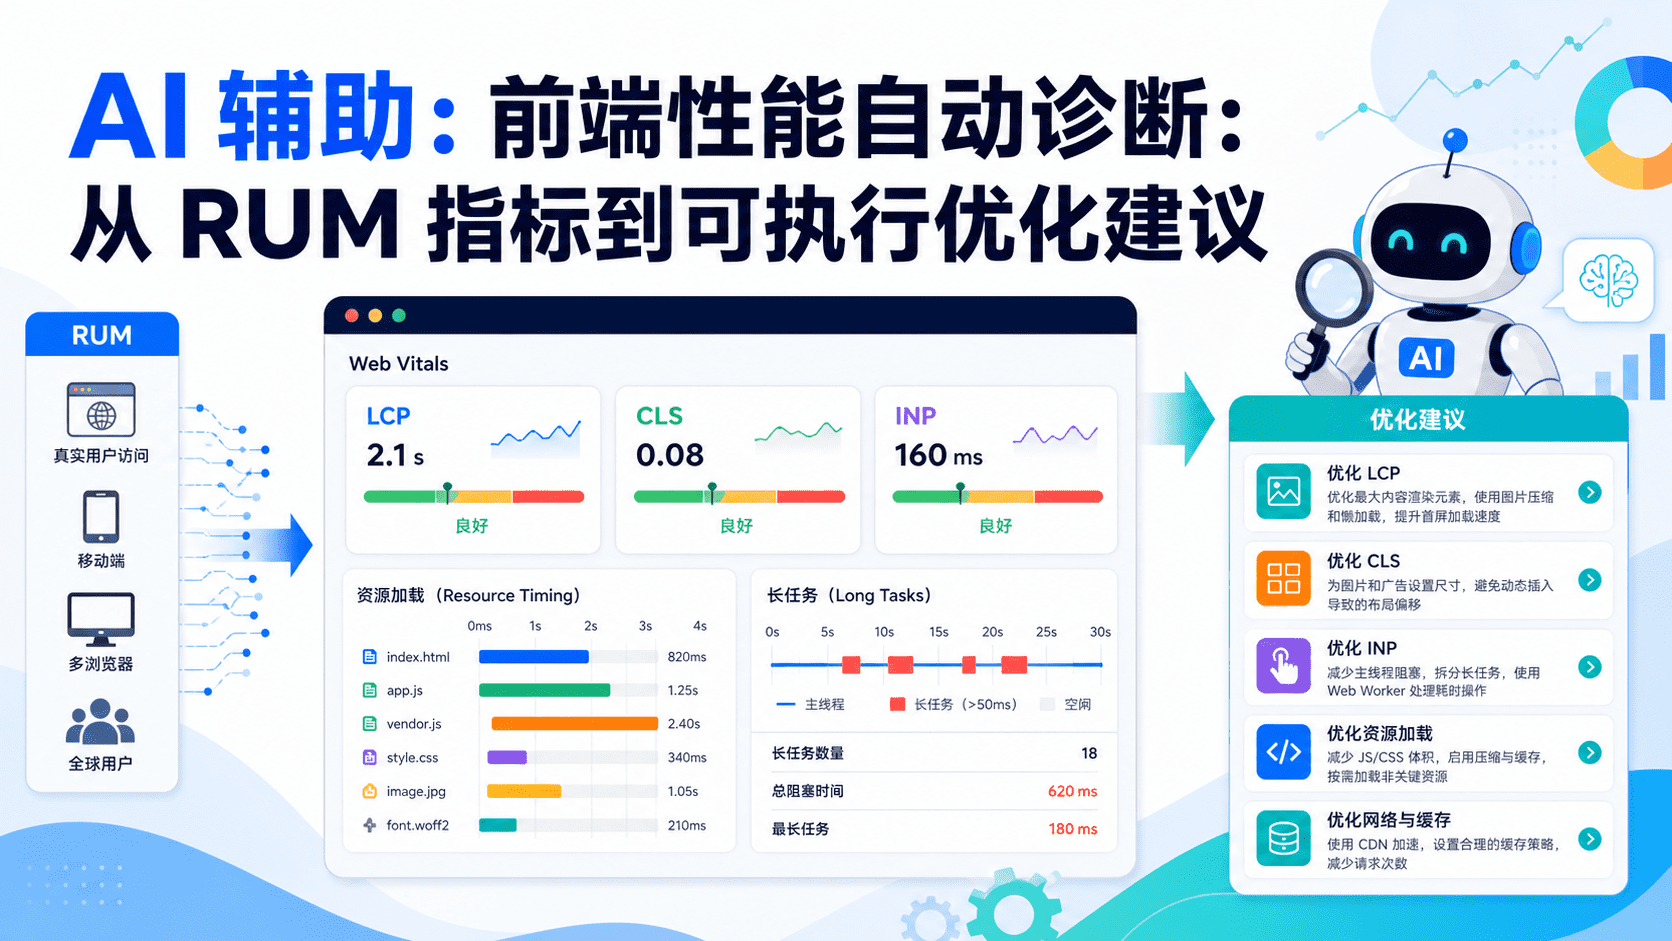
因此,高效的诊断链路必须实现这三类数据的合流。我们需要建立一个规则引擎,以路由为维度,结合设备类型、网络状况和应用版本对数据进行切片分析。全站平均值往往具有极大的欺骗性,它可能掩盖了移动端 4G 网络下的极端慢体验,或者某个特定版本引入的资源体积突增问题。只有通过细粒度的维度下钻,才能发现那些隐藏在平均数背后的性能黑洞。
例如,当检测到 LCP 指标异常时,诊断引擎应首先识别 LCP 元素的类型。如果是图片元素,系统需进一步检查其体积、格式、缓存命中率以及加载优先级;如果是文本元素,则需排查字体文件的加载策略及服务端渲染(SSR)的响应时间。对于 INP 指标较差的情况,重点应转向长任务分析,定位具体的事件处理函数或同步计算逻辑,判断是否由第三方库或复杂的业务逻辑导致了主线程卡顿。
精细化采集:上下文决定诊断价值
要实现上述的智能诊断,数据采集策略必须从“只报数值”升级为“上报上下文”。仅仅记录 LCP 的毫秒数是远远不够的,我们必须知道这个 LCP 是由哪个 DOM 元素触发的,该元素对应的资源 URL 是什么,以及当时的运行环境如何。
在实际工程中,我们可以利用 PerformanceObserver API 捕获 LargestContentfulPaint 条目,并提取关键上下文信息。这包括元素的 CSS 选择器(用于定位代码位置)、资源 URL(用于分析资源属性)、当前路由路径、应用版本号以及网络连接类型。通过将这些信息与性能指标一同上报,后端或分析系统才能建立起指标与代码之间的映射关系。
值得注意的是,元素选择器的生成需要兼顾唯一性与简洁性。过于复杂的选择器可能包含动态生成的类名或敏感信息,而过于简单的选择器又可能无法精确定位。通常,结合 ID、标签名和前两个类名即可满足大多数场景的定位需求。此外,长任务的采集同样重要。超过 50 毫秒的任务会被浏览器标记为长任务,直接影响交互响应。结合 Source Map 和调用栈采样,我们可以将模糊的“主线程阻塞”转化为具体的“某业务组件的 useEffect 钩子中进行了大量同步计算”,从而为开发者提供明确的优化方向。
权衡艺术:隐私、成本与数据价值的平衡
随着采集维度的增加,数据量和存储成本必然上升,同时隐私合规风险也随之而来。全量上报所有的 PerformanceEntry 不仅不经济,而且在法律层面可能存在风险。因此,智能的采样策略至关重要。
建议采用动态采样机制:对于正常范围的页面,保持较低的采样率以控制成本;而对于慢页面、错误页面或来自低端设备的样本,则提高采样率甚至全量采集。这些异常样本往往蕴含着最高的优化价值。在隐私保护方面,必须严格过滤敏感信息。URL 中的查询参数、用户输入框的内容、DOM 中的个人身份信息都应被剔除或脱敏。元素选择器也应进行裁剪,避免泄露内部结构细节。性能诊断需要的是技术上下文,而非用户隐私。
此外,自动生成的优化建议不能完全替代人工判断。规则引擎擅长发现常见问题,如图片未压缩、缓存头缺失、长任务过多等。但对于更复杂的架构性问题,如服务端渲染的水合(Hydration)阻塞、微前端架构下的资源竞争、或低端机上的内存泄漏,仍需结合静态代码分析和专家经验进行综合研判。AI 的作用在于缩小排查范围,提供高置信度的假设,而非直接替换工程师的决策。
从能跑到可维护:生产落地的关键约束
任何技术方案在生产环境的落地,都不能仅停留在主流程的通顺上。真正考验系统健壮性的,是异常输入的处理、依赖服务的抖动、并发压力的放大以及权限边界的控制。一个完善的性能诊断系统,必须具备清晰的失败分支和资源上限保护。
在评估此类系统时,建议定义三类核心指标:正确性、稳定性和成本。正确性指标关注诊断结果是否可信,是否存在误报或漏报;稳定性指标关注系统在部分组件失效时是否可控,是否会影响主业务的正常运行;成本指标则关注数据存储、计算和处理的经济性。这三类指标应同时纳入验收清单,不能仅凭平均耗时或单次成功率来证明方案的有效性。
在实现层面,可观测性本身也需要被观测。日志系统应记录请求标识、关键参数摘要、处理耗时、状态码及错误类型;指标系统应覆盖成功率、超时率、重试次数和队列长度;必要时还需引入分布式追踪(Trace),以关联上下游调用。这样,当诊断系统自身出现问题时,团队能够快速区分是代码逻辑错误、外部依赖故障还是容量配置不足,从而避免陷入“为了监控监控而监控”的死循环。
结语:让数据驱动真正的工程改进
前端性能自动诊断的终极目标,是将冰冷的指标转化为热的工程行动。LCP、CLS、INP 只是入口,真正的价值在于建立指标与资源、主线程、路由、版本之间的深层关联,并生成指向明确的可执行建议。
落地这一体系,建议从基础数据的全面采集入手,逐步建立基于规则的诊断引擎,并最终引入 AI 模型进行复杂模式的识别与预测。每一条建议都应当能够直接指向具体的路由、DOM 元素、资源文件或代码行。性能报表不应是终点,而是起点。只有当监控系统能够推动代码的修改、架构的优化和用户体验的提升时,它才真正完成了从“成本中心”到“价值中心”的转变。在这个过程中,技术团队的关注点将从“发生了什么”转移到“如何变得更好”,从而在激烈的市场竞争中,通过极致的用户体验赢得用户的青睐。