AI健康助手落地指南:从数据标准化到安全边界的工程实践
从数据孤岛到智能决策:健康助手的技术重构
当前健康管理领域存在一个显著的痛点:数据丰富但洞察匮乏。用户手中的智能手表、手环以及各类体检报告,积累了海量的生理指标,如心率、睡眠时长、血压数值等。然而,大多数现有应用仅停留在“记录”层面,类似于电子账本,缺乏对数据背后健康意义的深度解读。用户面对密密麻麻的体检指标往往感到焦虑,却不知如何调整生活方式。
AI健康助手的出现,旨在解决这一断层。其核心目标不仅是展示数据,更是结合用户的生活习惯、环境因素(如天气),提供具体、可执行的健康建议。从工程实现的角度来看,构建这样一个系统需要攻克三大技术难关:异构数据的统一标准化、大模型输出的专业性与安全性平衡,以及交互体验的自然化。
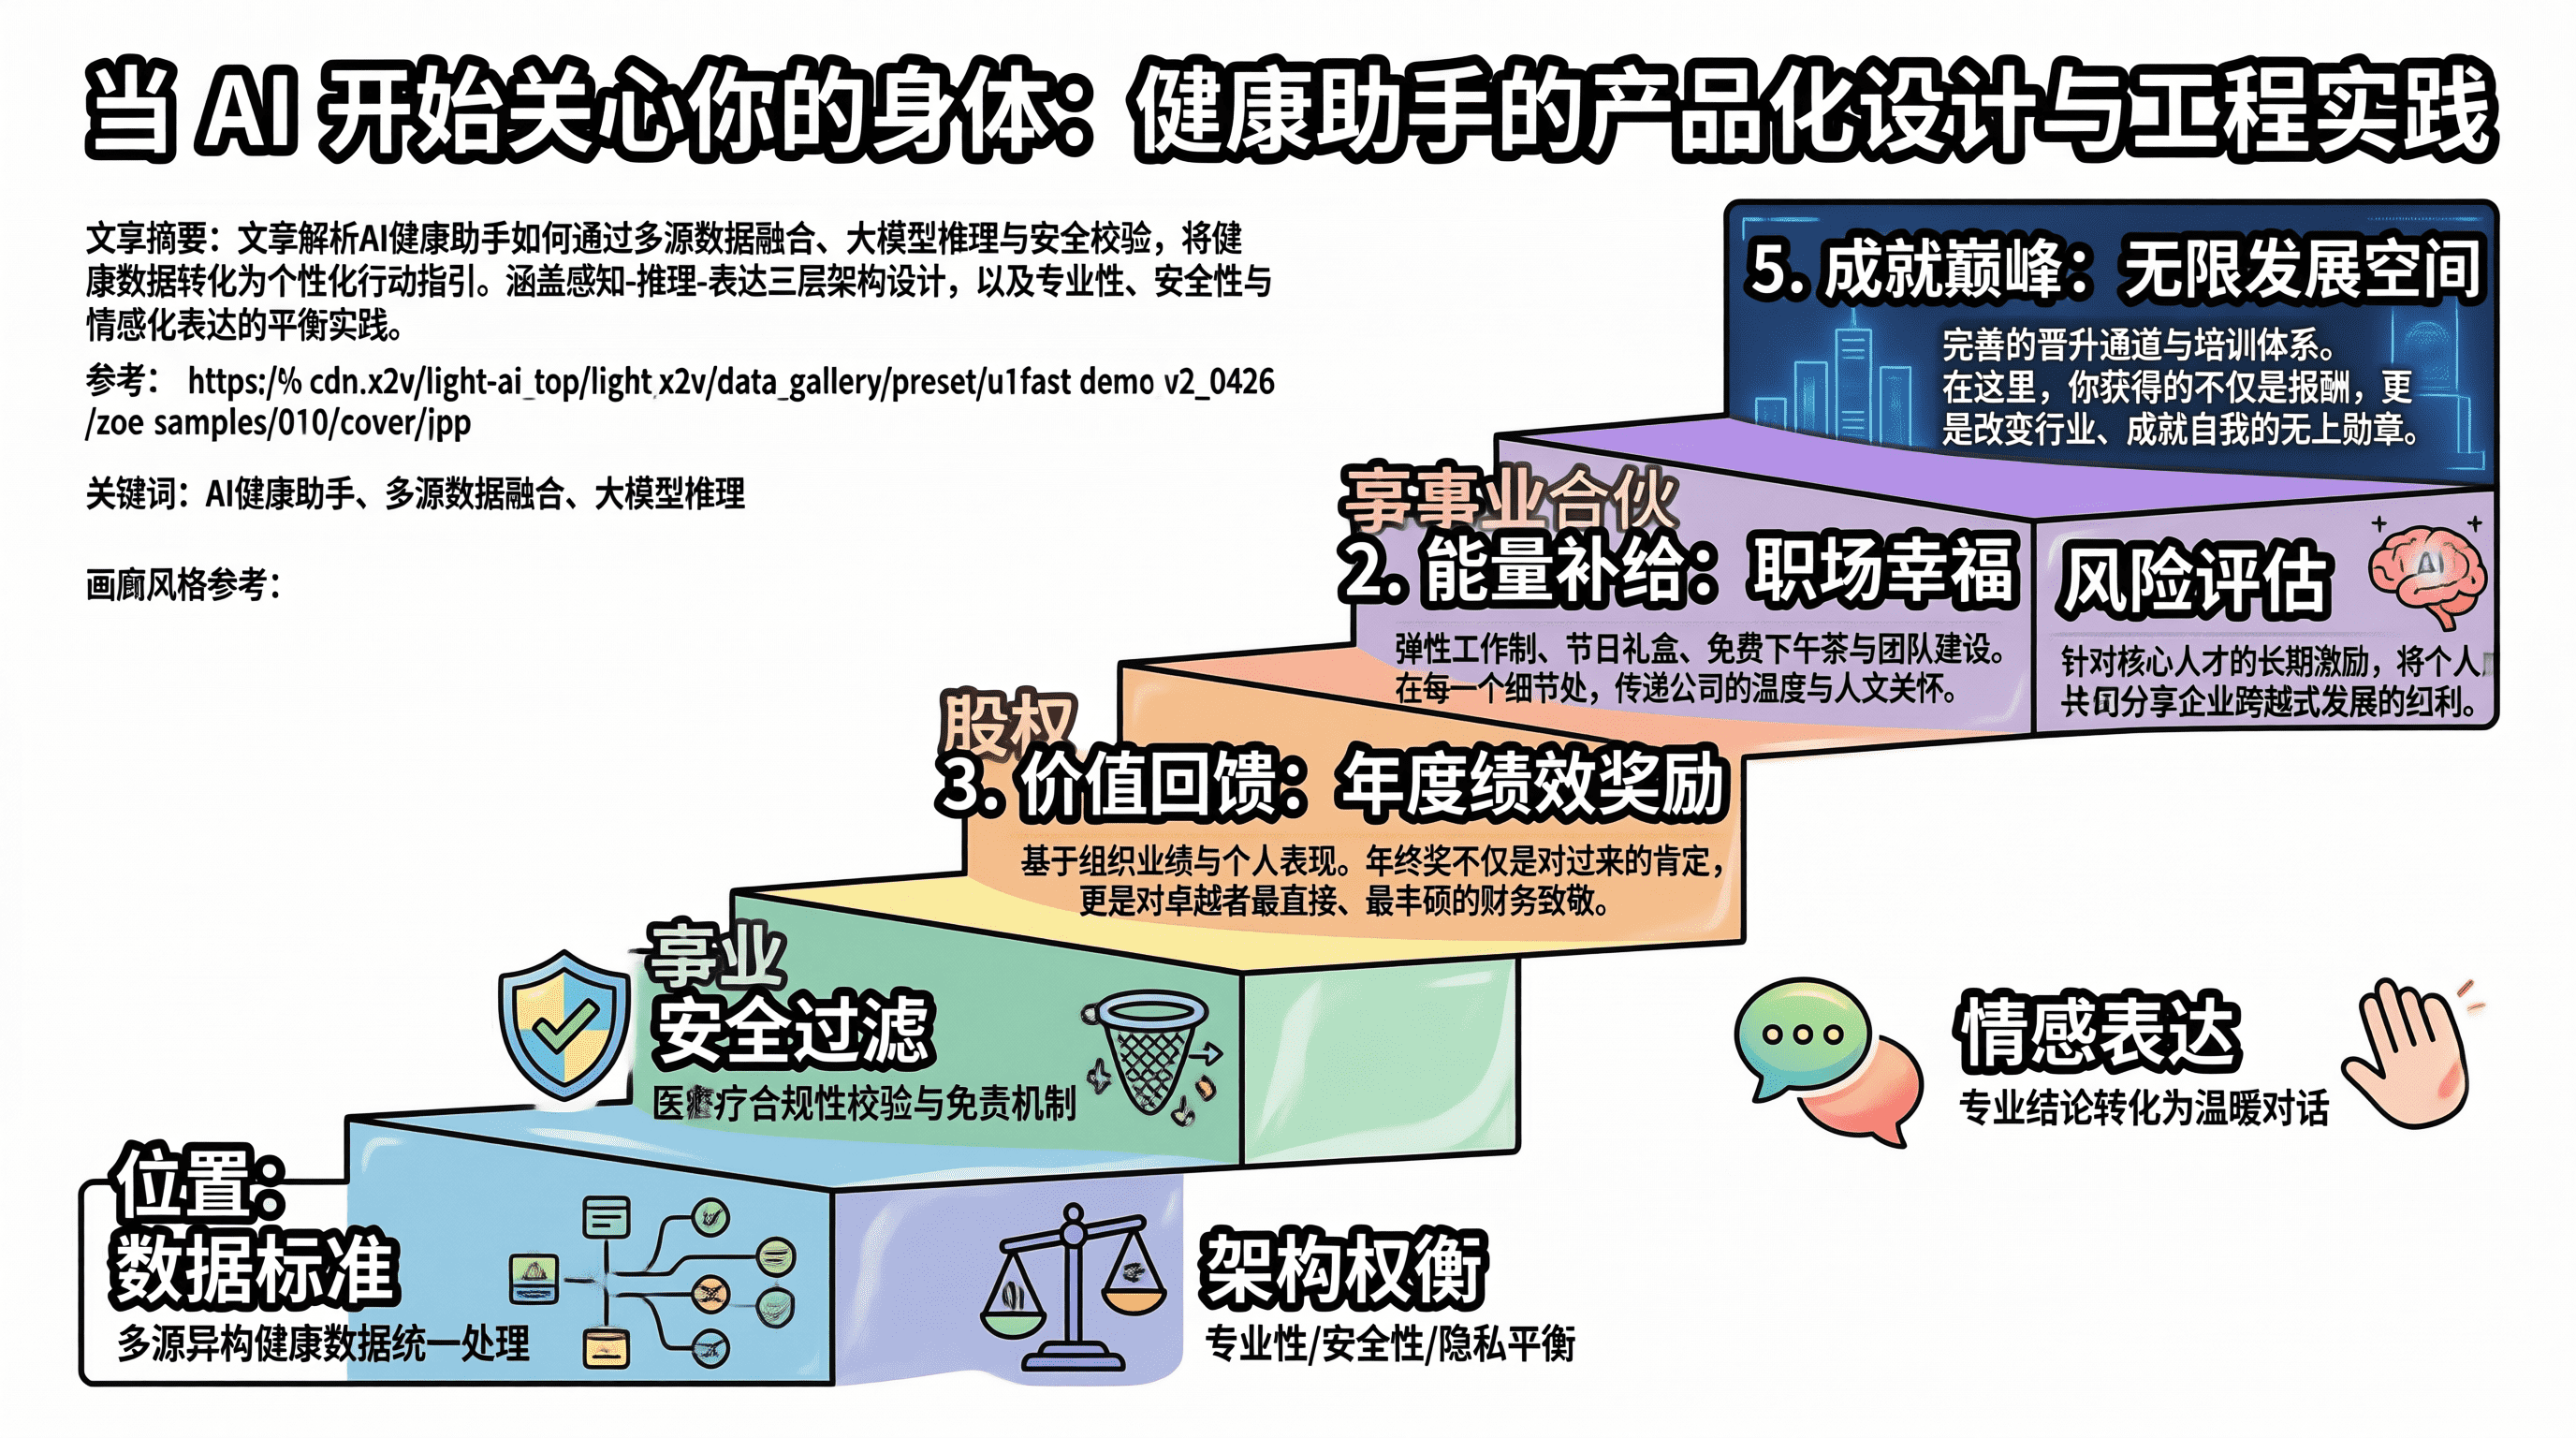
系统架构设计:分层处理与风险隔离
一个稳健的AI健康助手系统,其核心逻辑遵循“采集-分析-建议”的闭环。为了降低大语言模型(LLM)的幻觉风险并提高响应效率,系统架构通常采用分层设计,将确定性规则与概率性推理分离。
数据接入与标准化层
数据标准化是系统的基础。不同来源的数据格式差异巨大:Apple HealthKit通常使用JSON格式,华为穿戴设备可能采用Protobuf协议,而用户手动输入或OCR识别的体检报告则是非结构化文本。系统需要建立一个统一的数据映射引擎,将这些异构数据转换为标准模型,如HL7 FHIR(Fast Healthcare Interoperability Resources)标准。
在这一层,系统还需处理单位换算、时区对齐以及异常值过滤。例如,将不同设备的步数计数逻辑统一,或剔除因传感器故障产生的极端心率值。只有经过清洗和标准化的数据,才能进入下一阶段的分析。
分析处理层:规则引擎与大模型的协同
分析层是系统的“大脑”。直接将原始数据扔给大模型进行推理,不仅成本高,且容易因模型“猜测”规律而产生幻觉。因此,更优的策略是先通过规则引擎进行初步的风险评估。
规则引擎负责提取关键指标和趋势,判断是否存在异常。例如,当检测到收缩压超过180mmHg时,规则引擎会立即标记为“紧急偏高”。随后,这些结构化的风险摘要被传递给LLM。LLM基于这些经过验证的特征进行推理,生成个性化的建议。这种“规则保底+LLM增强”的模式,既保证了关键医疗指标的确定性,又利用了大模型的语义理解能力。
安全过滤层:合规红线
所有涉及疾病诊断、用药建议的输出,必须经过严格的安全过滤。这是医疗AI的合规底线。系统需内置敏感词库和正则表达式,拦截任何试图替代医生诊断或开具处方的表述。例如,将“你可能患有甲亢”修正为“甲状腺指标存在异常波动,建议就医确认”,并强制附加免责声明。
核心代码实现:工程细节与最佳实践
在具体的代码实现中,数据结构的定义、规则评估的逻辑以及安全过滤的机制是三个关键环节。以下通过Python代码示例,展示如何构建这一链路。
数据模型定义
首先,定义健康数据的标准模型。使用Pydantic进行数据验证,确保输入数据的类型、单位和时间戳符合规范。
from pydantic import BaseModel, Field, validator
from datetime import datetime
from typing import List, Dict
class HealthMetric(BaseModel):
metric_type: str = Field(..., description="指标类型:heart_rate/sleep/blood_pressure/steps")
value: float = Field(..., description="指标值")
unit: str = Field(..., description="单位")
timestamp: datetime = Field(..., description="采集时间,统一为 UTC")
source: str = Field(..., description="数据来源")
confidence: float = Field(default=1.0, ge=0.0, le=1.0, description="数据置信度")
@validator("metric_type")
def validate_metric_type(cls, v):
allowed = {"heart_rate", "sleep", "blood_pressure", "steps", "calories"}
if v not in allowed:
raise ValueError(f"不支持的指标类型: {v}")
return v规则引擎:确定性判断
规则引擎负责基于预设阈值进行风险评估。这种方法保证了关键指标(如危急值)判断的绝对准确性,不受大模型随机性的影响。
class HealthRiskAssessor:
THRESHOLDS = {
"heart_rate": {"low": 50, "high": 100, "critical_high": 120},
"sleep": {"low": 5.0, "optimal_min": 7.0, "optimal_max": 9.0},
"blood_pressure_systolic": {"low": 90, "high": 140, "critical_high": 180},
}
def assess(self, metrics: List[HealthMetric]) -> Dict:
risks = []
for metric in metrics:
threshold = self.THRESHOLDS.get(metric.metric_type)
if not threshold or metric.confidence < 0.6:
continue
if metric.value <= threshold.get("low", float("-inf")):
risks.append({"type": metric.metric_type, "level": "偏低", "value": metric.value})
elif metric.value >= threshold.get("critical_high", float("inf")):
risks.append({"type": metric.metric_type, "level": "紧急偏高", "value": metric.value})
elif metric.value >= threshold.get("high", float("inf")):
risks.append({"type": metric.metric_type, "level": "偏高", "value": metric.value})
return {"risks": risks, "assessment_time": datetime.utcnow().isoformat()}安全过滤与主逻辑
安全过滤层通过正则表达式拦截违规表述,确保输出符合医疗合规要求。主逻辑则串联数据评估、Prompt构建和LLM调用。
import re
from openai import OpenAI
import json
class HealthAssistant:
def __init__(self, api_key: str, model: str = "gpt-4o"):
self.client = OpenAI(api_key=api_key)
self.model = model
self.assessor = HealthRiskAssessor()
# 安全过滤:医疗合规底线
SAFETY_PATTERNS = {
"诊断替代": r"(患有|确诊|诊断为|得了)\\S*(病|症|炎|癌)",
"用药建议": r"(建议服用|推荐吃|应该吃|可以吃)\\S*(药|片|胶囊)",
}
def safety_filter(self, response_text: str) -> str:
filtered = response_text
for category, pattern in self.SAFETY_PATTERNS.items():
if re.search(pattern, filtered):
filtered = re.sub(pattern, "相关指标存在异常波动,建议尽快就医确认", filtered)
filtered += "\
\
[温馨提示:以上建议仅供参考,不能替代专业医疗诊断。如有不适,请及时就医。]"
return filtered
def _build_prompt(self, risk_report: Dict, user_profile: Dict) -> str:
return f"""你是一位专业的 AI 健康助手。语气亲切但不失专业。
用户画像:{json.dumps(user_profile, ensure_ascii=False)}
今日风险评估:{json.dumps(risk_report, ensure_ascii=False)}
请基于以上信息:
1. 解读当前健康状况
2. 给出 2-3 条可执行的生活建议
3. 若存在紧急风险,明确提醒就医
4. 严禁做出疾病诊断或用药建议"""
def chat(self, metrics: List[HealthMetric], user_profile: Dict) -> str:
risk_report = self.assessor.assess(metrics)
prompt = self._build_prompt(risk_report, user_profile)
try:
response = self.client.chat.completions.create(
model=self.model,
messages=[
{"role": "system", "content": "你是一位温暖专业的AI健康助手。"},
{"role": "user", "content": prompt}
],
temperature=0.7,
max_tokens=800
)
raw_response = response.choices[0].message.content
except Exception as e:
return f"服务暂时不可用,请稍后再试。(错误:{str(e)})"
return self.safety_filter(raw_response)工程实践中的关键权衡
在构建AI健康助手时,开发者必须在多个维度进行权衡,以找到最佳平衡点。
专业性与通俗性的平衡
医学术语准确但用户难以理解,通俗说法易懂但可能缺乏精确性。解决方案是采用“通俗解读+专业术语对照”的策略。例如,在解释“静息心率偏高”时,先说明“心脏负担较重”,再附带医学术语“窦性心动过速”,让用户根据自身需求选择阅读深度。
情感化与安全性的矛盾
过于温暖的语言可能导致“安慰性误导”。例如,当用户心率异常时,若仅回复“别担心,多休息”,可能延误治疗。因此,Prompt设计中需明确要求“温和但明确地提醒就医”,并在安全层强制插入免责声明,确保在提供情感支持的同时,不牺牲医疗安全性。
个性化与隐私的冲突
个性化服务依赖大量用户数据,但这与隐私保护相悖。敏感数据(如具体病史、基因信息)应在本地处理,仅将脱敏后的风险摘要上传至云端LLM。此外,采用差分隐私技术或联邦学习,可在不泄露原始数据的前提下优化模型。
实时性与成本的考量
每次对话都调用大模型,成本高昂。以日活10万计算,月成本可能高达数万美元。优化策略包括:缓存相似回复、在低风险场景使用小模型降级、以及通过规则引擎拦截简单查询,仅将复杂推理任务交给大模型。这些措施可将成本降低30%以上,但需监控回复质量的变化。
落地建议与未来展望
对于希望落地AI健康助手的团队,建议遵循以下路径:
- 单一数据源切入:初期专注于单一数据源(如步数+睡眠),验证数据标准化流程的稳定性,再逐步扩展至血压、心率等多维数据。
- 规则为主,LLM为辅:在系统初期,让规则引擎主导判断,LLM仅负责生成建议。随着数据积累和模型优化,逐步提高LLM的参与度。
- 安全过滤先行:在开放情感化表达之前,务必夯实安全过滤层,避免上线后出现合规事故。
- 持续迭代优化:通过A/B测试调整表达温度和专业知识深度,找到用户接受度与专业性的最佳平衡点。
AI健康助手的定位并非取代医生,而是作为随时在身边的健康提醒者。它适合日常监测、生活指导和风险预警,但不适用于疾病诊断、处方开具或急救场景。在急救情况下,直接拨打急救电话远比询问AI可靠。
技术能让数据说话,但只有通过精心的设计和严格的工程实践,数据才能真正转化为对用户有益的健康洞察。随着技术的进步,未来的健康助手将更加精准、安全且个性化,成为人类健康管理的重要伙伴。