AI Agent重塑Rust开发:从代码生成到自动化重构的深层变革
Rust开发的核心痛点与AI介入的必要性
Rust语言在系统编程领域的地位日益稳固,其通过所有权系统(Ownership System)、生命周期(Lifetimes)以及Trait Bound等机制,在编译阶段即可消除空指针解引用、数据竞争等常见内存安全问题。然而,这种严格的安全保障是以牺牲开发便捷性为代价的。对于初学者甚至中级开发者而言,Rust的学习曲线极为陡峭。一个典型的场景是:开发者可能仅需花费30分钟编写业务逻辑,却需要耗费2小时甚至更久来解读编译器报错信息,修复因借用检查器(Borrow Checker)拦截而引发的错误。
具体而言,Rust开发的高频痛点主要集中在三个方面。首先是编译错误信息的解读门槛。虽然Rust编译器以给出详细且富有建设性的错误提示闻名,但对于缺乏经验的用户,诸如borrowed value does not live long enough这类错误往往意味着巨大的认知负荷。开发者需要深刻理解变量作用域、引用传递以及借用规则,才能快速定位问题根源。其次是API设计的反直觉性。在Python或JavaScript等动态语言中,开发者可以先实现逻辑再优化类型;但在Rust中,如果在架构设计初期未能清晰界定所有权归属和生命周期约束,后期的重构成本将呈指数级上升。最后是生态选型的复杂性。Rust生态中crate的质量参差不齐,例如在网络库方面,reqwest与surf各有优劣;在序列化方面,serde_json与simd-json性能差异显著。这种选型焦虑往往需要大量的调研和实测。
正是在这种背景下,AI辅助编程工具成为了破局的关键。但需要注意的是,AI并非万能的代码代写机器,其核心价值在于辅助开发者处理高频、重复且高认知负荷的任务,而非替代开发者进行核心逻辑的设计。
AI辅助Rust开发的三层技术架构
要理解AI如何赋能Rust开发,必须明确其在不同层次的能力边界。当前,AI辅助Rust开发主要呈现为三个渐进的层级:代码补全、对话式辅助以及Agent自主执行。
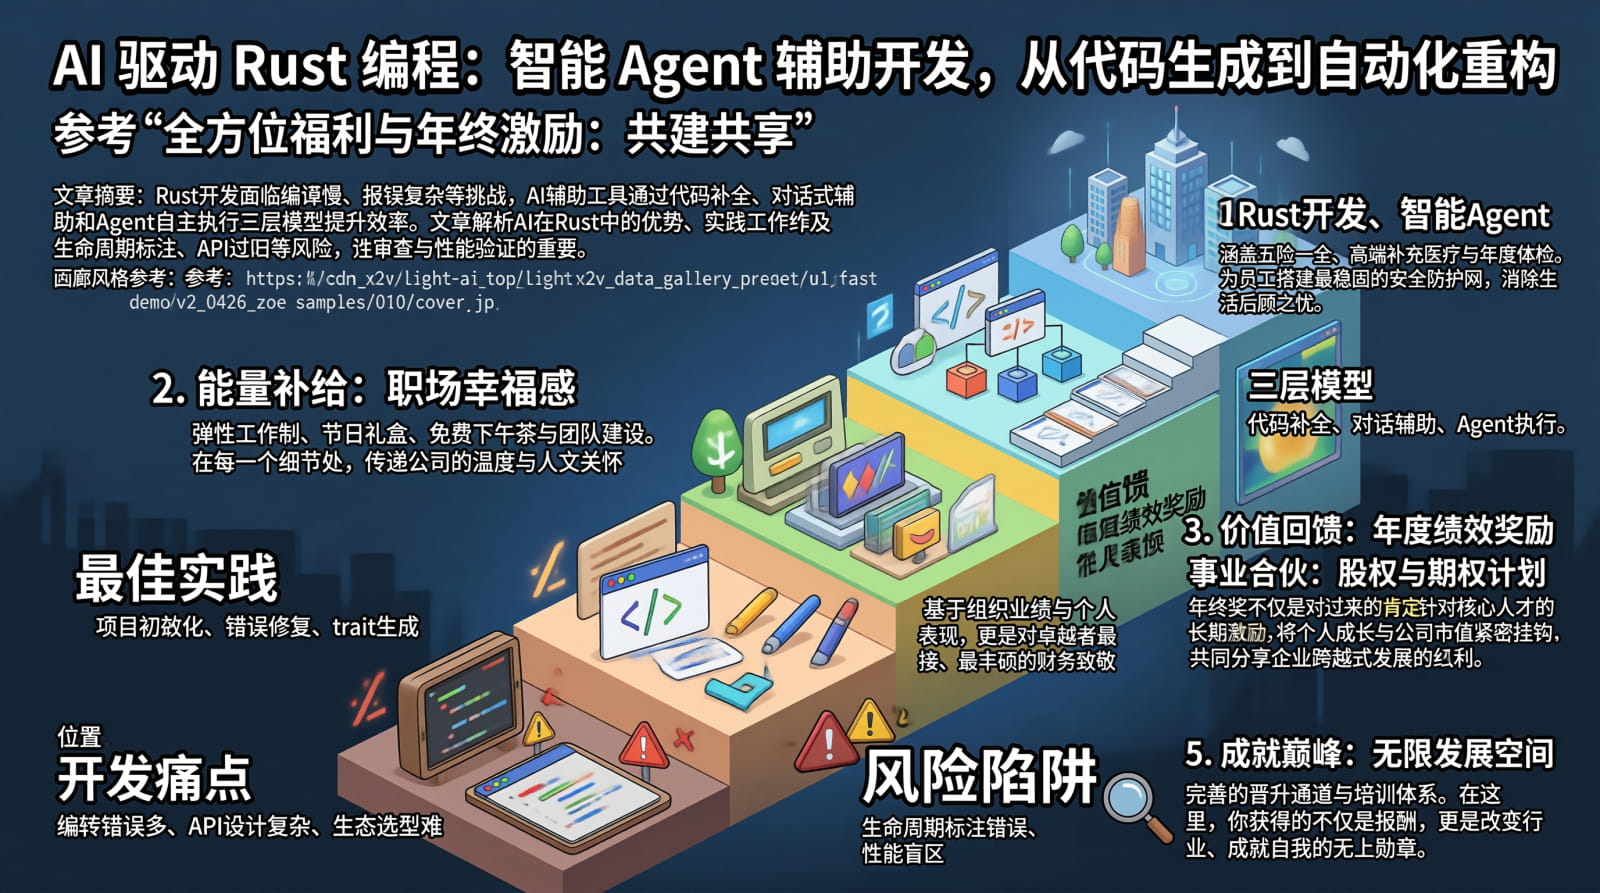
第一层是代码补全。这是目前最普及的形式,如GitHub Copilot。它基于大语言模型(LLM)的上下文预测能力,能够自动补全函数签名、循环结构或常见的模板代码。这一层级主要解决的是输入效率问题,减少开发者敲击键盘的次数。
第二层是对话式辅助。这一层级超越了单纯的代码生成,进入了解释与建议的领域。例如,当编译失败时,开发者可以将错误信息粘贴到Cursor Chat等工具中,AI不仅能解释错误原因,还能提供多种修复方案及其利弊分析。这一层级极大地降低了调试过程中的认知门槛。
第三层是Agent自主执行。这是当前技术的前沿,如Claude Code或某些集成IDE的AI Agent。它们拥有对文件系统的读写权限,能够自主读取代码库、分析错误上下文、生成修复补丁并执行测试。在理想情况下,Agent可以完成从错误定位到代码修改的全闭环操作。
Rust之所以成为AI辅助编程收益最大的语言之一,原因在于其强类型系统和结构化的错误信息。编译器提供的严格类型信息为AI提供了准确的上下文约束,使其生成的代码准确率高于动态语言。同时,Rust的模式固定(如使用Result<T, E>进行错误处理,使用RAII进行资源管理),使得AI更容易学习到通用的代码模式。然而,AI在Rust中也存在明显局限,特别是在生命周期标注和异步代码生成上,容易出现幻觉或约束冲突。
生产级实践:AI赋能Rust开发的最佳工作流
在实际生产环境中,如何将AI无缝融入Rust开发流程,而非仅仅作为玩具使用,是提升团队效率的关键。以下通过四个核心场景展示AI的具体应用方式。
加速项目初始化与骨架生成
项目初始化往往涉及大量样板代码的配置,如命令行参数解析、日志框架集成以及错误处理类型定义。AI可以快速生成符合现代Rust规范的项目骨架。例如,使用clap进行参数解析,tracing进行日志记录,anyhow进行错误传播。AI生成的代码通常包含了完整的#[derive]属性和错误处理逻辑,开发者只需关注核心业务逻辑的实现。这种“脚手架”式的辅助,让开发者能够将精力集中在算法和数据结构的设计上,而非配置文件的编写上。
深度解析与修复编译错误
面对复杂的编译错误,传统的调试方式是查阅官方文档或Stack Overflow。而AI辅助的方式则是“解释先行,修复在后”。当遇到生命周期错误时,AI不仅能指出words是局部变量,其引用无法返回给外部,还能解释为什么&text可以返回(因为输入的生命周期与输出绑定)。更重要的是,AI能提供具体的重构建议,例如将中间集合操作改为直接在原始字符串上进行切片,从而消除对中间变量的依赖。这种互动式的调试过程,不仅是修复代码,更是学习Rust底层原理的高效途径。
自动化Trait实现与错误类型转换
Rust中实现自定义错误类型需要实现Display和Error Trait,以及从标准库错误类型(如std::io::Error)转换的实现。这些代码重复且枯燥。AI可以瞬间生成这些样板代码,并正确实现From trait,简化错误传播。例如,将reqwest::Error转换为自定义的AppError::Network变体。这种自动化不仅提高了开发速度,还确保了错误处理的一致性和完整性。
辅助异步并发代码编写
异步编程是Rust的另一大难点,涉及tokio运行时、通道(Channels)和并发安全约束。AI可以辅助生成生产者-消费者模式的框架代码,包括mpsc通道的创建、发送端的超时处理以及接收端的循环逻辑。AI还能帮助识别潜在的Send约束冲突,例如在跨线程传递数据时,确保数据结构实现了Send和Sync trait。虽然AI生成的异步代码仍需人工审查,但它为开发者提供了一个可靠的基础起点,避免了低级并发错误的出现。
警惕AI陷阱:生命周期幻觉与性能盲区
尽管AI在Rust开发中表现出色,但盲目信任AI生成的代码可能导致严重的质量问题。以下是三个需要特别警惕的陷阱。
首先是生命周期幻觉。AI有时会根据表面模式生成看似正确的生命周期标注,但实际语义可能错误。例如,AI可能生成省略生命周期(\'_)的代码,在编译通过的情况下,运行时却出现悬垂引用或借用检查失败。这是因为AI难以完全理解整个调用链中引用的动态关系。因此,任何涉及生命周期的AI生成代码,都必须经过逐行的人工审查,确保其符合所有权的语义规则。
其次是过时API风险。大语言模型训练数据存在时间截止点,而Rust生态迭代迅速。AI可能生成已废弃的crate API调用,或者使用过时的错误处理模式(如使用panic!而非Result)。开发者必须对照最新的官方文档验证API的正确性,利用cargo doc本地文档进行核对,避免引入已弃用的功能。
最后是性能盲区。AI倾向于生成“能工作”的代码,而忽视性能优化。例如,在热路径(Hot Path)中,AI可能生成不必要的clone()操作,或在循环中使用collect()创建中间集合,导致内存分配频繁。对于性能敏感的场景,开发者必须使用cargo bench进行基准测试,并使用cargo flamegraph分析性能热点,确保AI生成的代码不会成为性能瓶颈。
适用边界与落地建议
综合来看,AI辅助Rust开发有其明确的适用边界。它非常适合用于项目初始化、样板代码生成、编译错误解释以及API选型调研。然而,对于复杂的生命周期设计、并发安全关键代码、性能敏感的热路径以及安全相关的加密逻辑,AI目前仍不足以完全替代人工判断。
对于希望将AI引入Rust工作流的团队,建议采取以下落地策略:
- 定位准确:将AI视为“更快的文档查询工具”和“高级代码补全助手”,而非“代码代写工具”。开发者仍需对最终代码的质量和安全负责。
- 解释优先:遇到编译错误时,优先让AI解释原因,理解背后的所有权和生命周期逻辑,再手动修复或采纳建议。
- 严格审查:对AI生成的生命周期标注和API调用进行严格的人工审查,特别是涉及所有权转移和生命周期绑定的部分。
- 性能验证:对AI生成的核心逻辑进行基准测试,确保其性能符合预期,必要时进行手动优化。
- 持续学习:利用AI生成的错误解释和重构建议,反向提升团队对Rust语言特性的理解,将AI转化为团队能力提升的加速器。
AI正在重塑Rust开发的边界,但它并未改变Rust的核心哲学。理解所有权和生命周期的本质,依然是每一位Rust开发者不可或缺的基本功。AI是工具,开发者才是灵魂。只有在深刻理解语言特性的基础上,才能充分利用AI的力量,打造出既安全高效又易于维护的高质量Rust软件。