端侧AI破局:为何内存带宽比算力更关键?2026年三大技术拐点解析
技术曲线的历史性交汇
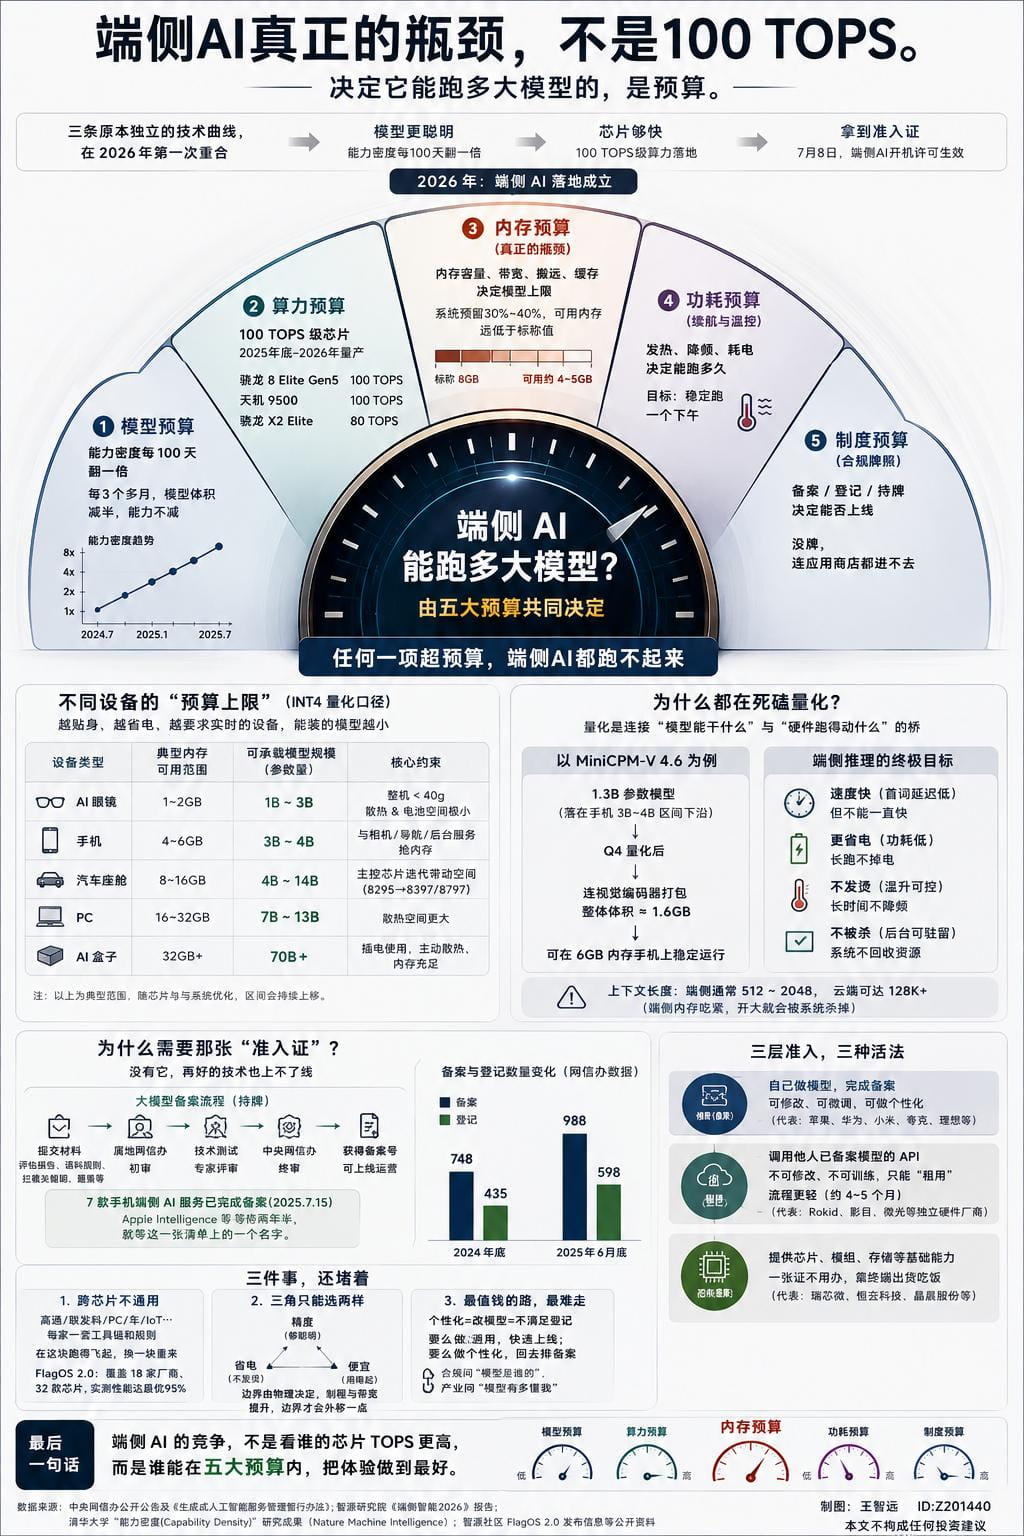
2026年,人工智能的叙事重心发生了显著转移。曾经被视为营销噱头的“本地运行大模型”、“不联网推理”,如今已成为智能手机、智能眼镜及汽车座舱的标准配置。这一转变并非偶然,而是三条原本独立演进的技术曲线,在2026年首次实现了完美的时空重合。
首先是模型能力的“浓缩化”。清华大学团队提出的“能力密度”概念指出,大模型的能力密度正以每100天翻一倍的速度增长。这意味着,仅需一半的参数规模,即可达到此前最强模型的性能水准。这种指数级的效率提升,使得将庞大模型塞入有限硬件成为可能。例如,MiniCPM系列模型在全球范围内的广泛下载与GitHub上的高关注度,印证了开源社区在轻量化模型上的巨大突破。
其次是芯片算力的实质性跨越。高通骁龙8 Elite Gen5与联发科天玑9500等新一代芯片,其AI算力峰值均达到100 TOPS,且功耗大幅降低,并支持低比特推理技术。这些硬件在2025年底至2026年间集中量产,为端侧AI提供了必要的物理基础。
最后是合规准入的正式落地。国家网信办发布的手机端侧AI服务备案清单,标志着端侧AI从技术探索进入合法商用阶段。苹果Apple Intelligence在中国市场的延迟上线,正是为了等待这一合规“准入证”。这三条曲线的汇合,构成了2026年端侧AI落地的核心驱动力。
被误读的瓶颈:内存而非算力
尽管100 TOPS的算力数字令人瞩目,但在端侧部署工程师眼中,这一指标的实际参考价值有限。决定手机能否流畅运行大模型的关键,从来不是纸面算力,而是内存容量、内存带宽、数据搬运效率及缓存管理机制。
云端与端侧的本质区别在于约束条件。云端受限于资金,可通过增加服务器扩展资源;而端侧受限于物理定律,内存大小、电池容量及散热面积均为固定值。这种物理约束将各类设备锁死在特定的模型尺寸区间内。
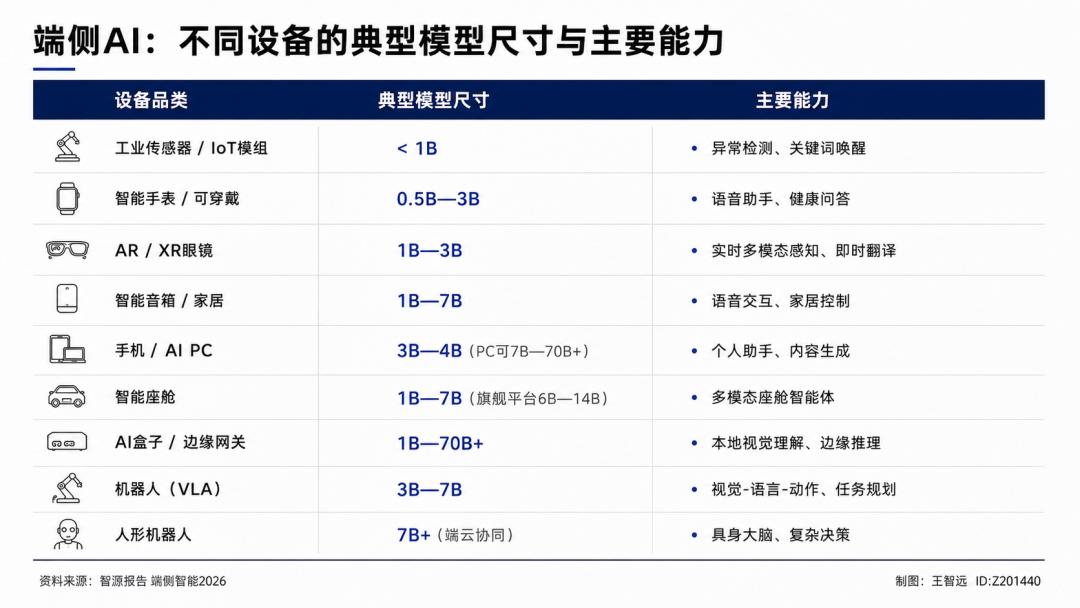
根据智源研究院《端侧智能2026》报告的数据分析,不同设备的模型承载能力呈现明显差异。AI眼镜因重量限制(通常低于40克),仅能容纳1B至3B参数模型;手机需在相机、导航等多任务间共享内存,适合3B至4B模型;而拥有充足电源与散热空间的AI盒子,则可承载70B以上的大模型。
以面壁的MiniCPM-V 4.6为例,其1.3B参数经Q4量化后,整体部署体积约1.6GB,可在6GB内存手机上安全运行。这一案例表明,模型设计必须严格遵循硬件的内存预算。若超出系统预留的内存阈值(通常为30%-40%),操作系统如iOS的Jetsam或安卓的LMK机制将直接终止应用,导致推理失败。
量化的艺术:连接模型与硬件的桥梁
在内存受限的端侧环境中,量化技术成为连接“模型能力”与“硬件性能”的关键桥梁。量化通过降低数据精度(如从FP16降至INT4或更低),大幅减少模型体积与计算开销,从而在精度、体积与速度之间寻找最优平衡。
然而,量化并非万能。它必须在精度损失与性能提升之间进行精细权衡。过度量化会导致模型“变傻”,无法处理复杂任务;而保留过高精度则会耗尽内存资源。因此,能否在特定硬件上实现精度、体积与速度的最佳平衡,已成为衡量模型厂商工程能力的核心标尺。
此外,端侧推理还需考虑持续负载下的稳定性。手机在高负载下易发热降频,导致电量快速消耗及系统资源抢占。因此,评估端侧AI性能时,不仅要看首词生成速度,更要关注其长时间运行的功耗表现及后台存活能力。目前,端侧模型的上下文长度通常限制在512至2000 tokens之间,远低于云端的128K,这正是为了避免内存溢出导致的系统崩溃。
合规分层:持牌、租牌与硬件商的生存逻辑
合规准入不仅影响产品上线,更重塑了产业链的利益分配格局。当前,生成式AI服务在中国市场呈现出明显的三层结构。
第一层为持牌方。华为、小米等终端厂商通过自有模型或合作方式获得备案,拥有系统级权限及跨应用调度能力。持牌方可直接对模型进行微调与个性化适配,无需担心合规风险。
第二层为租牌方。许多独立硬件厂商及软件服务商选择调用已备案模型的API。这一路径审批流程较短(约4-5个月),但存在两大限制:一是模型不可修改,无法进行个性化微调;二是品牌依赖性强,需明确公示模型来源。随着登记数量快速增长,这一模式成为中小厂商的主流选择。
第三层为硬件供应商。芯片厂商如瑞芯微、恒玄科技等,因不直接提供生成式AI服务,无需办理合规牌照。其收益直接取决于终端出货量,与合规风险隔离。这一层级在产业链中处于相对舒适的位置,专注于提供算力基础。
未解的难题:适配、三角困境与合规冲突
尽管端侧AI进展迅速,但仍面临三大核心挑战。
首先是芯片适配的碎片化。端侧芯片架构多样,高通、联发科、英特尔等各有其工具链与规则。主流AI开发依赖CUDA生态,而国产芯片缺乏相应的适配支持,导致模型迁移成本高昂。尽管智源FlagOS等项目试图统一算子库,但覆盖32款芯片的兼容性仍需时间打磨。
其次是“精度-功耗-成本”三角困境。在物理约束下,三者无法同时最优。提升精度需增加参数与内存;降低功耗需压缩模型;降低成本需使用低端芯片。模型密度定律虽能推动边界外扩,但三角关系依然存在,厂商需在特定场景下做出取舍。
最后是合规与个性化的冲突。端侧AI的核心优势在于数据隐私与个性化体验,但这要求模型具备本地微调能力。然而,合规制度要求模型备案后不可随意修改,否则需重新走完整备案流程。这一矛盾使得租牌方难以提供深度个性化服务,而持牌方则占据优势。这种制度设计实际上将高价值的个性化市场留给了具备合规能力的头部企业。
结语
2026年的端侧AI,正处于从技术可行向商业常态过渡的关键阶段。内存带宽与容量而非算力,成为制约模型规模的核心瓶颈。量化技术、合规准入及芯片适配,共同构成了行业发展的三大支柱。
未来,随着模型密度持续提升及硬件能效优化,端侧AI将在更多设备上实现深度本地化。然而,如何在合规框架下平衡个性化需求,如何解决芯片碎片化带来的适配难题,仍是行业需要长期探索的课题。对于厂商而言,理解物理约束与合规逻辑,比单纯追求算力指标更为重要。