端侧AI破局:为何内存带宽比算力更关键?2026年三大技术拐点解析
技术曲线的历史性交汇
2026年,人工智能的叙事重心发生了根本性转移。过去两年,我们习惯于讨论云端算力的无限扩张,而今年,手机、智能眼镜、汽车座舱等终端设备开始强调“本地运行大模型”、“不联网”、“芯片自算”。这不再是营销噱头,而是基于三条独立技术曲线在2026年首次重合的现实。
第一条曲线是模型能力的“浓缩”。清华大学孙茂松、刘知远团队提出的“能力密度”概念指出,大模型的能力密度正以每100天翻一倍的速度增长。这意味着,每隔三个多月,只需一半的参数规模,即可达到此前最强模型的效果。这种压缩速度远超摩尔定律下芯片算力每两年翻一倍的增长率。以MiniCPM系列为例,其1B参数版本在效果上超越了3个月前的2B模型,体积减半却更聪明。这种效率提升为端侧部署提供了可能。
第二条曲线是芯片算力的实质性突破。2026年,高通骁龙8 Elite Gen5与联发科天玑9500等旗舰芯片的AI算力均达到100 TOPS,且功耗大幅降低,支持低比特推理技术。这些芯片在2025年底至2026年间集中量产,标志着端侧硬件终于具备了承载复杂模型的基础能力。
第三条曲线是合规准入的落地。2026年7月,国家网信办发布首批7款手机端侧AI服务备案名单,其中包含苹果Apple Intelligence的国行版。苹果早在2024年便完成了端侧基础模型的技术准备,但在中国市场等待了两年半,直至获得合规许可。这三条曲线的汇合,标志着端侧AI从技术验证进入规模化落地阶段。
被误解的瓶颈:内存而非算力
尽管100 TOPS的算力数字令人瞩目,但端侧部署工程师普遍认为,纸面算力参考价值有限。真正制约模型运行的,是内存容量、内存带宽、数据搬运效率及缓存管理。在端侧环境中,模型往往被内存瓶颈拖慢,如同“路窄车快”,算力无法充分释放。
以iOS的Jetsam机制和安卓的LMK机制为例,系统会在内存超限时直接杀掉应用,且无预警。这意味着,即便手机标称8GB内存,实际需预留30%-40%给系统及后台服务,留给大模型的可用内存远小于标称值。这与云端形成鲜明对比:云端约束在于成本,可通过增加服务器扩展;端侧约束在于物理极限,受限于内存容量、电池容量及散热面积。
智源研究院《端侧智能2026》报告中的数据显示,不同设备能承载的模型规模存在显著差异。越贴身、越省电、越要求实时的设备,能装的模型越小。例如,AI眼镜整机重量控制在40克以内,留给内存和散热的空间极小,仅能支持1B-3B参数模型;而AI盒子因有充足电源和散热空间,可承载70B+参数模型。手机处于中间状态,受限于与相机、导航等应用的内存竞争,通常支持3B-4B参数模型。
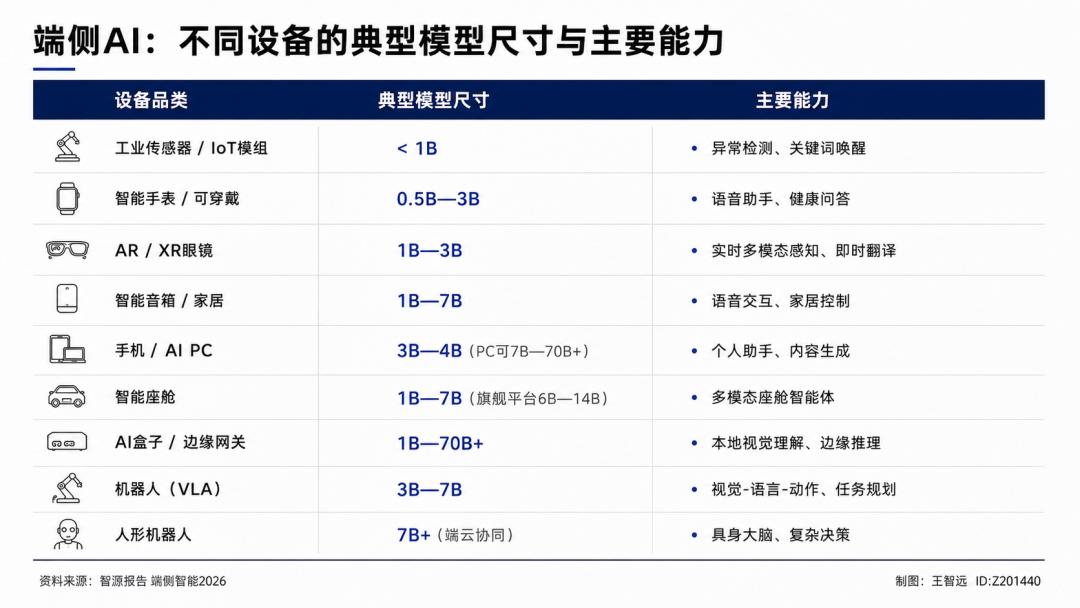
量化:连接模型与硬件的桥梁
面对严格的内存约束,量化技术成为端侧AI的核心工程能力。量化旨在精度、体积、速度之间寻找最优平衡点。以面壁的MiniCPM-V 4.6为例,其1.3B参数模型经Q4量化后,整体部署体积约1.6GB,可在6GB内存手机上运行。这一案例表明,模型设计需严格遵循硬件约束,而非单纯追求参数规模。
此外,端侧推理需关注持续负载下的稳定性。手机在高负载下易发热、降频、耗电,系统可能因资源抢占而终止应用。因此,端侧AI的评价标准从“首词生成速度”转向“长时间稳定运行能力”。当前,端侧模型上下文长度通常限制在512-2048 tokens,远低于云端的128K,主要原因在于内存占用过高会导致系统杀进程。
合规分层:持牌、租牌与硬件商的博弈
合规准入不仅影响产品上线,更重塑了产业链的利益分配。目前,端侧AI服务呈现三层结构:
第一层为持牌方。华为、小米、苹果等厂商持有备案牌照,拥有系统级权限、跨应用调度及开机自启智能体等特权。持牌方可自由微调模型,实现个性化定制,这是端侧AI的核心价值所在。
第二层为租牌方。通过调用已备案模型的API,企业仅需在省级网信办登记,流程约4-5个月。但登记模式限制模型修改,无法进行个性化微调。Rokid、影目等独立硬件厂商多采用此模式,虽灵活切换多家大模型,但缺乏数据独占性。数据显示,2026年6月,登记数量达598款,增速超过备案,反映中小厂商的合规策略。
第三层为硬件供应商。瑞芯微、恒玄科技等芯片厂商不受生成式AI服务管理暂行办法约束,无需办理牌照。其收益取决于终端出货量,与合规风险隔离。AI眼镜产业链的业绩预告显示,存储芯片及终端放量是主要驱动因素,合规并非其关注焦点。
落地困境:适配、三角与合规冲突
尽管前景广阔,端侧AI仍面临三大挑战:
首先是芯片适配碎片化。端侧芯片架构多样,高通、联发科、英特尔等各有独立工具链。主流AI开发依赖CUDA生态,国产芯片缺乏社区适配,导致模型迁移成本高。智源FlagOS 2.0试图统一算子库,覆盖32款芯片,但实际效果仍需验证。
其次是精度、功耗、成本的“不可能三角”。提升模型精度需增加参数,导致内存与功耗上升;降低功耗需压缩模型,牺牲精度;降低成本需使用低端芯片,限制模型规模。模型密度定律虽能扩展三角边界,但无法消除其存在。
最后是合规与个性化的冲突。端侧AI的核心优势在于数据隐私与个性化,但这要求模型微调。然而,微调后的模型需重新备案,流程繁琐。租牌方为快速上线,往往放弃个性化,导致产品同质化。这一矛盾将个性化能力集中于持牌大厂,加剧行业分化。
结语
2026年,端侧AI的落地并非单纯的技术问题,而是技术、物理与合规多重约束下的系统工程。内存带宽与容量成为比算力更关键的瓶颈,量化技术成为连接模型与硬件的桥梁。合规分层重塑了产业链格局,持牌方凭借个性化能力占据高地,租牌方在灵活性与深度间权衡,硬件商则受益于终端放量。未来,随着芯片架构统一、模型密度提升及合规流程优化,端侧AI将在更多场景中实现深度集成,推动人工智能从云端走向边缘,从通用走向个性化。