中国00后团队MACARON-V1破局:万亿参数LoRA强化学习如何重塑AI格局
技术路线的共识与分野
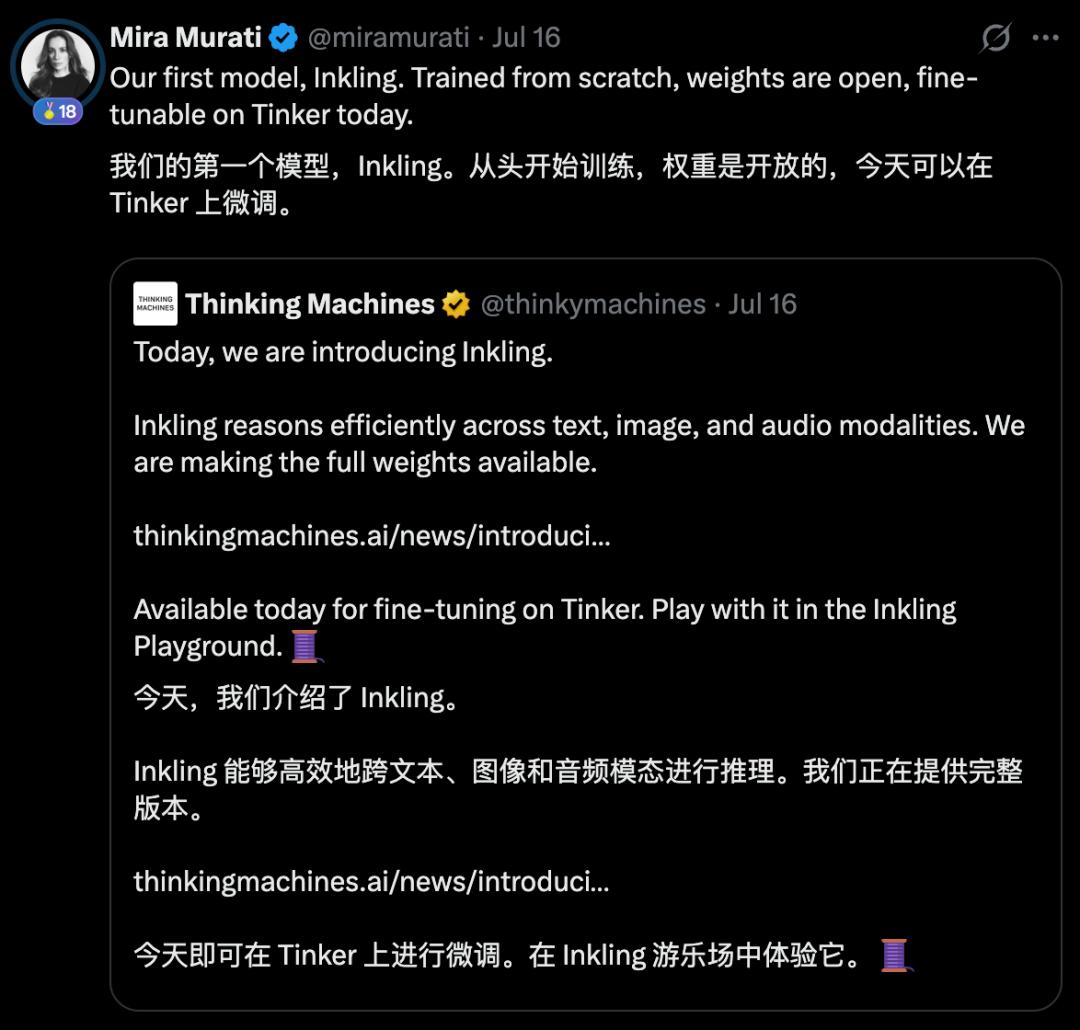
当硅谷顶级创业公司Thinking Machines Lab宣布获得20亿美元融资并推出拥有975B参数的Inkling模型时,整个AI行业都在关注这一里程碑事件。几乎同一时间,强化学习之父Richard Sutton和DeepSeek创始人梁文锋也表达了相似的判断:当前的深度学习架构存在根本性缺陷,下一代通用智能的核心在于“持续学习”能力。这条技术路线已从单纯的技术选择演变为行业共识。
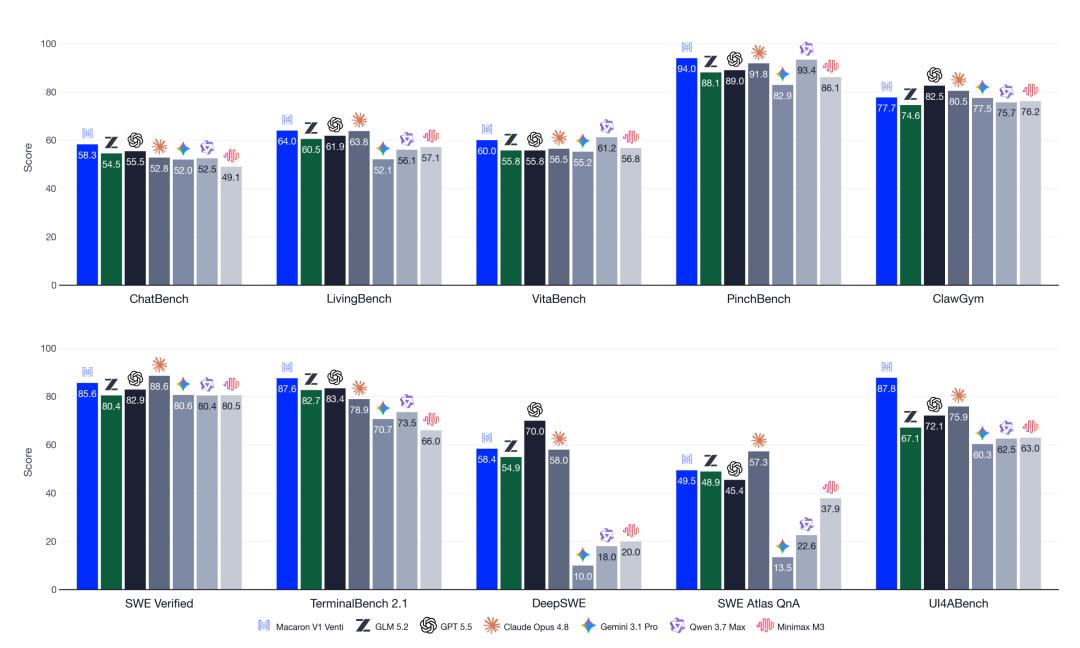
然而,在太平洋的另一侧,一家成立仅不到一年的中国实验室——Mind Lab,正在以截然不同的策略推进这一共识。他们发布的Macaron-V1模型,不仅在性能上达到了与Opus 4.8、GPT-5.5和Gemini 3.1 Pro相当的水平,更在代码能力和Agent任务中展现了惊人的突破。这不仅是参数的胜利,更是架构创新的胜利。
Mixture-of-LoRA:重新定义模型能力边界
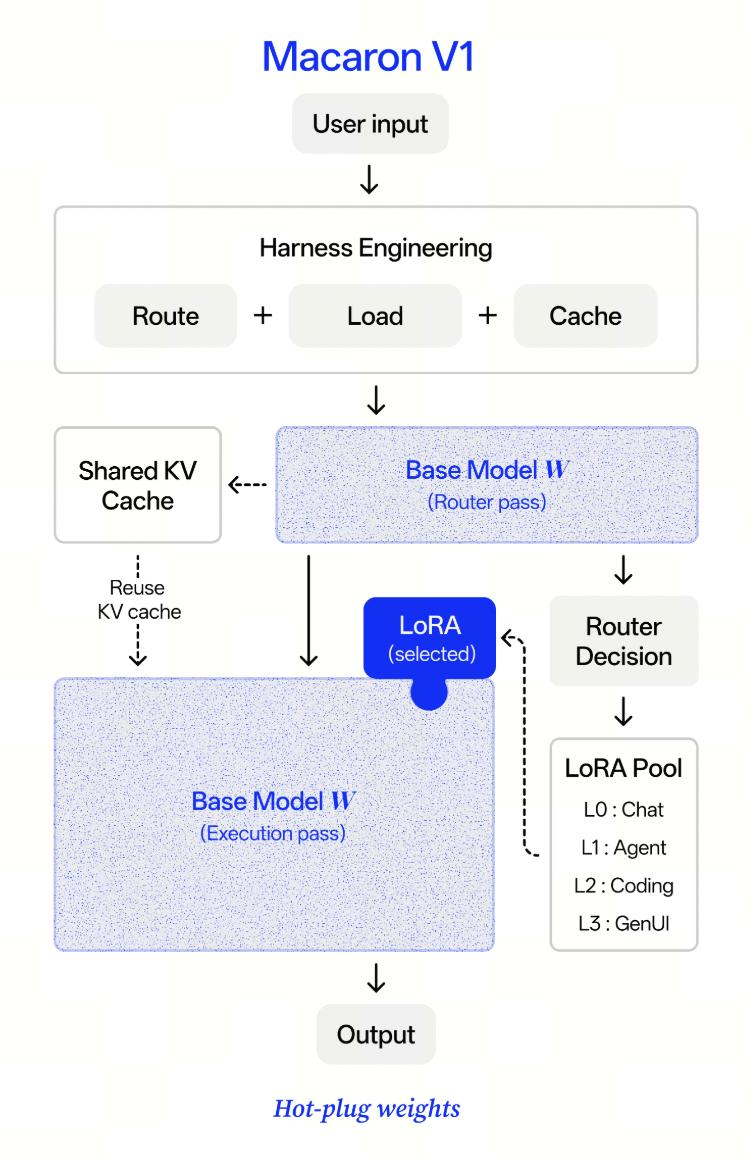
Macaron-V1的核心创新在于其对LoRA技术的重构。传统观点认为,LoRA是全参数微调的“廉价替代”,但在Mind Lab的架构中,LoRA被赋予了全新的角色。模型由744B的GLM-5.2基座与四个独立的1B LoRA模块组成,分别针对聊天、Agent、编程和生成式UI(GenUI)进行专门优化。
这种“Mixture-of-LoRA”(MoL)架构允许模型在运行时通过路由器动态切换不同的能力模块。例如,当用户请求安排日程时,系统自动调用Agent LoRA;当处理代码调试时,则切换至编程LoRA。这种设计避免了多任务训练中的能力冲突,实现了专才协同而非全能模型的内部博弈。
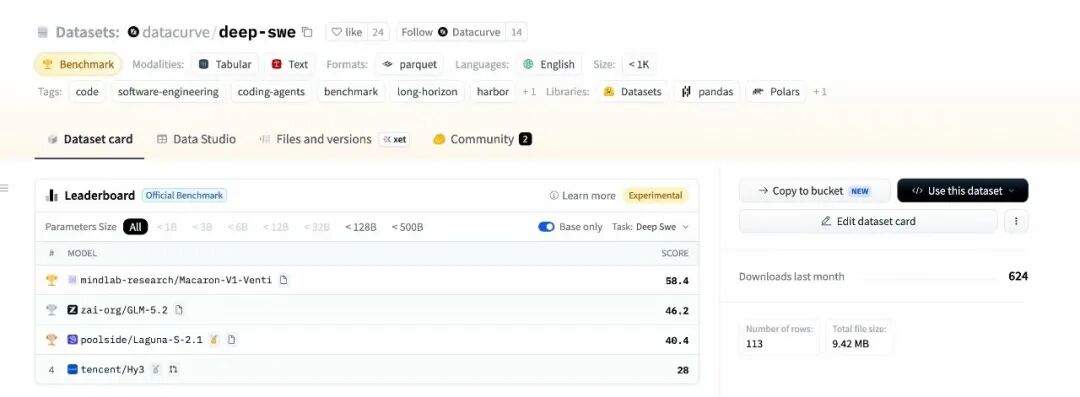
评测数据显示,Macaron-V1-Venti在SWE-bench Verified基准测试中以85.6分的高分登顶,显著领先于DeepSeek-V4-Pro等主流模型。在针对长程复杂软件工程任务的Deep-SWE测试中,该模型更是以58.4分的成绩,比其基座模型GLM-5.2高出12个点。这一差距直观地展示了强化学习后训练在提升特定任务能力上的巨大增量价值。
规模化的挑战:万亿参数下的稳定收敛
将LoRA强化学习应用于万亿参数规模的稀疏混合专家(MoE)模型,面临着巨大的技术挑战。核心难点在于“训推不一致”问题:在训练过程中,模型被切片分布到多张GPU上,推理与训练环境的微小精度差异会导致梯度漂移,进而使训练曲线无法收敛。
Mind Lab之所以能在这一领域取得突破,得益于其在Kim K2(总参1.04万亿)上的早期探索。通过在固定GPU算力下进行强化学习后训练,团队成功实现了曲线的稳定收敛。这一技术积累为Macaron-V1的开发奠定了基础,使其能够在不增加大规模算力的前提下,实现性能的大幅跃升。
全球能在万亿参数规模上跑通LoRA强化学习的团队屈指可数。Mind Lab与Thinking Machines Lab几乎同时证明了这条路线的可行性,但两者的执行策略却大相径庭。
站在巨人肩膀上:开源生态的战略价值
与Thinking Machines Lab从零训练基座不同,Mind Lab选择直接利用中国成熟的开源模型生态。Macaron-V1的基座分别基于GLM-5.2和Qwen-3.7,这些开源模型在预训练阶段已经接近全球最先进水平。
这种策略极大地降低了研发成本。Mind Lab仅用不到5000万美元的融资和30多人的团队,就实现了与硅谷百亿级团队相当的技术能力。通过利用现有的强大基座,Mind Lab将资源集中在后训练阶段的强化学习优化上,从而在投入产出比上获得了显著优势。
Andrew在WAIC演讲中展示的案例进一步印证了这一点:用户上传打乱的魔方照片,模型能够联动视觉理解、算法求解、Agent工具调用和GenUI生成3D还原指南。这种多模态协同能力的实现,得益于基座模型的强大通用性与LoRA模块的专项强化相结合。
经验时代:从预训练到持续学习的范式转移
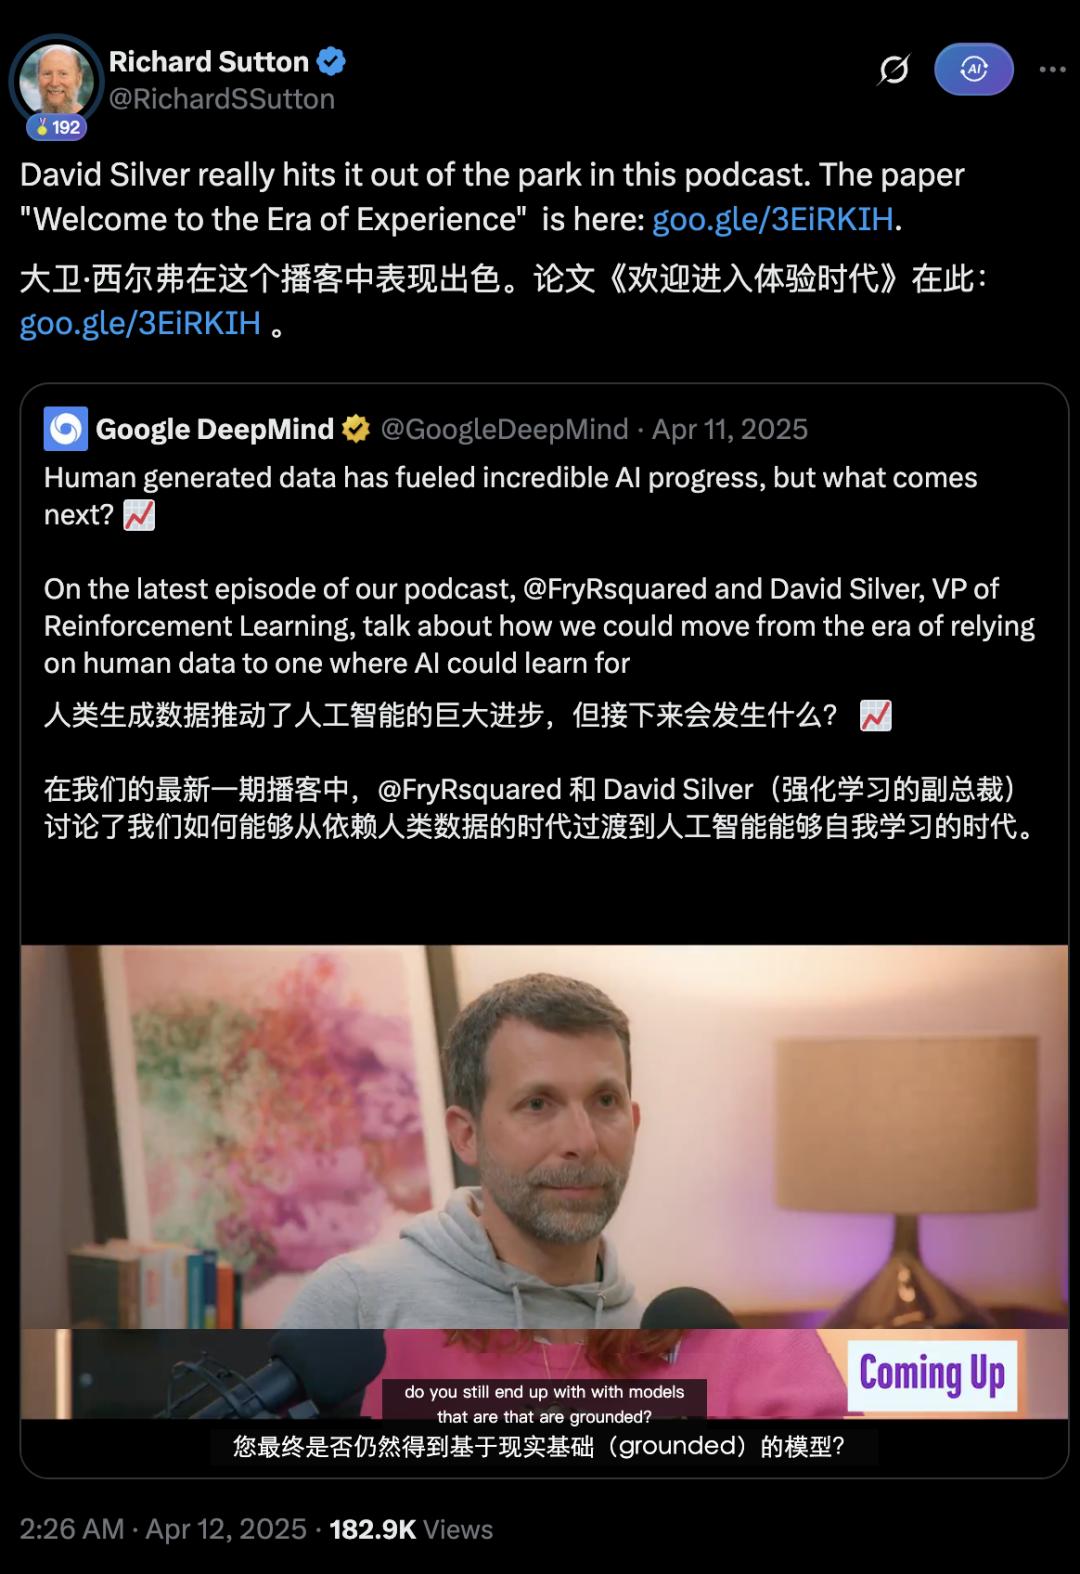
Richard Sutton提出的“经验时代”概念,揭示了当前大模型的根本矛盾:预训练完成后模型即被冻结,无法从真实交互中持续学习。Mind Lab的目标是打造一台“经验智能机器”,使模型能够在部署后继续在真实环境中成长。
在Macaron-V1架构中,LoRA不再仅仅是微调工具,而是成为可写入、可回滚、可独立演化的持久状态。基座模型承载通用知识,而LoRA模块则存储用户的偏好、代码风格和业务逻辑。实验表明,即使将适配模块压缩至基座参数的0.5%以下,系统依然能保持稳定可靠。
这种设计使得模型能够积累并复用经验。例如,用户纠正模型错误后,相关的修正逻辑被写入特定的LoRA模块,后续交互中模型将直接应用这些新能力,而无需重新处理历史数据。这标志着智能从一次性训练结果向持续生长过程的转变。
群体智能与第三条Scaling曲线
Macaron-V1的另一个颠覆性理念是“群体智能”。实验显示,从相同的基座出发,不同的数据顺序和掩码策略会导致模型发展出多样化的能力分布。单个适配器在AIME24测试中的准确率为36.44%,而198个不同适配器的多数投票准确率提升至48.67%。
Andrew将这种现象定义为“第三条Scaling曲线”:随着模型数量的增加,通过协作效应带来智能上限的提升。Mind Lab自建的MinT平台已建立百万级可寻址LoRA目录,意味着百万个独立演化的智能体可以共享同一个万亿参数基座。这种多样性与协作机制,模仿了人类心智通过不同经历形成互补效应的过程。
商业验证:速度与价值的双重认可
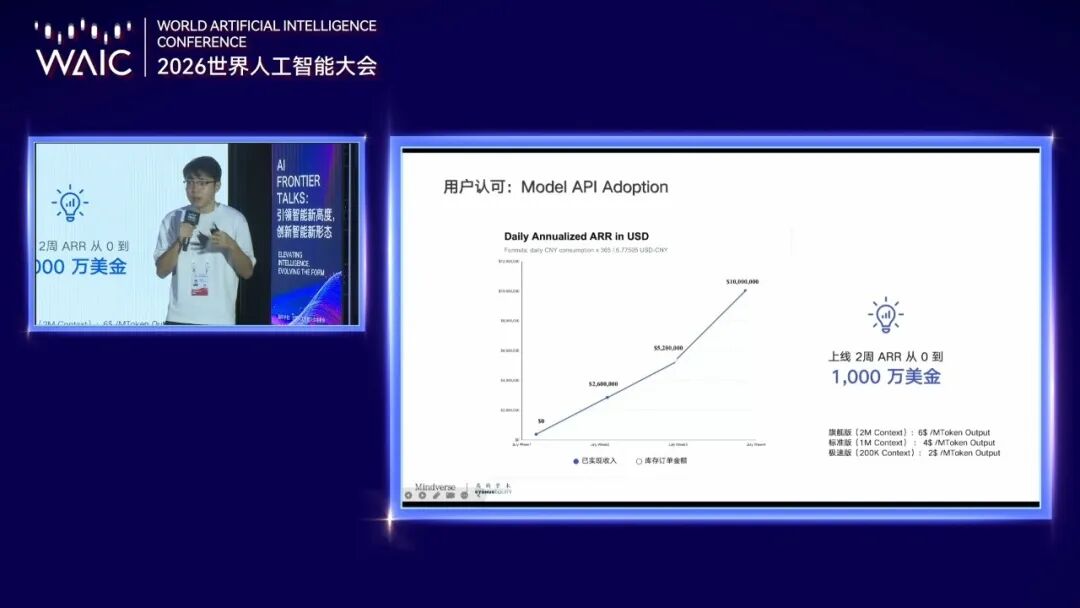
技术的最终落脚点在于市场验证。Macaron-V1开放API仅两周,即实现了1000万美元的年经常性收入(ARR),创下模型公司商业化速度的新纪录。这一数字背后的逻辑在于,客户购买的不仅是Token,更是模型在自身场景中的持续学习能力。
目前的API调用结构中,30%来自Agent工作流,30%来自代码生成,20%为聊天,其余来自GenUI。这种均衡的分布表明,技术已深入多个垂直领域,而非依赖单一爆款场景。韶音科技、头部手机厂商等合作伙伴的接入,进一步证明了其在硬件交互和个性化服务中的实用价值。
结语:持续学习作为新的护城河
AI行业的竞争焦点正从“谁拥有更大的基座”转向“谁能让模型更聪明地持续进化”。预训练是一次性的基础设施投入,而持续学习则是构建长期护城河的关键。
Mind Lab通过站在开源生态的肩膀上,以高效的资源分配实现了技术突破。这不仅展示了中国AI团队在架构创新上的敏锐度,也为全球AI发展提供了新的思路。当模型能够像人类一样从经验中成长,并通过群体协作实现智能跃迁,我们正逐步推开通向真正通用智能的大门。