AMD Helios架构揭秘:2026年AI推理时代,系统级竞争如何重塑算力格局?
从单点突破到系统重构:AI基础设施的新范式
在人工智能基础设施的演进历程中,竞争焦点正经历一场深刻的范式转移。过去几年,市场叙事高度集中于GPU的单点性能突破,但随着大模型从训练阶段迈向大规模推理应用,以及Agent(智能体)技术的爆发,算力需求结构发生了根本性变化。2026年7月24日,AMD在Advancing AI 2026大会上发布的Helios机架级AI平台及第六代EPYC“Venice”服务器CPU,标志着AMD正式将竞争维度从单颗芯片推向系统级吞吐与整体拥有成本(TCO)的较量。
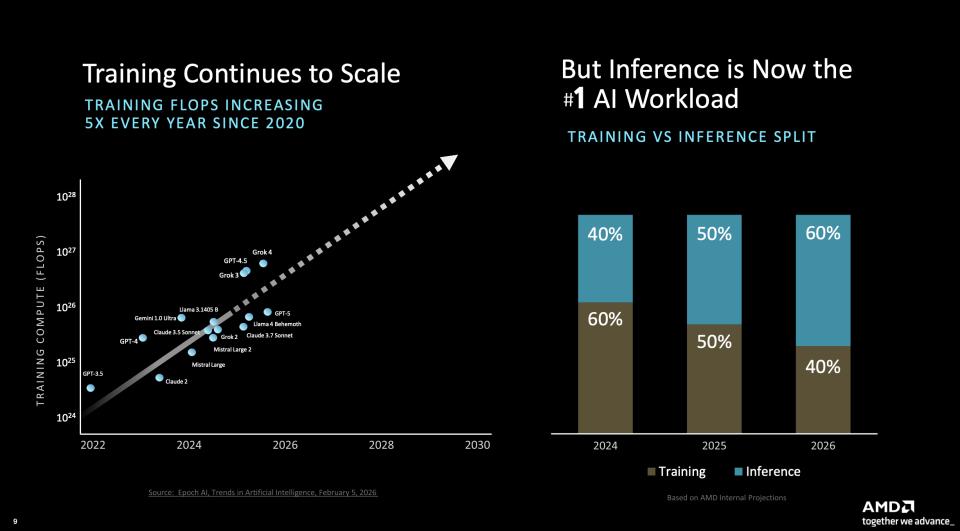
苏姿丰在主题演讲中明确指出,AI计算的重心正在从训练加速转向推理,而Agent将单次模型调用扩展为包含持续推理、工具调用和任务执行的复杂工作流。据AMD预测,2026年全球约60%的AI算力将用于推理。这一趋势意味着,单纯的峰值算力已不足以定义竞争力,如何在固定功耗下实现更高的Token吞吐、更低的单Token成本,以及更高效的系统调度,成为新的核心指标。AMD的战略归纳为“计算领先、开放平台”和“让AI无处不在”,其中Helios平台正是这一战略的核心载体,旨在将GPU、CPU、网络和软件整合为一套完整的AI工厂平台。
Helios架构解析:机架成为新的计算系统
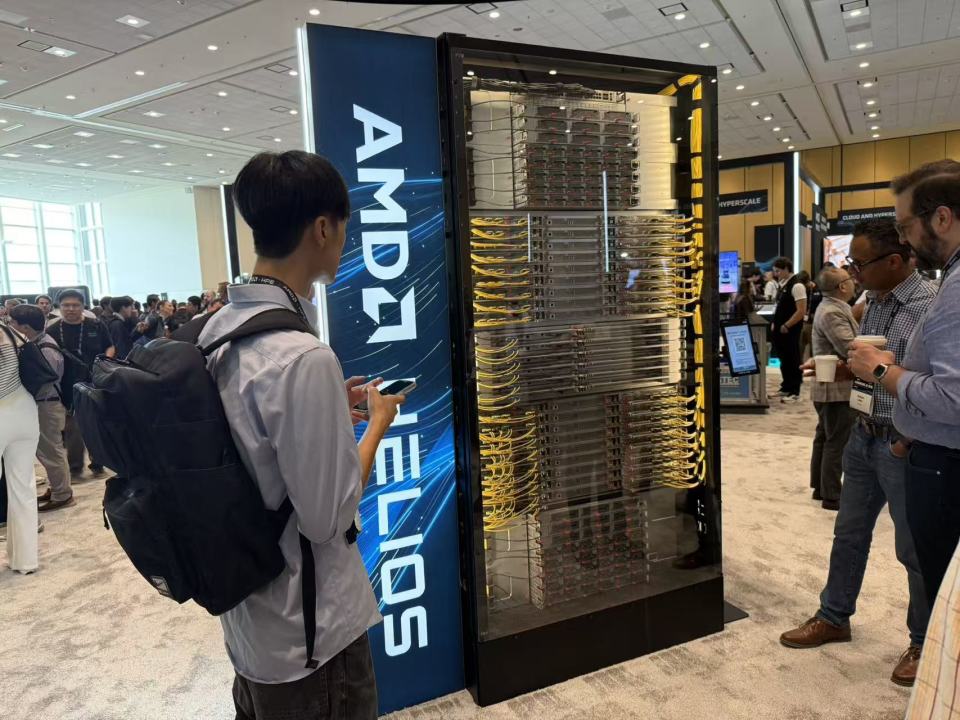
Helios平台的发布,代表了AMD对前沿AI负载需求的直接回应。传统72卡集群通常由9台八卡服务器组成,通过Scale-out网络连接,这种架构存在明显的局限性:每台服务器拥有独立内存,GPU间通信需经过多次网络跳转,容易引入延迟、拥塞和数据局部性约束。Helios通过重新定义系统边界,将72颗Instinct MI455X GPU组织成一个统一的机架级系统,实现了“机架成为新的系统”这一理念。
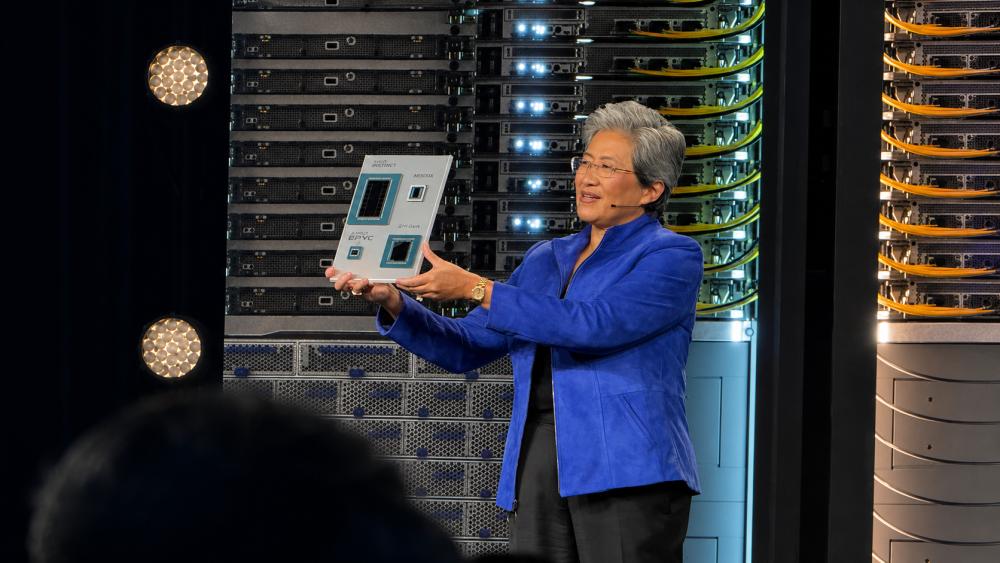
MI455X GPU是Helios的核心组件,其配备432GB HBM4显存,显存带宽达到23.3TB/s,峰值MXFP8算力为20PFLOPS,峰值MXFP4算力为40PFLOPS。与上一代MI355X相比,其显存容量提升1.5倍,带宽提升2.9倍,低精度峰值算力提升4倍。显存容量的扩大对于应对模型参数增长和长上下文推理至关重要,因为推理过程需要长期保存更多权重和KV Cache。在DeepSeek V4 Flash FP4推理测试中,MI455X的Token吞吐最高达到MI355X的34倍,Token成本最高降低18倍。这一数据虽基于预生产硬件,但展示了硬件升级带来的巨大潜力。
Helios系统由18个计算托盘和6个交换机托盘组成,通过UALoE Scale-up Fabric将72颗GPU连接在同一个计算域内,提供约31TB HBM4和260TB/s的聚合Scale-up带宽。这种单跳互连架构消除了传统多跳网络带来的延迟,软件层无需再对网络拓扑和数据局部性进行复杂适配。系统采用多平面Fabric和冗余路径设计,确保在链路或交换节点故障时,流量可自动切换至可用路径,故障被隔离在局部范围内,提升了系统的可靠性。
在CPU与GPU的比例配置上,Helios每个计算托盘采用“1颗CPU+4颗GPU”的配置。AMD回应称,Venice单颗CPU提供的核心数、内存容量和I/O能力足以支撑4颗GPU,这是当前设计下的平衡点。随着Agent负载中CPU编排任务的增加,这一比例能否长期保持充足余量,仍需客户部署验证。此外,Helios的模块化设计支持在机架内完成部分维护,整机架功耗约为225至245kW,兼顾了性能密度与运维效率。
网络分层与Pensando的整合:构建全栈数据路径
Helios的系统工程不仅限于计算单元,还延伸至网络架构的优化。AMD为Helios设计了三层网络体系,分别覆盖服务器入口、机架内部和跨机架集群的数据路径。
第一层是Salina DPU,负责前端网络、存储与安全卸载。Salina通过硬件卸载减少CPU在网络、存储和安全任务上的消耗,并面向长上下文提供KV Cache扩展能力,这对于Agent工作流中的上下文管理至关重要。
第二层是UALoE,承担机架内72颗GPU的Scale-up互连。UALoE将72颗GPU和约31TB HBM4连接在同一Fabric中,提供260TB/s的聚合带宽,确保GPU间数据交换的高效性。
第三层是Vulcano AI NIC,支持多个Helios机架之间的Scale-out扩展。Vulcano支持800G和PCIe 6.0,每颗GPU最高可获得2.4Tbps的Scale-out带宽,确保大规模集群间的数据传输效率。
Pensando网络系统的整合,标志着AMD从独立的云基础设施业务向AI平台核心组成部分的转变。Salina、UALoE和Vulcano的协同工作,使得Helios能够像英伟达的NVLink和InfiniBand生态一样,提供高度一体化的网络体验。然而,AMD的开放架构策略也意味着其需要联合更多合作伙伴共同交付,这在带来硬件选择权和定制空间的同时,也增加了兼容验证和性能调优的复杂度。
Venice CPU:应对Agent工作流的服务器变革
在Helios发布的同时,AMD推出了第六代EPYC 9006系列服务器CPU,代号Venice。苏姿丰指出,Agent带来的计算增量并不只落在GPU上。一个Agent任务包含网关、上下文组装、规划、检索、工具执行、验证和输出等多个环节,其中大量环节运行在CPU上。随着Agent数量从百万级走向十亿级,服务器CPU市场将迎来显著扩张。
Venice产品家族包括四条主要路线:EPYC 9006 SP7面向高核心数和高性能;EPYC 9006 SP8侧重企业场景下的系统性价比;EPYC 9006X SP7面向HPC和AI数据预处理;EPYC 9006 LP“Verano”采用LPDDR内存,面向高性能AI Host Node。Venice最高提供256个核心和512个线程,采用Zen 6架构,支持PCIe 6.0及多种内存配置。
进入Agentic AI时代,CPU的核心密度、内存带宽、虚拟化和I/O能力直接影响任务调度与沙箱并发。AMD官方数据显示,EPYC服务器CPU收入份额已达到46%,每周都有一家Forbes Global 2000企业转向AMD。Venice接下来的竞争不仅来自Intel Xeon,还来自NVIDIA Vera与Arm服务器CPU。随着CPU竞争开始与GPU平台和系统架构绑定,AMD希望通过核心密度、性能功耗和服务器整合能力扩大份额。
ROCm.AI与本地Agent:软件生态与边缘计算的延伸
软件是AMD此次发布中新增的重要看点。AMD正式推出ROCm.AI,这是一个面向开发者的AI驱动平台,旨在降低底层GPU编程与CUDA迁移的复杂度。ROCm.AI在现有ROCm基础软件栈上加入AI辅助能力,用于GPU代码生成、迁移、调试和性能优化,并支持与Cursor、Claude、Codex、Gemini等工具配合。
ROCm.AI的核心目标是让开发者借助AI分析代码、转换CUDA与HIP实现、定位性能瓶颈,并生成优化建议。AMD还重点介绍了FlyDSL,它采用Pythonic DSL,让Python开发者更专注算法表达,减少线程、内存和底层调度等GPU编排工作。AMD披露,Hugging Face上超过300万个模型可以在AMD平台开箱运行,排名前十的开源AI项目已原生支持AMD,相关开源贡献数量增长超过10倍。这些数据体现了ROCm生态的扩展速度,但软件平台的真正竞争力还取决于模型适配时效、算子性能、迁移成本和生产环境稳定性。
在客户端侧,AMD围绕现有的锐龙AI 400、锐龙AI MAX及Ryzen AI Halo开发者平台,展示本地AI推理能力。AMD将本地AI加速归因于数据隐私、降低高频推理Token成本以及断网环境下的可用性需求。锐龙AI 400面向约24B以内的模型,锐龙AI MAX支持更大规模的本地模型。Ryzen AI Halo开发者平台配备最高128GB统一内存,目标能力是原生运行最高约200B参数模型。AMD还预告了代号“Gorgon Halo”的后续平台,统一内存将提升至192GB,本地模型规模上限扩大至约300B。
企业级Agent是AMD推动本地AI落地的另一重点。AMD与思科联合展示了一套端侧全栈方案,将锐龙AI Halo硬件、Lemonade本地推理、模型路由和Agent沙箱,与思科的网络、安全、策略控制及可观测能力结合。企业可据此限制Agent访问范围、统一执行安全策略,并持续跟踪推理成本、Token效率和实际使用情况。由此,AMD希望将个人设备从调用云端AI的交互终端,升级为能够在本地承载模型、运行Agent并接受企业统一治理的计算节点。
Physical AI:芯片、模块、软件与生态的协同落地
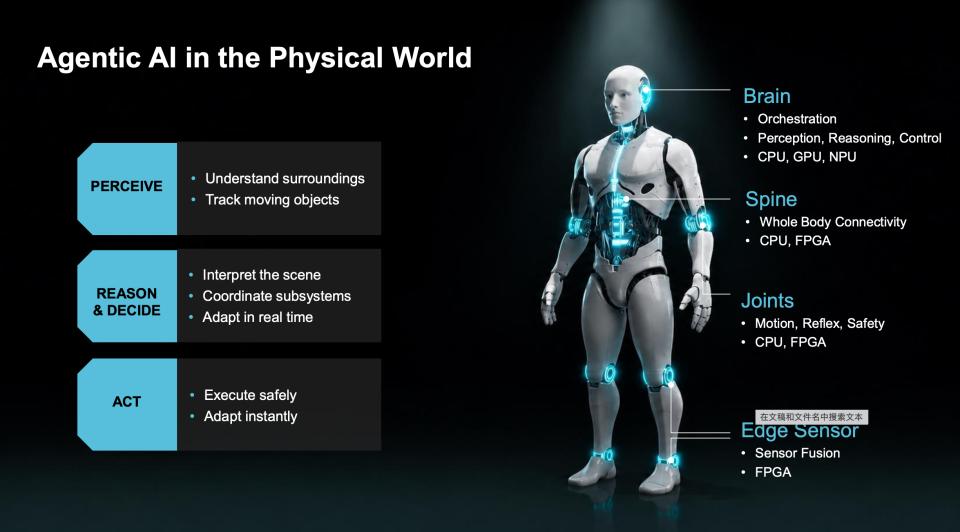
在Physical AI领域,AMD发布了五项内容,覆盖机器人计算从芯片到生态的多个层级。第一项是Ryzen AI Embedded X100系列,将CPU、GPU和NPU集成到同一平台,面向机器人感知、推理、规划和控制,目前已进入送样阶段。
第二项是基于X100系列的Kria AI System-on-Module,采用120×120毫米COM-HPC开放标准形态,集成CPU、GPU、NPU和统一内存,面向量产机器人。测试示例包括低于100毫秒的VLA推理、125微秒的实时控制循环和低于0.4毫秒的视觉分类。
第三项是Kria AI Robotics Developer Platform,被称为“业界首个开放、交钥匙、一体化机器人开发平台”,用于整合计算硬件、传感器、软件和参考系统,计划于2026年第四季度可用。
第四项是AMD Robotics Software Suite,包括Robotics Core SDK、Physical AI SDK、加速ROS节点、MoveIt 2,以及音频、操控等优化模块。它基于ROCm与HIP,强调从云端到机器人使用统一的AI软件栈,目前处于Early Access。
第五项是AMD Robotics Partner Network,首批包括30多家伙伴,覆盖机器人OEM和ODM、AI模型、传感器、中间件、仿真、数字孪生与系统集成。至此,AMD在Physical AI领域形成了芯片、量产模块、开发平台、软件和合作伙伴网络的基本结构,与数据中心侧的策略保持一致:用异构计算覆盖不同任务,再用开放软件和伙伴体系完成系统集成。
结语:开放架构的挑战与机遇
过去几年,AI基础设施的叙事高度集中在GPU。推理和Agent正在重写AI的范式和算力的账单,属于GPU的阶段正在过去。市场评价基础设施的方式也随之变化:从单颗芯片性能,转向每机架吞吐、单位Token成本、集群利用率和故障容忍能力。竞争单位从一颗GPU变成一整个机架,甚至一座数据中心。
英伟达早已看到这一点,把GPU、CPU、互连、网卡、DPU、交换机和CUDA组织成高度一体化平台。Vera Rubin NVL72代表的不只是性能,更是系统控制力。客户买的也是性能确定性、软件兼容性和部署速度。
AMD选择的路径是开放架构,对头部客户而言,这意味着更大的硬件选择权、更强的定制空间,以及重新获得议价能力。但开放的优势伴随更高的执行难度,AMD需要联合芯片、服务器、网络、云平台和软件伙伴共同交付。开放标准扩大生态,却不自动带来效率,比如兼容验证、性能调优等都会因参与方增加而更复杂。
与此同时,推理占比上升让“价格”重新变得敏感。训练时代客户为最强性能支付溢价,因为更短训练周期直接决定发布时间,Agent时代的采购逻辑更接近长期运营,模型每天持续运行,Token规模越大,成本越敏感。AMD把核心指标放在Tokens/$上,正是抓住这一窗口。
硬参数已经足够亮眼,但是AMD眼下真正的挑战,是这套“系统级架构”的实际运行能力,ROCm需要继续缩小与CUDA之间的迁移使用成本,Helios也需要逐渐把头部客户参与共创的经验沉淀下来,变成更多客户可以直接采用的标准化方案。这也是Advancing AI 2026之后更值得观察的部分。