00后团队挑战硅谷巨头:Macaron-V1如何用LoRA重构AI持续学习范式
风向转变:从预训练到持续学习的范式转移
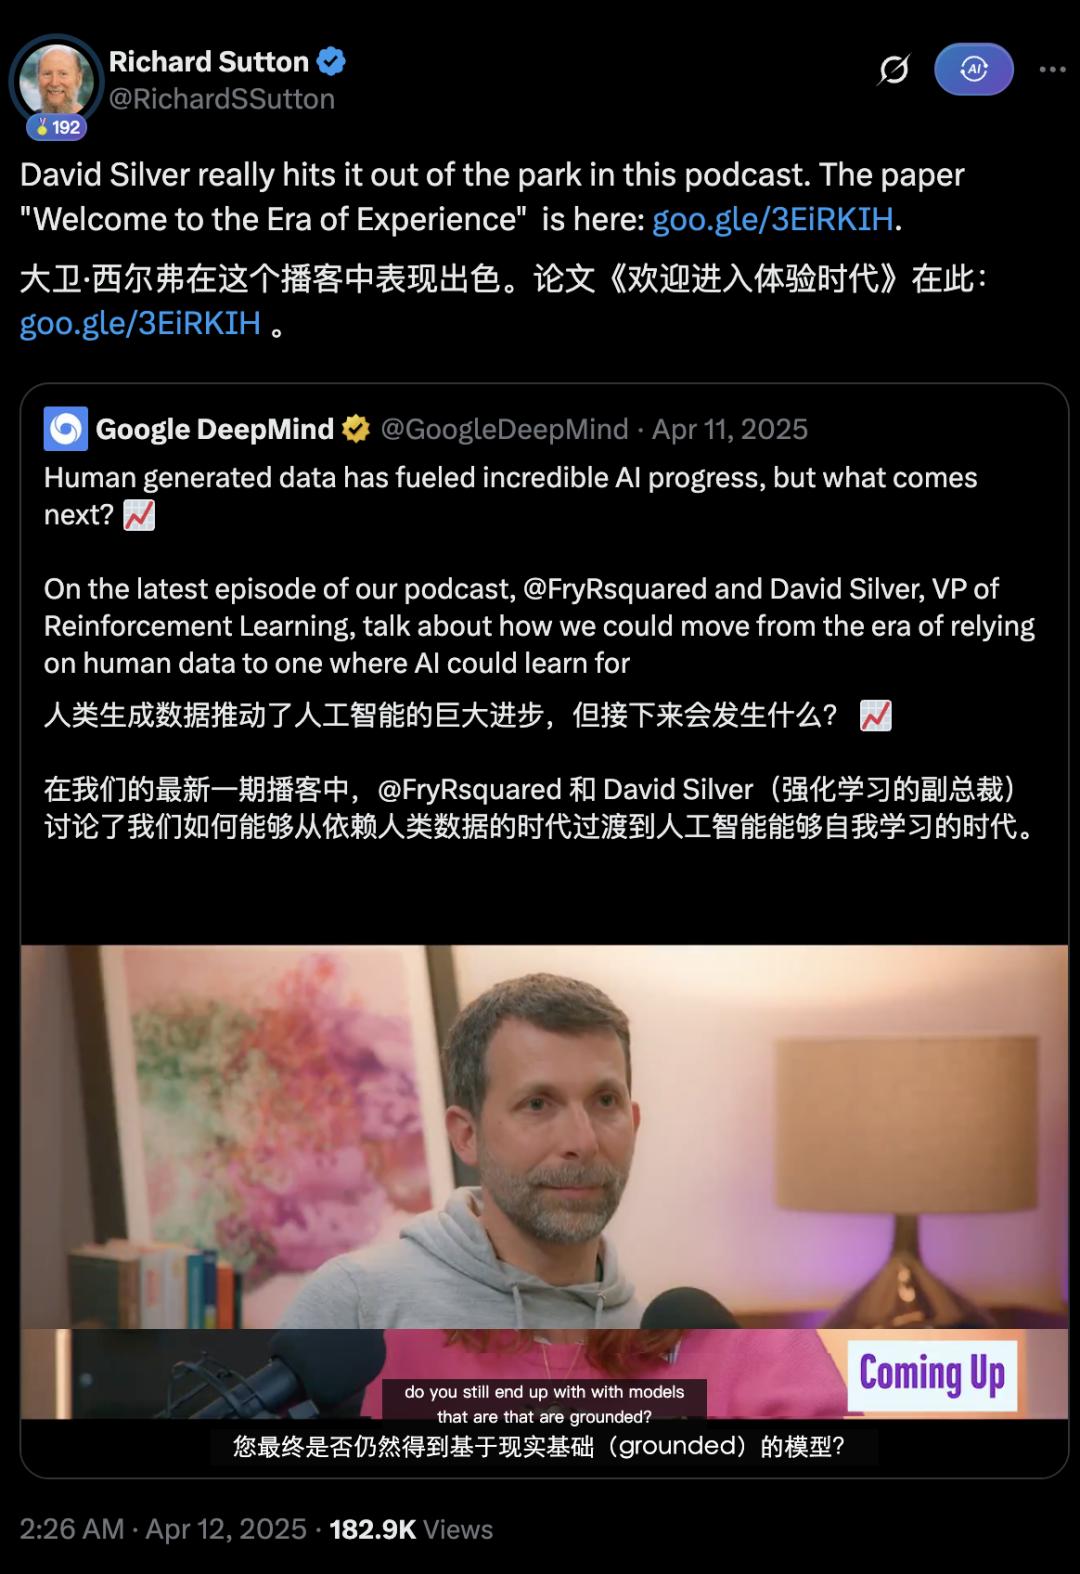
当前人工智能领域正经历一场深刻的底层逻辑重构。过去两年,行业焦点集中在通过海量数据预训练来堆砌模型参数规模,试图以此换取智能水平的线性提升。然而,随着DeepSeek创始人梁文锋、强化学习之父Richard Sutton以及前OpenAI CTO Mira Murati等顶尖专家不约而同地指向同一个方向——持续学习,行业共识正在形成:下一代通用智能的核心,不在于模型“知道”多少静态知识,而在于其能否在部署后通过交互不断进化。
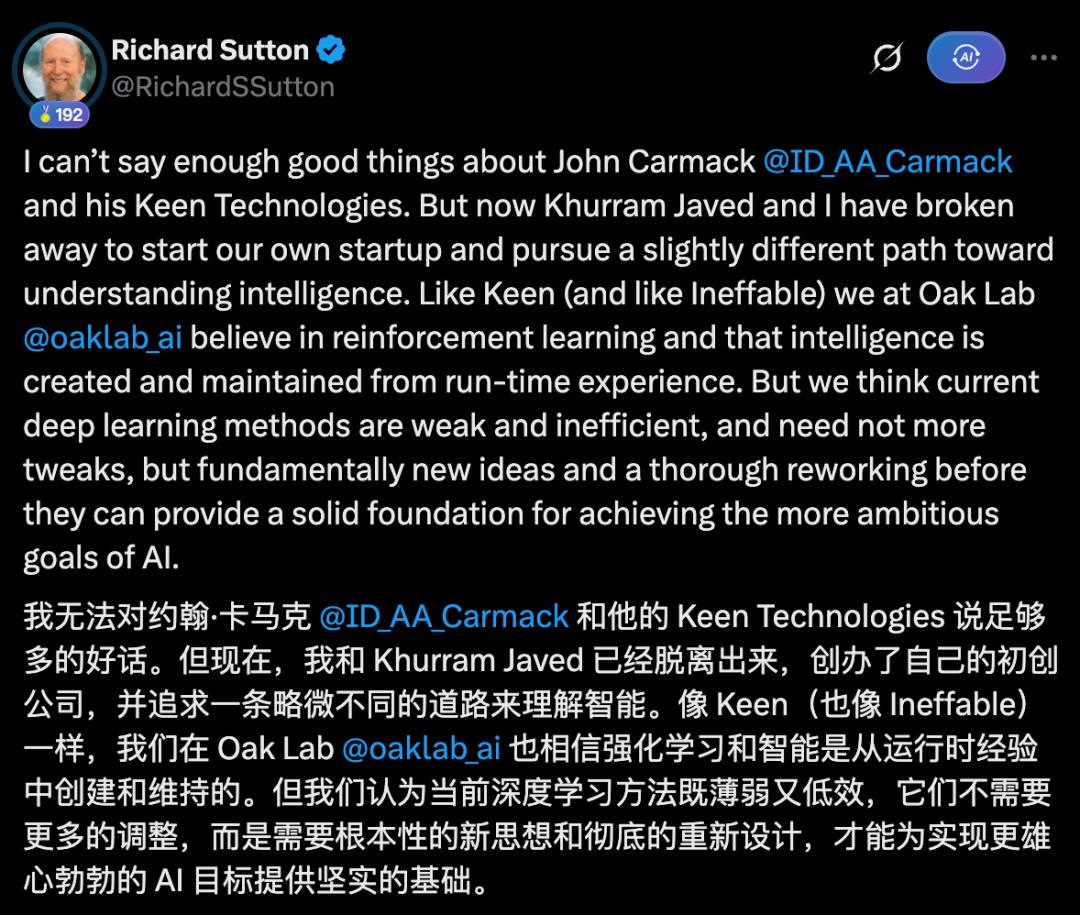
这一技术路线的转向并非偶然。Richard Sutton明确指出,当前的深度学习框架存在脆弱性和低效性,需要从根基上重新设计。梁文锋则将AI发展比作攀登台阶,认为Agent之后的关键一步是赋予模型持续学习的能力。当这一判断同时被图灵奖得主、硅谷顶级创业公司以及中国最具创新力的模型创始人所印证时,它已不再是一种技术选项,而是行业进化的必然路径。
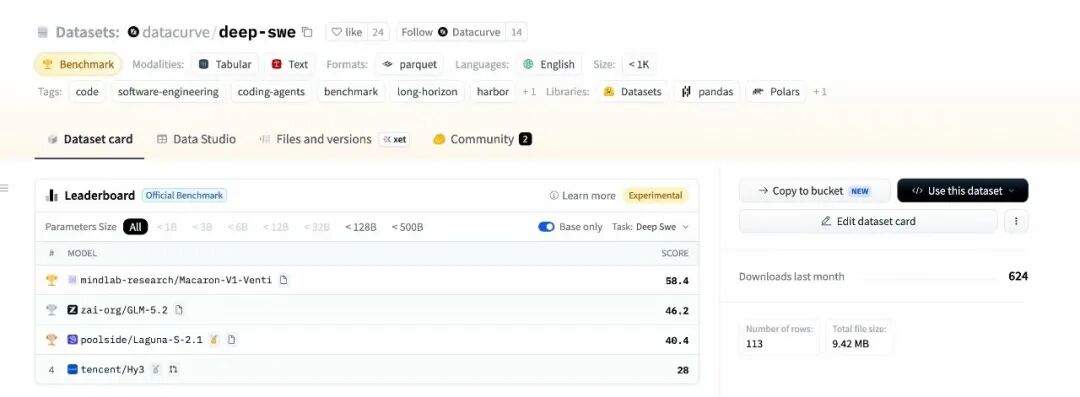
在这种背景下,太平洋彼岸的一家年轻实验室Mind Lab,悄然交出了一份令人瞩目的答卷。其发布的Macaron-V1模型,不仅在多项硬核评测中追平甚至超越了Opus 4.8、GPT-5.5等闭源巨头,更在技术路线上提供了一种极具性价比的替代方案。这标志着AI竞争的重心,正从“谁拥有最大的底座”转向“谁能让模型在真实世界中持续变聪明”。
架构创新:Mixture-of-LoRA打破能力冲突
Macaron-V1的核心创新在于其独特的架构设计:Mixture-of-LoRA(MoL)。传统观点认为,LoRA(低秩自适应)只是全参数微调的廉价替代品,但在Mind Lab的实践中,LoRA被重新定义为模型“个性”的载体,而基座模型则承载“共性”。
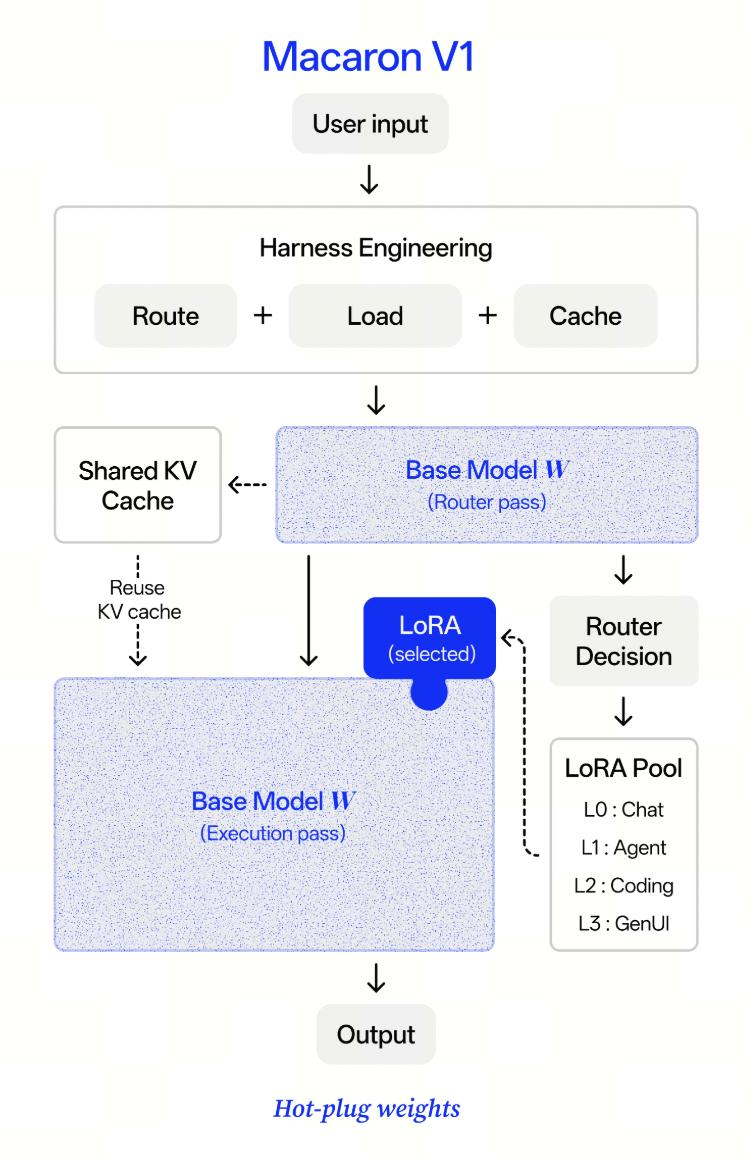
这种设计解决了多任务模型训练中的经典难题:不同任务之间的参数冲突。例如,聊天需要共情与灵活性,编程需要严谨与逻辑,Agent需要多步规划能力,而生成式UI则需要设计交互感。将这些能力强行融合在一个参数空间中,往往导致性能折损。Macaron-V1采用“拆”的策略,将旗舰版Venti(748B参数)的基座与四个独立的1B LoRA模块结合,分别负责聊天、Agent、编程和GenUI。
在运行时,系统通过动态路由器根据用户意图切换相应的LoRA模块。这种机制不仅实现了能力的解耦,还允许各个模块独立训练、评测和回滚,互不干扰。这种“专才协同作战”的模式,使得模型在保持通用基座强大能力的同时,能够在特定垂直领域达到专家级水平。
技术突破:万亿参数下的训推一致性难题
在万亿参数规模的MoE(混合专家)模型上实施LoRA强化学习,是全球AI界公认的“无人区”。其核心难点在于“训推不一致”:强化学习需要一边训练一边推理以收集反馈,当模型被切片分布到数十张GPU上时,训练精度与推理精度的微小偏差会导致梯度漂移,进而使训练曲线无法收敛。
Mind Lab之所以能在此领域取得突破,得益于其在Kimi K2(1.04万亿参数)上积累的深厚技术底蕴。通过优化训练环境与生产环境的一致性(Model and Harness共设计),Mind Lab确保了模型在训练时调用的工具接口、执行流程与上线后完全一致。配套的REPL Harness允许模型保存中间状态、复用有效流程,大幅减少了重复调用和上下文浪费。
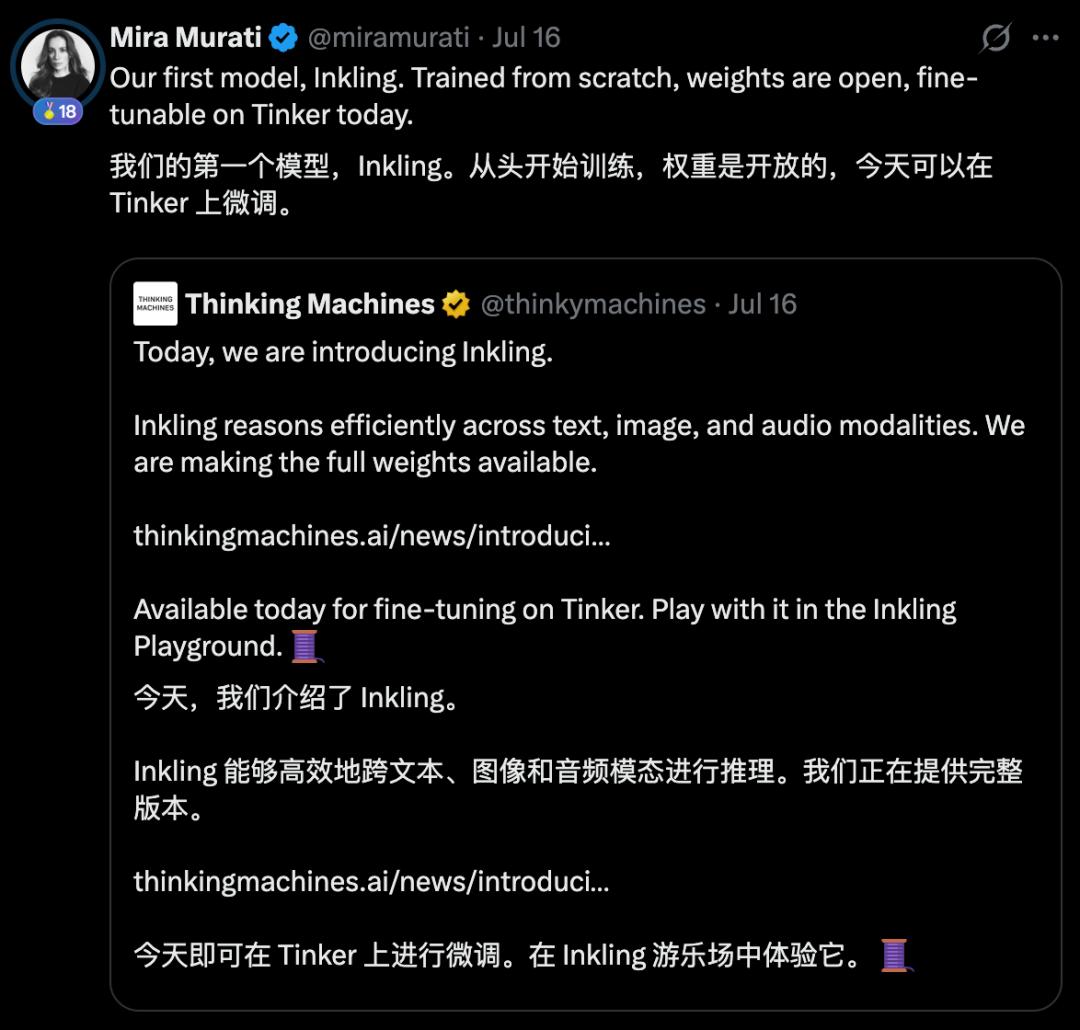
目前,全球能在万亿参数规模上稳定跑通LoRA强化学习的团队仅有两家:Mind Lab和Mira Murati的Thinking Machines Lab。这一技术壁垒的突破,意味着AI模型终于具备了在大规模参数空间内进行高效、稳定持续学习的可能性。
生态策略:站在开源巨人肩膀上的高效主义
与Thinking Machines Lab选择从零开始训练975B参数的Inkling模型不同,Mind Lab采取了截然不同的底座策略。TML投入20亿美元融资、100人精英团队及千兆瓦级算力,却仍面临模型能力落后于中国开源模型的困境。
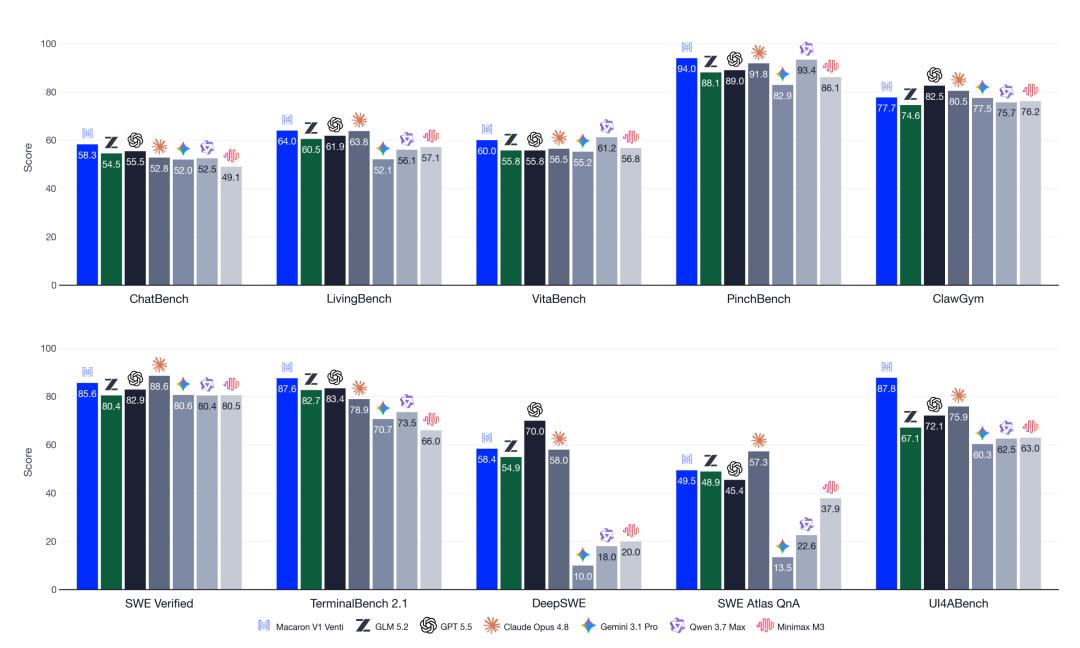
Mind Lab则选择直接基于中国顶尖的开源模型生态进行后训练。其旗舰版基于GLM-5.2,标准版基于Qwen-3.7。这种“站在巨人肩膀上”的策略,使得Mind Lab仅用不到5000万美元融资和30多人的团队,就实现了与硅谷百亿级团队同水位的技术能力。
这种策略的优势在于极高的投入产出比。中国开源模型如GLM、Kimi等已在全球范围内接近SOTA(当前最佳)水平。Mind Lab无需重复造轮子,而是专注于通过LoRA强化学习,将这些接近天花板的底座推向真正的SOTA。正如比喻所言:“你不必自己种麦子,就能烤出最好的面包。”
持续学习:构建“经验智能机器”
Macaron-V1的发布,实质上是向“经验智能时代”迈进的关键一步。传统大模型在预训练结束后即被“冻结”,无法从用户的反馈中汲取经验。而Mind Lab的目标是打造一台“经验智能机器”,使模型在离开实验室后,仍能在真实环境中通过交互持续学习。
LoRA在此过程中扮演了关键角色。它不仅是微调工具,更是可写入、可回滚、可独立演化的持久状态。基座模型存储通用知识,而LoRA模块则存储用户的偏好、代码风格及业务逻辑。实验表明,轻量级适配模块压缩到基模参数的0.5%以下,仍能保持稳定可靠。这种机制使得模型能够像人类一样,通过积累经验来不断提升解决复杂问题的能力。
群体智能:探索第三条Scaling曲线
除了持续学习,Macaron-V1还揭示了群体智能的巨大潜力。当多个模型实例基于相同基座但不同经历进行持续学习时,它们会演化出多样化的能力分布。这种多样性并非Bug,而是Feature。
实验数据显示,从相同的Qwen3-30B基座出发,198个不同Adapter通过多数投票,在AIME24评测中的准确率(48.67%)显著高于单个Adapter(36.44%)或同一Adapter重复采样(43.78%)。这证明了多样化学习路径之间产生了真正的协作效应。
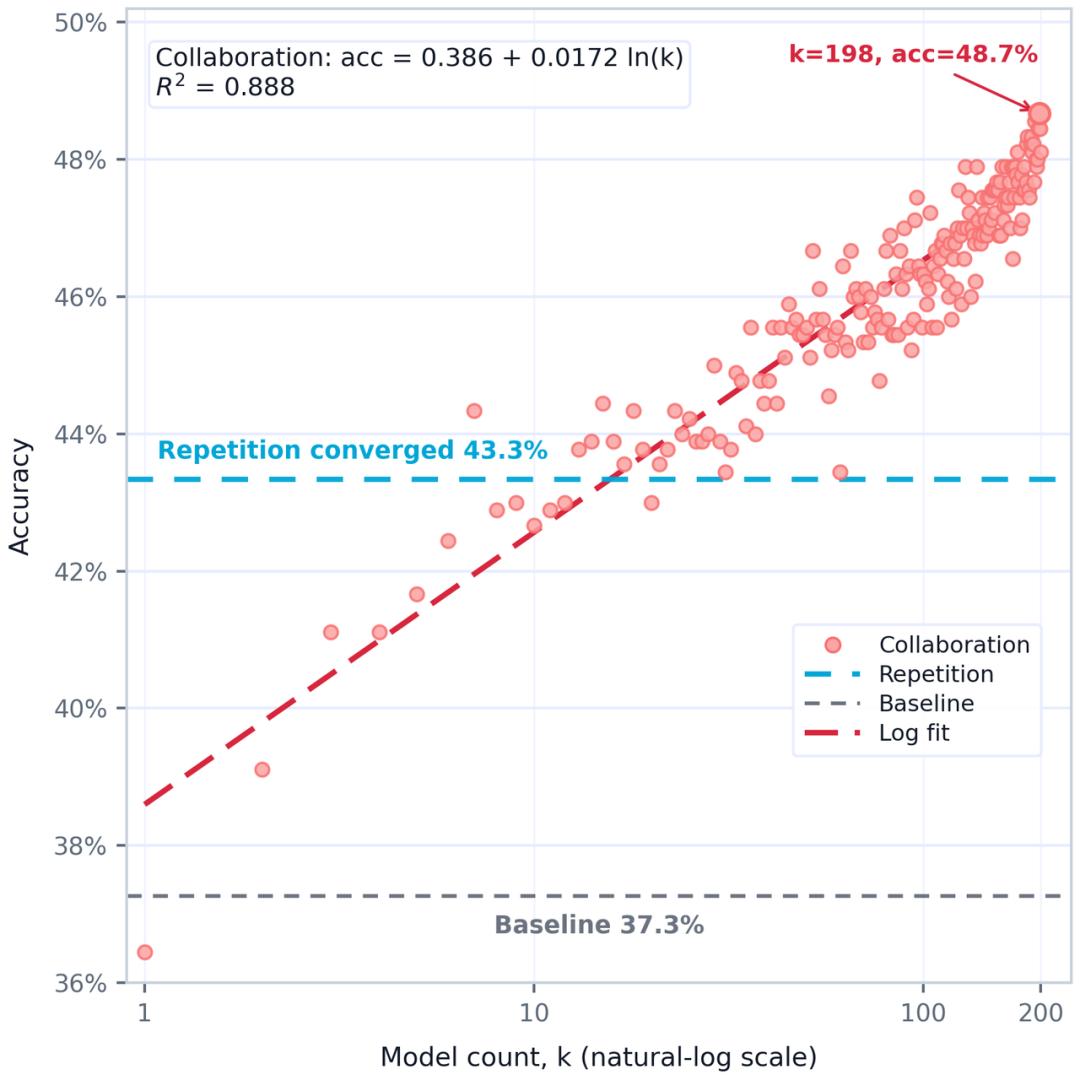
Mind Lab创始人Andrew将其定义为“第三条Scaling曲线”:第一条是参数规模扩展,第二条是推理Token扩展,第三条则是模型数量扩展。通过MinT平台,Mind Lab已建立百万级可寻址LoRA目录,实现了百万个LoRA共享同一个万亿参数基座。这种“百万个一万亿参数大模型”的协作模式,为突破现有智能上限提供了全新路径。
商业化验证:极速变现与技术落地
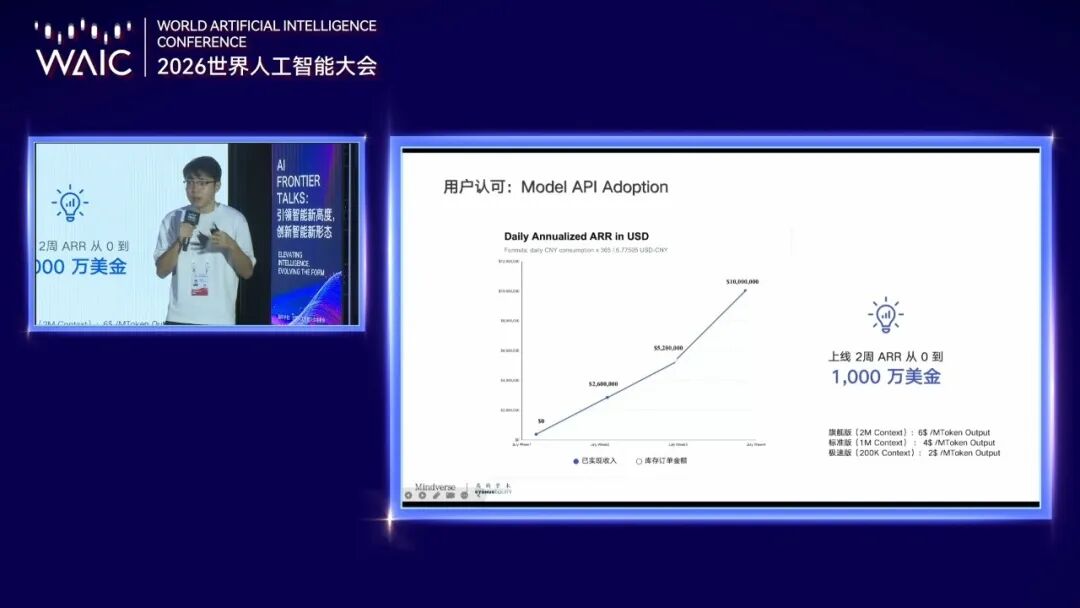
技术的先进性最终需由市场验证。Mind Lab在7月初开放API商业化,短短两周内即实现1000万美元ARR(年度经常性收入),创下模型公司最快商业化记录。这一速度证明了持续学习技术解决的是真实痛点。
客户购买的不仅是Token,更是模型在自身场景中持续迭代的能力。例如,手机厂商可将产品知识训练进专属LoRA,耳机公司可将交互偏好写入模型状态,核心数据无需离开本地,既保障了隐私又实现了个性化。目前,韶音科技、AI硬件初创Odyss及某头部手机厂商已加入合作名单。
API调用结构显示,20%为聊天,30%为Agent工作流,30%为代码生成,其余来自GenUI。这种均衡的场景分布,表明该技术并非依赖单一爆款,而是具备广泛的适用性。旗舰版6美元/百万Token,标准版4美元,极速版2美元的定价策略,也体现了其高性价比优势。
结语:推开智能进化的新门
Richard Sutton在多伦多呼吁进入“经验时代”,梁文锋强调持续学习是下一代模型的必要条件,Mira Murati在旧金山搭建万亿参数LoRA基础设施。尽管路径不同,但行业巨头们正共同押注同一个未来:模型应在部署后继续学习,而LoRA是实现这一愿景的关键技术。
Mind Lab作为这条赛道上最年轻的选手,以极高的效率推开了这扇门。它证明了在AI竞争中,真正的护城河不在于预训练时的算力堆砌,而在于部署后的持续进化能力。当足够多的智能体在真实世界中协作、学习、成长,一条通向更高智能的新路线已然打开。这不仅是技术的胜利,更是AI发展范式的一次深刻跃迁。