真实工作流数据:AI训练新范式与企业自研模型的战略抉择
在人工智能发展的早期阶段,互联网上浩如烟海的公开文本构成了大语言模型训练的基石。然而,随着模型参数规模的指数级增长,高质量公开数据的枯竭已成为制约AI进一步进化的瓶颈。当前,行业焦点正迅速转向一座尚未被充分开采的金矿:企业真实工作流中产生的数据。这种被称为Real-world Data的资源,不仅记录了最终结果,更完整保留了人类专家在解决复杂问题时的思维路径、工具调用序列以及试错过程。这一转变标志着AI训练范式从“阅读互联网”向“观察并模仿人类工作”的根本性迁移。
数据市场的本质是一场永不停歇的冲浪运动。每当模型能力突破一个临界点,最有价值的数据形态就会发生剧烈演变。过去几年,我们见证了从自动驾驶标注到专家知识问答,再到如今真实工作流数据的迭代。早期的数据供应商主要依赖人工构造任务,即Type 2数据,通过雇佣领域专家在沙盒环境中完成指定动作来生成训练集。这种方式在模型能力爬坡初期效果显著,但随着模型处理长程任务能力的增强,其局限性日益暴露。人工构造的环境往往缺乏真实世界中的历史状态、组织规则和意外分支,导致模型在面对复杂现实场景时泛化能力不足。
相比之下,Type 1数据直接捕获自真实工作过程,如代码提交记录、客户沟通日志或内部协作流程。以GitHub为例,Commit message、Issue讨论与代码修改串联起来,完整还原了一个技术问题从发现到解决的全生命周期。这种数据不仅包含动作本身,更隐含了行动背后的意图与上下文逻辑。然而,纯粹的Type 1数据获取难度极大,涉及隐私合规与数据清洗等多重挑战。因此,当前市场的主流趋势是向Type 1.5形态过渡,即在保留真实工作流特征的基础上,通过工程化手段增强数据的可训练性。这要求数据公司不仅要具备运营能力,更要拥有深厚的技术底蕴,能够设计多层自动化质检体系,确保数据在规模化生产中的质量稳定性。
在评估数据价值时,Hillclimbability(爬坡能力)是一个关键指标。许多数据供应商倾向于设计模型完全无法完成的任务以展示其独特性,但这并非有效的训练策略。真正有价值的数据应卡在模型能力的边界上,使得模型在经过一定次数的尝试后能够逐步掌握规律。例如,如果模型在32次尝试中有30%的概率成功,说明该任务具有极高的训练价值;若尝试256次仍无一次成功,则表明任务远超当前能力或存在定义缺陷。这种精细化的数据筛选机制,要求供应商具备敏锐的Data Taste和Research Taste,能够准确判断模型当前的瓶颈所在,并提供针对性的数据供给。
随着训练范式的转变,强化学习(RL)环境的重要性愈发凸显。RL环境不仅是模型执行任务的场所,更是其获取反馈、优化策略的关键界面。传统的RL环境多局限于单一沙盒,而新一代环境正朝着空间扩大、工具动态化、组织结构复杂化的方向演进。Agent不再孤立行动,而是需要在多个系统间穿梭,调用不确定的外部工具,甚至协调多个子Agent共同完成任务。这种复杂性对奖励机制提出了更高要求,不仅要看结果是否正确,还要考量时间成本、资源消耗以及流程的合理性。
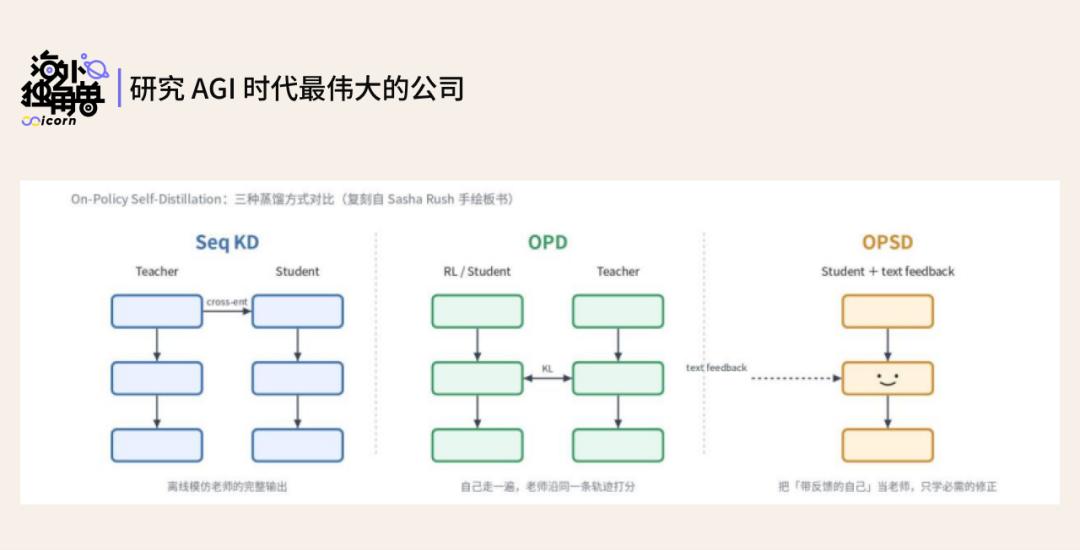
Jason Wei提出的Verifier's Law指出,任务的可验证性决定了AI学习的难易程度。代码编写之所以成为RL的首选场景,是因为其环境易于复制、并行和重置,模型可以通过海量试错快速积累经验。然而,在销售、管理、法律等真实世界场景中,反馈稀疏且不可重复,模型难以通过暴力刷题提升能力。这就引出了提升样本效率的两条重要路径:OPSD(On-Policy Self-Distillation)和Dreaming。
OPSD是一种经验压缩机制,旨在将长期交互中形成的隐性知识转化为显性的训练信号。通过让熟悉特定组织上下文的“老员工模型”指导基础模型,可以蒸馏出更高效的决策策略,而非简单复述历史对话。这种方法能够将稀疏的最终反馈转化为密集的过程监督,显著提升学习效率。而Dreaming则借鉴了人类的反思机制,模型在真实交互结束后,基于内部世界模型进行大量模拟推演,探索不同策略下的潜在结果。这种内部模拟不仅增加了训练样本的数量,更帮助模型建立起对因果关系的深层理解,从而在少量真实数据的情况下实现能力的快速迁移。
面对这一趋势,企业是否应该自建模型并进行Post-training成为战略决策的核心议题。通用模型虽然强大,但往往无法契合企业的独特偏好与业务规则。例如,客服场景中,企业可能希望模型在特定情况下拒绝退款请求,这与通用模型的顺从倾向相悖。此外,成本考量也是推动企业自研的重要动力。对于高频使用的垂直应用,依赖外部API意味着将利润拱手让人,且面临算力成本波动的风险。通过Post-training,企业可以用一次性资本支出替代长期的运营支出,实现成本结构的优化。
判断是否进行Post-training,需综合评估四个乘数:数据独特性、评估清晰度、任务频率与单次改善价值。只有当这四个维度均具备显著优势时,自研模型才具有经济可行性。以DoorDash为例,其菜单录入任务具有高度独特的内部规则,且发生频率极高,通过RL微调小模型不仅提升了准确率,还大幅降低了推理成本。应用公司在这一过程中拥有天然优势,它们占据用户工作流入口,能够低成本获取高质量的Agentic轨迹数据,这些数据在外部市场上极其昂贵且稀缺。
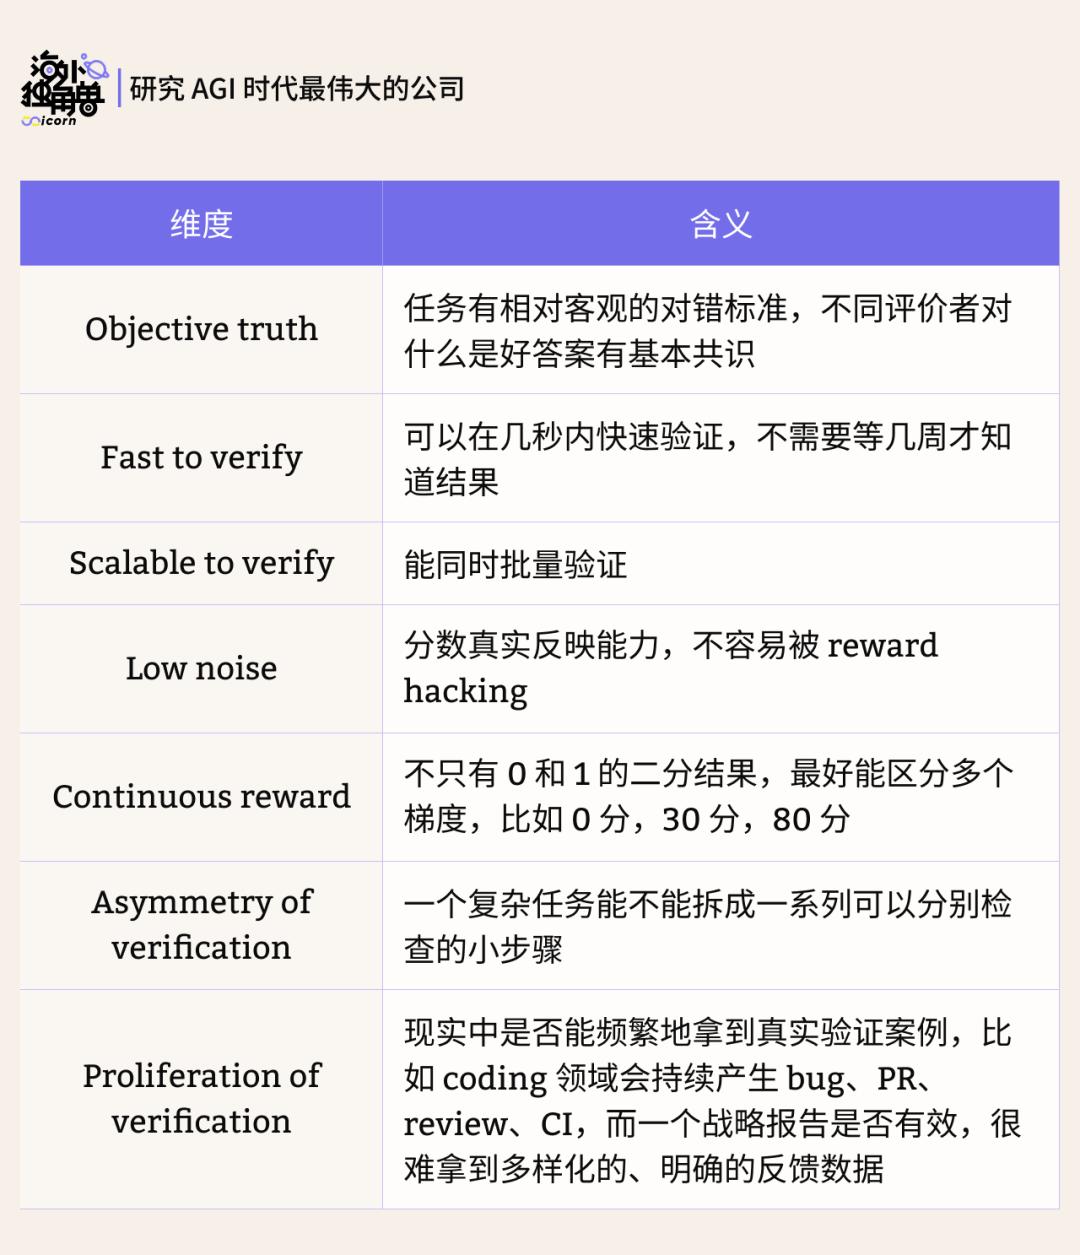
值得注意的是,除了代码领域,其他垂直领域的Agentic数据同样蕴含巨大价值。即使用户行为缺乏明确的硬奖励信号,也可以通过对比学习等方法提取偏好信息。例如,用户对结果的接受与否、修改幅度大小、以及不同实现路径的成本差异,均可转化为有效的训练信号。这些数据不仅有助于提升模型在特定任务上的表现,更能帮助企业构建起难以复制的竞争壁垒。
未来,数据供应链将更加细化和专业化。我们将看到更多专注于数据中介、专家网络以及环境生成的新型公司出现。对于创业者而言,单纯依靠人力堆砌的数据服务模式窗口期正在关闭,唯有通过技术手段实现数据生产的自动化与规模化,才能在激烈的市场竞争中立足。对于企业而言,拥抱真实工作流数据,不仅是提升AI应用效能的手段,更是重塑业务流程、挖掘数据资产价值的战略机遇。在这场AI超级周期中,谁能更高效地将真实世界的工作流转化为模型可理解的智慧,谁就能掌握下一个时代的主动权。