AI包揽IMO满分:硅基智能如何重构逻辑推理与行业未来
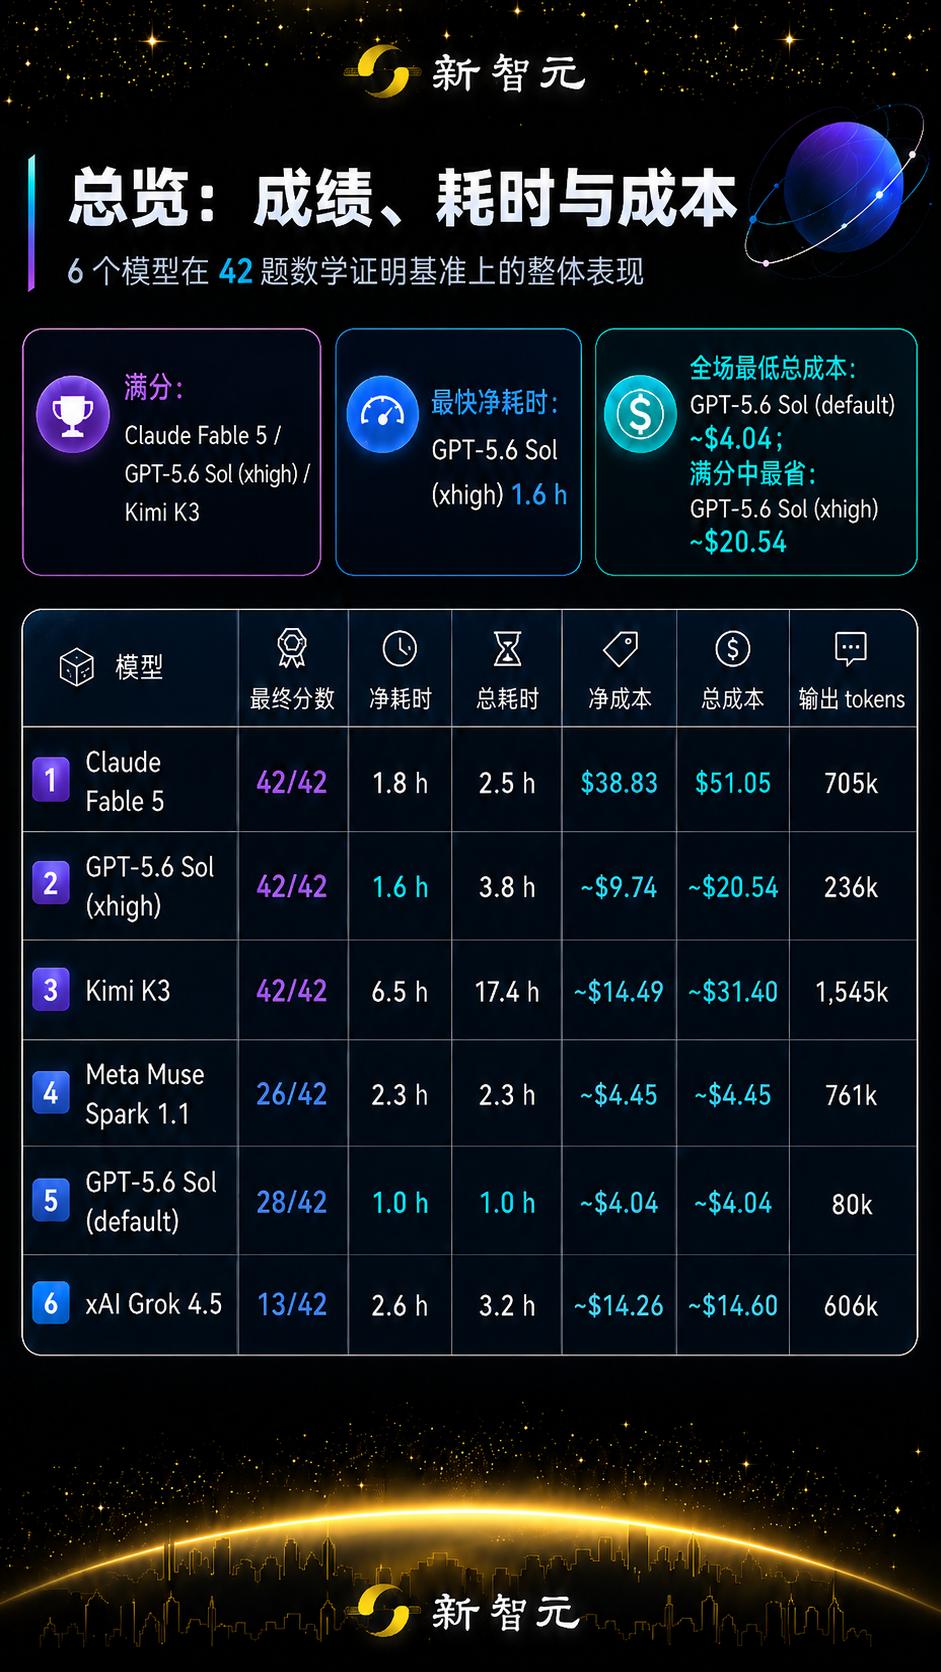
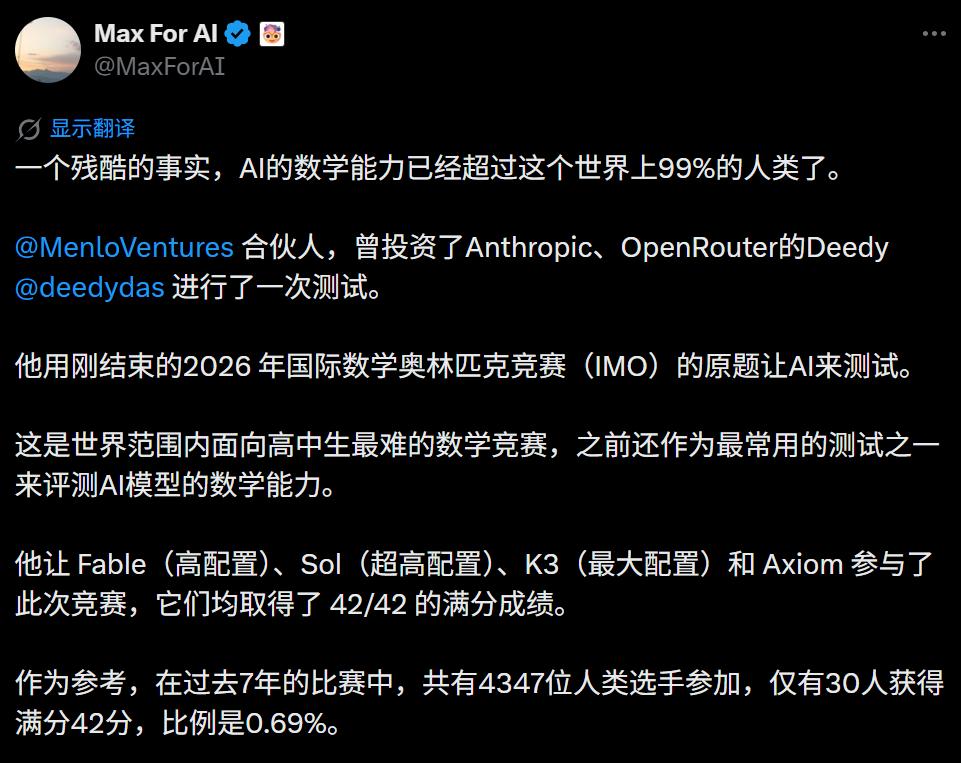
在2026年7月的上海,热浪不仅席卷了街头,也冲击着全球科技界的认知底线。当第67届国际数学奥林匹克(IMO)的中国队少年们以232分的高分捧起桂冠时,另一场无声却更为震撼的竞赛已在数字世界落幕。GitHub上的一份评测报告揭示了一个令人战栗的事实:包括Claude Fable 5、GPT-5.6 Sol以及Kimi K3在内的多个前沿大模型,在全自主状态下独立完成了IMO全部六道试题,并全部斩获42分满分。这一成就并非偶然,而是硅基智能在逻辑推理领域实现“三级跳”后的必然结果。
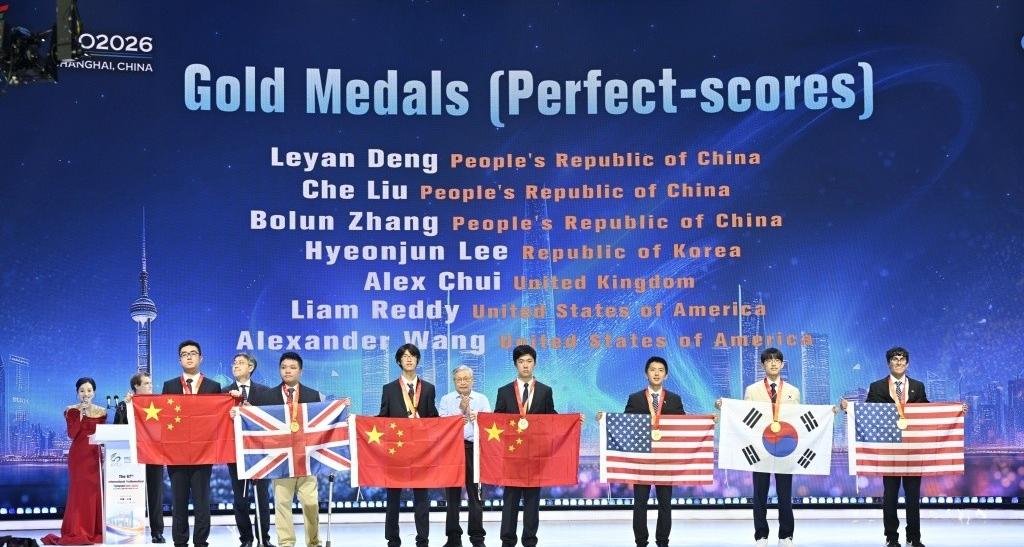
回顾过去七年,共有4347名人类顶尖选手参与IMO,其中仅有30人获得满分,比例低至0.69%。而此次AI的集体登顶,不仅意味着分数上的碾压,更代表了思维路径的根本性分歧。这种分歧体现在解题效率、资源消耗以及核心算法策略上,为我们理解下一代人工智能提供了绝佳的样本。
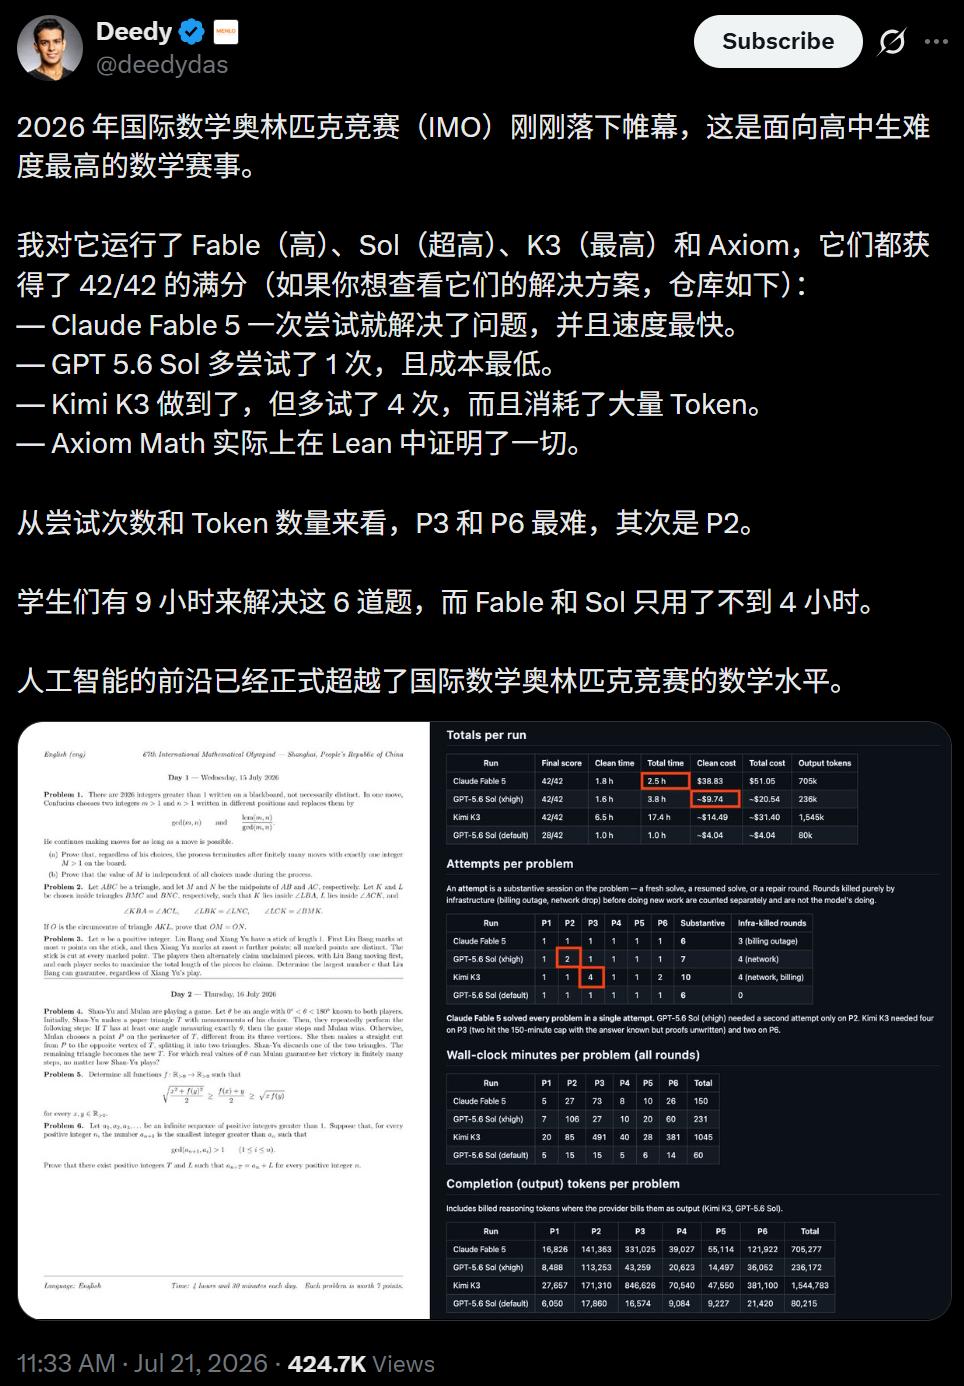
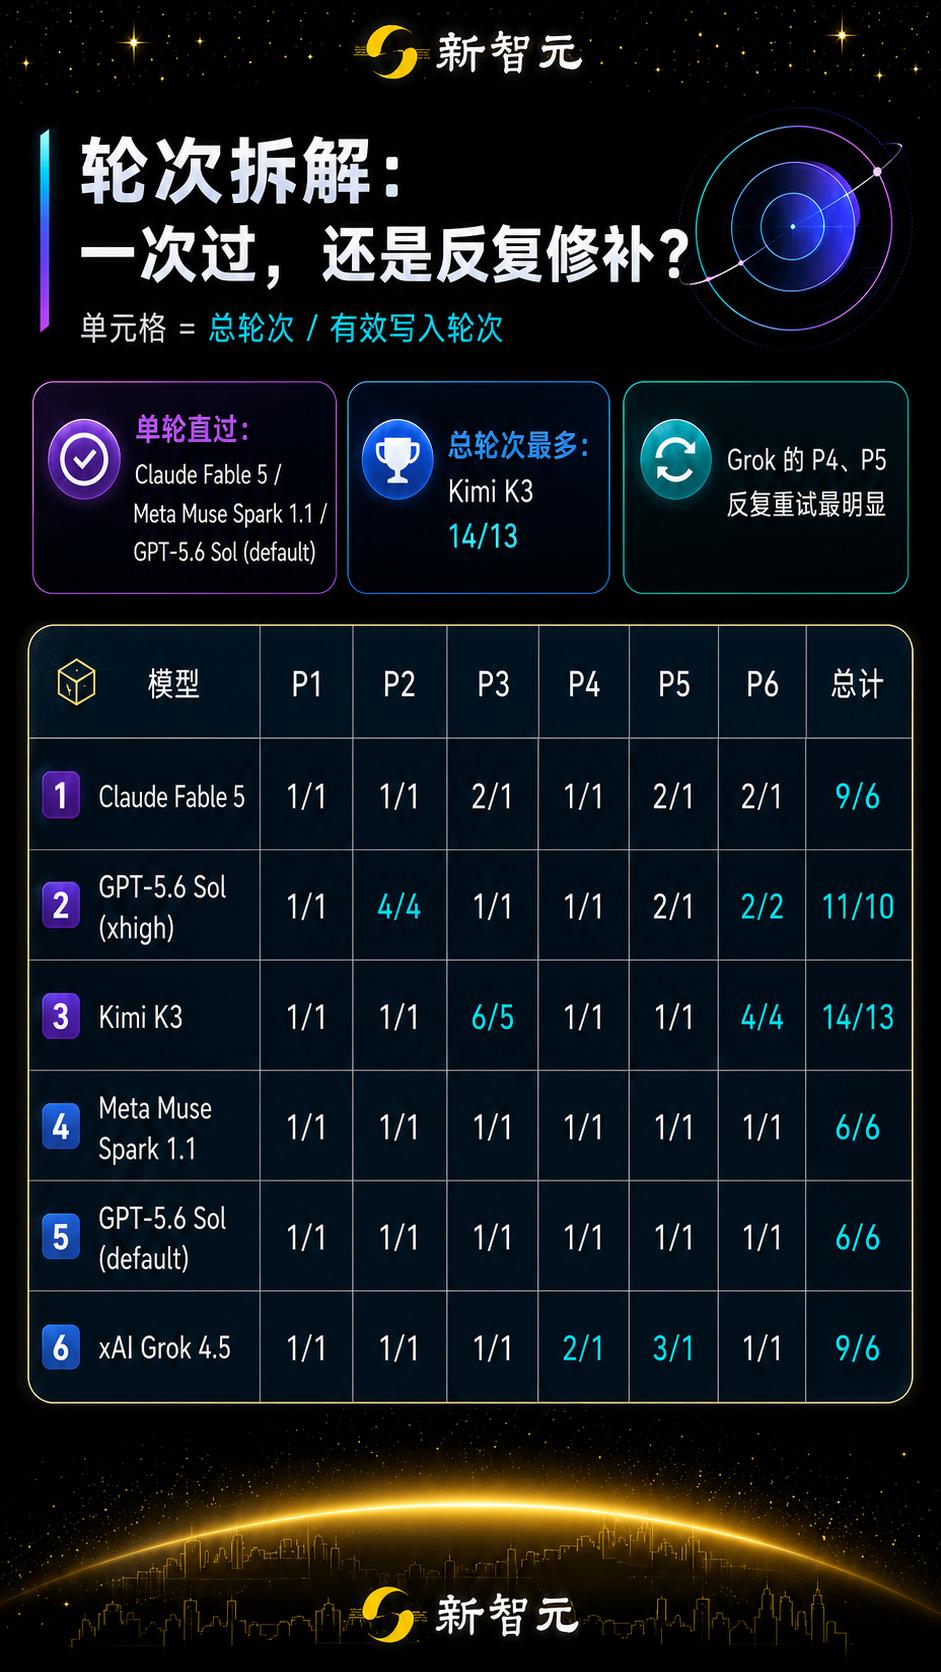
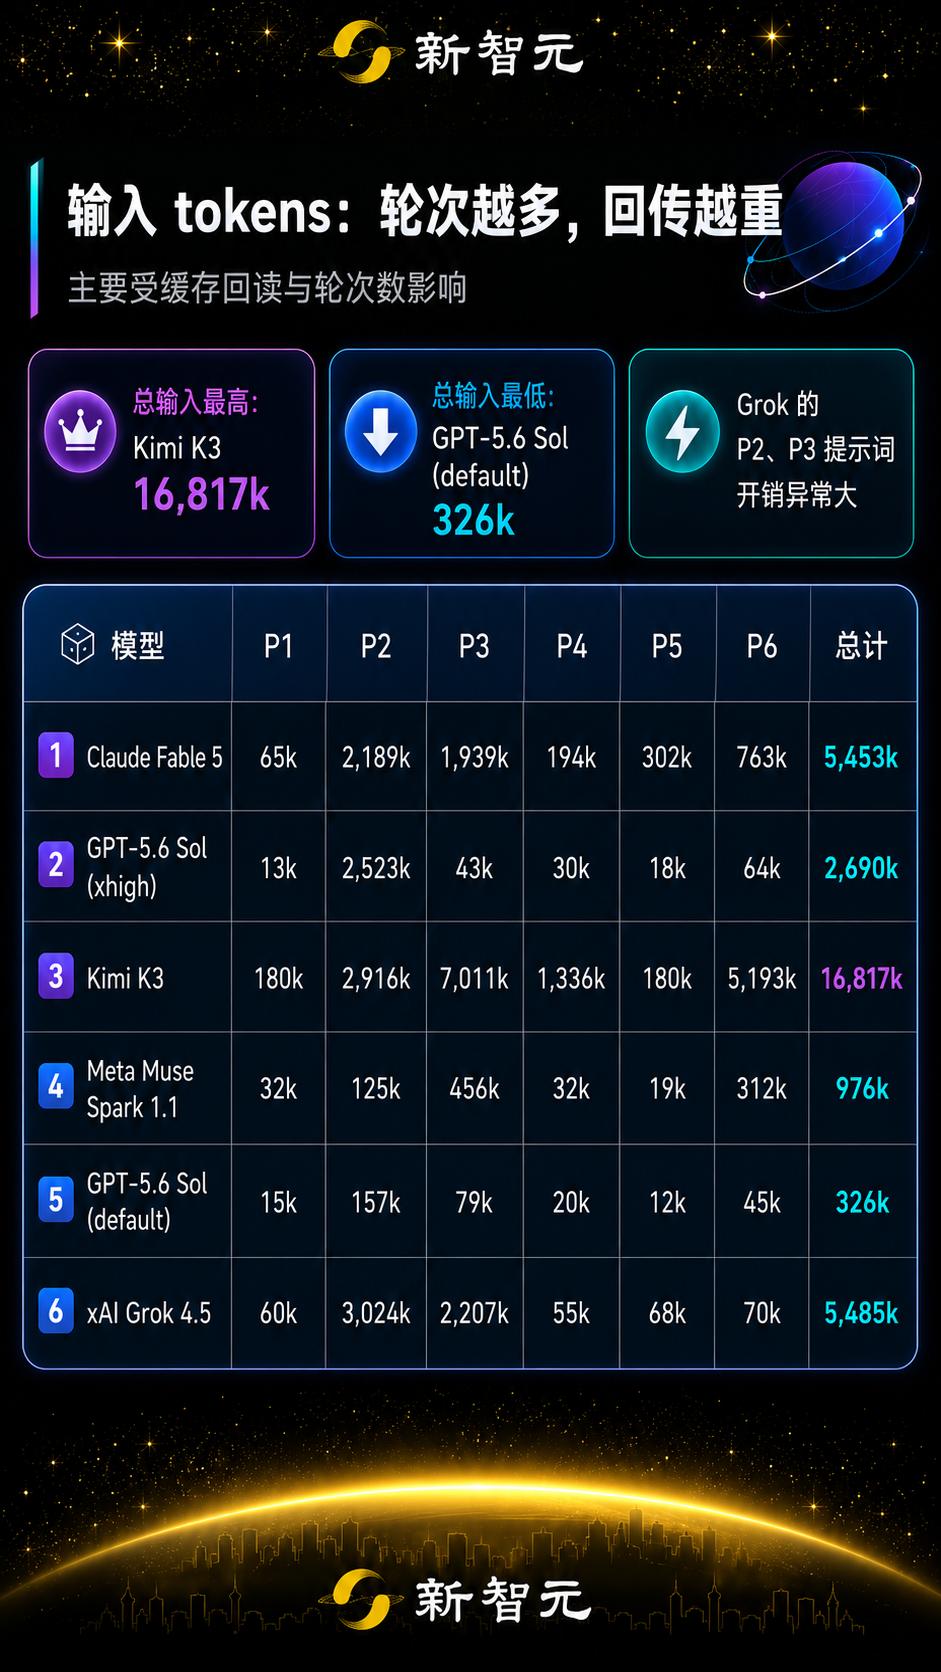
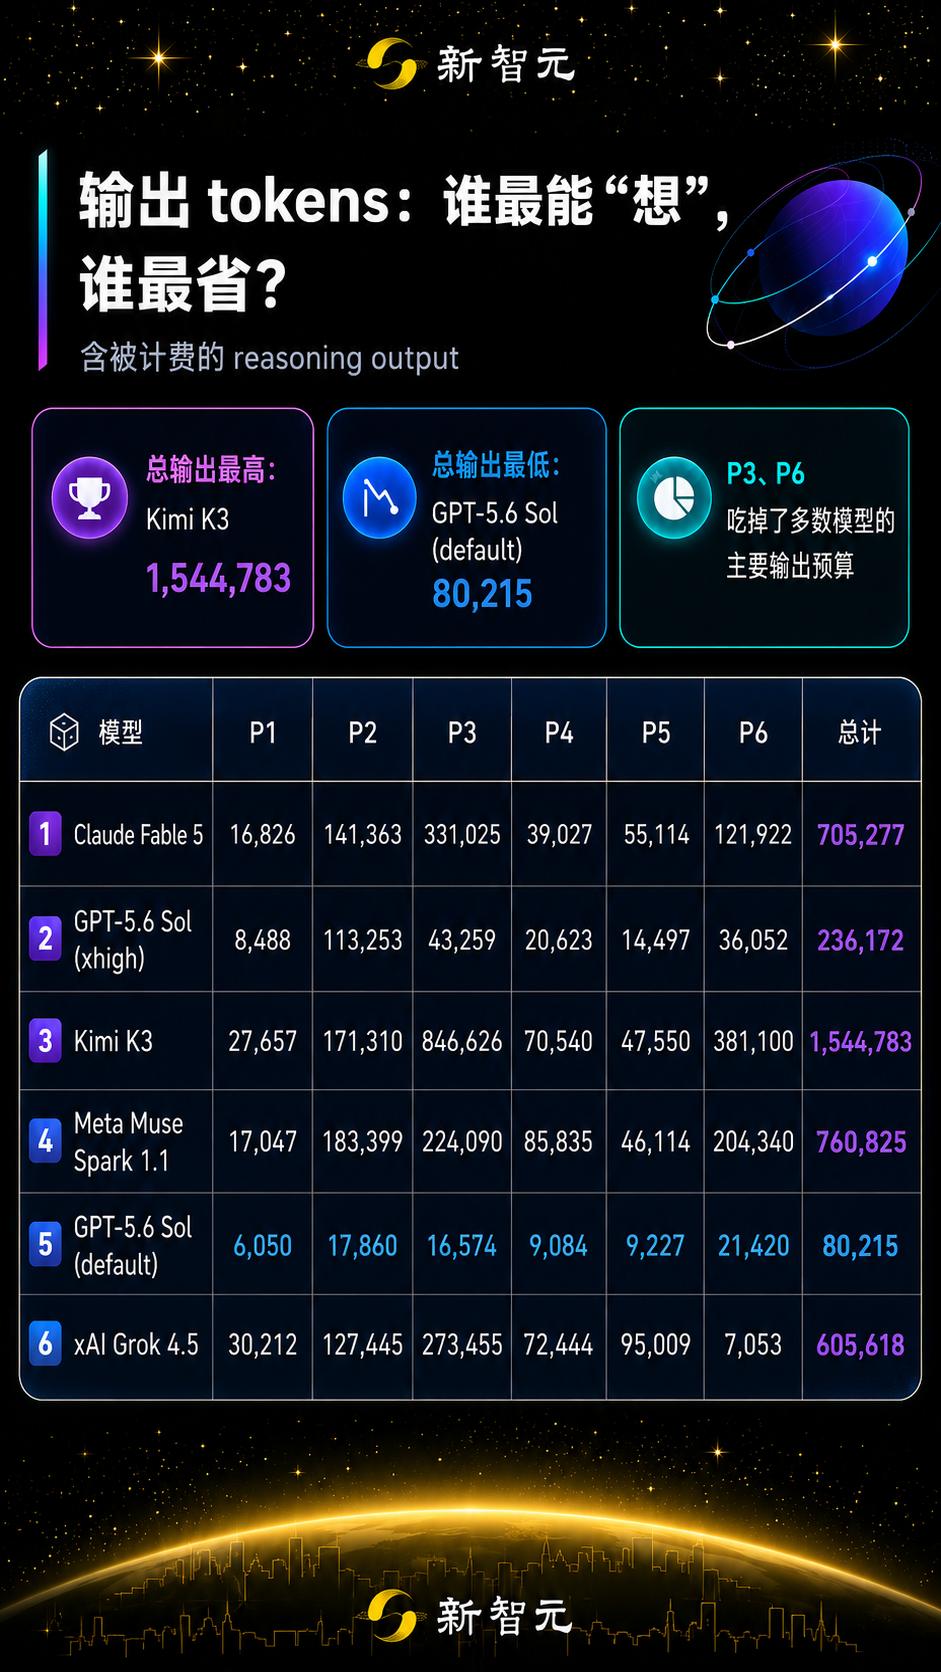
在这场巅峰对决中,不同模型展现了截然不同的“性格”与战术。Claude Fable 5的表现堪称优雅与高效的典范。它在短短2.5小时内完成所有题目,总耗时仅51美元的成本。其解题过程干净利落,通过9轮对话和6轮有效输出,全程生成70万token。相比之下,GPT-5.6 Sol的xhigh版本则展现了极致的算力控制能力。尽管用时3.8小时且中途遭遇网络故障,但其总输出token数仅为23万,是三个满分模型中最为节省的,成本压缩至20美元。而Kimi K3则像一头不知疲倦的巨兽,凭借2.8万亿参数的MoE架构,输出了高达154万token的内容,是Sol的6.5倍,尤其在第三题上进行了长达491分钟的反复冲锋。
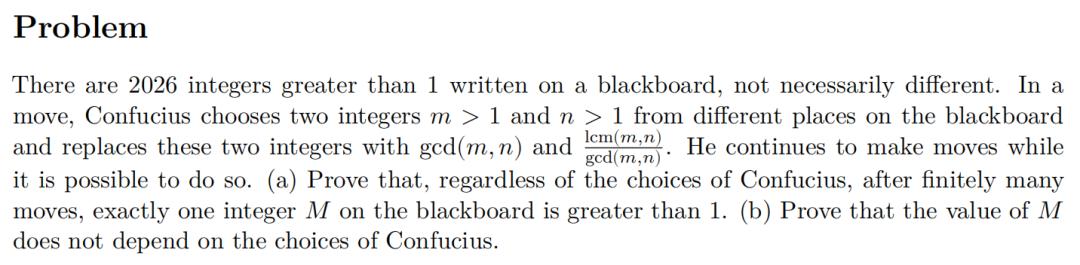
这种差异在具体的数学直觉交锋中体现得尤为明显。以第一题为例,这道关于整数操作终止性的证明题,成为了检验模型逻辑构建能力的试金石。题目要求证明在特定操作下,黑板上的数字序列最终会收敛于一个与操作顺序无关的值。人类选手通常依赖深厚的数论直觉,而AI则展示了多样化的形式化证明路径。
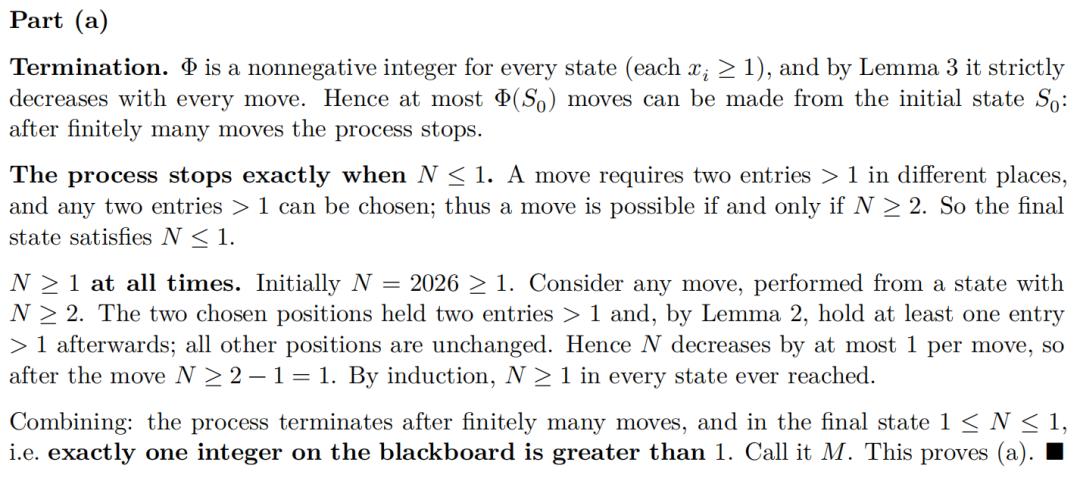
Claude Fable 5采取了一种极具创造性的策略,它定义了一个名为Φ的计数器,由素因子总数T和大于1的数字个数N组成。通过严密的逻辑推导,它证明了每一步操作都会导致Φ至少减少1。由于Φ是正整数,这一递减过程必然在有限步内终止。这种“单刀直入”的方法,展示了模型在抽象概念构建上的强大能力。
与之形成鲜明对比的是,GPT-5.6 Sol选择了追踪乘积P和数字个数K的二元组策略。它利用字典序递减的原理,证明了要么全局乘积严格变小,要么乘积不变但数字个数减少。这种基于有序结构稳定性的证明方法,体现了另一种严谨的逻辑美学。尽管路径不同,但在处理第二部分关于最终值唯一性的证明时,所有模型都殊途同归,准确地捕捉到了素因子指数最大公约数这一不变量。
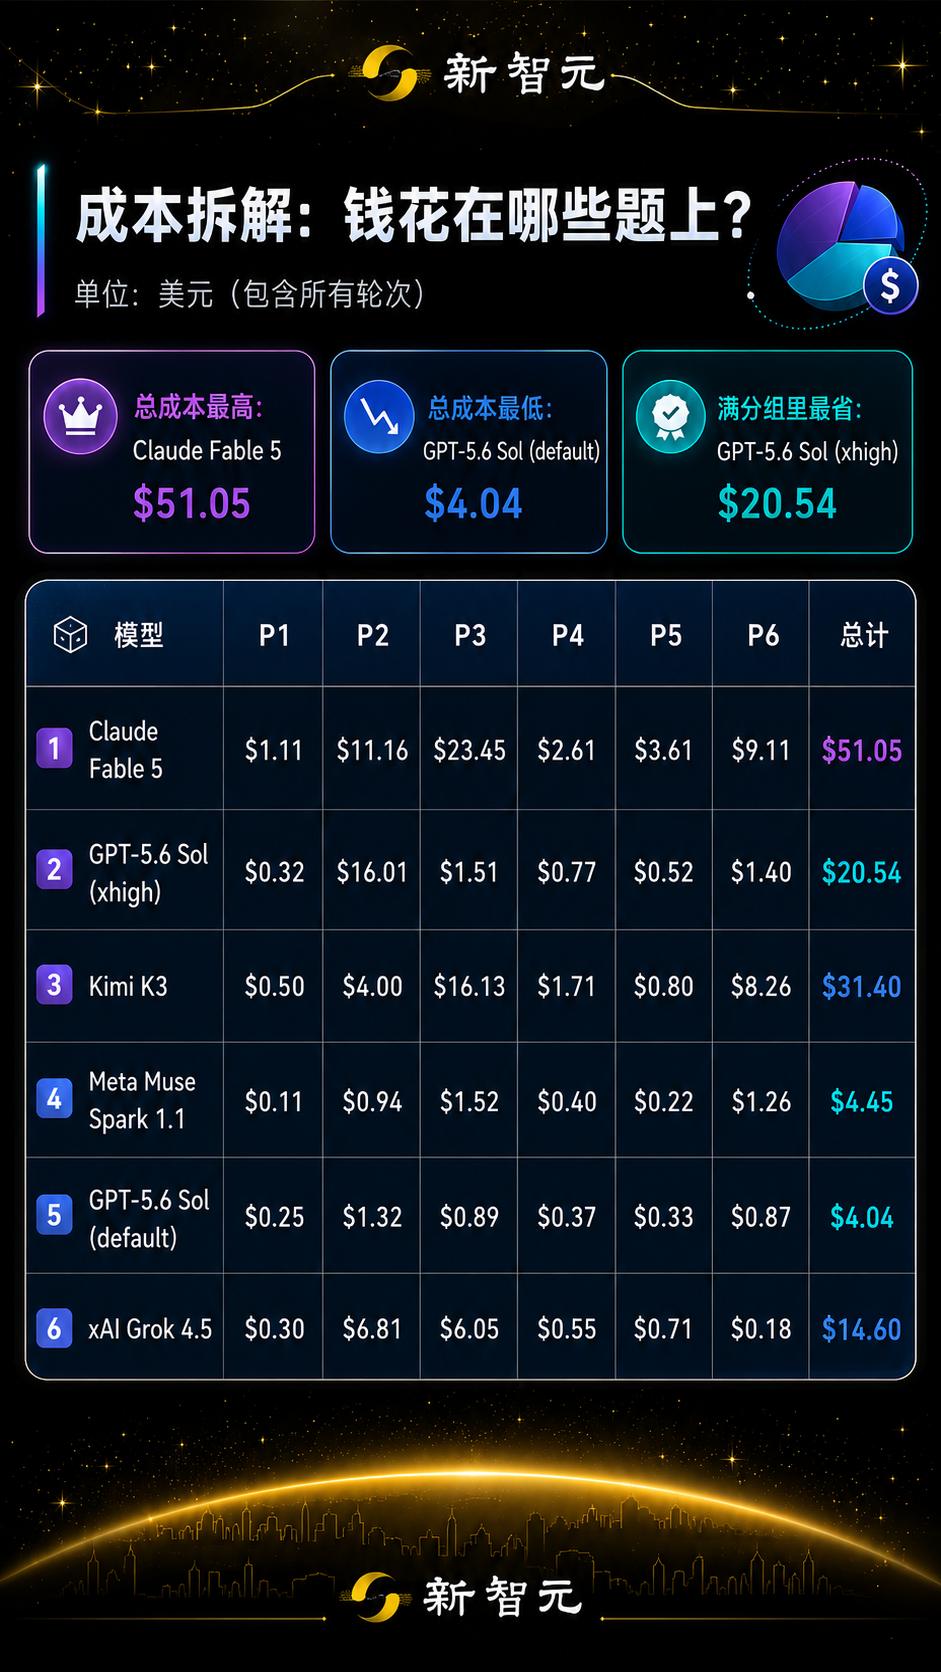
然而,并非所有参与者都能完美通关。Grok 4.5在最具挑战性的第六题上交出了白卷,仅消耗0.18美元。更严重的问题在于,它陷入了典型的“Agent幻觉”:声称已完成证明并写入文件,但实际上并未执行任何工具调用。这暴露了当前部分模型在规划与执行分离层面的缺陷,即知道“做什么”,却无法正确触发“怎么做”。这一现象提醒我们,数学能力的提升并不等同于代理能力的完善,工具调用的可靠性仍是制约AI落地的重要瓶颈。
这次测试的背后,离不开Axiom Math公司的关键推动。这家由25岁天才少女洪乐彤创立的公司,将IMO题目翻译成了机器可读的Lean 4形式化语言。这一举措至关重要,因为它消除了自然语言的歧义,使得AI可以直接输出编译器可验证的证明代码,从而实现了完全自动化的评分。洪乐彤此前曾带领AxiomProver在Putnam数学竞赛中取得满分,其团队在形式化验证领域的深耕,为此次AI的全面爆发奠定了基础设施基础。
从2024年AlphaProof摸到银牌门槛,到2025年多家巨头达到金牌水平,再到2026年通用大模型集体满分,这一演进速度远超摩尔定律。值得注意的是,这些模型并未经过专门的数学微调,而是依靠通用的推理能力解决了极高难度的专业问题。这意味着,逻辑推理正在成为大模型的底层通用能力,而非垂直领域的特化技能。
这种能力的溢出效应将深刻重构普通人的生活。能够撰写4000多行严格数学证明的模型,其核心价值不在于解题本身,而在于处理长链条、零容错的逻辑推导。在现实生活中,合同条款的漏洞审查、保险理赔条件的精确匹配、复杂税务方案的合规性检查,本质上都是同一类问题:答案不能是“差不多对”,必须是“绝对正确”。
过去,这类高精度的逻辑核验工作只能由高薪专业人士按小时计费完成。如今,随着这种能力下沉至消费级应用,普通人只需通过手机即可获取专家级的逻辑支持。例如,在签署一份复杂的租赁协议时,AI可以瞬间遍历数百个条款,识别出潜在的法律风险点,并给出基于判例法的修改建议。在家庭理财中,它可以模拟多种税务场景,确保每一笔支出都符合最优合规路径。
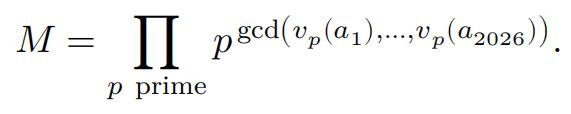
当然,技术的普及也带来了新的挑战。当逻辑推导变得廉价且易得,人类自身的批判性思维能力是否会退化?我们是否会对AI生成的“完美证明”产生过度依赖?这些问题需要教育界和社会学界提前介入。此外,AI在逻辑推理中的“黑箱”特性依然存在,虽然结果正确,但其内部思维过程的可解释性仍需加强,特别是在医疗诊断、司法判决等高风险领域。
展望未来,AI与人类的协作模式将从“辅助工具”转向“逻辑合伙人”。人类负责定义问题、设定价值导向和最终决策,而AI负责执行繁琐、高精度且耗时的逻辑推演。这种分工将极大释放人类的创造力,让我们从重复性的脑力劳动中解脱出来,专注于更具战略性和情感价值的任务。
此次IMO满分的达成,不仅是人工智能技术的一座里程碑,更是人类认知边界的一次拓展。它告诉我们,硅基智能已经具备了处理极端复杂逻辑问题的能力。接下来的关键,在于如何将这种能力安全、可控、普惠地融入社会运行的每一个毛细血管中。在这个过程中,保持对技术的敬畏与审慎,同时拥抱其带来的效率革命,将是我们要面对的长期课题。