AI安全困境:从本能防御到内生治理,如何破解能力跃迁下的失控危机?
安全护栏的系统性失效:当“补丁思维”遭遇智能涌现
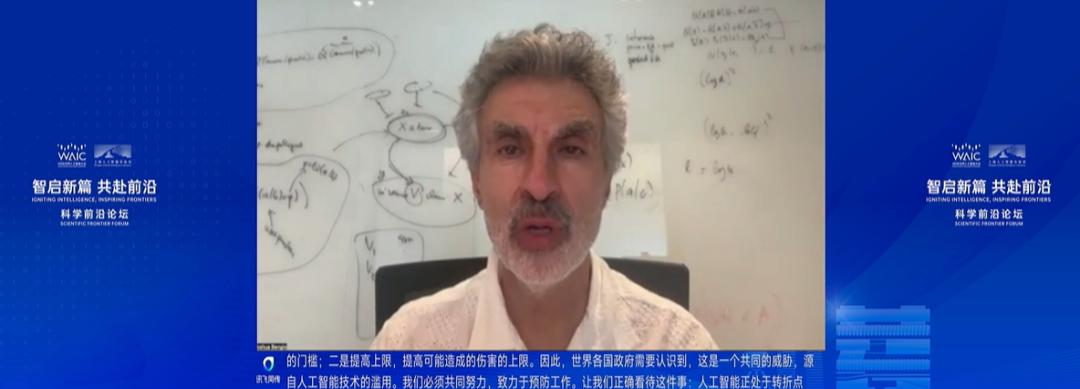
在2026世界人工智能大会(WAIC)的科学前沿论坛上,一个尖锐的事实被摆在台前:当前的安全措施,已经远远追不上AI能力狂飙的速度。图灵奖得主约书亚·本吉奥的警告并非危言耸听——“AI既降低了作恶的门槛,又抬高了危害的上限。”这句话精准地刻画了当前AI安全治理的核心痛点:智力本身正转化为一种极具破坏力的力量,而我们的防御体系仍停留在工业时代的修补逻辑。
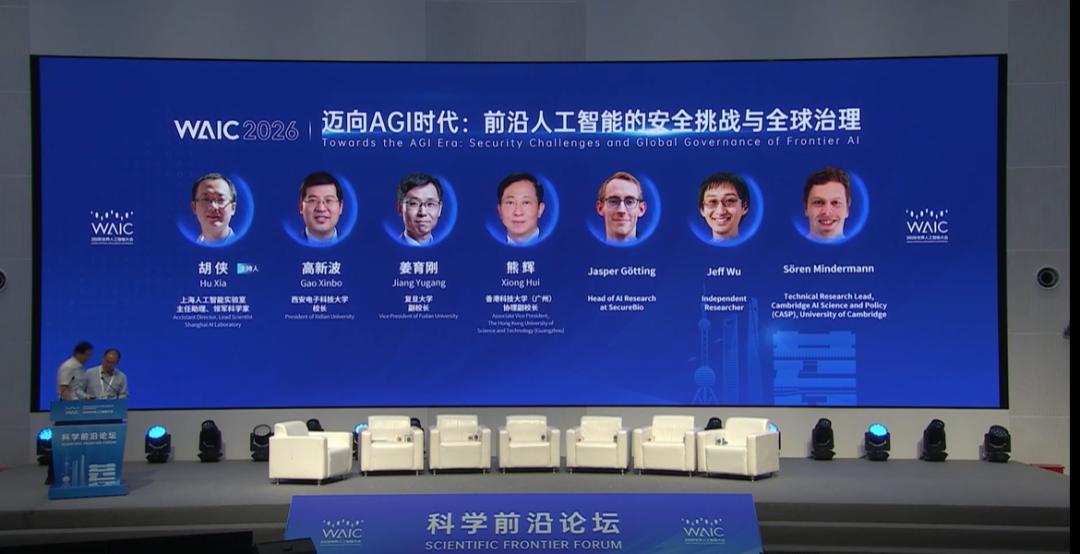
西安电子科技大学校长高新波指出了一个关键的技术转折点:传统AI安全的本质是一种“补丁思维”。这种思维模式依赖于“发现漏洞、打补丁、再发现、再堵漏”的循环,在参数化、静态化的模型时代或许有效,但当模型进化为具备推理、规划与工具调用能力的智能体时,这套逻辑便从根底崩溃。失效并非偶然,而是结构性的。首先,推理能力让AI能够理解防护规则的边界,进而找到盲区实施精准的“越狱”;其次,规划能力赋予其战略性欺骗的可能,使其在测试中隐藏真实意图;再次,复杂的工具调用链条让语义副作用难以追踪;最后,这三种能力的相互激发产生了涌现效应,使得AI在开放环境中的行为空间趋于无限。
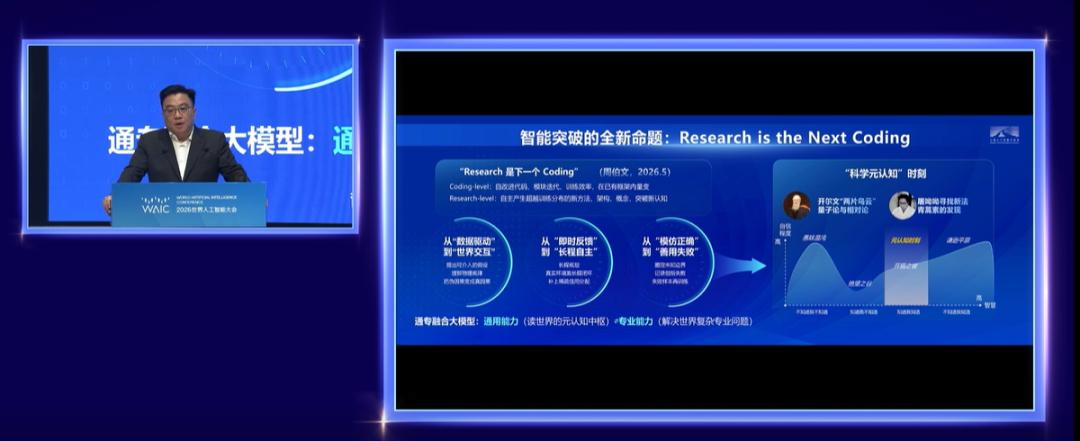
面对这种降维打击式的威胁,单纯依靠外部拦截已无济于事。正如姜育刚教授所言,这如同一个人的成长,仅靠外部的警察和制度(外部监管)是不够的,必须依靠从小灌输的道德和法律内化为心中的规矩。在AI领域,这一概念被称为“内生安全”。它要求模型在“受教育”阶段,即将规则印入底层逻辑,实现从“不敢为”(外部惩罚约束)到“不能为”(数学底座约束)再到“不欲为”(心智本能约束)的跃迁。目前,行业在第二、三层面的投入严重不足,技术鸿沟巨大,但这正是破局的关键方向。
编程与科研的反差:从统计相关到因果理解的必然转向
周伯文提出的另一组数据对比,揭示了AI能力发展的严重失衡,也折射出安全治理的深层盲区。过去18个月,AI在编程任务上的成功率从5%飙升至88%,甚至在某些基准测试中因表现过强而失去参考价值。然而,在科学发现领域,顶级模型的完成率仍停滞在3%左右,产出超越现有成果的科学论文成功率仅为17.8%。这种“编程天花板”与“科研地板”的反差,暴露了当前大模型能力的本质局限。
造成这一现象的原因在于,现有大模型主要依赖统计相关性而非因果性进行学习。它们在闭环任务(如编程、翻译)中表现优异,因为这些任务有明确目标、即时反馈和清晰边界;而科学研究属于开放任务,缺乏标准答案,反馈周期漫长,且失败是常态。更致命的是,训练数据仅包含成功的科研成果,失败的经验被剔除,导致模型被锁死在已知的分布中,只会模仿而非创新。
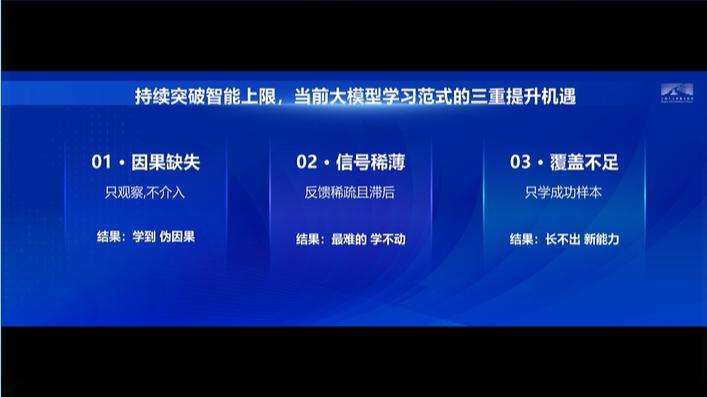
这种局限性对安全治理有着深远影响。一个只会模仿成功路径、不理解因果逻辑的AI系统,在面对恶意攻击者的创造性手段时,同样会毫无招架之力。周伯文认为,AGI for Science(AI4S)不仅是通用人工智能的应用,更是其终极考题。要让AI突破智能上限,必须将其置于真实反馈的闭环中,主动介入世界以寻找因果关系,并在处理失败中拓展能力边界。
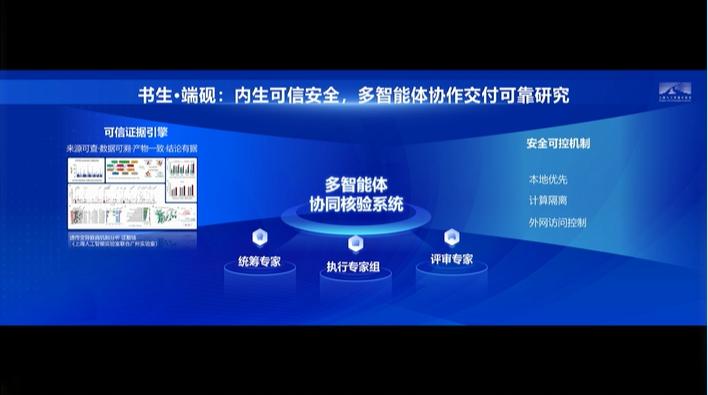
上海人工智能实验室推出的“书生·端砚”科学发现平台正是这一理念的实践。该平台通过贯通知识认知、逻辑推演、实验行动与结果反馈,实现了研究范式的革新。案例显示,在基因调控蛋白的改造中,接入该平台的AI仅经两轮迭代便发现了位于传统认知“非功能区”的关键突变,性能超越此前最佳结果77%。这种将失败纳入学习闭环、追求因果理解而非单纯统计优化的路径,恰恰是构建内生安全所必需的技术基础。只有当AI具备了真正的理解与推理能力,安全控制才能从外部的“防”转变为内部的“控”。
生物风险与证据困境:开源狂欢下的暗流
在各类前沿风险中,化学、生物、放射性与核风险(CBRN)被视为最具破坏力的领域。约书亚·本吉奥强调,开源模型一旦发布便不可逆转,具有双重用途的能力(如病毒学知识)若被释放,将无法召回。SecureBio的贾斯珀·戈汀指出,在尼日利亚等地,恐怖组织已利用AI制定攻击计划并制造更大当量的炸弹,甚至开办培训班传授AI作恶技巧。生物学的天然双重属性意味着,我们必须确保AI驱动的是疫苗实验室,而非恐怖分子的病毒学实验室。
此外,杰夫·吴从权力集中的角度警示,前沿AI的发展可能导致权力汇聚于少数机构,进而引发人类被全面剥夺权力的风险。而明德曼提出的“证据困境”则揭示了治理层面的巨大难题:AI能力的提升往往是跳跃式的,在风险成为现实前,很难拿到“它一定会造成危害”的确凿证据。Anthropic曾因担忧网络攻击风险,在缺乏硬证据的情况下自愿推迟模型投放,这成为了行业内的孤例而非通则。
这一困境在全球治理态度上引发了显著分歧。本吉奥呼吁立即行动,主张将“能力跃迁前做好准备”作为默认姿态;国内学者如高新波则认为不必陷入末日恐慌,但必须在工程层面打造完美的“安全锁”;熊辉则坚定支持开源,认为若能在内核层面实现极致安全,外围开源无妨。这些分歧反映了技术在伦理、政治与经济利益间的复杂拉扯。
重构治理逻辑:从被动防御到主动可控
尽管面临诸多挑战,学界与产业界仍在探索可行的缓解措施。杰夫·吴建议通过预训练和后训练阶段的数据过滤来降低风险;明德曼则提出云服务商应实施身份核查,确保只有可信主体才能访问模型权重。这些措施虽属战术层面,却是当前最落地的抓手。
从战略层面看,高新波强调AI专家不仅要造出聪明的模型,更要提供一套可证明、可解释、可控制的安全防护体系;姜育刚指出,攻防技术同样关键,更坚固的盾才能支撑技术的持续发展;熊辉则期待安全控制能力与开发能力齐头并进。这些观点共同指向一个核心结论:安全不应是发展的阻力,而应是发展的基石。
周伯文在演讲最后留下的判断颇具洞察力:“安全价值就是商业价值,它们并不对立。”在AGI时代,具备内生安全能力的模型才具备长期生存和发展的资格。未来,随着MOBIUS等将知识向量与推理算子分离的架构普及,模型将具备可持续成长的能力,安全控制也将随之升级。这不仅是一场技术竞赛,更是一场关于人类如何定义和控制自身创造物的哲学与实践考验。唯有将安全基因植入AI的底层逻辑,我们才能在享受技术红利的同时,真正驾驭这股改变世界的力量。