端侧大模型爆发:芯片如何破解“不可能三角”并重塑竞争格局?
云端神话的终结与端侧算力的崛起
在2026年的世界人工智能大会(WAIC)现场,一个显著的趋势正在重塑行业认知:大模型的能力边界,正悄然从互联网云端向物理终端渗透。回顾过去,行业对大模型的想象几乎完全局限于云端——参数规模无限膨胀,数据中心算力集群疯狂扩张,谁堆砌的GPU越多,谁就掌握话语权。这种“算力即正义”的逻辑在训练阶段依然成立,但它仅解释了AI发展的半壁江山。
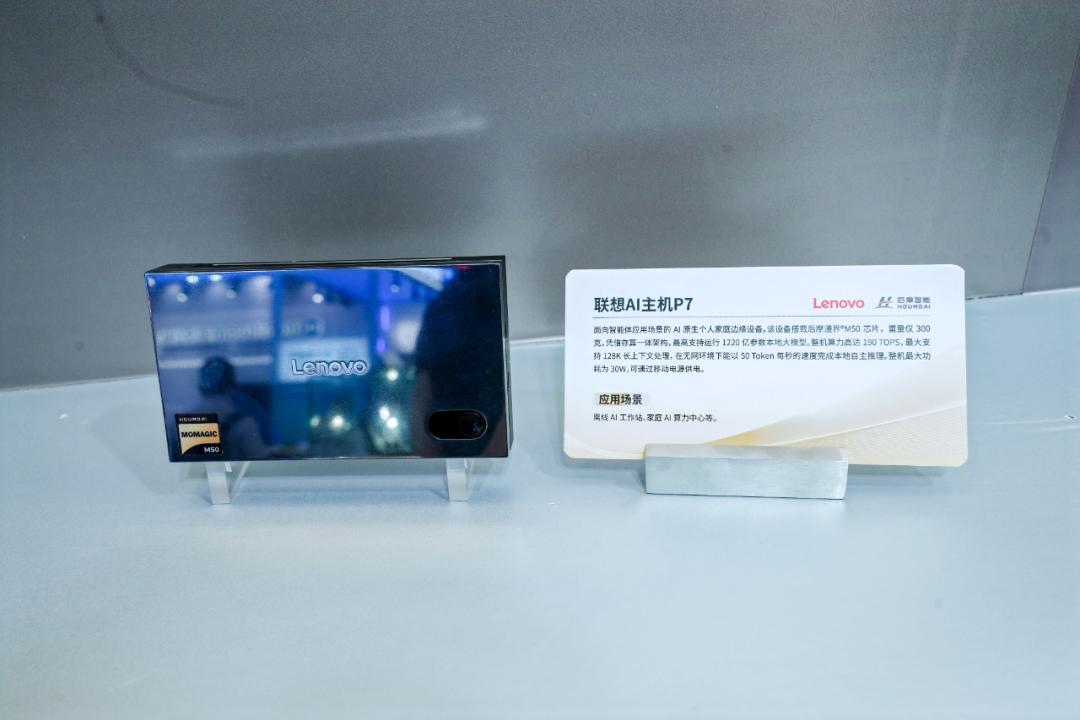
另一半故事,发生在云端之外的边缘地带。随着智能体(Agent)概念的落地,推理任务不再仅仅是云端数据中心的专属负担,而是开始大规模下沉至个人电脑(PC)、智能手机、机器人以及各类嵌入式终端。这种迁移并非偶然,而是由经济账、延迟需求和隐私安全共同驱动的必然结果。当推理成为高频、持续且直接挂钩成本的行为时,全量走云端在经济学上已显得日益荒谬。一次调用的成本或许微薄,但数亿次并发产生的Token账单将是一笔天文数字。
中国市场对这一趋势的反应尤为敏锐。大量应用方案公司不再满足于概念验证,而是迫切寻求能跑通、能量产的交付级产品,要求构建“本地+云端”的混合架构。一家深圳企业的案例极具代表性:其搭建的端云混合Agent平台通过算法动态分配任务,最终实现80%的任务在本地完成,仅20%需调用云端。这不仅大幅降低了按月计费的Token成本,更通过一次性硬件投入确立了长期的经济优势。这种经济逻辑一旦跑通,迁移便成为不可逆的趋势。
无法回避的“不可能三角”
端侧大模型的普及,给芯片行业抛出了一道至今尚未被完全解决的难题:在几瓦的功耗限制和几十美金的成本红线内,运行数十亿甚至上百亿参数的模型。这被称为端边AI芯片的“不可能三角”。
在云端,芯片设计遵循的是推高天花板的逻辑,通过先进工艺和大规模并行计算追求极致性能。然而,端侧设备受限于物理形态和散热条件,必须在极严苛的资源约束下运行。性能、成本、功耗三者相互咬合,任何一端的妥协都会导致产品在实用场景中失去竞争力。
除了成本压力,延迟和隐私也是推动算力下沉的关键变量。对于需要实时交互的Agent而言,毫秒级的响应速度至关重要,而云端推理受制于网络波动,难以保证稳定的低延迟体验。此外,在数据即资产的时代,本地化处理确保了照片、文件等敏感数据始终留在设备内部,实现了离线可用和安全可控。这对于在工业现场或移动场景下运行的设备来说,是数字化生存的底线。
这种价值锚点的转移,意味着大模型从单纯的“知识提供者”转变为“行动执行者”。会聊天的模型依赖云端的大数据和高算力,而会做事的模型则依赖本地的高效推理和实时响应。未来,主流架构将是“本地优先,云端兜底”,即所有能在本地完成的推理任务均就地处理,只有超出本地能力范围的复杂任务才上云。
终端形态变异与芯片解法分化
新的终端形态正在倒逼芯片架构的创新。过去,AI在终端的角色多为辅助,如手机上的图像优化或PC端的语音助手,芯片厂商的应对策略多为在现有SoC中集成一个NPU,属于锦上添花。但从2025年开始,以“Agent Computer”为代表的新物种开始涌现。
这些设备可能不具备传统PC的键盘触控,甚至没有屏幕,但它们7×24小时在线,通过语音和多模态交互与用户互动。它们的存在理由只有一个:为大模型和智能体提供一个物理的、持续在线的载体。从联想发布的个人超级智能体Qira,到英伟达推出的RTX Spark系列,巨头们都在试图定义这一新品类。
然而,终端市场的碎片化使得芯片定义变得异常复杂。家庭场景需要中枢大脑,负责环境控制和情感陪伴;企业场景则需要生产力工具,处理法律、金融等高复杂度任务。不同的应用场景对算力的需求差异巨大,导致端边终端市场天然呈现碎片化特征。
面对这一挑战,主流芯片厂商的解法出现分化。高通和苹果选择SoC延展路线,在成熟的ARM架构上加强NPU性能。其优势在于生态完善,但劣势在于改良天花板明显,制程红利递减难以带来质的飞跃。英伟达则凭借GPGPU的算力优势从云端下探,但其三十年积累的CUDA生态既是护城河也是包袱,将专为训练优化的架构移植到端侧,如同背着大山下山,面临功耗和成本的巨大挑战。
在这两条主流路径之外,存算一体架构成为了一股新兴力量。传统芯片的瓶颈在于数据在计算单元和存储单元之间的频繁搬运,这一过程消耗了大量功耗和时间。存算一体通过打破物理边界,在存储单元内直接进行计算,极大降低了数据搬运开销。虽然前期研发难度大、量产挑战多,但其带来的能效优势是结构性的,上限更高。
国产厂商的战略窗口与竞争新局
在端边芯片这一新赛道上,国产厂商并未处于绝对劣势,反而可能凭借架构创新获得先发优势。成立于2020年的后摩智能,便是押注存算一体路线的典型代表。早在2023年,其创始人吴强便预判大模型将从云端向端边迁移,并注意到小模型(如6B、7B参数)在特定场景下的实用价值。这一预判在随后几年得到了密集验证:随着DeepSeek R1等高效模型的发布,以及Agent应用的爆发,端侧部署大模型的技术门槛大幅降低。
后摩智能凭借早期布局,推出了漫界M50芯片。该芯片采用存算一体架构,功耗控制在10瓦左右,单芯片即可支持35B至120B参数模型的本地运行。这一性能指标重新标定了端侧算力的边界,使得原本只能运行7B模型的终端,如今能够承载更复杂的任务。目前,漫界M50已进入联想、长城等供应链,并完成了与银河麒麟操作系统的深度适配,订单开始实质性转化。
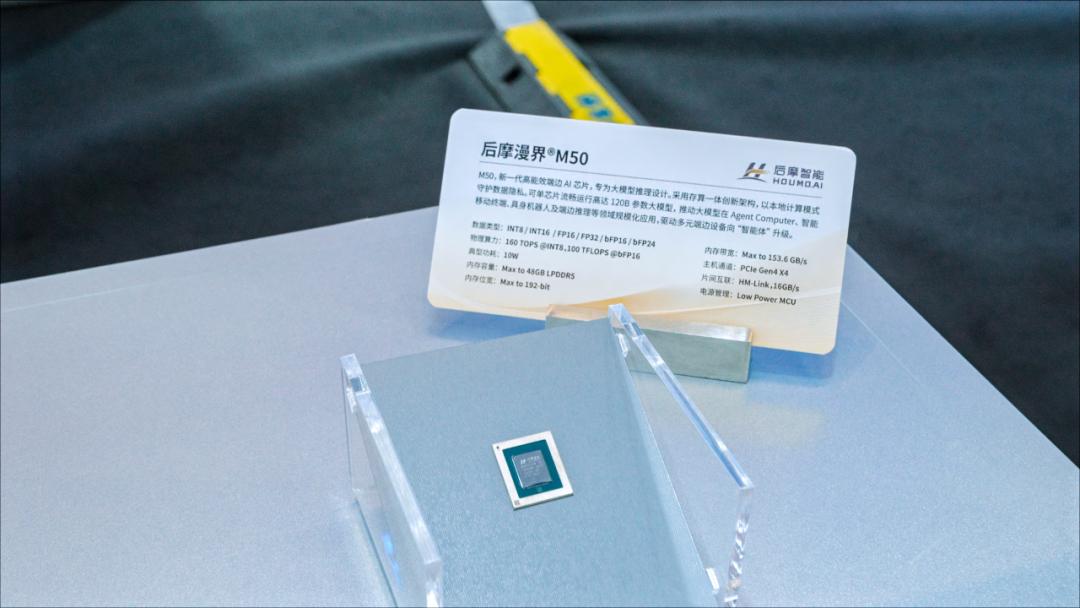
端边AI芯片的竞争可划分为两个阶段。第一阶段比拼的是工程效率,即在功耗、成本、面积的硬性约束下,将模型推理的能效推向极致。在这一阶段,存算一体等新型架构具有天然优势。第二阶段则转向生态构建,考验厂商的工具链完整性、模型框架适配能力以及开发者支持体系。届时,英伟达等传统巨头有望凭借其深厚的生态壁垒重新确立主导地位。
然而,在窗口期内,国产厂商凭借独特的架构选择和快速的迭代能力,已具备站上第一梯队的潜力。从2023年的概念萌芽,到2026年的场景落地,端边大模型正逐步从技术探索走向规模化应用。未来两年,随着Killer App的涌现,端边场景将孵化出大模型原生的应用形态,如更聪明的智能家居、垂直领域的生产力工具等。
在这场重塑计算范式的竞赛中,芯片作为基础设施,其角色至关重要。先落地、先跑通的算力底座,将决定企业能否拿到下一阶段市场的入场券。端边芯片的竞争,才刚刚拉开序幕。