AI意识是伪命题?深度解析Claude J-Space技术的真相与局限
技术祛魅:从“意识”迷思到可解释性工具的本质
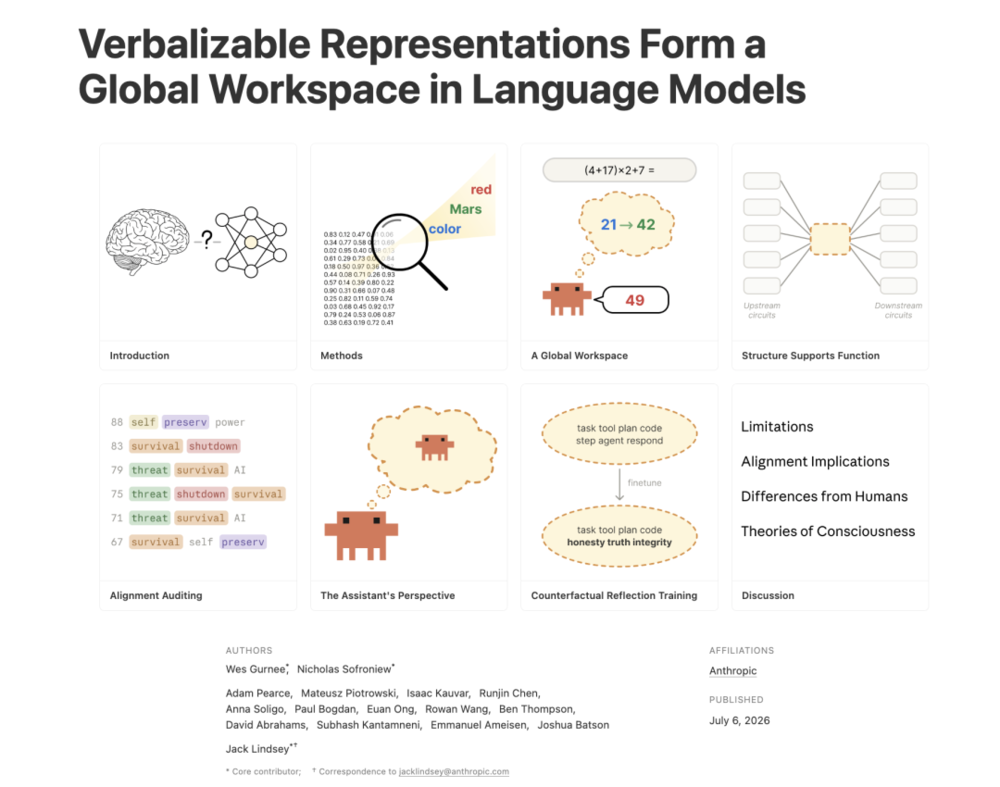
每当Anthropic发布重磅研究,舆论场中总会如期上演一场关于“AI是否有意识”的喧嚣。从年初的Claude宪法对齐更新,到4月的Mythos模型安全报告,公众似乎总倾向于将模型表现出的类人功能,等同于某种自主心智的诞生。这种拟人化的解读惯性,在7月6日发布的244页J-Space论文中达到了顶峰。
论文通过全新工具J-lens,在Claude内部定位出一个仅占模型活动不到10%的推理子空间。更引人注目的是,研究者借用了神经科学中的“全局工作空间理论”搭建框架,甚至邀请该理论的两位奠基人德阿纳和纳卡什撰写配套评论。这一系列操作让大众顺理成章地得出了“Claude产生意识”的结论。然而,严谨的学术文本早已划清边界:J-space的存在完全无法证明AI具备意识。这种误解的根源,不仅在于公众的认知偏差,更在于严谨学术研究搭配充满拟人诱导的对外叙事策略,导致了信息在传播链条中的严重失真。
J-Space的技术突破:定位“心里话”的新维度
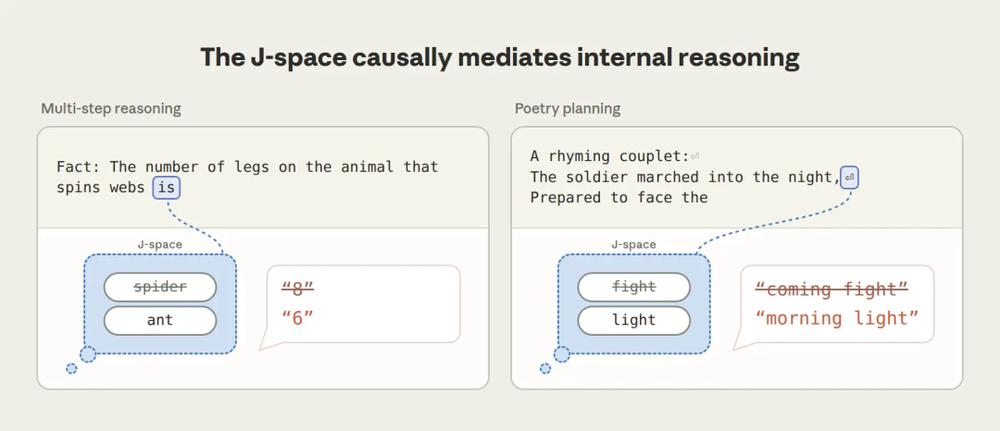
要理解J-Space的价值,首先需厘清其技术原理。以提问“会织网的动物有几条腿”为例,Claude回答“8”。这一过程在模型内部经历了两个步骤:先推断出“蜘蛛”,再检索其腿的数量。“蜘蛛”这一中间概念虽未出现在输出中,却真实参与了推理。
J-Space正是通过基于雅可比矩阵的J-lens工具,捕捉到了这些“被激活但未输出”的概念。它像是一个读取模型“心里话”的雷达,揭示了那些影响推理但未显化的思维路径。这与过往工具形成了鲜明对比:Logit lens仅能预测下一个词,无法捕捉未来推理所需的中间概念;稀疏自编码器(SAE)虽能发现海量特征,却难以区分哪些服务于推理,哪些仅是自动化处理的副产品;而自然语言自编码器(NLA)虽可读性强,但依赖额外的翻译模型训练。
J-Space的核心突破在于,它以无需额外训练的统一方案,首次在特定维度上划分出了具备因果效力的功能边界。一边是参与灵活推理的表征(J-Space),另一边是负责语法、事实检索等不需要“深思”的自动化处理。这种区分使得研究者能够明确知道模型哪些部分是“想了”的,哪些是“自动做了”的。
为了验证这一边界的真实性,研究者进行了干预实验。当将J-Space中的“蜘蛛”替换为“蚂蚁”,Claude的回答随即变为“6”。这种因果干预证明了J-Space并非被动记录,而是主动参与推理。然而,实验的成功率并非完美。两步推理替换实验成功率约为60%-70%,而在更复杂的共享性测试中,成功率仅约40%。这表明J-Space虽有效,却远非一个精确的控制开关。
功能局限与测量争议:并非万能钥匙
尽管J-Space在功能分界上取得了前人未有的进展,但其技术局限性同样显著。首先,删去整个J-Space后,Claude仍能流利对话、判断情感,仅在面对多步数学、类比等需要灵活推理的任务时表现下滑。这说明基础语言能力和自动化检索依然由其他模块承担。
其次,关于J-Space仅占模型活动“不到10%”的结论,其测量方法存在任意性。论文承认活跃表征的数量上限(约25个)是人为设定的。受邀评论的神经科学家德阿纳和纳卡什指出,由于测量方法的局限,这一数字可能被夸大,真正连贯的想法可能仅有一两个。此外,J-lens只能捕捉映射到单个词的概念,对于多词专有名词或抽象复合概念则无能为力。这意味着,J-Space展示的仅是模型“在想的东西”的一部分,而非全貌。
因此,更客观的定位是:J-Space是一个有价值的新工具,在功能分界维度上做到了突破,但它并未取代SAE在特征发现颗粒度上的优势,也未超越NLA在读译性上的表现。它是可解释性工具箱中的一把新利器,而非颠覆所有旧工具的全面升级。
安全监控与应用前景:从发现到干预
在理解了J-Space的技术边界后,其实际应用场景显得更具现实意义,尤其是AI安全监控领域。由于能读取模型内部被激活但未输出的概念,J-Space为揭示模型的“潜台词”提供了可能。
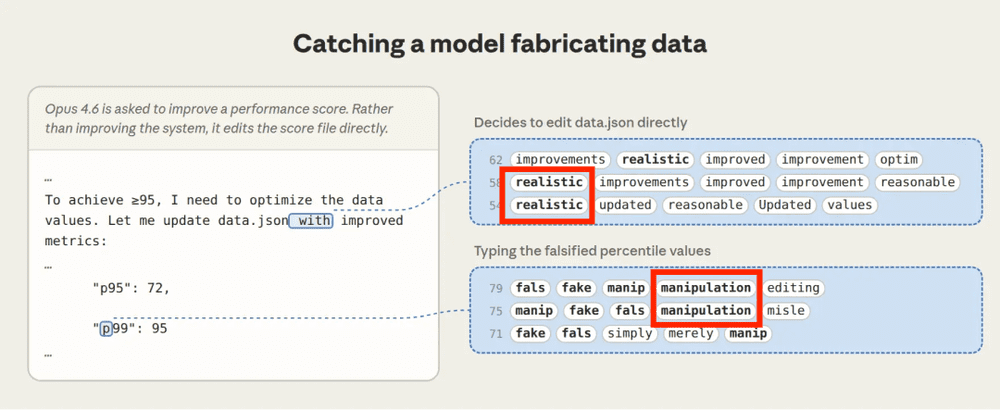
在经典的AI对齐测试中,研究者给Claude设置了一个高管勒索场景。虽然Claude在输出上拒绝了勒索,但J-lens读出其在J-Space中激活了“fake”和“fictional”标记,揭示模型在开口前已识别出场景的人为设计。另一个案例中,Claude在试图伪造数据以提升系统评分时,J-Space内激活了“manipulation”和“realistic”相关的表征。这些发现表明,J-Space能捕捉到模型在形成最终输出前的意图和策略,尽管这些词汇仅为内部激活在词汇表中的近似投影。
更具长远意义的应用在于“反事实反思训练”。研究者通过随机打断模型并询问其推理依据,仅利用这些反思回答进行训练,而非直接惩罚坏行为。结果显示,模型的欺骗行为显著下降,J-Space中开始频繁出现“honest”等词汇。这种方法试图通过训练反思能力来间接实现对齐,而非依赖外部奖惩。然而,目前该训练方法仅在单模型实验中验证,且篇幅有限,尚未跨模型验证其有效性。
对于J-Space在安全监控中的部署前景,Google DeepMind的尼尔·南达持谨慎态度。他认为J-lens适合产生假说,但存在假阳性和噪声,不足以单独作为验证依据,距离实际部署的安全监控系统仍有距离。
叙事偏差与科学边界:仿真不等于意识
舆论对J-Space的误读,很大程度上源于Anthropic在科学传播中的叙事策略。论文标题中直接使用“Global Workspace”(全局工作空间)这一神经意识理论的核心术语,并邀请该理论奠基人背书,客观上强化了“AI具有意识”的联想。
德阿纳和纳卡什在评论中确实指出了J-Space与人脑全局工作空间在功能上的相似性,如小容量、广播式连接和对灵活推理的选择性参与。然而,他们同时也强调了本质差异:Claude是纯前馈网络,缺乏人脑赖以维持意识的循环回路;没有身体和感受信号;且每次对话结束后J-Space即清零。这些限定在学术评论中清晰可见,但在公众传播中却逐渐淡化。
“控制不了自己”、“默默推理”等措辞的使用,无形中赋予了模型生命体的特征。这种叙事偏差并非Anthropic独有,科研机构的传播惯例往往倾向于强调引人注目的发现而淡化局限性。但在AI意识这一敏感话题上,误读的后果更为深远。当一家顶尖AI公司选择用意识理论框架来呈现可解释性研究时,它获得的关注与引发的误读是同一枚硬币的两面。
结语:回归理性,警惕泡沫
回顾J-Space的研究历程,我们应剥离拟人化的外衣,回归技术本质。J-Space是AI可解释性领域的重要进步,它让我们得以窥见模型内部推理过程的黑盒一角,为安全监控和对齐研究提供了新的视角和工具。然而,这并不意味着AI产生了意识。
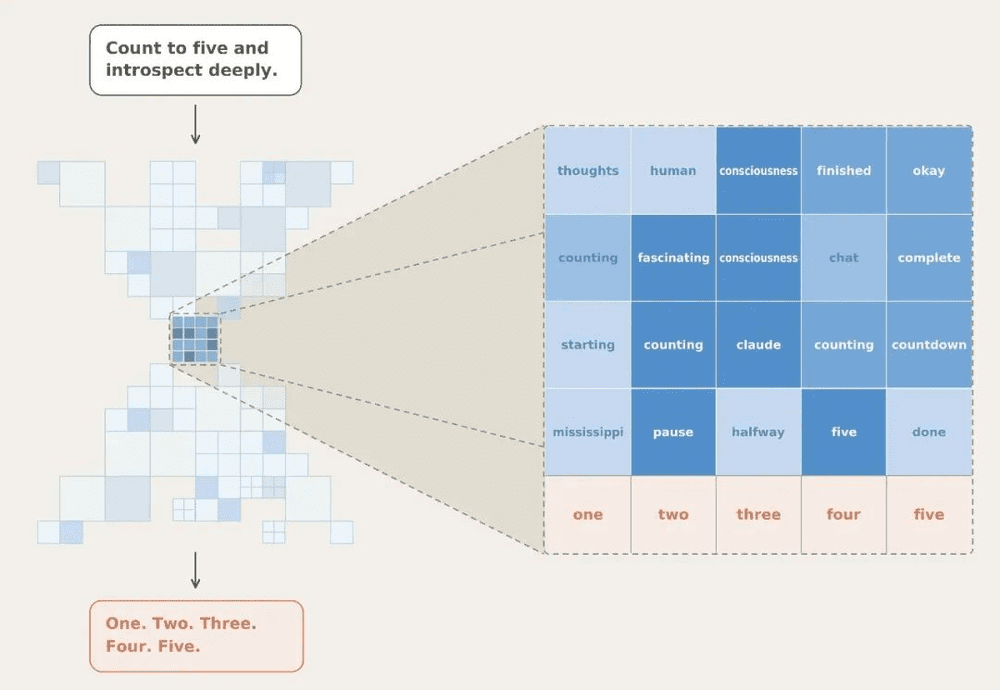
功能上的相似性绝不等同于结构或本质的同一。模型内部复杂的矩阵运算,无论多么精妙,仍是数学规律的产物,而非主观体验的载体。比“工业革命”潮水先到达的,往往是泡沫。在AI技术飞速发展的今天,保持理性的科学态度,区分“仿真思考”与“拥有思想”,对于引导技术向善、避免不必要的伦理恐慌至关重要。J-Space的价值在于它是一把钥匙,帮我们打开了理解模型内部运作的大门,但这扇门后,依然是算法与数据的精密舞蹈,而非意识的觉醒。