大模型巨头集体“造芯”:英伟达护城河正被算力主权瓦解
全球人工智能产业的底层逻辑正在经历一场静默却剧烈的重构。过去三年,公众和资本的注意力几乎完全集中在模型参数的规模、大语言模型的智能上限以及应用层的创新上。然而,随着行业进入深水区,竞争的核心要素发生了根本性转移:从“谁更聪明”转向了“谁更便宜”。这种转变并非源于技术的停滞,而是因为AI应用规模化的必然结果——推理成本的急剧攀升。在这一背景下,包括Meta、OpenAI、DeepSeek在内的全球顶级大模型公司,正以前所未有的速度加速自研芯片计划。这并非简单的技术尝试,而是一场关于“算力主权”的战略突围。英伟达,这家定义了AI硬件标准的霸主,正面临着一个前所未有的悖论:它最忠实的客户,正在成为它最危险的竞争对手。
从供应商到竞争者:客户名单的彻底洗牌
回顾半导体历史,巨头往往死于外部颠覆者或技术范式的转换,而非其核心客户的反向攻击。但今天,英伟达面临的局面截然不同。路透社披露,Meta计划于2026年9月量产代号为“Iris”的第四代自研AI芯片,该芯片由Meta与博通联合设计,台积电制造,专门针对其庞大的社交网络与大模型推理需求定制。与此同时,OpenAI发布的Jalapeño推理芯片已投入生产,DeepSeek也秘密启动自研项目一年有余,智谱AI同样在探索与国内ASIC厂商的合作。
这一系列动作并非孤立事件,而是行业共识的体现。Forrester分析师Mike Gualtieri曾指出,依赖外部芯片将使企业永远无法成为真正的AI巨头。这句话深刻揭示了巨头们的动机:当算力成为如同电力般的基础生产资料,将其命脉完全交予单一供应商是不可接受的战略风险。Google早在十年前便布局TPU,Amazon推出Trainium,微软推出Maia,这些早期布局者已验证了自研芯片在成本控制上的巨大优势。如今,曾经的“跟随者”们试图复制并超越这一路径,试图在底层硬件层面建立自己的护城河。
这种“去英伟达化”的趋势,首先体现在对定价权和供应链安全的掌控上。英伟达的黑well系列芯片虽然性能强劲,但其高昂的售价和有限的产能,使得采购成本成为AI公司沉重的负担。摩根士丹利提出的“芯片通胀”概念,准确描述了GPU、HBM(高带宽内存)及高速光模块价格持续上涨的现状。对于每年投入数百亿美元基建的巨头而言,任何微小的成本降低,乘以数万亿次的推理调用,都能转化为巨大的利润空间。因此,自研芯片不仅是技术炫技,更是生存刚需。
推理时代的经济账:Token成本决定生死
理解这场芯片竞赛的关键,在于区分“训练”与“推理”不同的经济逻辑。在模型训练阶段,算力需求集中且爆发力强,对精度、互联带宽的要求极高,英伟达的GPU集群凭借成熟的软件栈(CUDA)和硬件性能,目前仍占据主导地位。然而,训练只是一次性行为,而推理则是持续性、高频次的消费行为。每一次用户提问、每一个AI Agent的工具调用,都在消耗GPU算力。
这里存在一个决定性的数学题:如果一个Token的成本是0.01美元,日调用量达到100亿次,年消耗将达365亿美元。若能将单Token成本降低50%,利润即可翻倍。这种边际效益的驱动,使得AI公司不惜重金投入硬件研发。推理场景对芯片的要求与训练截然不同:它不需要极致的峰值算力,而是更关注能效比、延迟、吞吐量以及部署灵活性。ASIC(专用集成电路)在这些维度上天生具有优势,因为它可以根据特定的算法架构进行定制化优化,剔除冗余电路,从而在特定任务上实现比通用GPU更高的性能价格比。
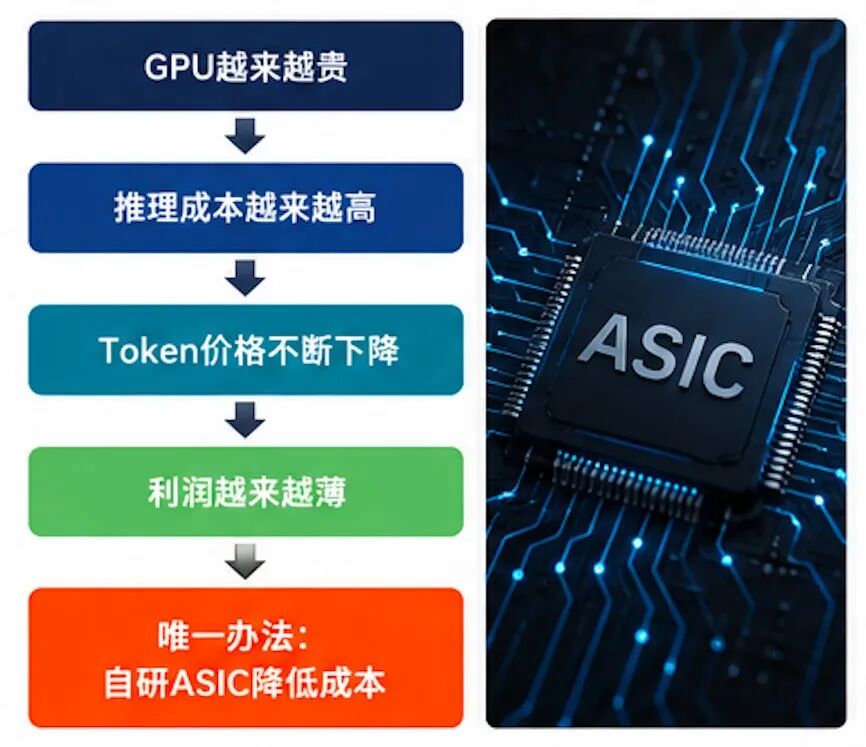
OpenAI的Jalapeño、Google的TPU以及DeepSeek自研芯片,均聚焦于推理场景。它们证明了一个事实:在推理领域,通用性让位于效率。随着AI应用从“尝鲜”走向“日用”,推理算力的消耗将呈指数级增长。英伟达若不能在推理芯片领域提供足够的成本竞争力,其最赚钱的业务板块将面临被蚕食的风险。这不仅是市场份额的流失,更是其商业模式根基的动摇——当客户发现自研芯片能以更低成本提供同等甚至更优的服务时,英伟达的议价能力将急剧下降。
全栈战争:重构AI基础设施生态
大模型公司自研芯片的背后,是一场从应用层向基础设施层延伸的“全栈战争”。未来的AI竞争,不再是单项能力的比拼,而是整个技术栈的协同效应。苹果的成功并非仅因A系列芯片,而是芯片、iOS、App Store与开发者生态形成的闭环。AI产业正走向同样的道路:模型是入口,芯片是底座,云平台是载体,软件栈是粘合剂。
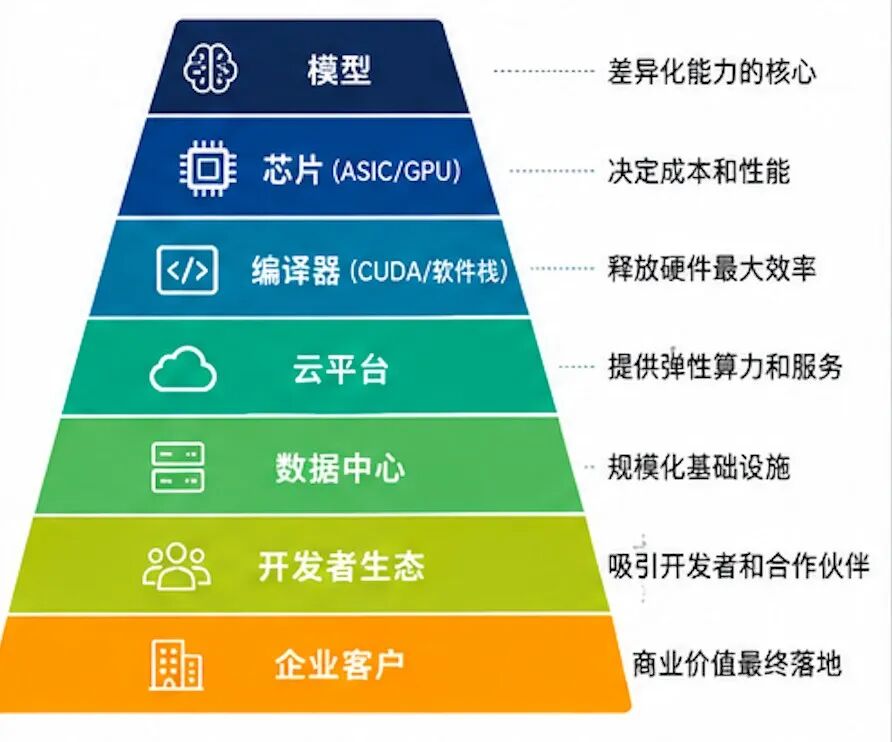
Google拥有Gemini模型、TPU芯片、Google Cloud以及全球光纤网络;Meta拥有Llama系列、MTIA芯片、庞大的数据中心和社交网络;OpenAI则布局Jalapeño芯片、Stargate数据中心,并与Oracle等构建算力联盟。这种垂直整合使得企业能够优化从算法到硬件的每一层细节,实现软硬件协同加速。例如,模型结构的微调可能促使芯片架构的变更,而芯片特性的变化又会反过来影响模型的设计。这种深度耦合带来的效率提升,是分散式供应链无法比拟的。
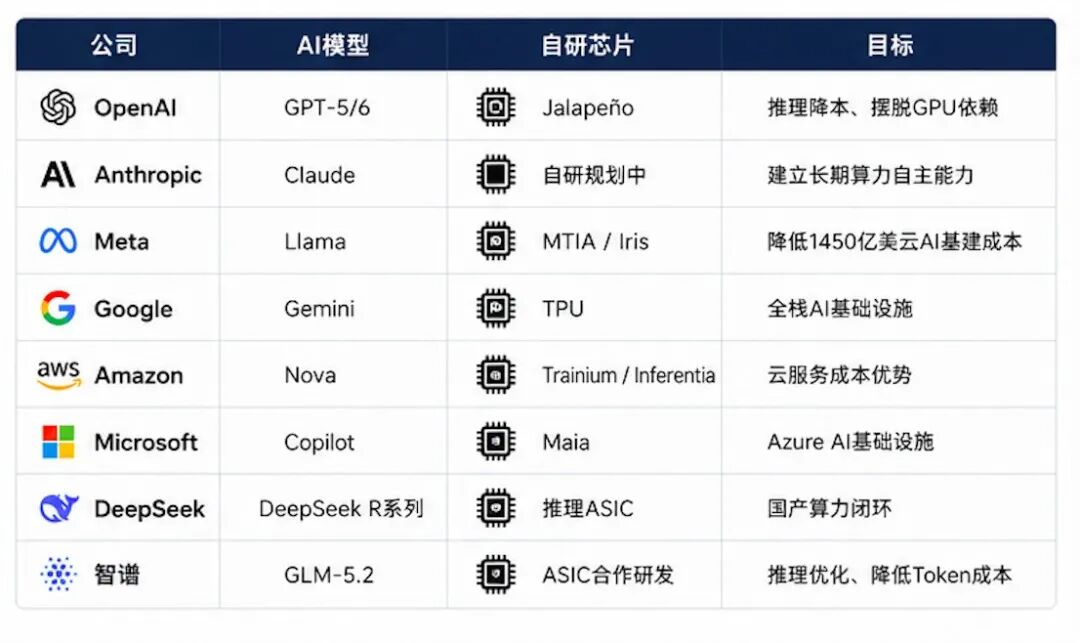
此外,这种全栈战略还赋予了企业更强的抗风险能力。在地缘政治不确定性增加的今天,供应链的安全至关重要。通过自研芯片,巨头们可以 diversify 供应来源,减少对单一供应商的依赖。同时,他们可以根据自身业务特点定制数据中心的冷却系统、电源管理甚至网络拓扑,进一步优化整体TCO(总拥有成本)。这种系统级的竞争力,将成为未来AI巨头最核心的壁垒。
中国AI的突围:算力主权与国产替代
对于中国企业而言,自研芯片的意义更为深远,它关乎算力主权与技术自主。美国对先进GPU出口的限制,使得中国AI企业难以获取最新的英伟达硬件。HBM供应受限、CUDA生态壁垒、先进制程约束,这些因素共同构成了中国AI发展的外部阻力。在这种环境下,依赖进口GPU不仅成本高昂,更存在断供风险。
因此,DeepSeek、智谱等企业的芯片布局,不仅是成本驱动,更是战略必需。通过自研推理芯片,中国企业可以绕过部分限制,利用成熟的先进制程和国产HBM,构建自主可控的算力体系。与此同时,华为昇腾、寒武纪、沐曦等国产芯片企业正在加速追赶,形成多元化的国产AI生态。据伯恩斯坦预测,英伟达在中国AI半导体市场的份额将从2025年的40%降至2026年的8%,而国产芯片供应商将占据近80%的市场份额。这一结构性逆转,标志着中国AI产业正在从“应用创新”向“基础软硬件协同创新”转型。
这种转型并非易事。中国芯片产业在EDA工具、IP核、制造良率等方面仍面临挑战。然而,巨大的市场需求和应用场景优势,为国产芯片提供了宝贵的迭代机会。DeepSeek通过优化国产芯片适配,实现了API价格的显著降低和性能的保持,便是软硬件协同优化的成功案例。未来,中国AI的竞争格局将是“模型+国产芯片+国产云+国产数据中心”的整体竞争,任何单一环节的短板都可能成为瓶颈。
英伟达的十字路口:防御与转型的双重挑战
英伟达的困境,本质上是技术范式转换与商业生态演进的双重挑战。在训练市场,英伟达仍拥有绝对优势,CUDA生态的粘性极高,短期内难以被完全替代。但在推理市场,随着ASIC和自研芯片的成熟,英伟达的市场份额将被逐步侵蚀。这种侵蚀不会一夜发生,但会像云计算取代本地服务器一样,缓慢而不可逆。
英伟达的应对策略至关重要。一方面,它需要继续在训练芯片上保持技术领先,巩固CUDA护城河;另一方面,它必须拓展其在推理市场的竞争力,例如通过推出更灵活的定制芯片服务或优化Grace Hopper等新品类,以应对ASIC的挑战。此外,英伟达还需重新审视其与客户的关系,从单纯的供应商转变为合作伙伴,共同优化AI基础设施。然而,商业逻辑决定了巨头们必然追求自主可控,英伟达与客户之间的博弈将是长期的。
这场“算力主权战争”没有最终的赢家,只有适应者。对于英伟达而言,真正的危险不在于失去某个大客户,而在于整个AI产业底层逻辑的改变:算力不再仅仅是商品,而是战略资源。当所有巨头都成为芯片设计者,英伟达必须从“卖铲人”转型为“提供全套采矿方案”的伙伴,否则,它的“四面楚歌”才刚刚开始。未来,AI基础设施的多元化、碎片化与定制化,将成为常态。谁能在这其中找到新的平衡点,谁就能在下一个十年继续领跑。