OpenAI发布GPT-5.6:以iPhone式分级策略重塑大模型性价比竞争
人工智能行业正在经历一场从“唯性能论”向“性价比论”的深刻转向。OpenAI 近期发布的 GPT-5.6 系列模型,不仅是其技术栈的一次重大迭代,更标志着大模型产品策略正式进入了一个新的维度:通过精细化的产品分级和极致的成本控制,将 AI 从“极客玩具”转变为“大众生产力工具”。
这一转变的核心在于,OpenAI 意识到单纯的性能竞赛已触及边际效用递减的瓶颈,而如何在保证效果的前提下降低使用门槛,才是决定 AI 能否真正融入社会基础设施的关键。GPT-5.6 的发布,实质上是在回答一个问题:当算力成本不再呈指数级下降时,如何通过产品工程学的优化,让企业和个人用户以更低的代价获得同等甚至更优的智能服务?
分级策略:重新定义用户的选择逻辑
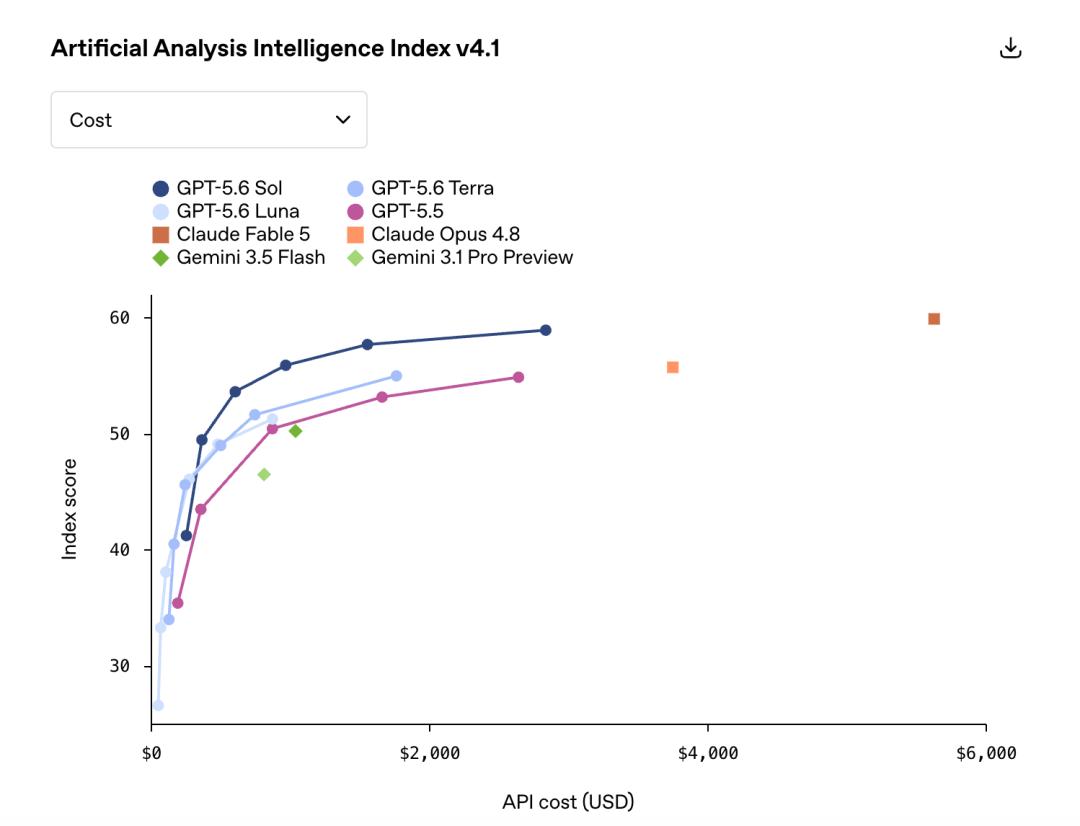
回顾 GPT-5.6 的产品架构,最引人注目的变化莫过于其命名体系与产品线划分。OpenAI 此次推出了 GPT-5.6 Sol、Terra 和 Luna 三个版本,分别对应太阳、地球和月亮。这种命名看似浪漫,实则隐藏着清晰的市场定位逻辑:Sol 作为旗舰,提供极致性能;Terra 作为主力,平衡性能与成本;Luna 作为入门,主打高性价比。
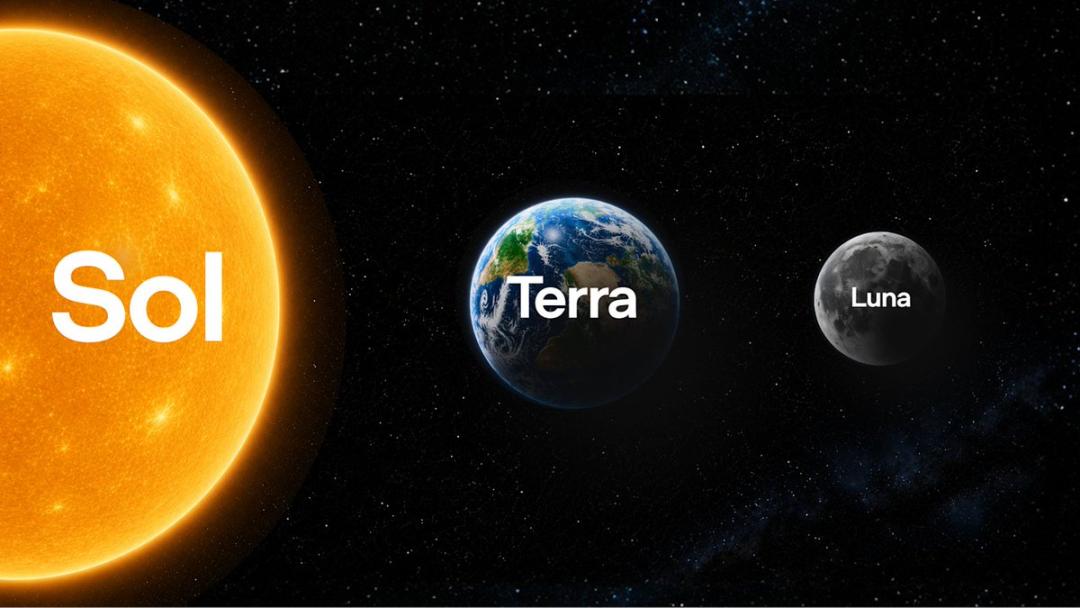
这种“代际+能力层级”的分级方式,极大地降低了用户的选择成本。对于普通用户而言,无需深入理解模型背后的参数差异,只需依据自身需求选择对应层级的版本即可。这种策略与苹果在 iPhone 产品线上的成功逻辑不谋而合。通过明确的品牌层级,OpenAI 成功地将复杂的 AI 技术能力转化为直观的消费者语言。
| 模型版本 | 定位描述 | 输入价格 (USD/百万token) | 输出价格 (USD/百万token) | 适用场景 |
|---|---|---|---|---|
| GPT-5.6 Sol | 旗舰性能,最强推理 | $5.00 | $30.00 | 复杂科研、高精度代码、关键决策 |
| GPT-5.6 Terra | 日常主力,平衡之选 | $2.50 | $15.00 | 常规办公、内容创作、日常咨询 |
| GPT-5.6 Luna | 入门首选,极致性价比 | $1.00 | $6.00 | 简单问答、批量处理、轻量任务 |
从定价策略来看,Terra 和 Luna 的推出,直接击中了长期以来困扰 AI 应用的痛点:高昂的 Token 消耗。GPT-5.6 Terra 的性能已与上一代 GPT-5.5 相当,但成本更优;而 Luna 则以更低的门槛,让海量长尾用户得以接入先进的 AI 能力。这种分级策略不仅扩大了用户基数,也为 OpenAI 构建了更稳固的商业护城河。
核心突破:从“能回答”到“能干活”
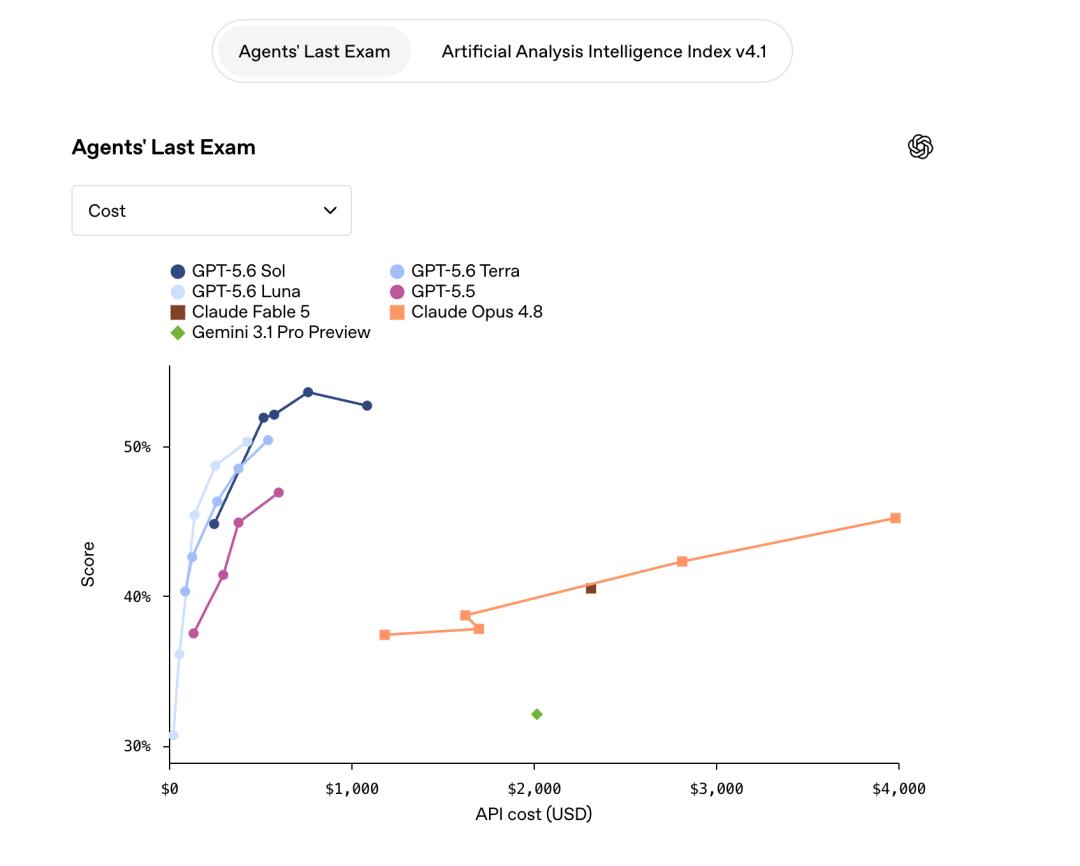
如果说分级策略是表面的包装,那么底层能力的提升则是 GPT-5.6 的真正硬核所在。OpenAI 此次重点展示了 GPT-5.6 在“自主完成任务”方面的突破,特别是通过新增的 Agent's Last Exam (ALE) 基准测试进行了量化验证。
ALE 测试并非传统的知识问答或代码编写测试,而是模拟真实职场环境,要求 AI 独立、端到端地完成具有实际经济价值的数字化工作。测试涵盖了 55 个行业、1500 多个任务,旨在衡量 AI 是否像真正的员工一样,能够理解目标、规划步骤并执行结果。
在这一极具挑战性的测试中,GPT-5.6 Sol 取得了 56.3 分的最高分,显著优于主要竞品 Claude Opus 4(注:原文提及 Fable 5,此处指代顶级竞品模型)。更令人瞩目的是,GPT-5.6 Sol 在中等推理水平下,其得分依然领先,且成本仅为竞品的四分之一。这一数据揭示了一个关键趋势:AI 的价值不再仅仅体现在单次问答的智能程度,更体现在其执行复杂工作流的经济效率上。
为了支撑这种复杂任务的执行,GPT-5.6 引入了两项创新的推理模式:“Max”推理和“Ultra”模式。
- Max 推理模式:允许模型在面对数学证明、复杂规划等高难度任务时,投入更多的计算时间和资源进行深度思考。这种“慢思考”机制显著提高了复杂任务的完成率,解决了以往大模型在逻辑推导中容易犯错的痛点。
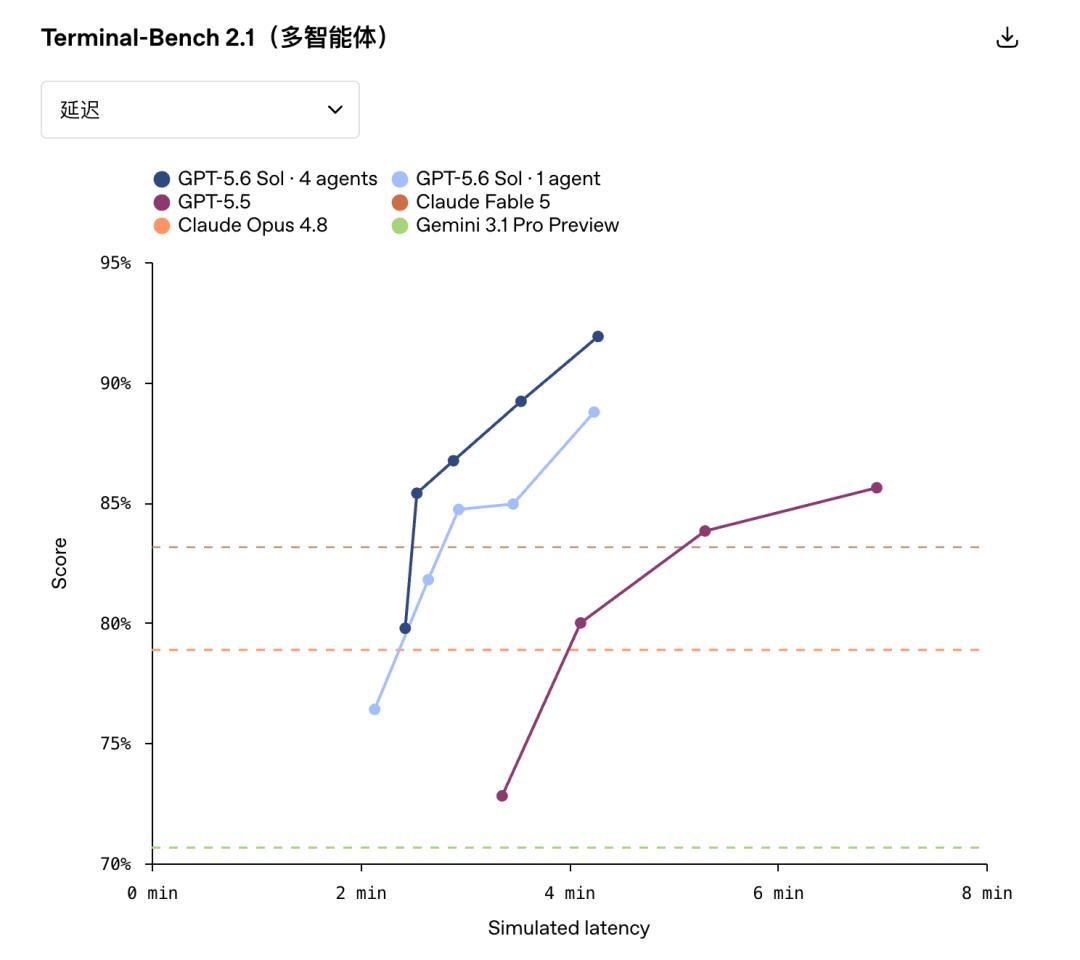
- Ultra 模式:这是一种模拟团队协作的并行处理机制。该模式能够协调四个子智能体,分别处理任务的不同模块,最后整合输出。在 Terminal-Bench 2.1 等基准测试中,多智能体协作的效率远超单一大模型,更接近人类团队的工作模式。这种架构创新,预示着未来 AI 应用将从“单兵作战”向“团队协同”演进。
场景深化:办公、安全与科研的全面渗透
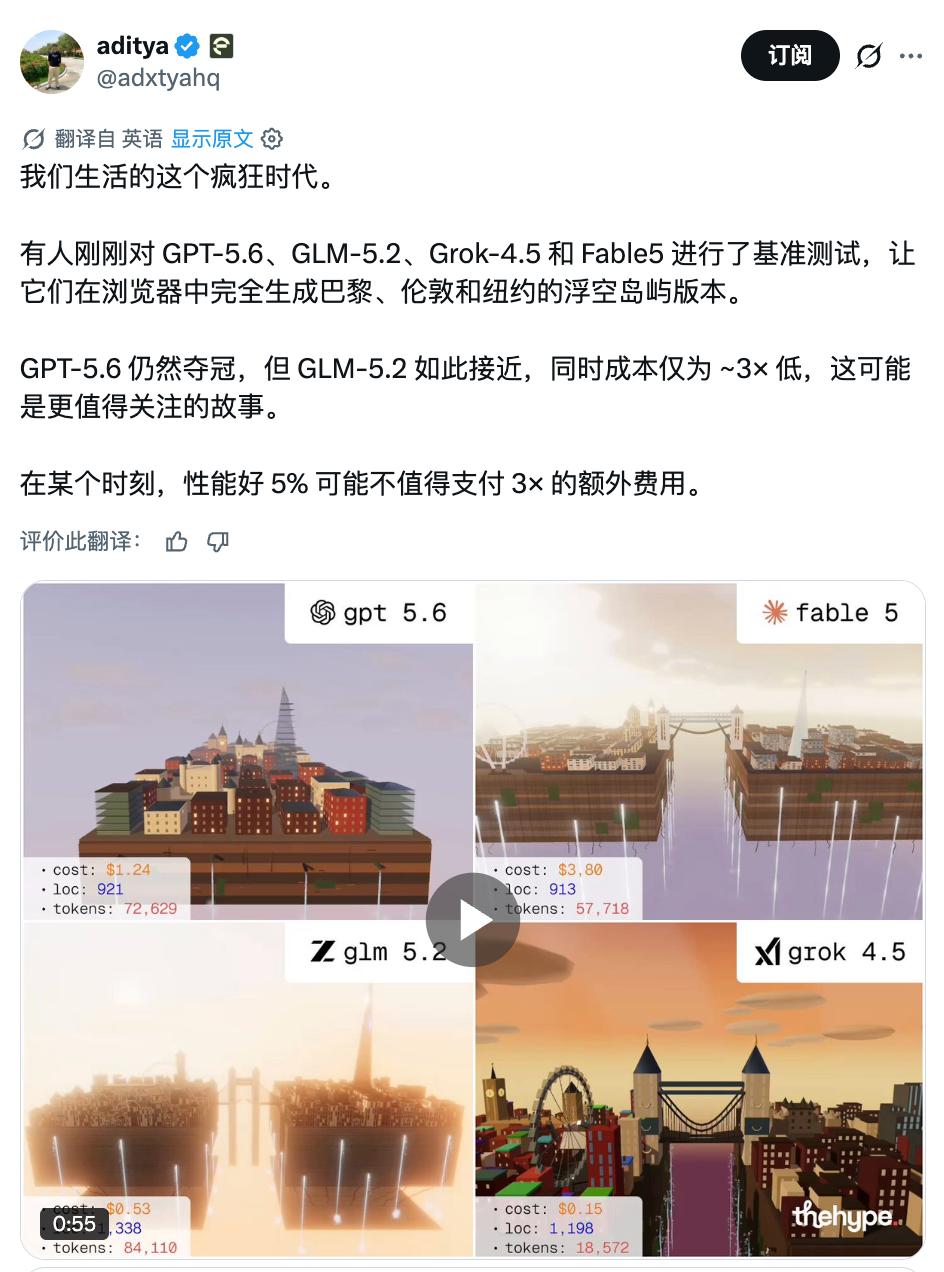
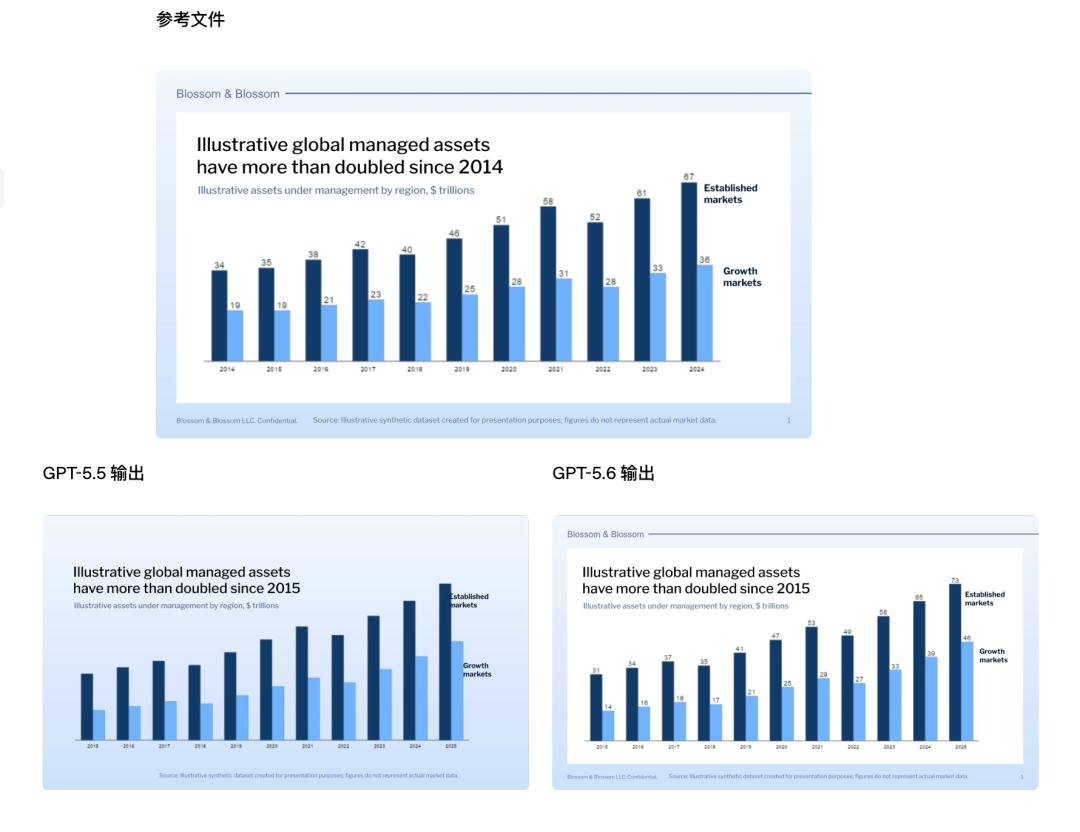
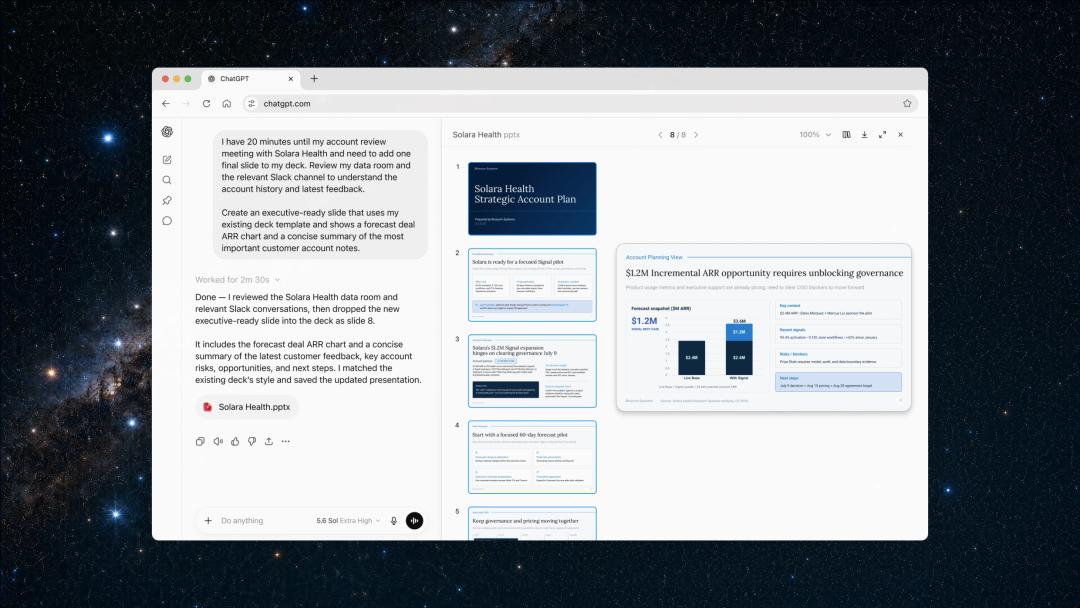
GPT-5.6 的能力提升不仅体现在基准测试的分数上,更反映在具体应用场景的体验优化中。在办公领域,模型对 PPT、Word 和 Excel 等文档生成的支持达到了新的高度。通过引入模板参考机制,GPT-5.6 能够生成格式更精美、内容更准确的文档,极大地提升了白领用户的生产力。
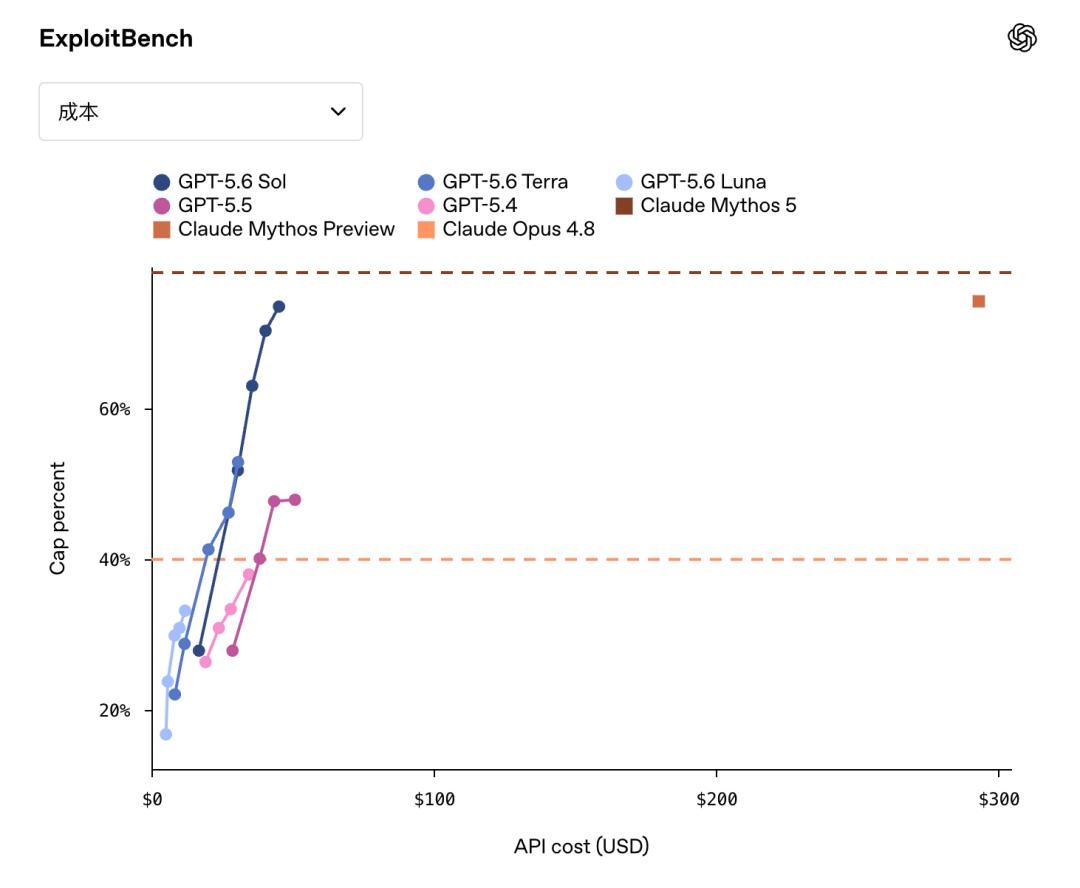
在网络安全领域,GPT-5.6 表现出显著的攻防优势。在漏洞发掘和利用测试中,该模型能够在消耗更少 Token 的情况下,达到与竞品相当的效果。这意味着,企业在部署 AI 辅助安全审计时,不仅获得了更强的检测能力,还降低了运营成本。这对于对安全响应速度要求极高的企业而言,是一个极具吸引力的卖点。
此外,在生物化学等科学研究领域,GPT-5.6 Sol 在成本和速度上的双重优势,使其成为科研人员的高效助手。无论是文献综述、实验设计还是数据分析,AI 的低成本介入正在加速科学发现的进程。这种“低成本、高效率”的组合,正是当前科研经费紧缩背景下,学术界和工业界最迫切的需求。
竞争格局:全球混战与本土挑战
尽管 GPT-5.6 在性能和成本上取得了显著进步,但其面临的竞争环境依然严峻。特别是在全球 Token 消耗量激增的背景下,如何控制成本成为各大厂商的核心竞争力。
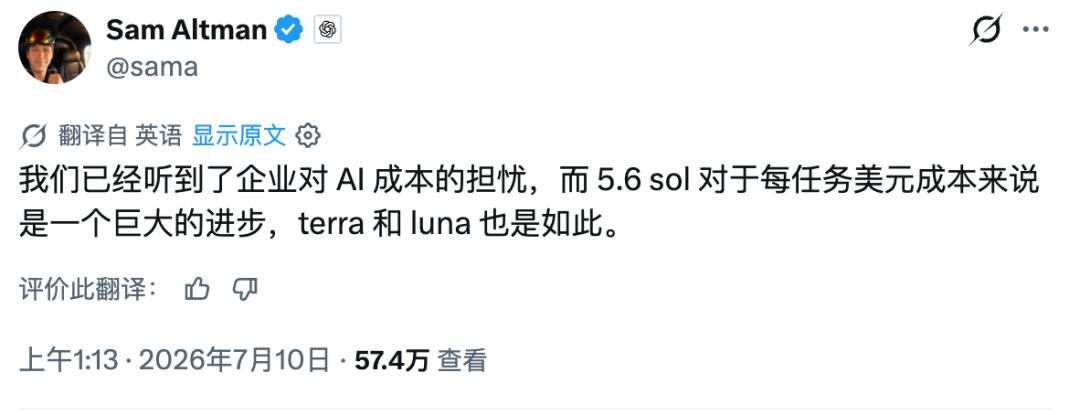
OpenAI CEO 萨姆·奥特曼在社交媒体上明确表示,降低企业的 AI 使用成本是公司当前的首要任务。GPT-5.6 的定价策略,正是对这一承诺的回应。与之前的版本相比,新模型在同等效果下的 Token 消耗大幅降低,直接减轻了用户的经济负担。
然而,来自亚洲市场的挑战不容忽视。以 DeepSeek 为代表的中国大模型厂商,凭借极致的成本控制和技术优化,在全球市场上发起了强劲的挑战。DeepSeek V4 的输入价格仅为 0.44 美元/百万 Token,远低于 OpenAI 的 5 美元。这种巨大的价格差距,使得 OpenAI 在低端市场面临严峻的流失风险。
| 模型厂商 | 代表产品 | 输入价格 (USD/百万token) | 输出价格 (USD/百万token) | 市场策略 |
|---|---|---|---|---|
| OpenAI | GPT-5.6 Luna | $1.00 | $6.00 | 降低门槛,扩大用户基数 |
| Anthropic | Claude Opus 4 | $15.00+ | $75.00+ | 坚持高端,强调安全与推理 |
| DeepSeek | V4 | $0.44 | $0.88 | 极致低价,颠覆性竞争 |
| Grok | 4.5 | $2.00 | $6.00 | 中端定位,性价比突围 |
这种价格战并非简单的恶意竞争,而是技术成熟度提升的必然结果。随着模型蒸馏、量化技术以及推理优化的进步,大模型的边际成本正在快速下降。未来,大模型的竞争将不再是单纯的性能比拼,而是“性能-速度-成本”三维平衡的艺术。
未来展望:AI 基础设施的平民化之路
GPT-5.6 的发布,标志着 AI 技术正式迈入“平民化”阶段。通过精细化的产品分级和持续的成本优化,OpenAI 正在努力消除 AI 使用的高门槛,使其成为像水电煤一样普及的基础设施。
从长远来看,这种趋势将催生更多垂直领域的 AI 应用。当使用成本足够低时,企业将敢于在更多边缘场景和长尾需求中部署 AI,从而释放出巨大的经济价值。例如,在小型制造业的质量检测、个性化教育的辅助教学、甚至是家庭生活中的智能管家,AI 都将展现出巨大的潜力。
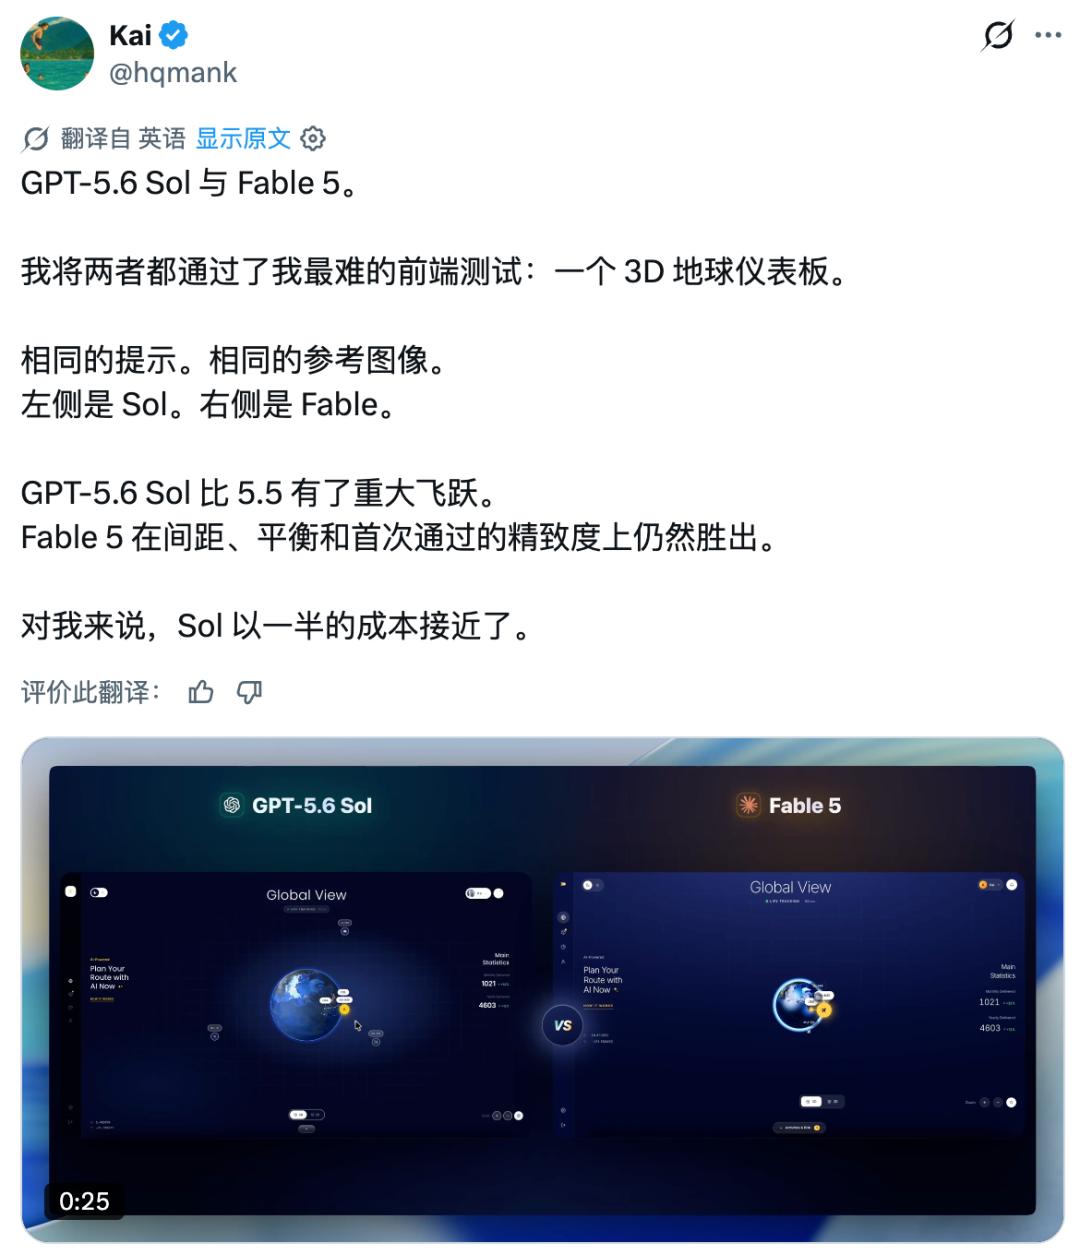
同时,我们也应看到,尽管 GPT-5.6 在诸多方面取得了进步,但在视觉生成、前端动画设计等特定领域,与部分竞品相比仍存在差距。这表明,通用大模型的发展仍面临诸多挑战,需要在多模态融合和细节控制上持续突破。
最终,这场 AI 大模型的混战,胜者未必是最聪明的那个,而是最能贴近用户需求、最能以合理成本解决实际问题的那个。OpenAI 通过 GPT-5.6 展示的这条路径,或许正是行业未来的共同方向:在技术的冷峻与商业的温度之间,找到最佳的平衡点。随着更多厂商加入这场“降本增效”的竞赛,我们将见证一个更加普及、更加智能、也更加普惠的 AI 时代的到来。