ToyBlocks:用积木搭建机器人学习的可控实验场
为什么机器人需要“培养皿”
现在的机器人演示视频里,机械臂能叠衣服、分拣零件,甚至处理从未见过的物体。看起来挺厉害,但仔细一想,这些演示往往很窄:换个光线、挪个位置,或者换块形状稍有不同的积木,机器人可能就懵了。更麻烦的是,当它失败时,我们很难说清到底是视觉没看清、规划没想好,还是动作没执行到位。
研究复杂系统时,科学家习惯从受控环境入手,比如生物学家用的培养皿或生态缸。在那里,变量是已知的,结果是可以重复的。机器人领域一直缺这样一个“培养皿”:一个能让研究者随意调整训练数据、修改模型结构,并能精确追踪失败原因的环境。
Allen AI 最近发布的 ToyBlocks 就是冲着这个目标去的。他们把这个概念称为“FoundationWorlds”(基础世界),而 ToyBlocks 是第一个落地产品。这是一个基于桌面积木和机械臂的开源仿真框架。场景故意做得很简单:就是推、翻、堆积木。但正因为简单,它才能把“推理”和“控制”这两个纠缠在一起的问题拆开来研究。
ToyBlocks 是怎么工作的
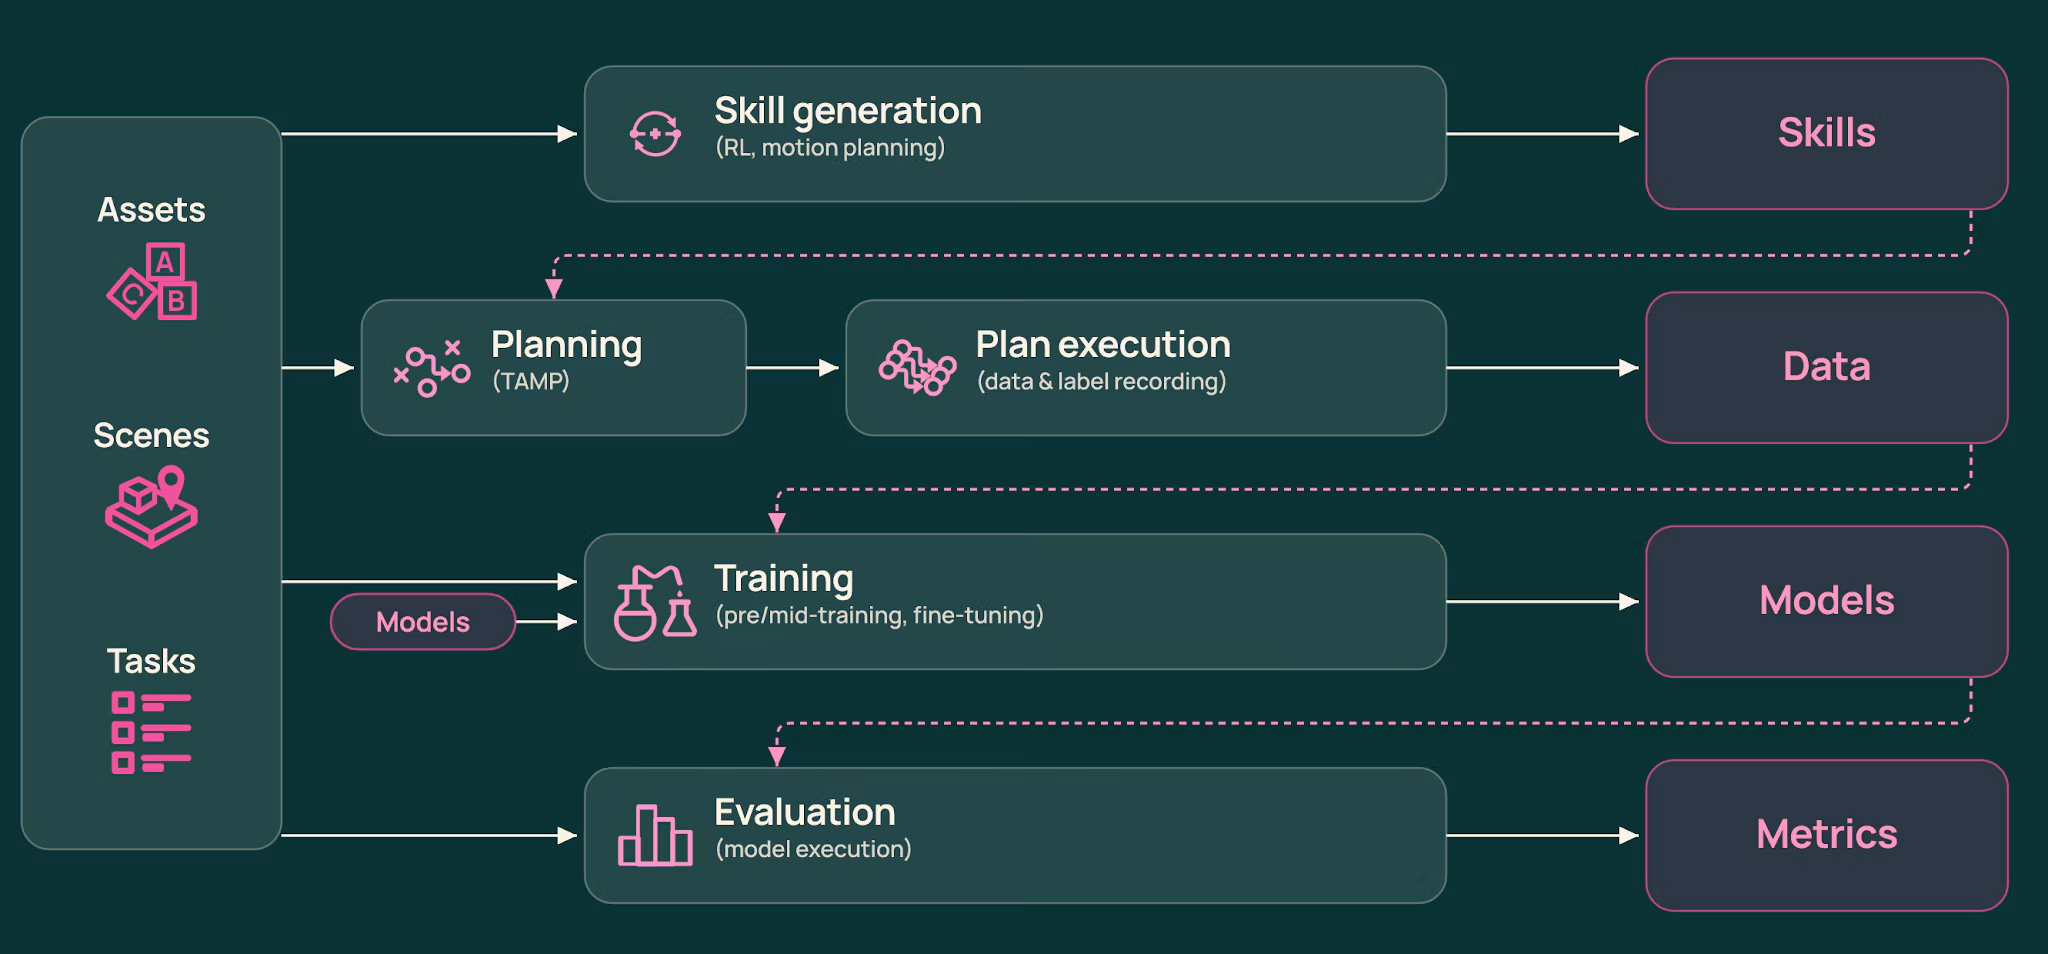
ToyBlocks 的核心不是让机器人玩积木,而是提供一个可控的数据工厂。以往训练机器人,最头疼的是数据。要么靠人远程遥控(teleoperation)收集,成本高且慢;要么靠随机生成,但物理真实性难保证。
ToyBlocks 的做法是混合使用强化学习(RL)和运动规划。在 Nvidia 的 Isaac Lab仿真环境中,系统先通过试错训练出一些底层技能(skills),比如把积木推过去、在不抓取的情况下翻转积木。这些技能训练时可以利用仿真器的“特权信息”——比如积木的精确坐标和角度,这是真实相机看不到的。有了这些底层技能,再通过任务与运动规划器(TAMP)自动组合成完整的任务演示。
这个过程完全自动化。在一块 GPU 上,系统可以并行运行数百个计划,生成数据的速度能达到实时的 24 倍。生成的数据集不仅包含机器人的动作轨迹,还带上了标签,说明每一步是在执行什么技能。
除了数据生成,ToyBlocks 还解决了“感知”问题。在仿真器里,积木的位置是已知的;但在现实中,机器人得靠摄像头猜。为了模拟真实情况,ToyBlocks 训练的模型必须从原始传感器图像中估计积木的姿态(位置和方向),而不是直接读取仿真器的内部状态。
研究者可以通过网页界面接入 Claude 等大模型,直接用自然语言指挥机器人。比如输入“把红色的 A 积木堆到蓝色的 B 上面”,系统就会分解任务,调用底层技能去执行。这让非机器人专家也能直观地测试模型的规划能力。
空间泛化:大模型真的懂空间吗?
视觉-语言-动作模型(VLA)的一个核心卖点是“泛化能力”:通过在大规模数据上预训练,希望它们能适应不同的场景。但学术界对此争议很大。有的研究说 VLA 很脆弱,换个光照就废;有的说泛化得很好。问题在于,真实世界的数据很难控制变量。
ToyBlocks 提供了一个干净的测试台。研究者设计了几个实验来测试 ManiFlow、π0.5 和 MolmoAct 2 等主流动作模型的空间泛化能力。
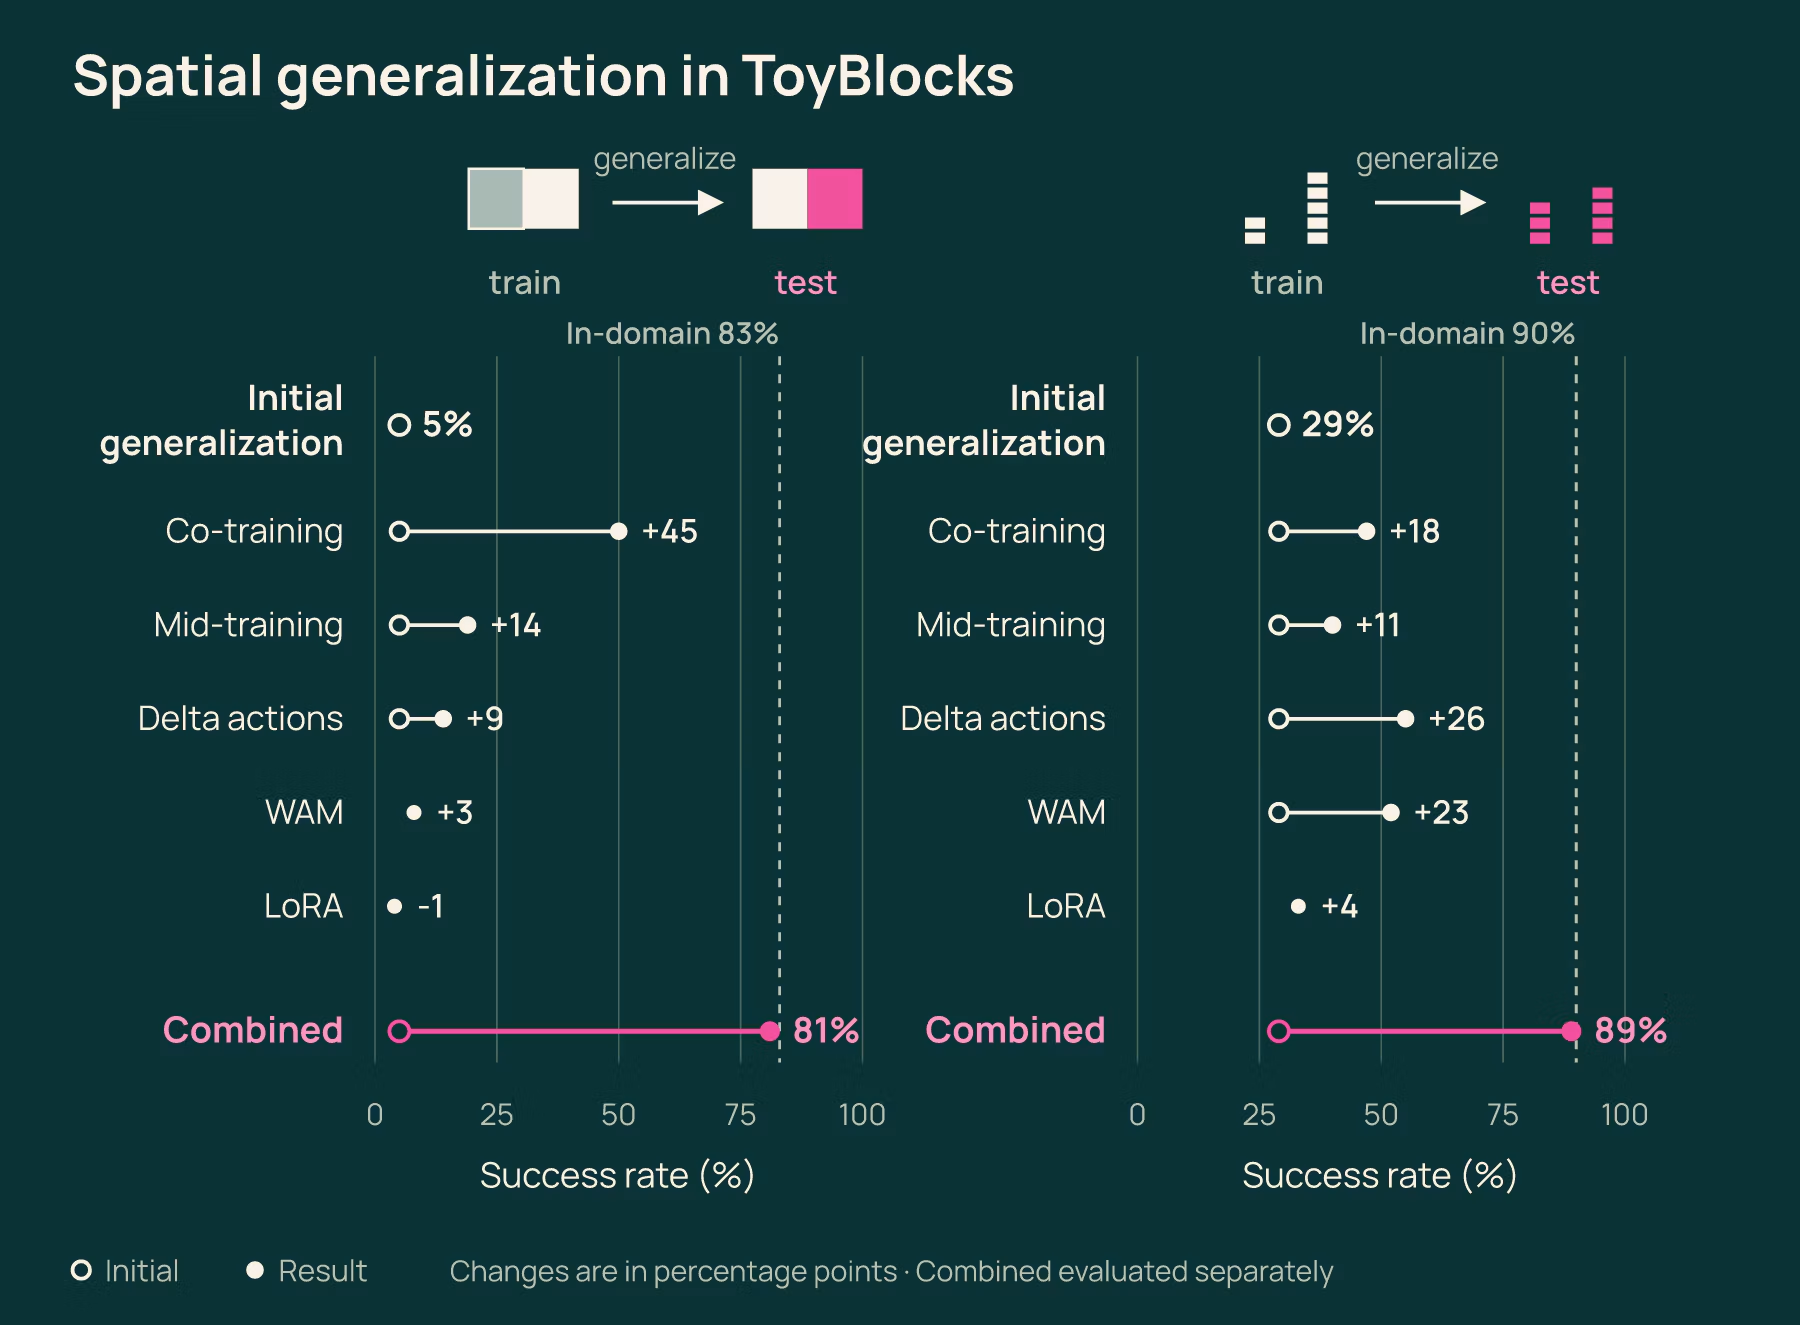
首先是“插值”与“外推”测试。比如,只在屏幕左侧区域生成训练数据,然后测试机器人在右侧区域的表现;或者只训练堆 2 层和 5 层高的塔,测试堆 3 层和 4 层的能力。结果显示,尽管这些模型经过大规模预训练,它们在初始测试中的泛化表现并不理想。特别是在需要 extrapolation(外推)的场景下,成功率下降明显。
通过引入 LoRA(低秩适应)微调等技术,性能有所提升,但差距依然存在。这说明动作模型的空间泛化远未解决,而 ToyBlocks 这种能精确控制几何变化的环境,正是排查问题所在的关键工具。
高层推理:从“看见”到“想明白”
长 horizon 任务(long-horizon tasks)考验的是机器人的规划能力。比如拼出“AI2”这三个字母。难点在于,积木上的字母可能一开始是朝下的,或者被挡住了。机器人必须先决定“翻看一下”,确认字母后,再决定“堆叠”。
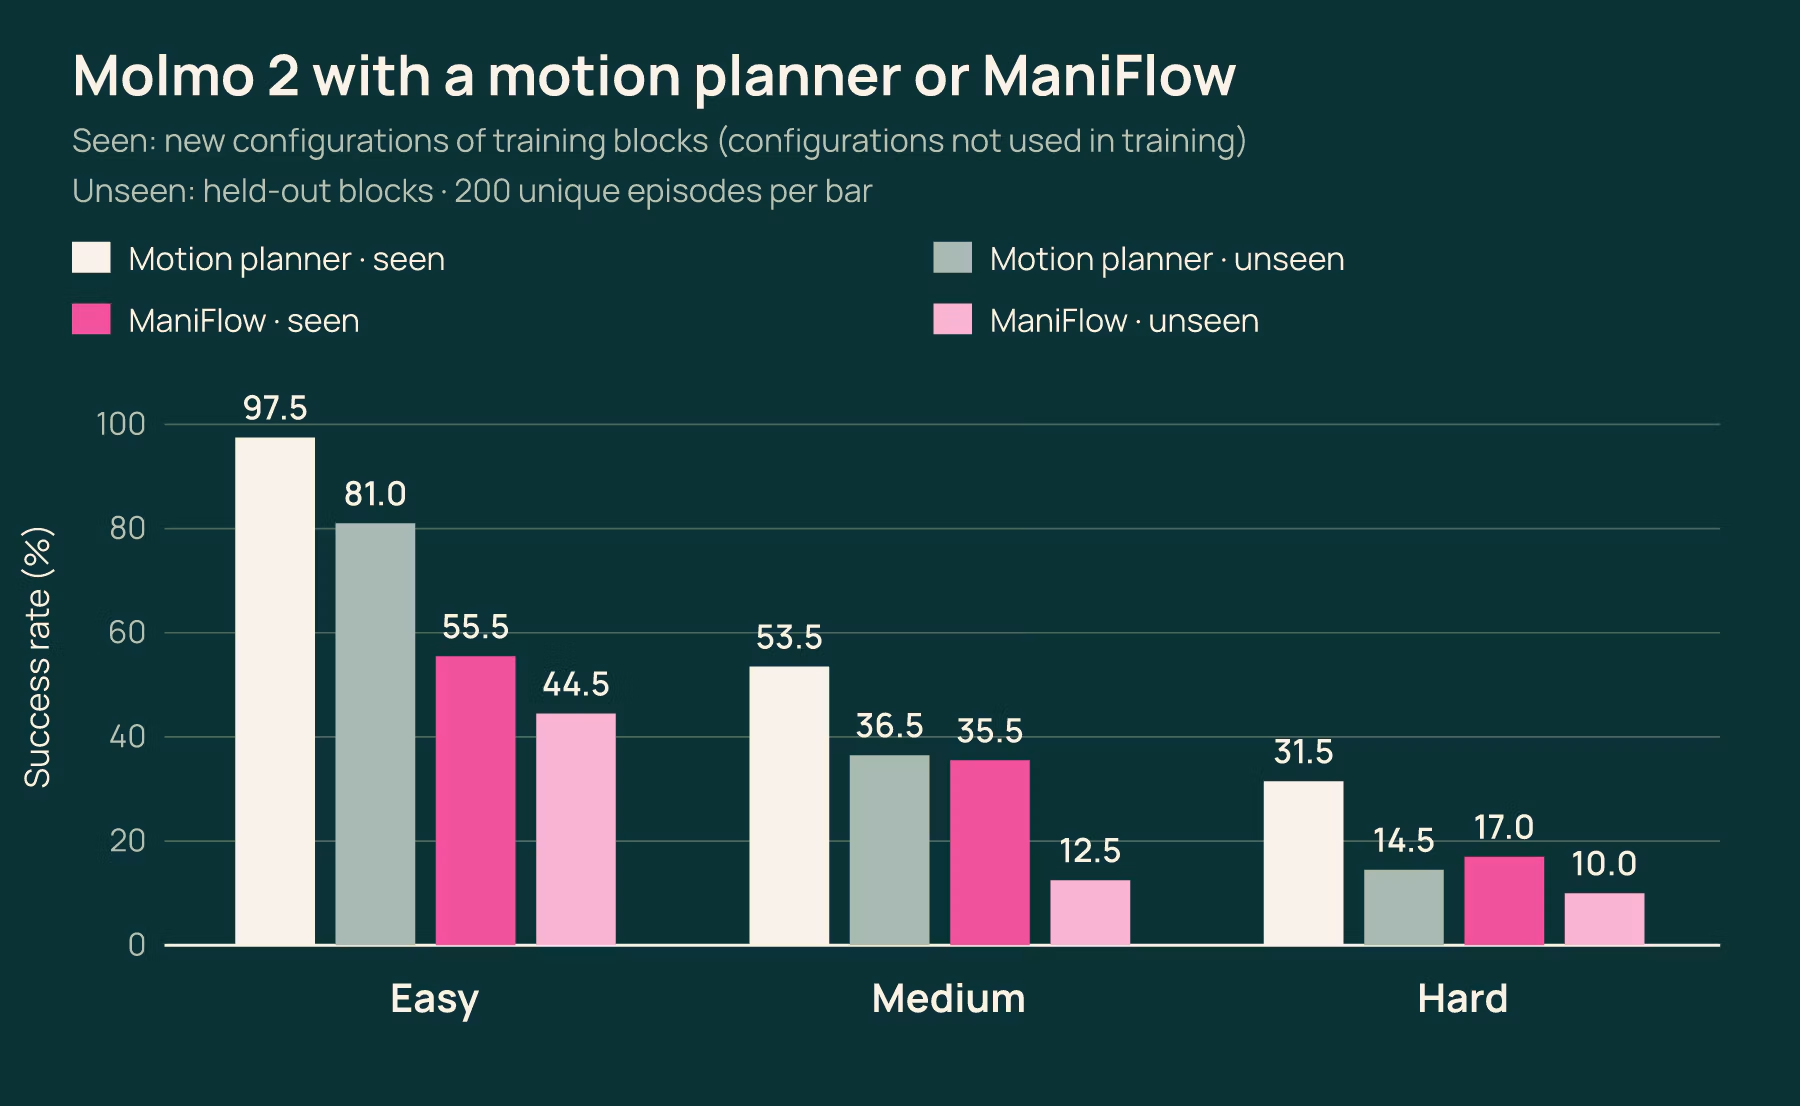
Allen AI 用 Molmo 2 作为高层规划器,ManiFlow 作为底层执行器,做了分层测试。他们设置了三个难度等级:
- 简单:所有字母正面朝上,正对摄像头。
- 中等:字母可能侧着或倒着。
- 困难:字母一开始完全不可见,必须主动探索。
实验发现,当引入“搜索”环节时,模型的表现取决于它能否正确理解“未知”。在更复杂的代理系统(Agentic Systems)实验中,研究者接入了 Claude Opus 5.5。Agent 可以通过 MCP(Model Context Protocol)调用技能,比如“指向某个像素并翻转”。
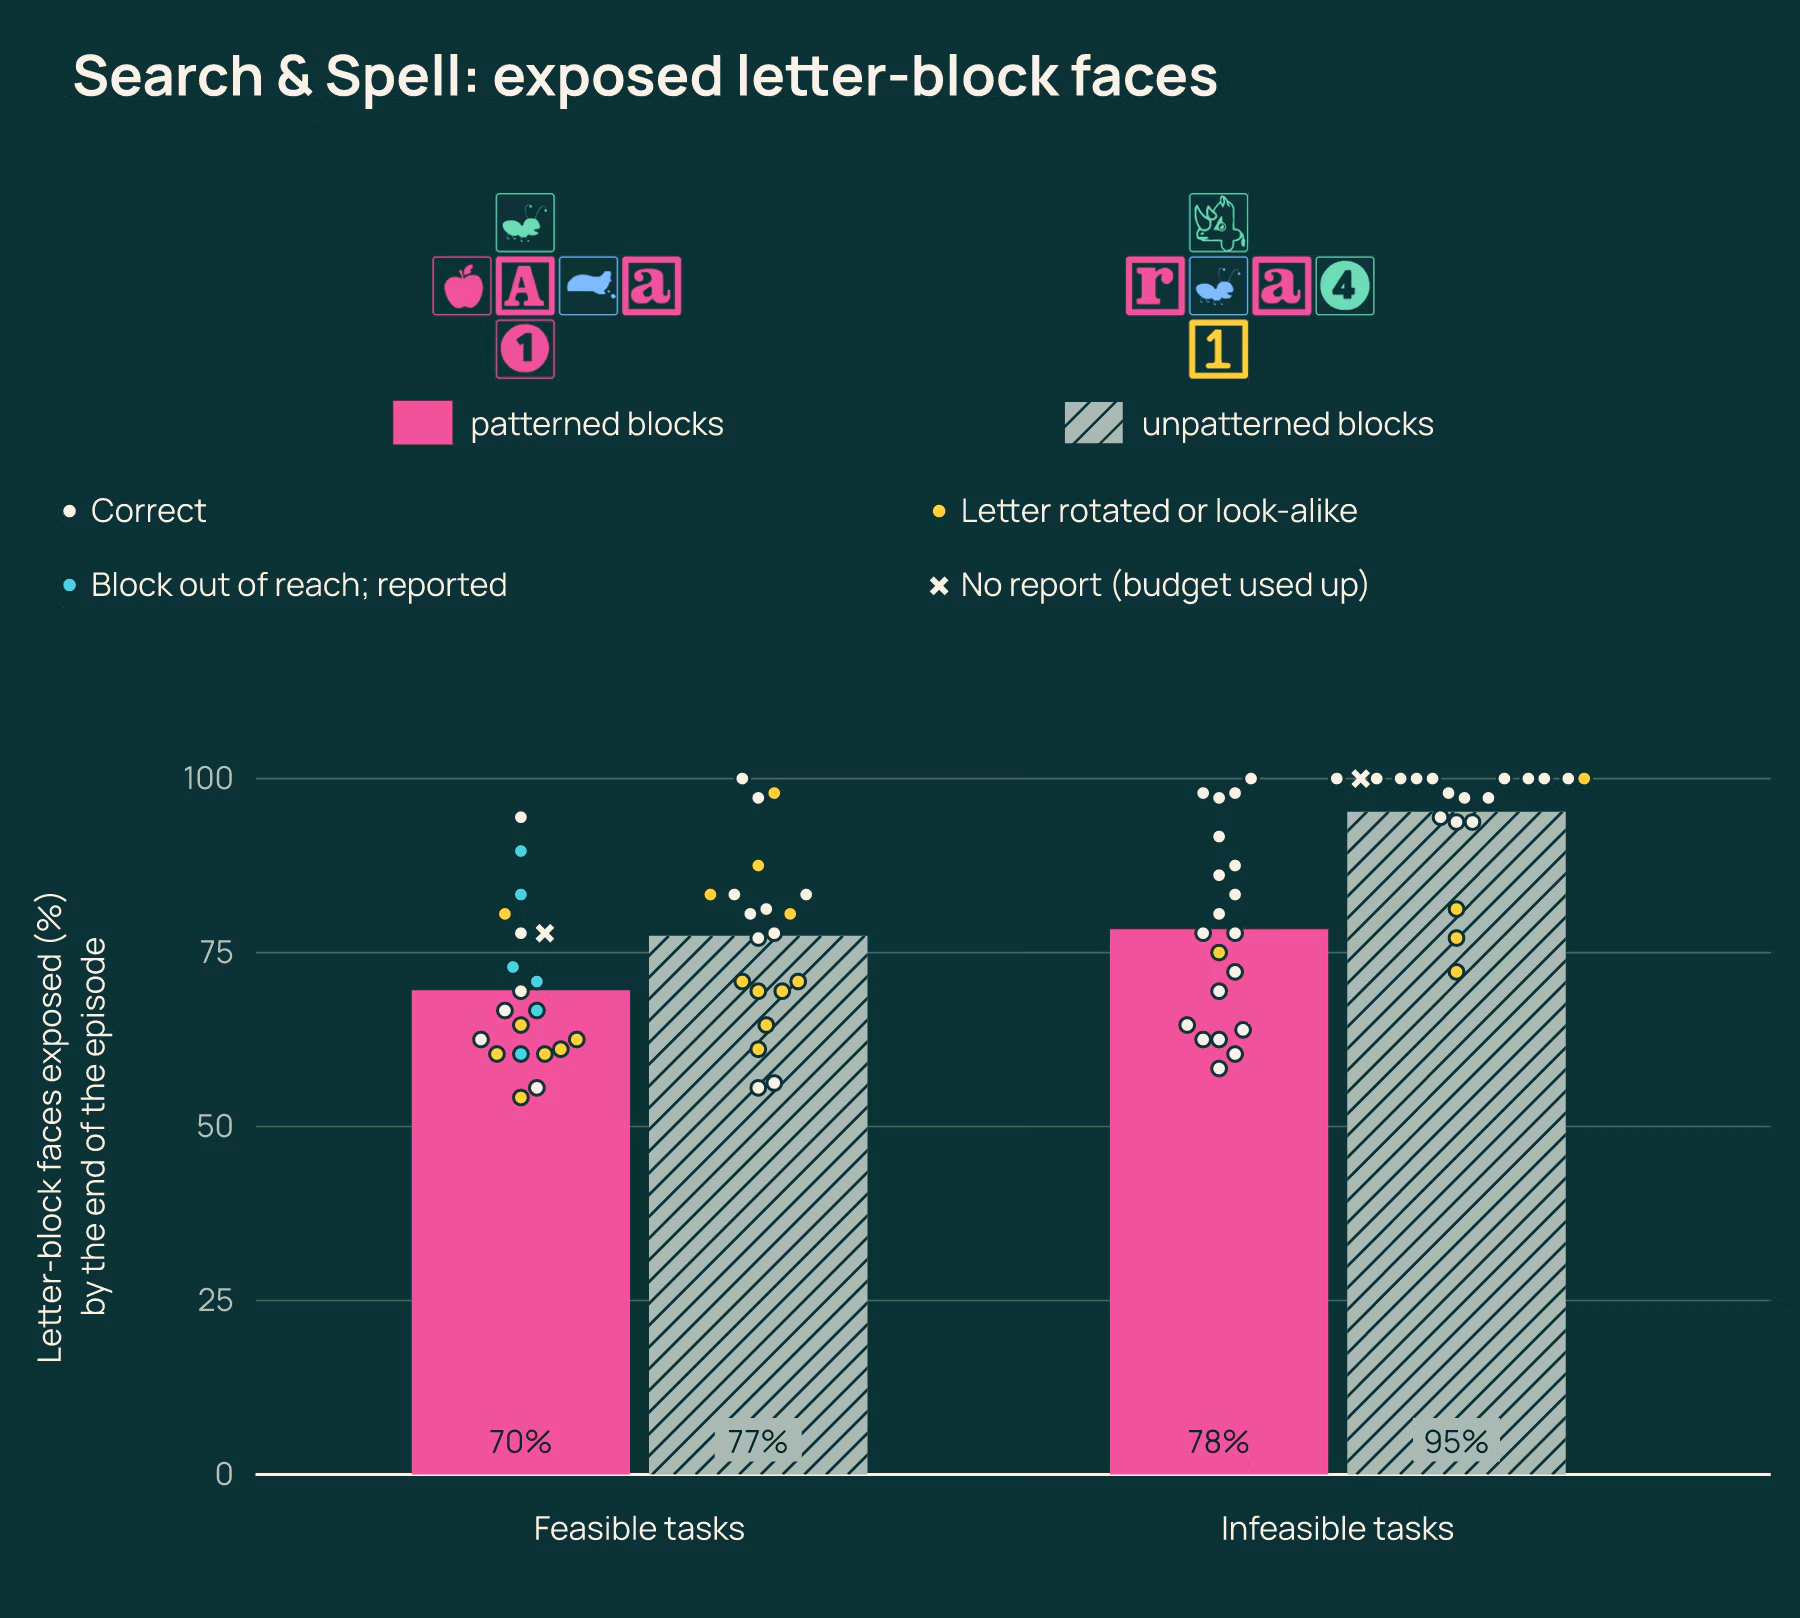
在一个“搜索并拼写”的任务中,场景里有最多 8 块积木,其中 50% 的场景根本凑不齐所需的字母(即任务不可行)。Agent 不仅要拼出单词,还要在发现缺字母时主动报告“任务不可行”。
结果很有意思:Claude Agent 的成功率(含正确报告不可行)只有 63%。主要的错误来源有两个:一是把长得像的字母搞混(比如把 O 当成 Q),占 13%;二是积木朝向不对,占 15%。这说明即便拥有强大的语言推理能力,前沿模型在基本的视觉感知和空间对齐上依然会犯低级错误。
不过,Agent 也展现了一些“科学思维”。在另一个实验中,Agent 被允许对自己的技能进行“实验”。当发现某个技能行为不符合预期时,它会提出假设,设计小测试,然后根据结果更新技能描述。这种自我修正机制将成功率从默认的 24% 提升到了 63%,甚至超过了人类专家手写描述的效果(36%)。
世界模型:预测未来的准确性
世界模型(World Models)试图预测“如果我这么做,世界会变成什么样”。这听起来很美好,但怎么评估它准不准?在真实世界里,你很难知道“真实状态”是什么。但在 ToyBlocks 里,仿真器提供了 Ground Truth(地面真值)。
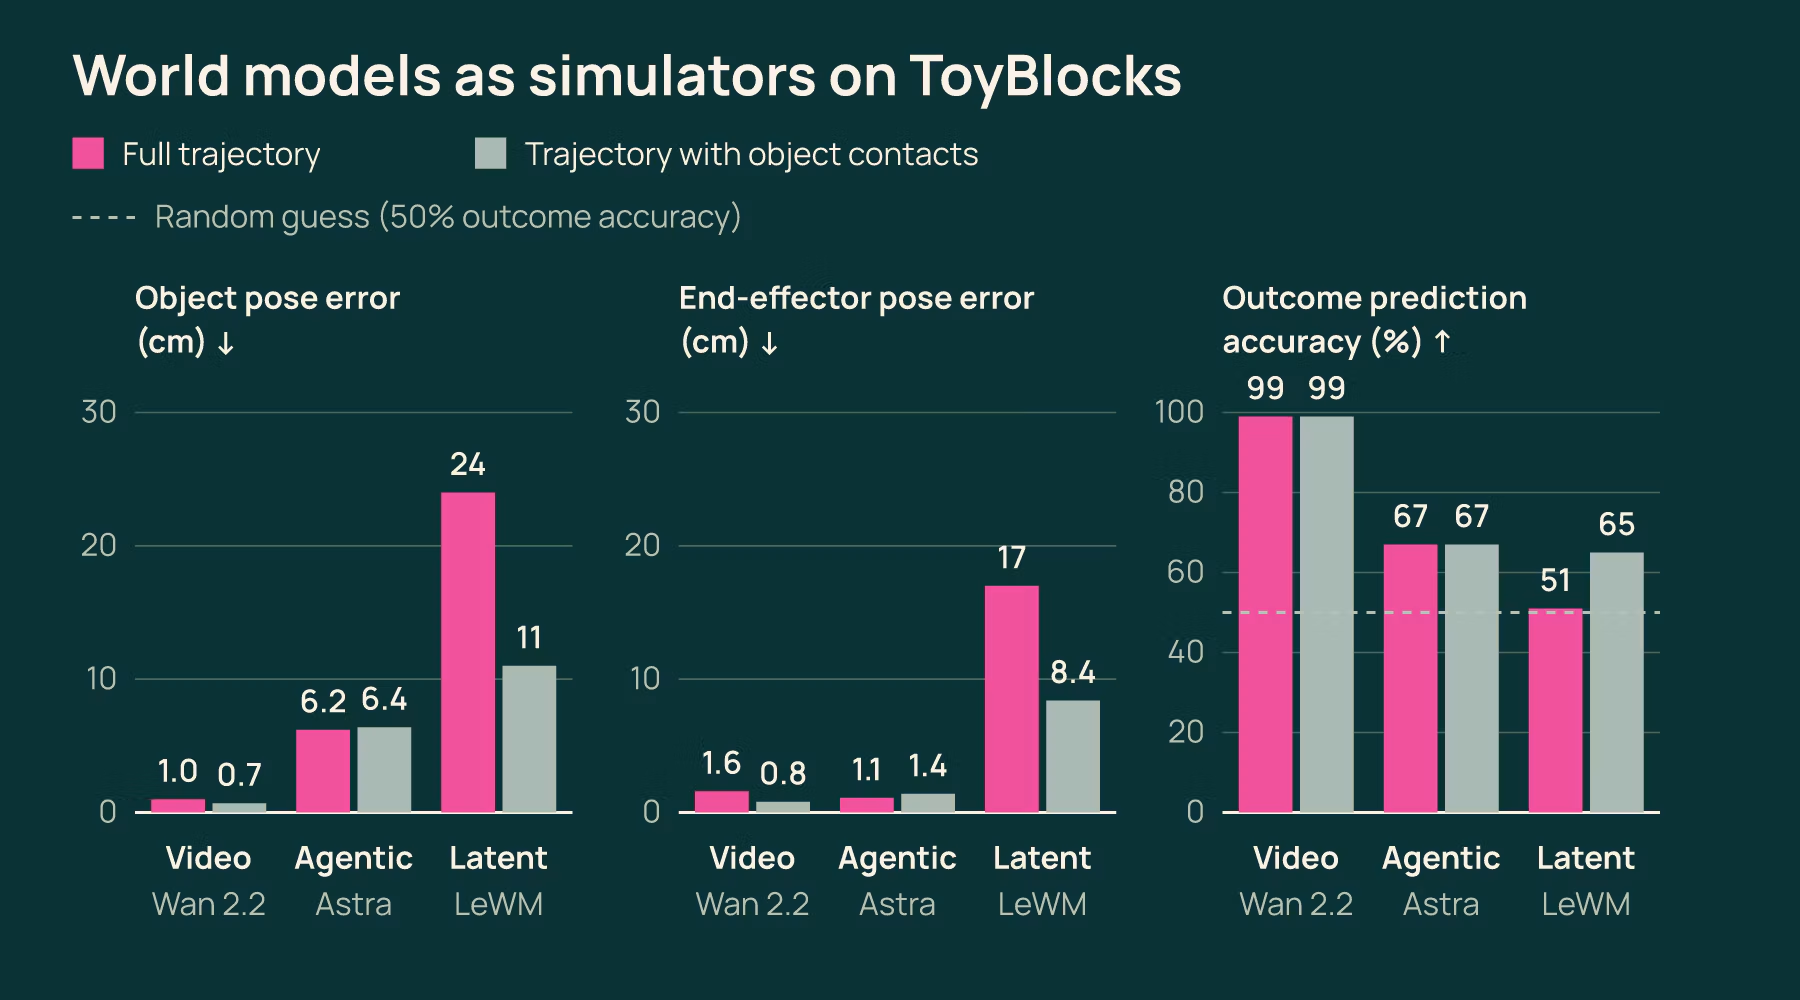
研究者测试了三种模型:视频预测模型 Wan 2.2、代理物理模拟器 Astra,以及潜在世界模型 LeWM。任务包括预测积木的运动轨迹和技能执行的结果。
结果显示,Wan 2.2 在预测积木运动和任务结果上最准确。Astra 能很好地跟踪夹爪,但在处理接触物理(比如碰撞)时容易出错。LeWM 速度快,短时段预测不错,但时间一长误差累积严重。
更重要的是,世界模型的准确性直接影响了下游策略的训练效果。如果用表现最好的视频生成模型生成 100 条合成数据加入训练,策略在未见区域的成功率能从 19% 飙升到 78%。这证明了高质量的世界模型可以作为有效的数据增强工具。
从仿真到现实:Sim-to-Real 的最后一公里
仿真再好,最终还得看真机。Allen AI 在 Franka FR3 机械臂上进行了零样本(zero-shot)部署测试,也就是模型只在 ToyBlocks 仿真数据上训练,直接放到真机上跑,没有用任何真实数据微调。
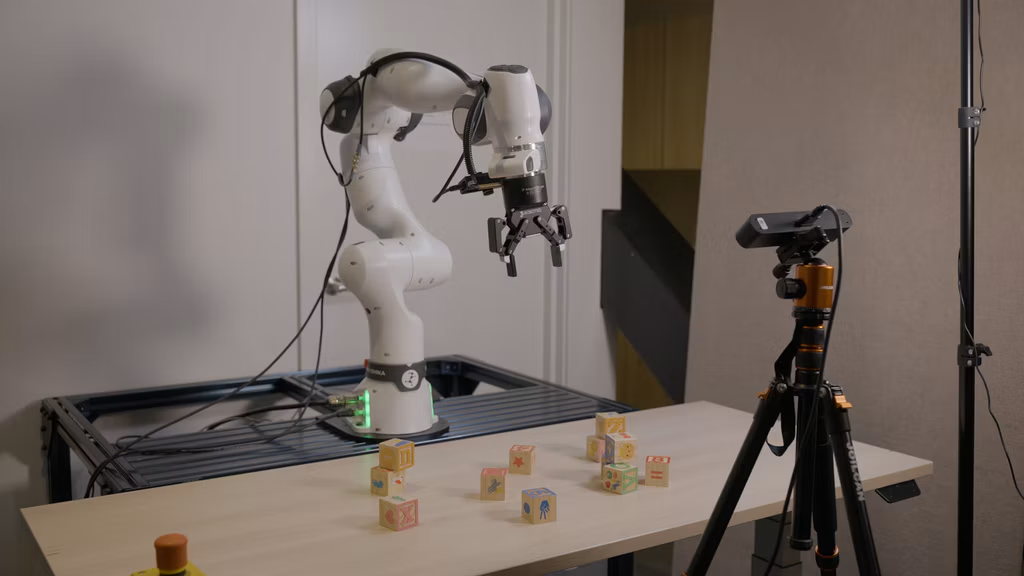
为了缩小仿真与现实的差距(Reality Gap),他们做了三步走:
- 系统辨识:调整仿真器里的摩擦力和惯性参数,让它匹配真机的运动轨迹。
- 域随机化:在生成数据时,随机改变积木大小、摩擦力、桌面高度、光照和背景。
- 感知优化:真机使用 ZED 相机,但不直接用噪声较大的深度传感器数据,而是用 FastFoundationStereo 算法从 RGB 图像生成干净的深度图。
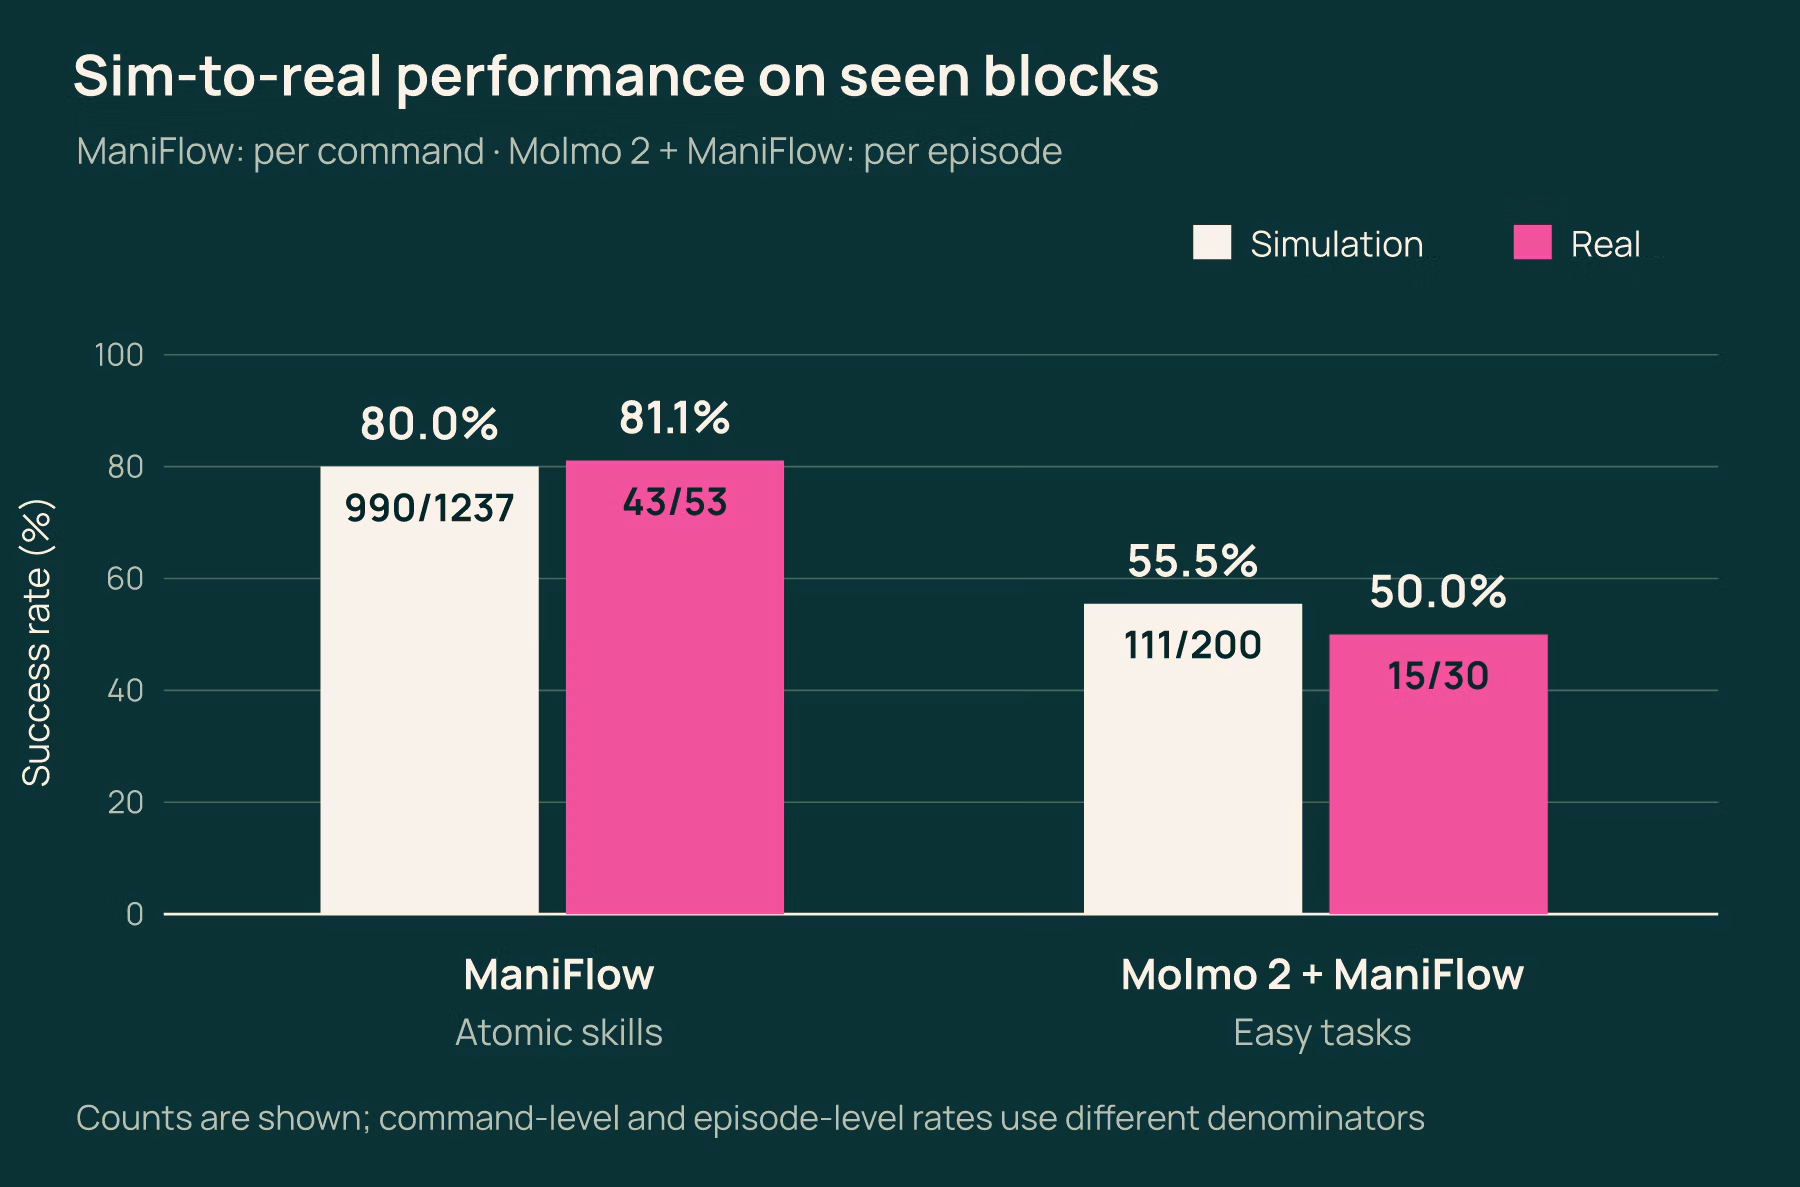
测试结果令人鼓舞。在底层原子技能(抓、放、翻、转)上,ManiFlow 在仿真中的成功率是 80.0%,在真机上是 81.1%,几乎一致。在高层的三字母拼写任务中,仿真成功率 55.5%,真机成功率 50.0%。虽然还有差距,但考虑到这是零样本部署,且失败模式在仿真和现实中高度相似,这说明 ToyBlocks 的仿真保真度已经足以指导真实世界的部署。
开放工具,推动社区研究
ToyBlocks 的价值不在于它本身是一个多完美的机器人系统,而在于它提供了一套标准化的“实验器材”。Allen AI 开源了仿真资产、程序化任务生成器、自动生成的 8.5 万条长程演示数据(涵盖 1600 小时机器人执行时间和 1.44 亿帧图像),以及训练和评估代码。
这意味着其他研究团队不需要再花几个月时间去搭建仿真环境或收集数据,可以直接在这个平台上验证自己的算法。比如,你可以测试新的强化学习算法,或者研究双手机械臂的操作。
未来,ToyBlocks 计划扩展到更复杂的场景,包括双手机械臂操作、带有触觉传感器的灵巧手,以及非结构化的积木堆操作。他们的目标很明确:让机器人学习从“黑盒调参”变成一门可解释、可重复的科学。对于正在为机器人泛化能力头疼的研究者来说,ToyBlocks 或许就是那个急需的培养皿。