Agent时代CPU配比趋近1:1,英特尔重估其调度价值
Agent改变AI计算配比
过去几年,AI训练和推理的硬件配置基本遵循一个默认规则:一颗CPU搭配四颗GPU(1:4)。这种结构适合大模型“吞”大量数据、做密集矩阵运算的场景——GPU负责核心计算,CPU只做基础协调。
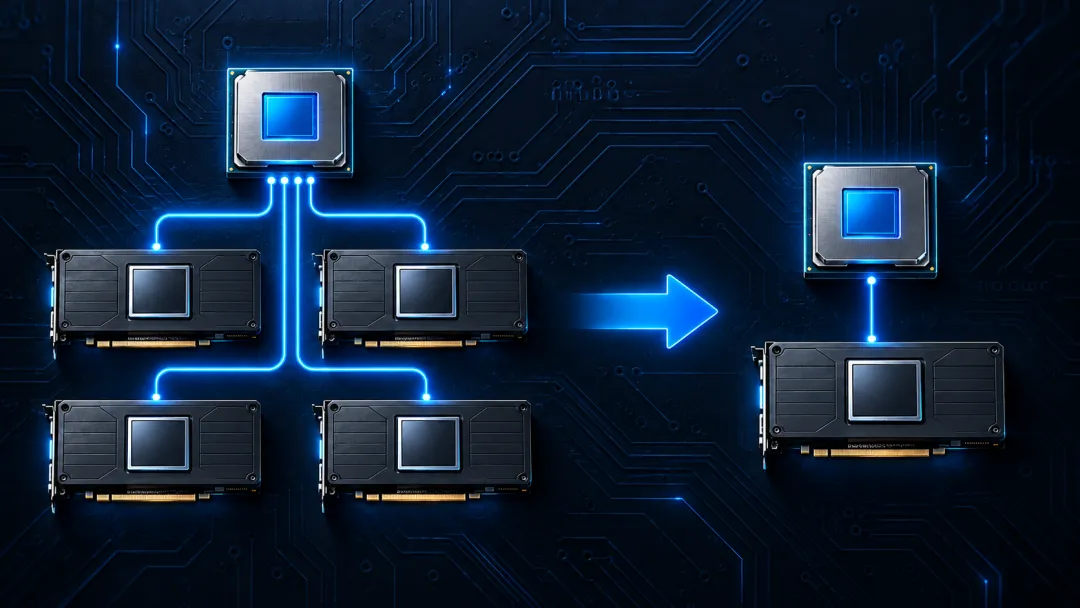
但随着AI智能体(Agent)的普及,这个比例正在被打破。在英特尔近期于苏州举办的技术创新与产业生态大会上,官方明确提出:当前AI系统正朝着1颗CPU配1颗GPU(1:1)的方向演进。
这不是凭空猜测。背后是Agent工作模式的根本变化——它不再只是被动回答问题,而是主动规划、调用工具、执行任务、迭代试错。比如用户让Agent“每天早上8点整理前一天的AI新闻并总结”,看似简单一句话,背后却涉及网页抓取、PDF解析、视频转文本、信息清洗、任务拆解、多轮模型调用等复杂流程。
这些环节中,真正需要GPU做矩阵运算的部分其实有限,反而是大量非结构化数据的提取、格式转换、流程控制和资源调度,更适合由CPU处理。如果CPU跟不上,GPU就算再快,也只能干等着数据喂进来。
CPU为何成了瓶颈?
英特尔数据中心事业部副总裁、中国区总经理陈葆立用一个具体例子说明问题:当企业部署多个Agent时,不仅要关心“能启动多少个”,更关键的是“每个Agent能否在规定时间内稳定完成任务”。
比如某些业务需要瞬间拉起成百上千个沙箱环境供Agent运行。这时候,CPU的并发调度能力、内存带宽、I/O响应速度就直接决定了系统是否卡顿。如果CPU处理不过来,后续任务链就会堆积,用户体验断崖式下降。
更麻烦的是,Agent的工作具有强依赖性。前一步没完成,后一步就无法启动。这意味着整个任务流的延迟,往往不取决于GPU算得多快,而卡在CPU处理中间环节的速度上。
为应对这一挑战,英特尔将现代数据中心简化为三个核心模块:
- CPU集群:负责Agent的任务编排、执行调度和数据预处理;
- GPU等加速器:专注模型推理计算;
- 存储系统:保存对话历史、生成文档及中间缓存数据。
其中,CPU贯穿始终——它要从网络或存储中拉取原始数据,做清洗和格式化;要把任务分发给合适的GPU;还要管理不同Agent之间的资源隔离与优先级。任何一个环节拖沓,都会拖累整套系统的吞吐效率。
KV Cache带来的新压力
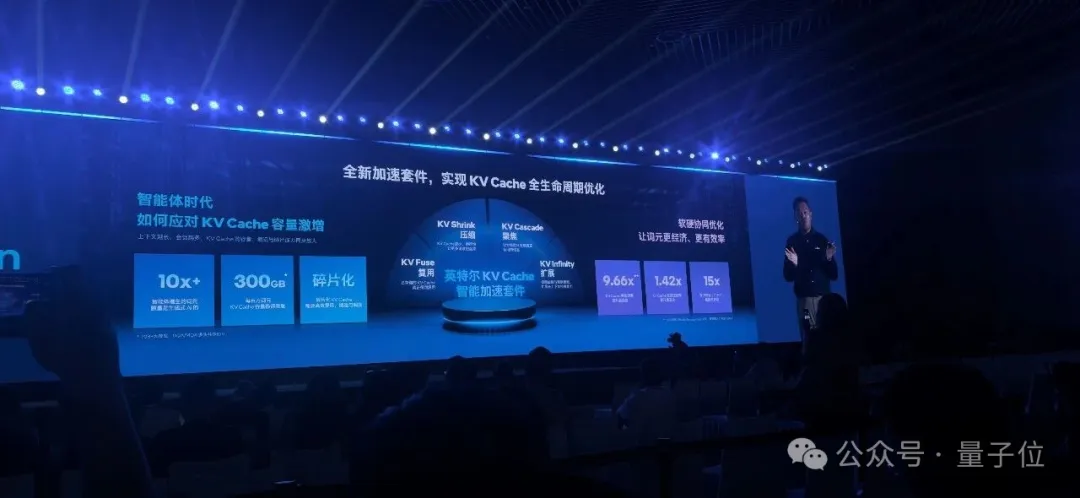
另一个容易被忽视但日益关键的问题是KV Cache(键值缓存)的管理。
随着大模型上下文长度突破百万token,Agent在多轮交互中会不断累积中间计算结果。这些KV Cache若全部放在GPU显存里,很快就会爆满。于是系统不得不把部分缓存卸载到系统内存甚至SSD上。
但数据一旦离开高带宽的HBM,访问延迟就会飙升。如何高效压缩、快速搬运这些缓存,就成了影响Agent响应速度的关键。而这类工作——数据压缩、内存调度、跨层级传输——恰恰是CPU的传统强项。
英特尔为此推出了专门的优化方案:利用至强处理器内置的AMX(高级矩阵扩展)和DL Boost指令集,对KV Cache做无损压缩;同时通过CXL等高速互连技术,加快CPU与GPU、内存之间的数据流转。测试显示,这些优化能让缓存访问延迟降低30%以上,显著减少GPU空转等待的时间。
端侧Agent同样依赖CPU
这种趋势不仅存在于数据中心。在个人设备上,Agent的运行逻辑同样需要多芯片协同。
英特尔副总裁高嵩指出,在PC、机器人或车载AI设备中,典型分工如下:
- CPU:处理Agent的决策规划、任务调度等需要低延迟响应的逻辑;
- GPU:承担图像生成、大模型推理等高算力任务;
- NPU:以低功耗持续运行语音识别、视觉感知等常驻AI功能。
例如家庭服务机器人,既要实时感知环境(NPU),又要规划路径、协调机械臂动作(CPU),还可能调用本地大模型生成对话(GPU)。三者必须紧密配合,而CPU往往是那个“发号施令”的中枢。
高嵩特别提到,未来围绕私人数据运行的本地Agent(如个人知识库助手)会越来越多。这类应用对隐私和响应速度要求极高,无法依赖云端,必须在端侧完成全流程。这也意味着CPU不仅要快,还要足够智能地分配任务给不同计算单元。
软件生态才是落地关键
当然,光有硬件还不够。英特尔深知,CPU的价值最终要通过软件栈释放出来。
因此,他们在PyTorch、Linux内核、Kubernetes等开源项目中持续投入,优化任务调度器、内存管理器和I/O子系统,确保至强处理器的能力能被上层应用直接调用。同时,与国内软件厂商合作开发高性能存储中间件,目标就是让数据“少走路、快送达”。
北京大学林毅夫在会上的一句话点明本质:“AI对经济的影响,最终要通过各行业用它提升效率来体现。” 对英特尔而言,这意味着必须把CPU、软件和行业场景打包成可落地的解决方案,而不是只卖芯片。
价值重估的核心指标
回到最初的问题:CPU的价值该如何重估?
过去我们看CPU,主要关注主频、核心数、IPC(每周期指令数)。但在Agent时代,更相关的指标变成了:
- 并发任务支撑能力:单台服务器能稳定运行多少个Agent;
- P99响应延迟:99%的任务能在多长时间内得到响应;
- 资源调度效率:CPU能否快速协调GPU、内存、存储,减少空闲等待;
- 真实任务吞吐量:在模拟新闻摘要、客服工单处理等场景下的实际完成速率。
这些指标无法靠纸面参数体现,必须在真实业务流中测试。而英特尔近期展示的优化案例,正是试图用具体数据证明:在Agent密集型负载下,CPU的投入回报率正在显著提升。
市场似乎已经嗅到变化。大会次日,英特尔股价单日上涨12%,反映出投资者对这一叙事的认可。毕竟,如果未来每部署一颗GPU都要配一颗高性能CPU,那整个AI芯片市场的蛋糕分配,可能真的要重新切一遍了。