刷视频真能教会机器人干活?三家实验揭示人类动作预训练的规模效应
人类视频正在成为机器人训练的新燃料
过去几个月,Figure、Dyna Robotics 和亮源新创(Light Origins)陆续发布了关于“用人类行为视频预训练机器人”的实验结果。它们不约而同地指向一个核心问题:人类在日常生活中积累的动作经验,能不能像互联网文本之于大语言模型那样,成为一种可规模化、且下游收益可预测的预训练资源?
答案似乎越来越倾向“能”,但前提是——你得知道怎么用。
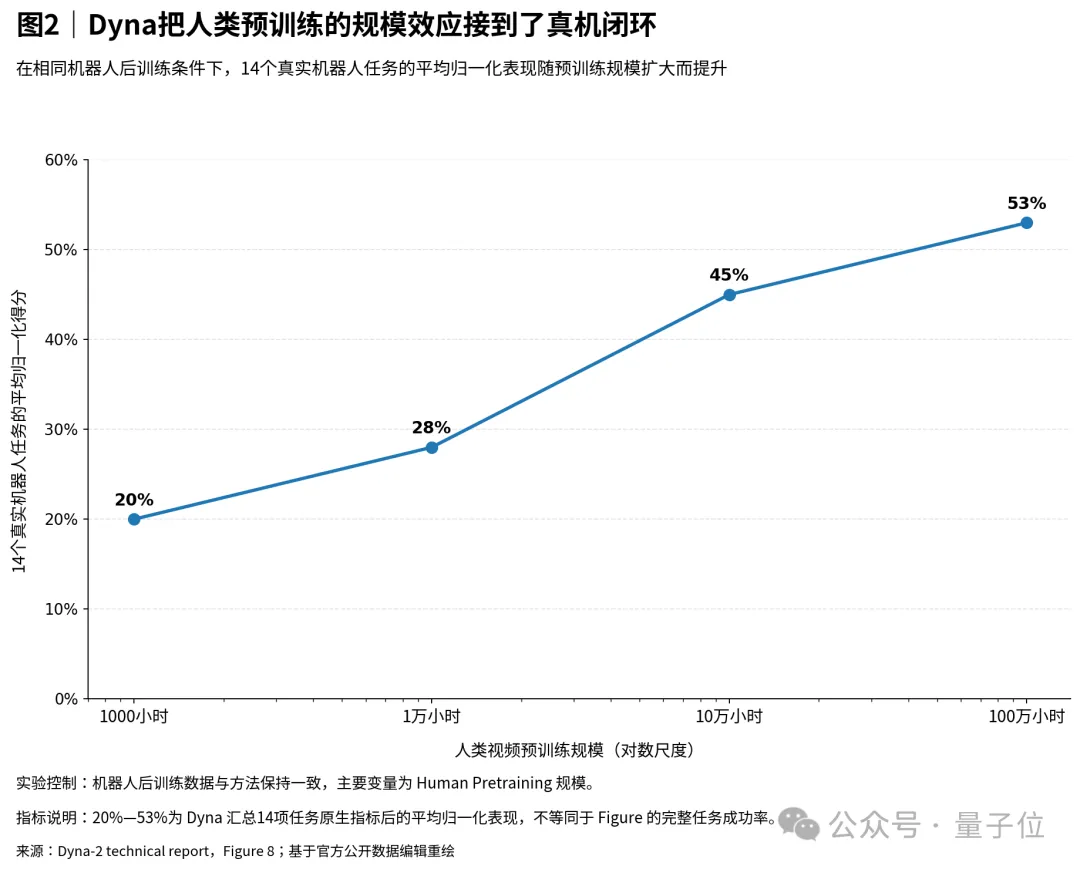
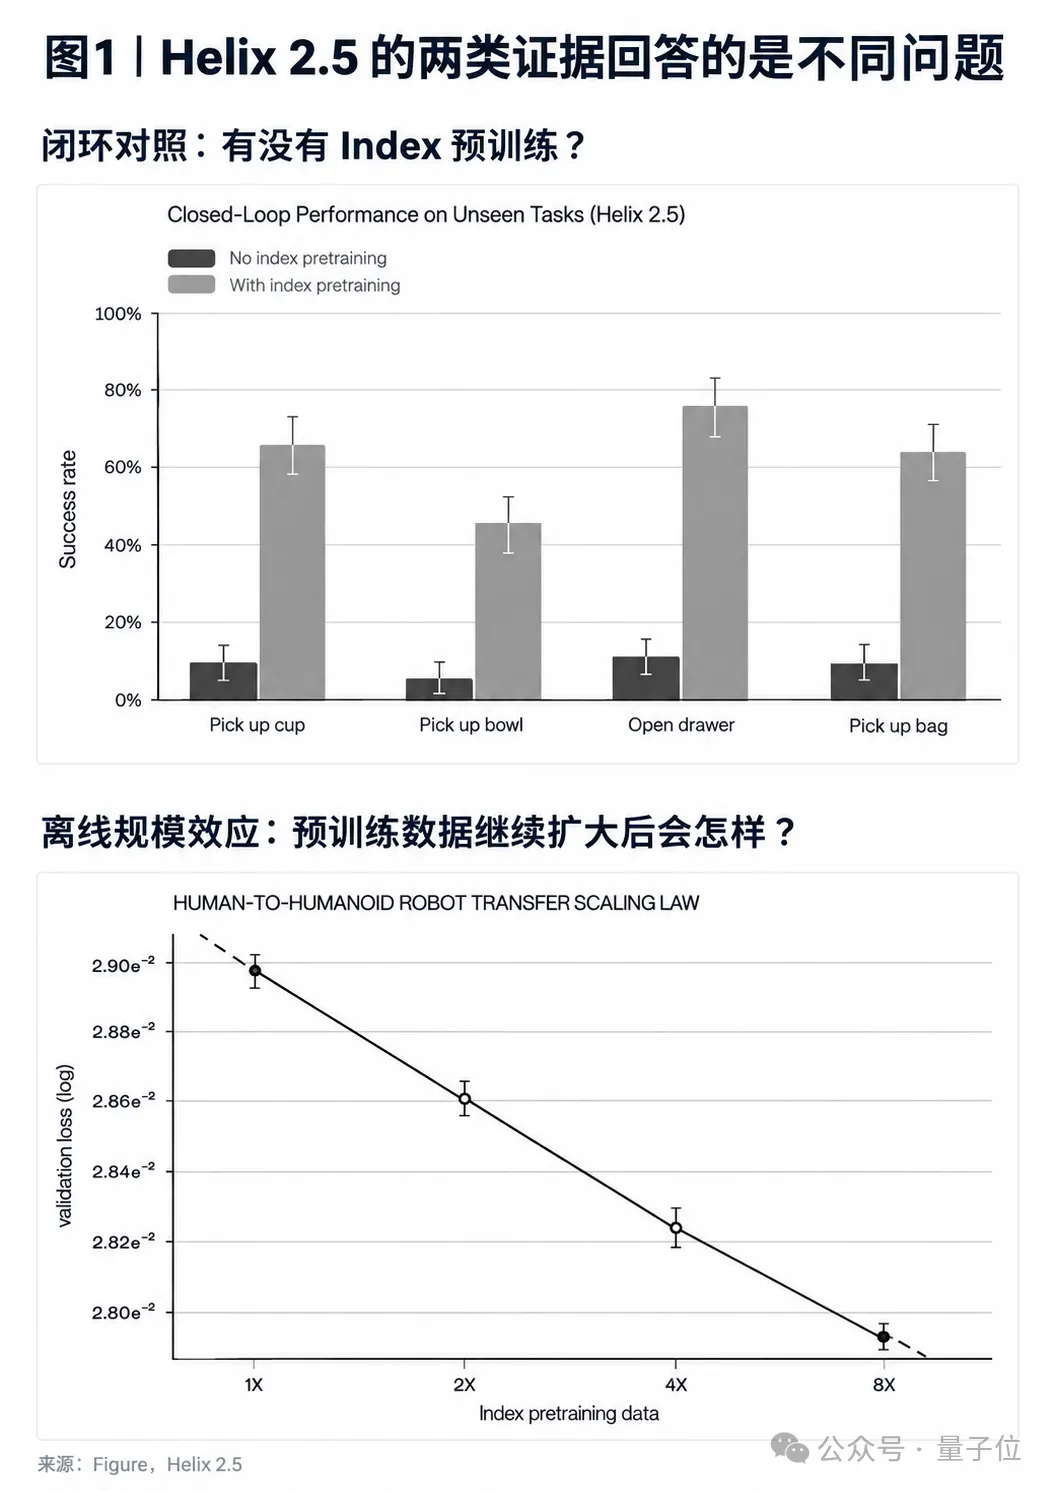
Figure 在9月展示的 Helix 2.5 进入30个陌生家庭执行家务的视频,表面看是“零样本”能力的秀场,实则背后藏着更关键的对比实验:同样用任务专属数据微调,经过 Index 人类行为预训练的模型,完整任务成功率从9%跃升至56%。这里的“完整任务”要求严苛——玩具必须全部收进篮子,中途若需人工干预即算失败。
这个跳跃不是靠现场学习实现的。机器人到达后不采集新数据、不更新权重、也不切换策略。它依赖的是此前在其他环境中用专门数据适配过的策略,而该策略的骨干网络是否经过大规模人类动作预训练,成了成败分水岭。
预训练规模与离线指标的幂律关系
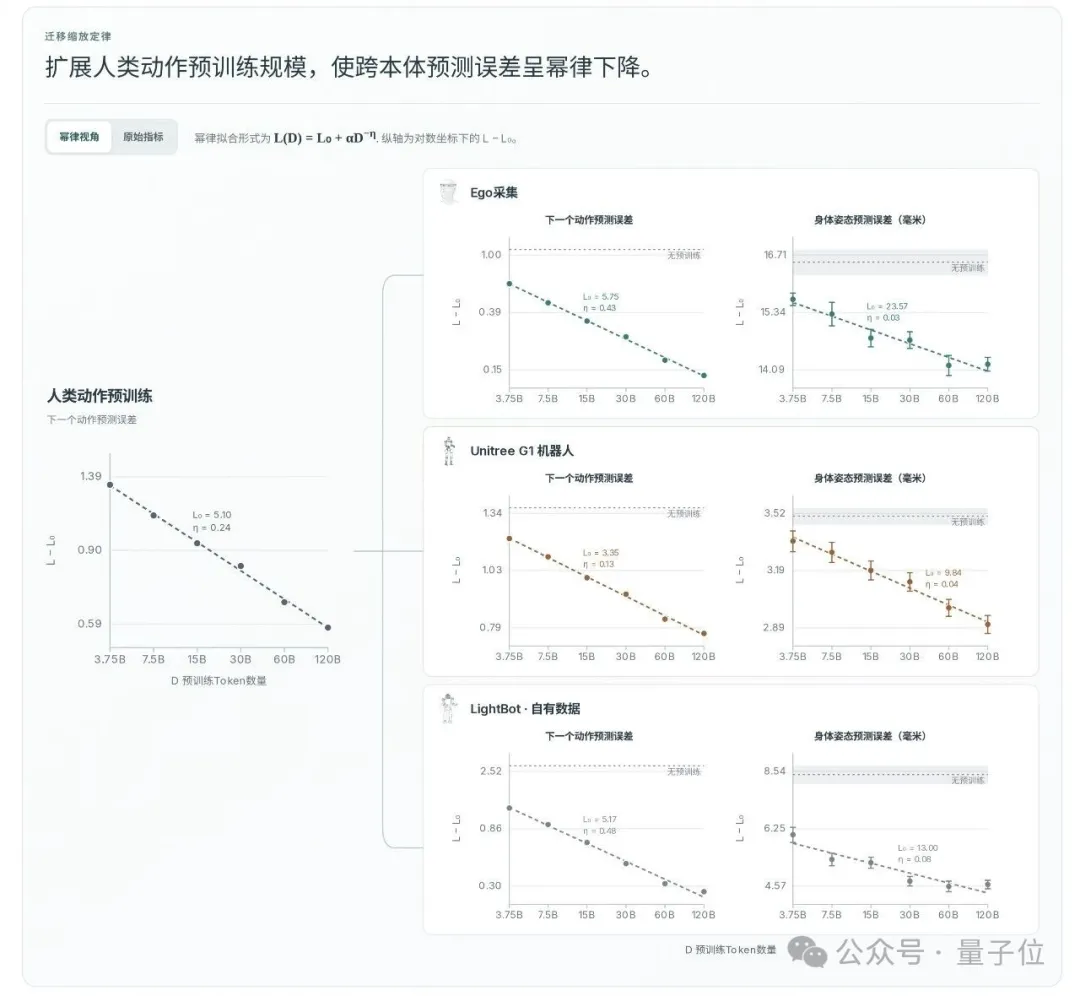
Figure 还做了另一组容易被忽略的实验:用四档嵌套的 Index 数据(1倍、2倍、4倍、8倍)分别预训练相同架构的模型,再用同一套任务数据微调,比较动作预测损失。
结果很清晰:随着预训练数据翻倍,验证集上的动作预测误差持续下降,且趋势高度可预测。Figure 用小规模数据拟合曲线后,成功预测了最大规模模型的损失值,误差仅占整个8倍跨度变化量的0.54%。
但这组实验测的是离线指标,不是真实机器人的闭环表现。Figure 并未公布这四档预训练规模各自对应的真实家庭任务成功率。因此,我们不能直接说“预训练数据翻倍,任务成功率也按相同比例提升”。
真正把预训练规模和闭环表现连起来的,是 Dyna Robotics。
Dyna:从百万小时视频到真实任务得分
8月发布的 Dyna-2 系统,用1000小时、1万小时、10万小时和100万小时四档严格嵌套的第一视角人类视频进行预训练。各档数据只是在前一档基础上追加,来源比例保持一致,以排除分布偏移的干扰。
随后,四档模型用完全相同的机器人后训练流程适配到14个真实任务。结果发现,平均归一化得分依次达到任务上限的20%、28%、45%和53%。这里的“归一化得分”是为了统一不同任务的原始指标而设计的综合度量,并非直接的任务成功率,但明确显示:预训练阶段的数据规模差异,在经过相同后训练后,仍然延续到了真机闭环表现。
Dyna 还通过消融实验追问:这种规模效应从何而来?
单独用带动作标签的数据预测动作,模型会过拟合;加入未来视频预测任务后,迁移表现整体改善;而当进一步引入大量无动作标签、仅用于视频预测的人类视频时,跨本体泛化才呈现出稳定的单调提升。
这说明,光有数据量不够,模型被要求从中学什么同样关键。世界建模、视频预测这类自监督信号,可能比单纯的动作回归更能释放大规模人类视频的潜力。
Figure 的解法:主动构建可控数据供应链
Figure 对互联网公开视频的态度很直接:“要训练通用机器人,所需数据并不存在于来源广泛的互联网视频中。”
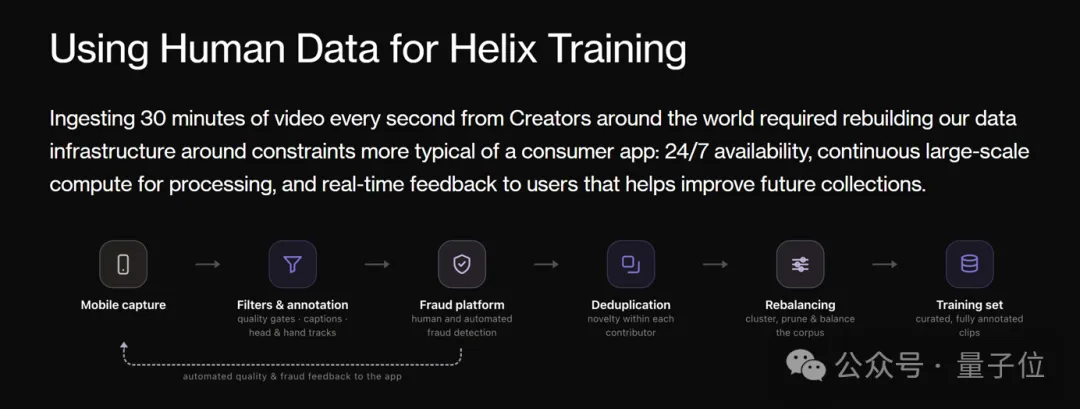
于是它搭建了自己的 Human Data 供应链——Index。通过 Creator 创作者网络,人们在真实家庭和工作场所录制任务视频。截至8月底,平台已收到超1600万条视频,累计支付创作者1500万美元。Helix 2.5 发布时,新视频正以约35分钟/秒的速度流入 Index。
这些数据还要经过质量过滤、反作弊、去重、再平衡和文本标注,最终形成训练集。Figure 将此视为一套“可主动改变训练分布的基础设施”:某类任务不足就定向补采,某种环境过载就重新平衡,长尾缺失就组织生产。
配合这套数据体系的,是巨额算力投入。9月初,Figure 宣布与英国 AI 云厂商 Nscale 达成合作,初始算力承诺达35亿美元,未来或超60亿,计划部署最高10万颗 GPU。CEO Brett Adcock 明确表示,Helix 下一阶段的瓶颈正是数据和算力。
这条路线资本密集,但对数据分布拥有强控制力。
另一条路:从嘈杂的互联网视频中提取信号
并非所有团队都选择重新采集数据。另一些研究者试图提升模型从现有互联网视频中提取可迁移信号的能力。
CoMo 从多样化的网络视频中学习连续潜在运动表示,为未见过的视频生成伪动作,再与有限机器人数据联合训练策略。
HuRo 更进一步,将不同来源、视角的人类视频“机器人化”,转换成更接近机器人观测和动作分布的形式。随着这类预训练数据扩大,真实任务完成度和分布外表现持续改善。
Rhoda 则绕开显式动作恢复,直接用广泛视频训练因果视频模型,预测世界状态变化,再通过逆动力学模型将预测转化为机器人动作。实验显示,更强的预训练在机器人数据稀缺时收益更明显。
这些方法机制各异,但目标一致:当原始数据远离机器人分布时,能否通过表示学习、动作恢复或世界建模来弥合差距?
亮源新创:把预训练推向互联网规模
亮源新创选择了更具挑战性的数据源——互联网中的第三视角人类行为视频。这类视频规模庞大、多样性高,但人机域差异也更大:镜头不跟随人体、动作常被遮挡、无直接动作标签、人类与机器人身体结构不同。
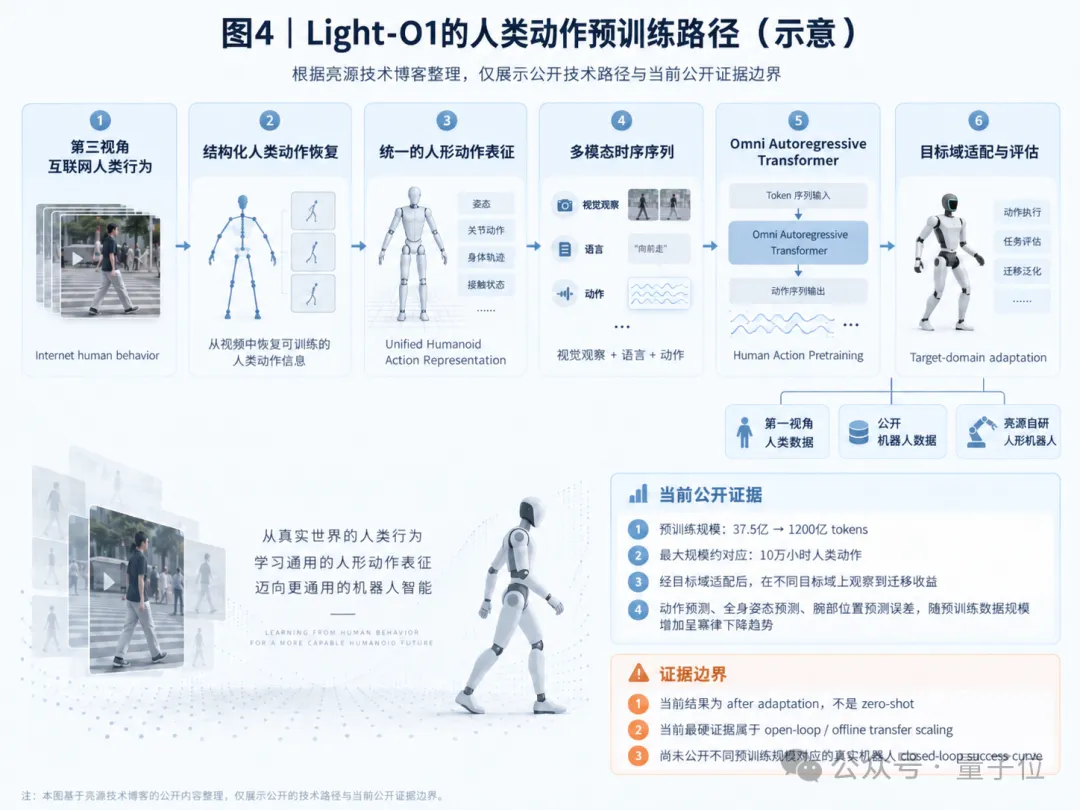
根据其9月21日技术博客,Light-O1 先从视频中恢复结构化人类动作,再编码成统一的人形动作表示,与视觉、语言信息一起进行自回归预训练,最终得到一个“人类动作先验”(Human Action Prior)。
预训练规模从37.5亿 tokens 扩展到1200亿 tokens,约对应10万小时人类动作。随后在第一视角人类数据、Unitree G1 机器人及自研人形平台上进行目标域适配。
结果发现,随着预训练规模扩大,动作预测误差、全身姿态误差和腕部位置误差均持续下降,并呈现幂律趋势。亮源将此称为“迁移缩放定律”(Transfer Scaling Law)。
值得注意的是,这一结果基于适配后的开环预测指标,并非闭环任务成功率。但它是首次在互联网规模第三视角视频上,验证了多本体人形机器人的迁移缩放现象。
不同层级的“规模效应”不能混为一谈
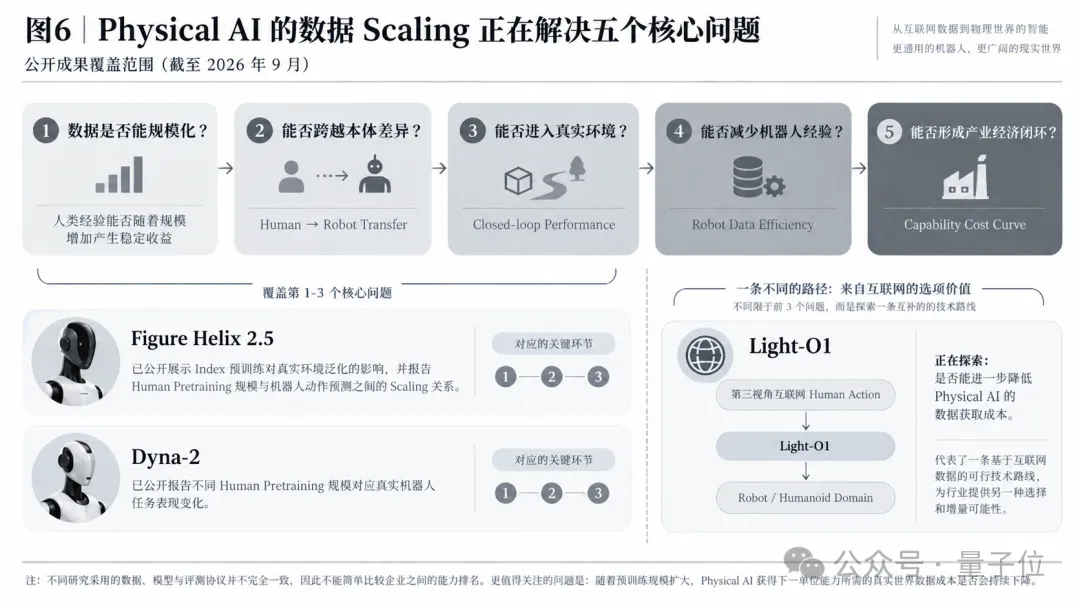
把三家结果放在一起,容易混淆不同层级的“Scaling”:
- 预训练层:数据增加是否持续改善模型本身?(是)
- 迁移层:这种改善能否在机器人目标域保留?(Figure 和亮源验证了离线指标的保留)
- 闭环层:最终能否提升真实机器人在陌生环境中的任务成功率?(Figure 用9% vs 56%证明“有无预训练”影响巨大;Dyna 用四档数据展示了闭环得分的连续提升)
Figure 尚未公开预训练规模与闭环成功率的连续曲线;Dyna 的20%-53%是归一化得分,不能与 Figure 的56%直接比较;亮源目前只验证到离线迁移。
更深层的问题是:更强的预训练能否显著减少对昂贵机器人真实数据的依赖?
Figure 提到,Helix 2.5 在某任务上仅用前代约一半的专属数据就达到相近成功率,并扩展到30个家庭。但这跨了模型代际和评估条件,非严格对照实验。
Dyna 在“拧瓶盖”任务中仅用约10分钟机器人示范就完成适配,且表现随人类视频规模提升。但它仍未给出“多少小时人类数据等价于多少小时机器人数据”的换算关系。
真正要算的是整条数据成本链
行业习惯用“小时数”比较数据成本:遥操作贵,人类视频次之,互联网视频近乎免费。但实际账本复杂得多。
Figure 为可控性付费:创作者激励、采集体系、质检、再平衡——换来的是“缺什么就能补什么”的能力。
互联网路线省了物理采集成本,但新增了其他开销:视频筛选、动作恢复精度、遮挡处理、人机动作对齐、以及将嘈杂信号压入模型所需的海量算力。
Dyna 则提示第三种可能:不一定非要高质量动作标签,世界建模本身就能让纯视觉视频参与规模化学习。
因此,这场数据战的胜负,不取决于谁拥有最多“小时数”,而在于机器人获得下一项能力时,整条链路还要向真实世界支付多少总成本。
Helix 2.5 让人类经验成为不可忽视的规模化轴线;Dyna 证明这条轴能穿透到真实闭环;亮源则把实验推向了距离机器人最远却最丰富的互联网级行为。
接下来的关键实验已经很明确:固定机器人适配方案,让不同规模预训练的模型逐一进入闭环;再改变机器人数据预算,绘制等性能曲线。到那时,我们才能真正讨论“互联网级人类动作”的数据经济性。