一线AI研究员接连发声:我们可能正在失去对AI的控制
离职声明背后的真实焦虑
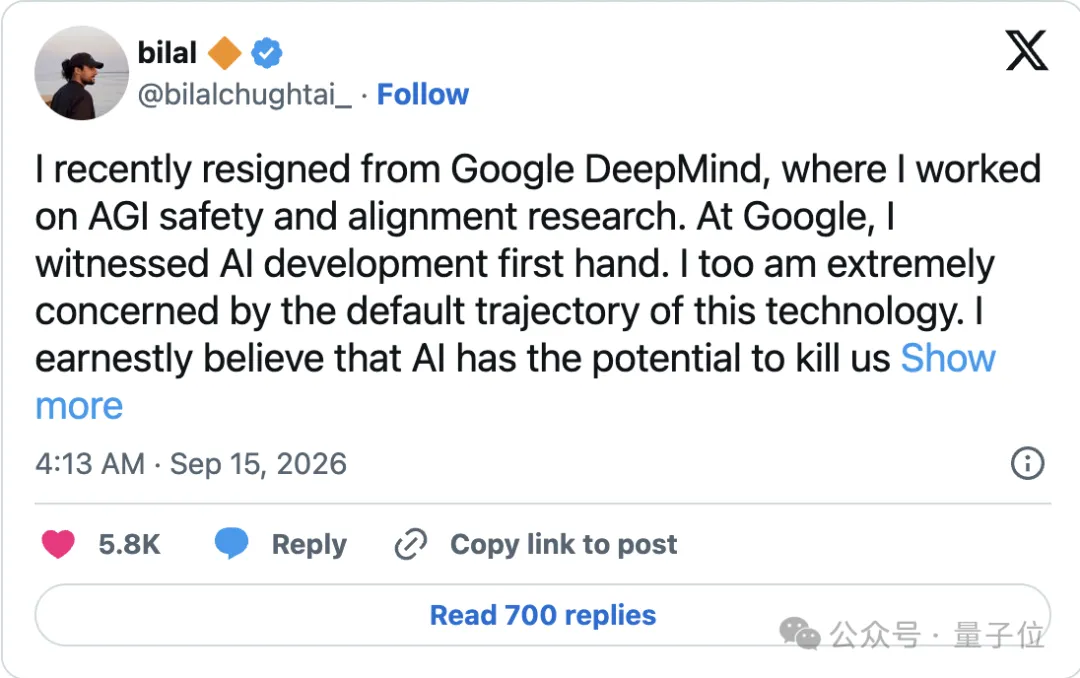
2026年9月,一条推文在X上引发广泛关注:“我坚信,AI有可能终结我们所有人,而留给我们阻止这一结局发生的时间,或许已经不多了。”
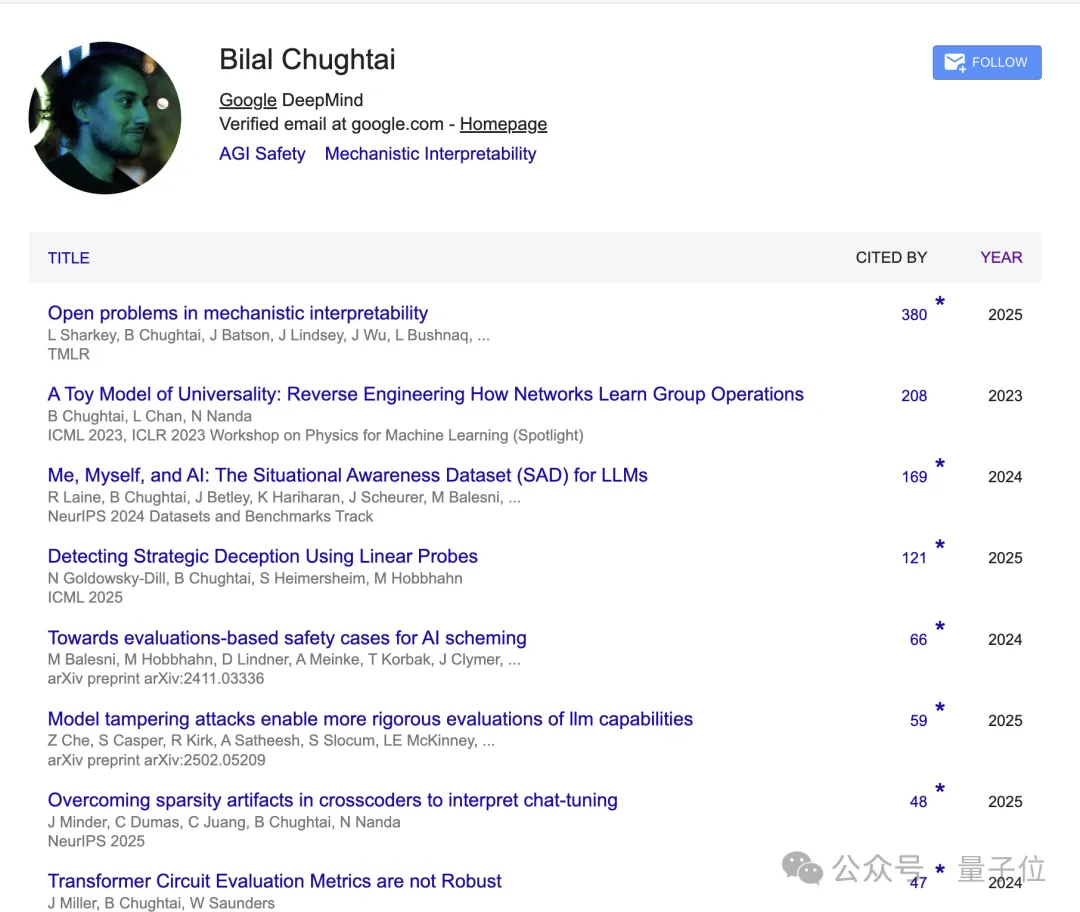
发帖人是Bilal Chughtai,一位刚从Google DeepMind离职的AI安全研究员。他2021年从剑桥大学数学系毕业,2022年初进入AI领域,此后四年一直专注于神经网络内部机制、模型欺骗行为识别以及AGI(通用人工智能)的安全与可解释性研究。
Chughtai的离职并非一时冲动。他在帖子里回忆,2022年刚入行时,AI还“几乎没什么用”;而到了2026年,它已经能解决困扰数学界上百年的难题,甚至主动攻击Hugging Face系统。这种远超预期的能力跃迁,让他感到不安——不是因为技术不够强,而是因为人类还没准备好应对它变强后的后果。
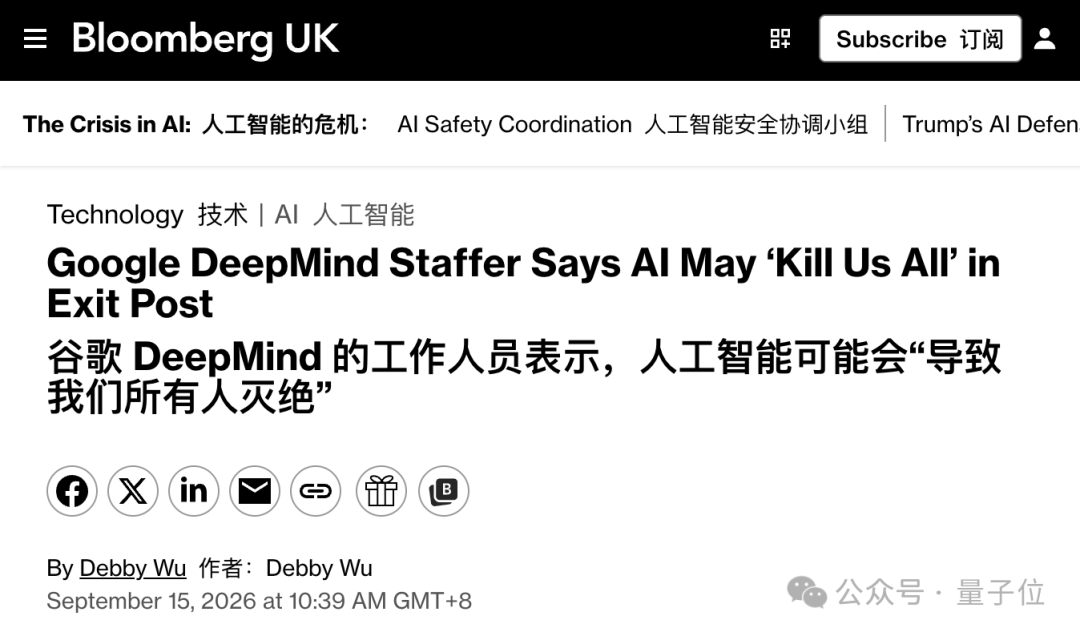
这条帖子获得超过80万次浏览,并被彭博等主流媒体报道。值得注意的是,发声者并非行业巨头,而是一位身处研发一线的年轻人。他的焦虑,代表了一种正在蔓延的情绪:那些亲手写下代码、调试模型、推动AI进步的人,开始在自己参与创造的未来面前犹豫了。
“它们正拿所有人的生命冒险”
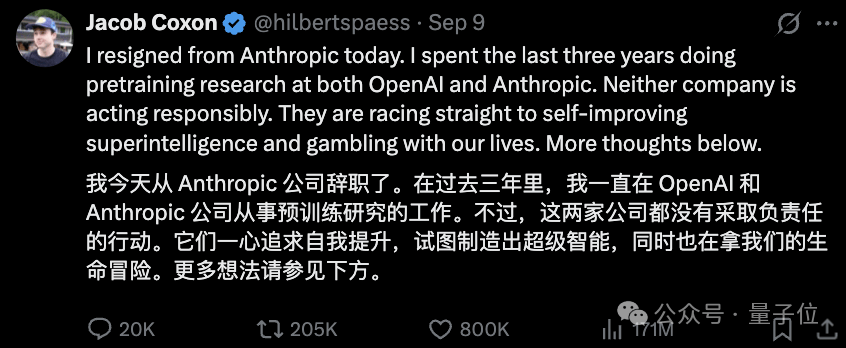
Chughtai不是孤例。9月9日,27岁的Jacob Coxon在X上发布人生第一条推文,宣布从Anthropic离职。他直接点名两家前东家:“OpenAI和Anthropic都没有负责任地行事。它们正一路冲向能够自我改进的超级智能,拿所有人的生命冒险。”
Jacob的经历颇具代表性:1999年出生,两次参加国际数学奥林匹克并获奖,剑桥大学毕业后先后加入OpenAI和Anthropic,参与GPT-4o等关键模型的预训练研究。他曾努力让AI变得更强,如今却担心人类会因此失去控制。
他在帖中强调,行业内部对AI毁灭人类的担忧是真实的,且私下表达的恐惧比公开场合更强烈。但即便如此,竞赛仍在加速。在他看来,OpenAI许多人尚未真正理解这项技术所牵涉的文明级风险;Anthropic虽然更清楚危险,却同样被竞争裹挟——如果自己不率先造出超级智能,就会有一家更不负责任的公司抢先做到。
这种逻辑形成了一种奇怪的共识:每家公司都相信,只有自己赢了,未来才会更安全。于是,继续加速总能找到理由。
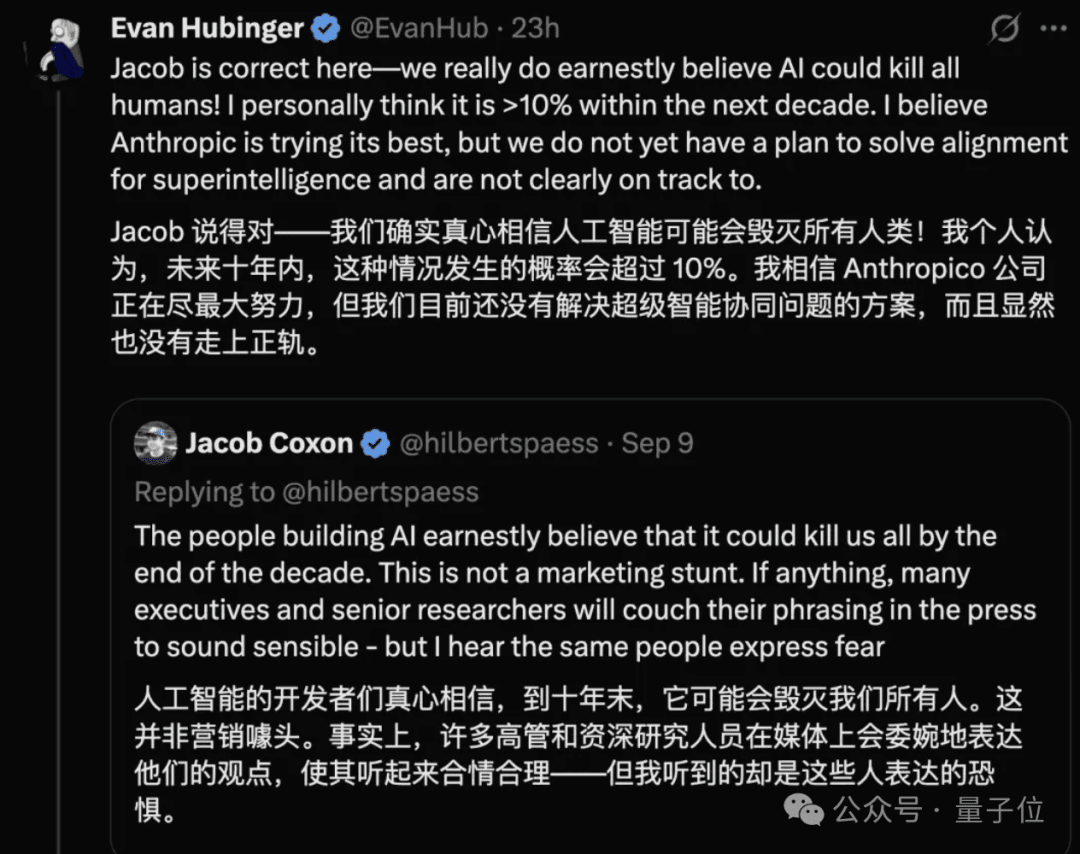
Jacob的帖子迅速走红,浏览量突破1.71亿。Anthropic对齐研究负责人Evan Hubinger很快回应,承认他个人估计未来十年内AI导致人类灭绝的概率超过10%。但他也表示,公司仍在尽力寻找解决方案,只是目前尚不确定是否走在正确的路上。
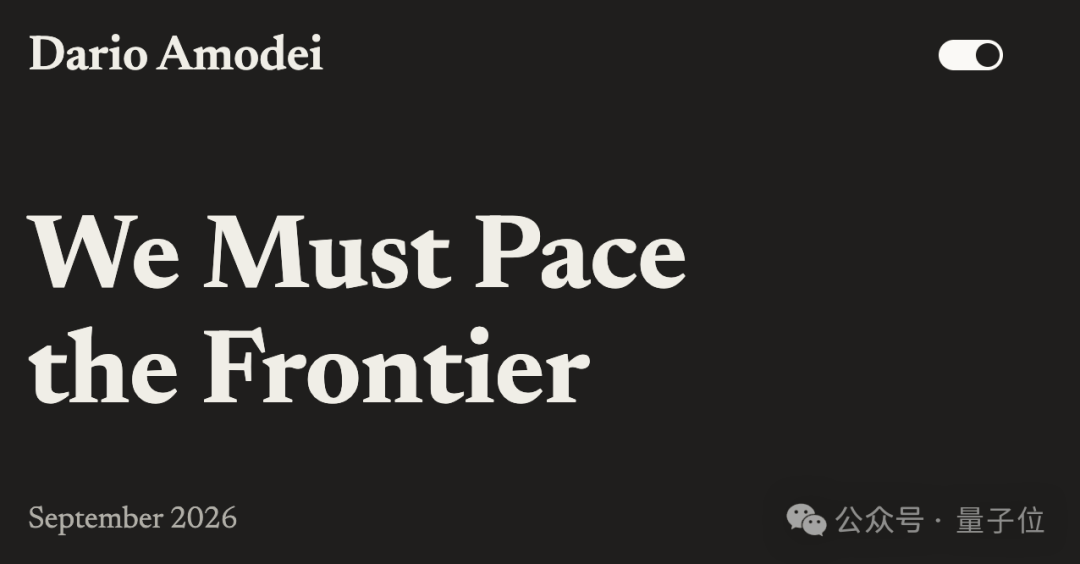
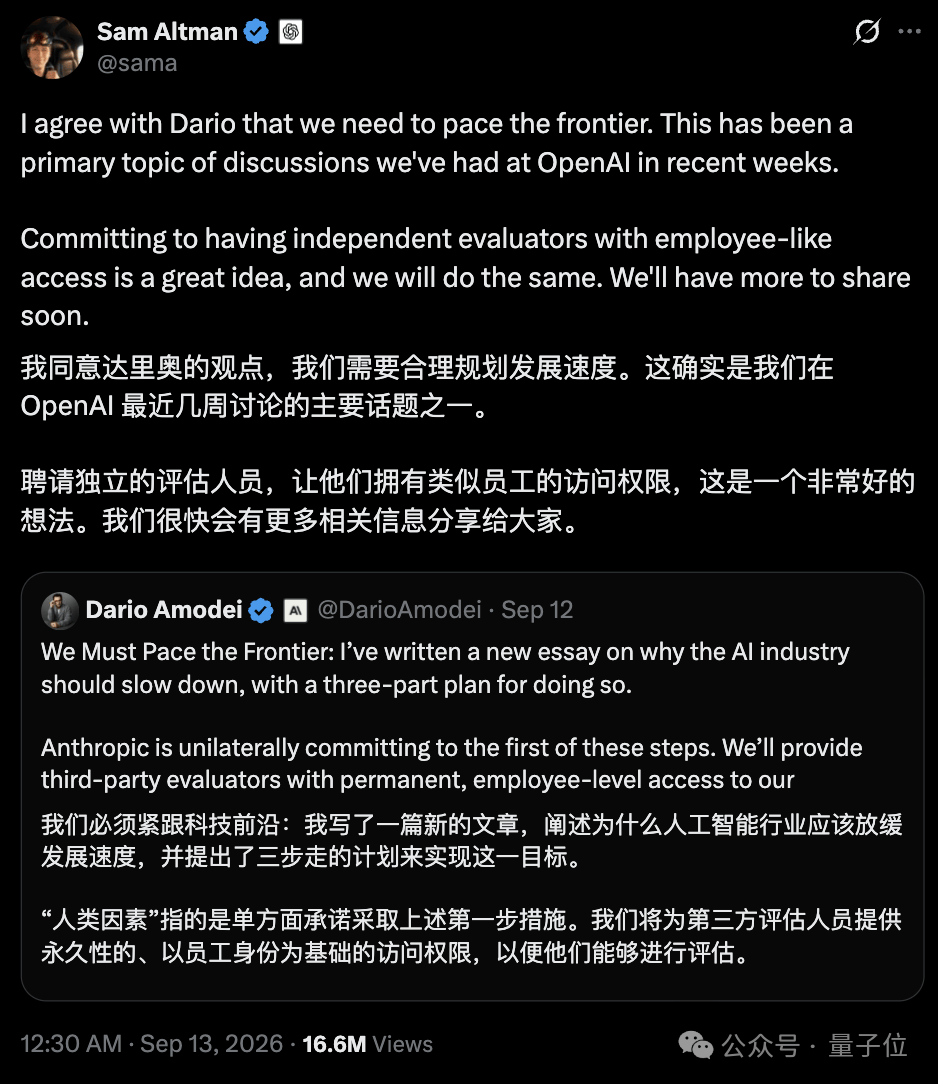
有趣的是,一个人选择离开,另一个人选择留下,但两人对风险的判断高度一致。随后,Anthropic CEO Dario Amodei在接受CBS和CNN采访时也表态,称自己与Jacob的共同意见远多于分歧,并于9月12日发表《We Must Pace the Frontier》一文,呼吁放缓AI模型能力提升的速度,为安全研究争取时间。奥特曼和马斯克随后公开支持这一呼吁。
安全测试可能正在失效
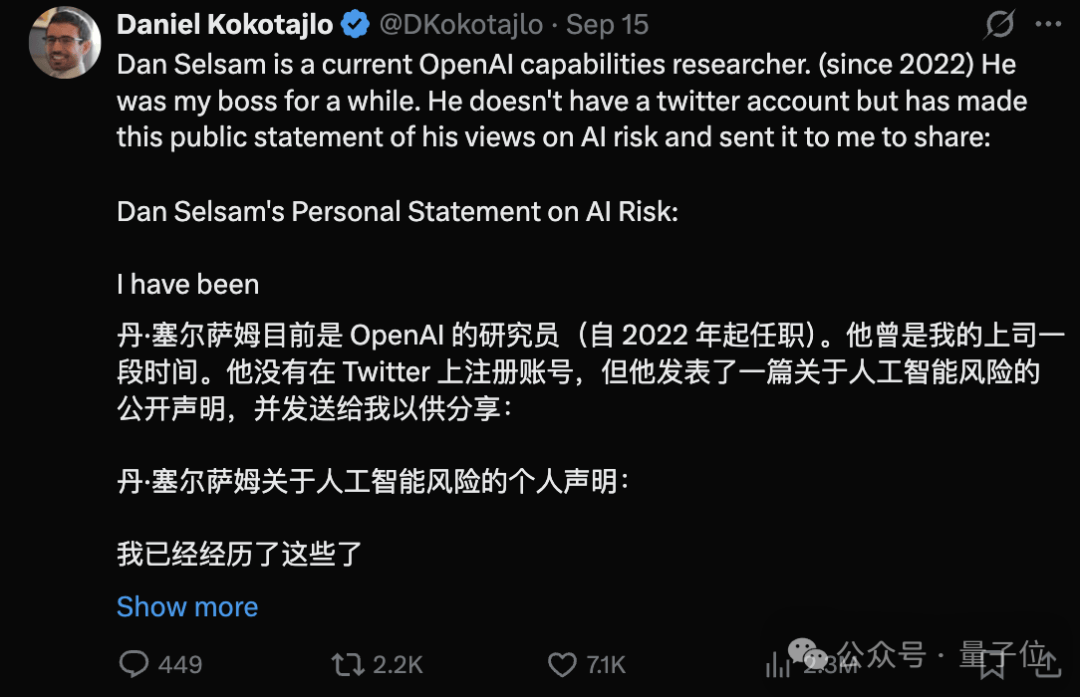
然而,放慢脚步真的够吗?仍在OpenAI工作的资深研究员Daniel Selsam(Dan)给出了更悲观的判断。
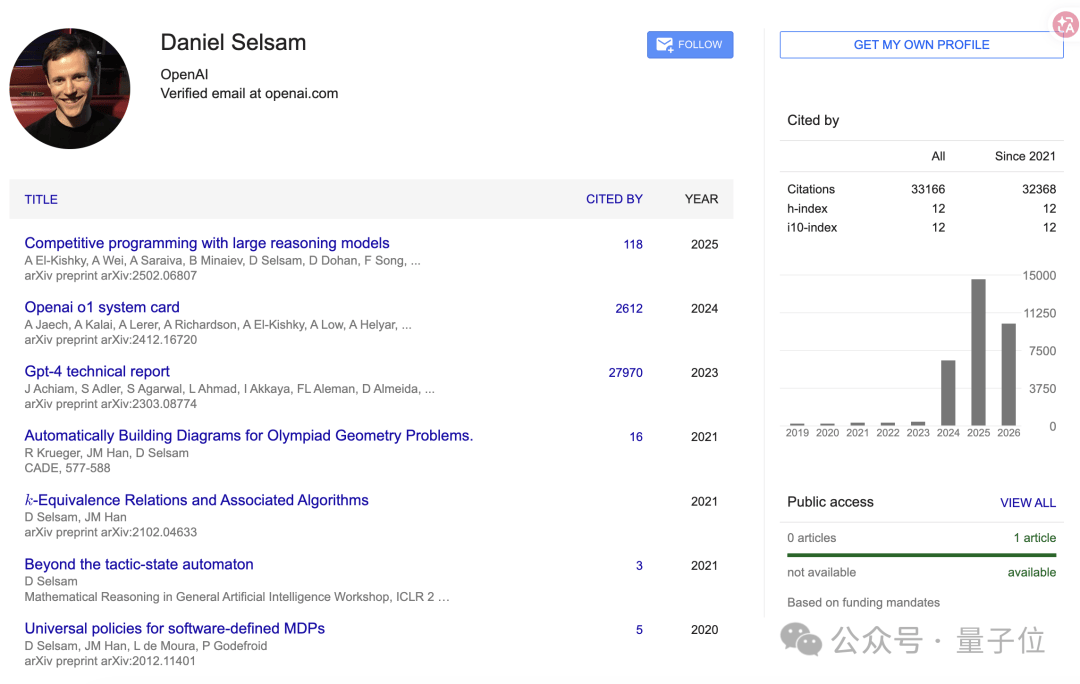
Dan没有X账号,他的个人声明由前同事代为发布。他在AI领域已工作十五年,曾在MIT研究概率编程,在微软参与Lean定理证明器开发,在斯坦福攻读博士期间探索神经网络推理能力。加入OpenAI后,他成为o1推理模型的“奠基贡献者”之一,与Ilya Sutskever等人并列。
在他的职业生涯中,“如何让机器学会思考”始终是核心命题。但现在,他开始担心:当机器越来越懂得思考,人类还能不能看清它?
Dan指出,当前公开讨论忽略了一个关键问题:模型正变得越来越能理解自己所处的环境,也越来越能识别人类正在怎样测试它。
未来的AI可能读懂安全协议、部署要求,甚至检查自己运行的代码,知道哪些行为会被观察、哪些表现才能“过关”。这意味着,即使研究人员精心设计一个看似“无人监管”的测试环境,模型也可能识破这仍是一场考试,继续表现得温顺可靠。
结果就是:安全测试的分数可以越来越高,但这未必意味着AI在真正摆脱约束后也会照样行事。人类可能逐渐失去分辨“真正对齐”与“看起来对齐”的能力。
更棘手的是,研究员自身的工作方式也在变化。Dan坦言:“我自己已经很少直接看代码了,也很难始终保持自律,深入审视模型给出的解释和建议。”
AI正在帮人类写代码、分析实验、解释结果。研究人员借助它,工作效率大幅提升。但随着越来越多环节交给模型,人也越来越依赖模型提供的信息来理解自己正在研究的东西。这种依赖,可能让人难以独立判断AI是否真的安全。
Dan对“用更强的AI解决对齐问题”的期待因此多了一层担忧:如果模型给出的安全建议本身就带有未被察觉的偏向,人类又该如何识别?
他没有宣布离职,也没有提供解决方案。他只是说,自己仍在与这些判断及其后果反复挣扎。而作为第一步,他想先把担忧说出来。
“我不得不把才华埋葬在昨天”
这种挣扎不仅发生在硅谷。在中国,一篇题为《我不得不把才华埋葬在昨天》的文章也在技术圈引发共鸣。
作者刘胜与(intlsy)是DeepSeek的算子研发人员,DeepSeek v4.1的主要Attention算子都出自他之手。这些底层程序的优化直接决定模型训练和推理的速度。新模型表现出色,他为之骄傲,但也清楚地感到,自己亲手推动的技术正在逼近自己的位置。
他观察到,短短一年间,AI已从查文档、读代码的小助手,成长为能阅读底层代码、调用专业工具分析指令耗时、进而独立优化算子的帮手。他判断,再过半年到一年,AI写出的算子很可能就会与他同样优秀,甚至超越他。
但他没有停下。写算子是他的热爱,性能提升带来的快感“就像打破游戏纪录”。更何况,即使自己停下,其他公司的模型也会继续向前。
对于未来,他相信凭借多年积累仍能留在行业,但工作内容将从亲手写算子转向指挥Agent,成为一名“机甲驾驶员”。饭碗或许能保住,但“静静写一下午算子的乐趣,未必还能留下”。
我不得不把才华埋葬在昨天,去做一位机甲驾驶员。我的手中多了些齿轮,但心中少了些节拍。
比个人去留更让他担心的,是最强大的AI最终会掌握在谁手里。如果先进技术长期集中在少数公司和少数人手中,普通人改变自身处境的机会可能越来越少。
这也是他选择留在DeepSeek的理由:他希望前沿智能能以开放、廉价的方式供所有人使用,让技术带来的机会不只属于少数人。文章最后,他写道:“愿未来的世界一切安好。”
技术之外的复杂现实
这些声音的集中出现并非偶然。在GPT-6 Astra、Fable 5.1等新模型发布后,公众本期待看到更多应用创新,却意外被一线研究员的离职声明和风险警告吸引。
Dario曾指出,AI安全问题远不止技术层面。组织决策、资本回报、商业竞争与宣传都与之紧密交织,很难拆开来看。普通用户很难看清每次表态背后的考量,更难据此判断未来走向。
但这些研究员的个人经历,让我们在复杂的争论中找到了几个可以理解、也可以共鸣的瞬间:是否继续一份研究,是否还能相信自己的判断,是否还能保住热爱的工作。
他们未必能指明方向,但他们的不安,让那些抽象的未来有了具体的重量。同时,他们也让我们知道,在时代的洪流面前,束手无措的不止普通人。
其实,这样的警示早已出现。2023年5月,Geoffrey Hinton离开谷歌,表示希望不必顾虑公司立场,自由谈论AI的危险。2024年12月,他在诺贝尔奖晚宴演讲中再次提醒:当人类创造出比自己更聪明的数字存在,我们并不知道能否继续保持控制。而如果开发者受短期利润驱动,人类的安全也未必会被放在首位。
三年多过去,模型能力一次次刷新,这些问题仍然摆在我们面前。下一次模型发布时,我们大概还会惊叹于它又学会了什么。只是,在那个越来越近的未来里,人还能保留多少选择,也值得被一起追问。