商汤大装置拿下中国Neocloud市场近半份额
Neocloud是什么?为什么突然重要了
最近一份由弗若斯特沙利文和头豹研究院联合发布的《中国全栈AI云服务市场报告 2026H1》提到一个新词:Neocloud(新云)。它指的是一类从诞生起就围绕AI构建的云服务商,和阿里云、百度智能云这类传统云计算厂商“后来加AI”的路径不同。
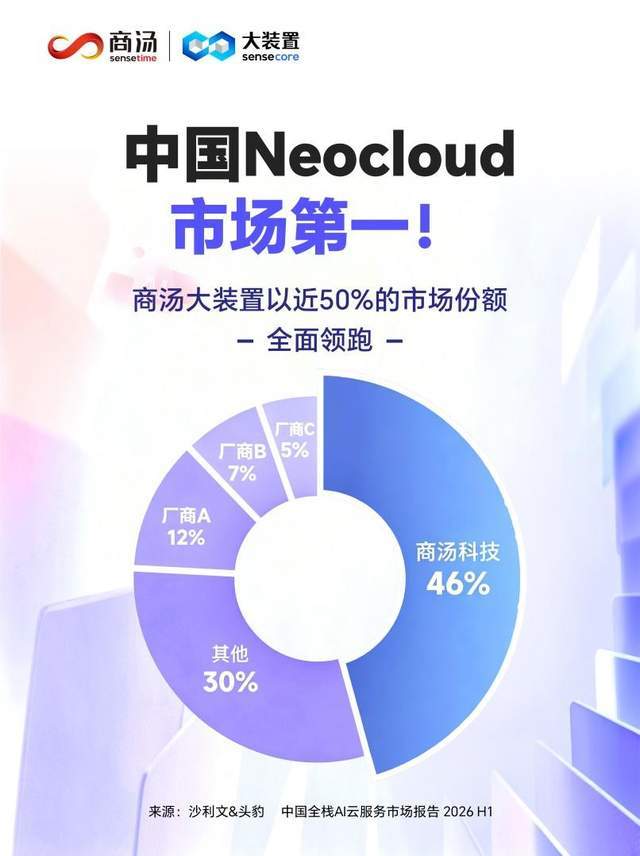
报告把商汤科技的大装置列为国内Neocloud的代表,还给出一个具体数字:市场份额接近50%,排第一。这个数据背后,其实反映的是AI基础设施正在经历一次结构性变化。
关键转折点是2026年被称作“Agentic AI元年”。这类AI不再只是被动回答问题,而是能主动规划、调用工具、执行任务。但代价是——同样生成一个Token,Agentic AI需要的算力可能是传统大模型的10倍以上。这对供电、散热、网络互联和集群调度都提出了更严苛的要求。
传统云平台虽然也能跑AI,但架构上毕竟不是为这种高密度、长时间、强并行的负载设计的。而Neocloud从底层开始就按AI的需求搭,比如商汤大装置,早期就是为训练自己的视觉大模型建的,后来逐步开放成对外服务的智算平台。
商汤靠什么拿下近一半市场
沙利文报告里提到,海外Neocloud玩家如CoreWeave、Nebius主要聚焦在提供高性能GPU算力。但商汤走的路不太一样,它试图覆盖从算力到行业落地的完整链条。
首先是端到端能力。商汤不只卖裸金属或虚拟机,而是把算力、调度平台、模型工具链和行业解决方案打包。比如企业要部署一个工业质检模型,商汤能提供从训练集群配置、推理部署到与产线系统对接的一整套服务。这种“交钥匙”模式在制造业、金融等场景很吃香。
其次是超大规模集群的稳定性。AI训练动辄上千卡,节点故障、网络抖动几乎不可避免。商汤用了断点续训、自动容错、拓扑感知调度等技术,让集群在动态扩容或硬件波动时仍能保持高利用率。有客户反馈,他们一个百亿参数模型的训练周期因此缩短了近两周。
第三是算力和电力的协同。现在电费已经占到智算中心运营成本的40%以上。商汤搞了个“算电协同Agent”,能根据电价波动、业务优先级和冷却效率动态调整任务排期。比如夜间谷电时段多跑训练,白天高峰则切到低功耗推理任务。这种系统级优化能让整体TCO(总拥有成本)下降15%左右。
国产算力真的能打了吗
过去两年,国产AI芯片进展很快,但实际落地常卡在两个问题:一是单卡性能和NVIDIA有差距,二是软件栈不成熟导致集群效率低。商汤的做法是绕过“硬拼单卡”,转而优化整体推理性价比。
他们用了一种叫“PD分离异构混合推理”的技术。简单说,就是把模型的不同部分拆到不同类型的芯片上跑——计算密集的部分用高性能卡,轻量任务用便宜卡,中间通过高速互联协调。实测下来,整体推理性价比达到了NVIDIA H系列的1.25倍。
更关键的是,在相同成本下,这种方案的日均Token产出量是纯国产同构集群的2.5倍。这意味着客户花同样的钱,能服务更多用户请求。对想控制成本又必须用国产芯片的政企客户来说,这可能是目前最可行的路径。
截至2026年8月,商汤平台日均Token服务量已达4.5万亿,预计年底冲到10万亿。这个数字背后,其实是大量垂类模型在跑——比如银行的风控模型、医院的影像分析、工厂的预测性维护,每个都在持续产生Token。
不只是卖算力,还要懂行业
Neocloud如果只做算力租赁,很容易陷入价格战。商汤的策略是深入行业,和客户一起定义问题。他们提了一个“FDE模式”:Field(现场)、Data(数据)、Engine(引擎)三位一体。工程师直接驻场,和客户一起梳理业务流程、标注数据、迭代模型。
比如在某港口项目,最初客户只想用AI识别集装箱编号。但驻场团队发现,真正影响效率的是堆场调度。于是他们额外开发了基于视觉的堆场状态感知模块,把调度决策时间从小时级降到分钟级。这种“超出预期”的交付,让客户第二年就把合作范围扩大到了整个物流链。
这种打法虽然重,但粘性强。一旦AI嵌入核心业务流程,替换成本就很高。目前商汤在智慧城市、医疗、汽车、金融四个领域都有超过50个深度合作案例。
生态战刚刚开始
沙利文预测,未来三年AI云的竞争会从“谁的GPU多”转向“谁的生态效率高”。单点技术优势不够了,得看整个产业链能不能跑通——从芯片、框架、模型到应用。
商汤在WAIC 2026上拉了近20家伙伴启动“银河计划”,包括芯片公司、ISV(独立软件开发商)、行业集成商。目标不是简单拼凑资源,而是共建一套兼容国产芯片的标准化工具链。比如统一模型格式、共享性能调优库、联合认证解决方案。
已经有几家参与方透露,他们正在测试一个跨芯片平台的自动迁移工具。开发者在一个NVIDIA集群上训练好的模型,能一键转到昇腾或寒武纪集群上跑,性能损失控制在10%以内。如果真能落地,国产算力的 adoption(采用率)可能会加速。
算力规模是底线,迭代速度才是天花板
商汤内部有个说法:“算力规模决定你能不能活下来,但响应速度决定你能长多大。” Agentic AI时代,客户需求变得极快——今天要支持多模态推理,明天要接入实时数据流,后天又要优化能效比。
传统云厂商的组织架构偏稳态,功能上线周期动辄几个月。而商汤把大装置团队做成“AI原生组织”,产品迭代以周为单位。比如他们最近推出的Token精炼工厂,就是把低质量Token过滤、高质量Token缓存、动态批处理打包成一个服务,客户开箱即用。
这种敏捷性在早期市场特别重要。当大家都在摸索Agentic AI的最佳实践时,谁能更快试错、更快交付,谁就能积累更多真实场景数据,反过来优化基础设施。这是一个正循环。
当然,挑战也不少。比如国产芯片的软件生态依然碎片化,跨厂商兼容仍是难题;再比如电力供应的地域限制,让智算中心选址越来越难。但至少目前,商汤靠着全栈能力和行业深耕,在Neocloud这条新赛道上跑出了领先身位。