HSImul3R:让三维重建从“看起来对”变成“物理上能用”
视觉上成立,物理上却可能崩塌
人坐上椅子,对我们来说再自然不过。我们不仅看到动作,还本能地知道:椅子要承重,臀部会压在椅面上,双腿悬空或踩地,整个系统在重力作用下保持平衡。这种对物理交互的理解,是人类感知世界的基础。

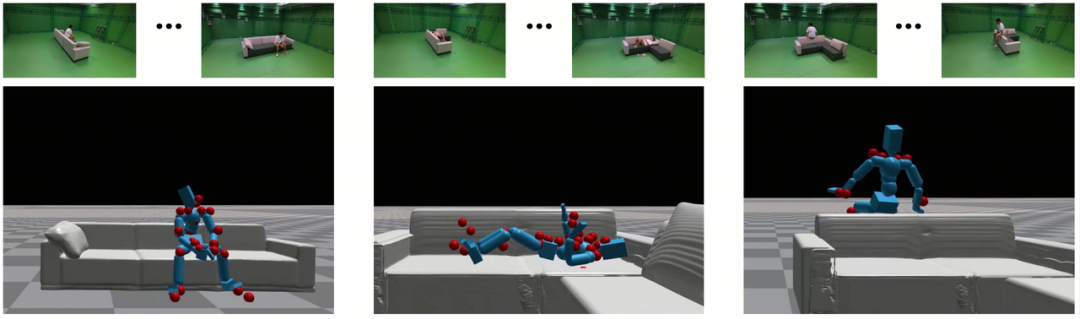
但对当前的三维重建系统而言,“看见动作”和“重建真实交互”之间仍有巨大鸿沟。一个在图像中看起来完美坐在椅子上的人体模型,一旦放进物理仿真器,椅子可能因结构缺失而倾倒,人体也可能直接“穿”进椅面——视觉上成立,物理上却不成立。

问题出在哪?传统三维重建主要追求几何准确、姿态还原和视觉对齐,回答的是“像不像”。但对于机器人这类具身智能体来说,它们最终要在一个由重力、碰撞、摩擦和接触决定的真实世界中行动。如果重建出来的世界经不起物理推敲,再逼真的渲染也毫无意义。
HSImul3R:把物理规则嵌入重建过程
为解决这一问题,大晓机器人联合南洋理工大学 S-Lab、上海人工智能实验室提出了 HSImul3R(Physics-in-the-Loop Reconstruction of Simulation-Ready Human–Scene Interactions)。这项工作已被计算机视觉顶会 ECCV 2026 接收,核心目标是推动三维重建从“视觉正确”走向“物理可执行”。
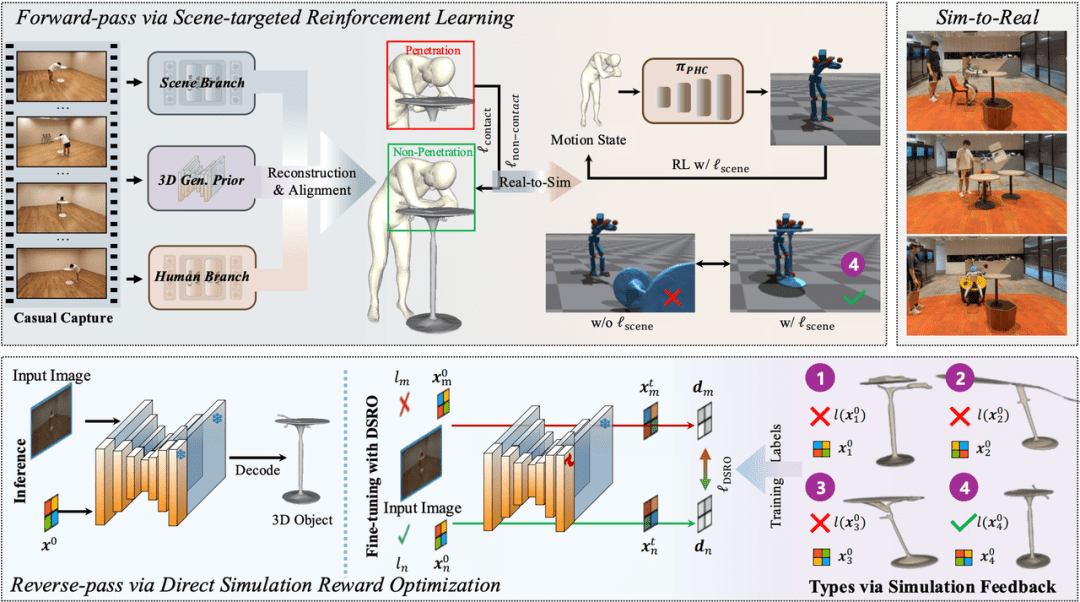
HSImul3R 的关键创新在于,它不再把物理仿真当作事后的检验工具,而是将其变成重建过程中的主动监督者。团队提出了 物理闭环(Physics-in-the-Loop)双向优化框架:一边优化人体运动,使其在特定场景中稳定交互;另一边反向修正三维场景,确保物体能支撑真实的人–物接触。
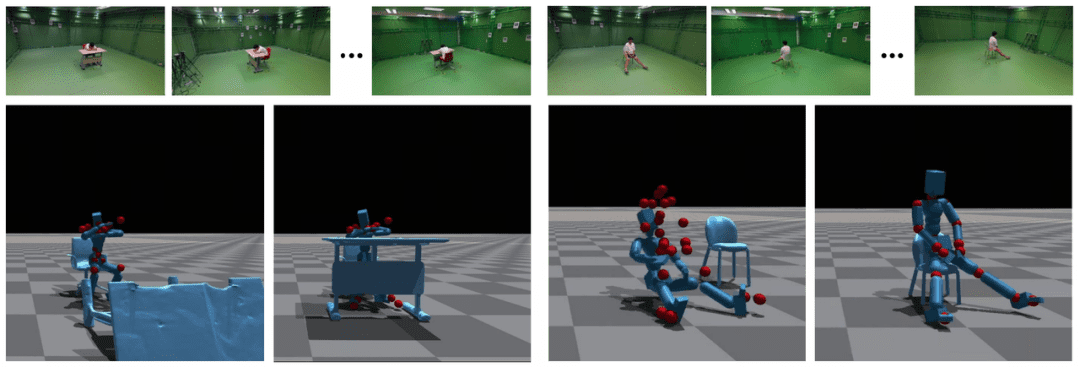
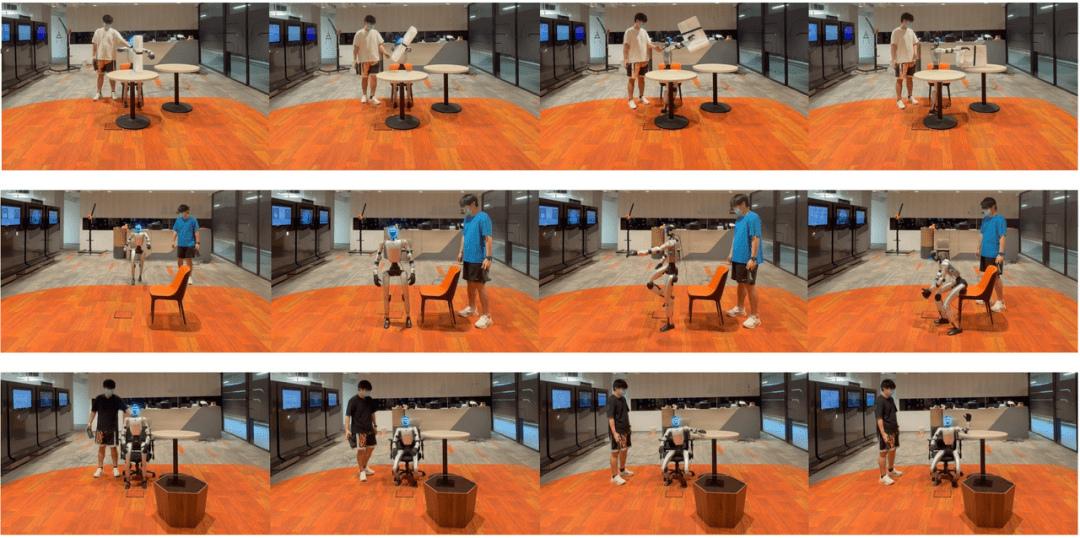
更重要的是,该方法支持非标定稀疏视角输入,甚至能处理单目视频,更贴近实际应用场景。最终,团队还将优化后的人体动作迁移到 Unitree G1 人形机器人上,打通了从日常视频到真实机器人执行的完整链路。
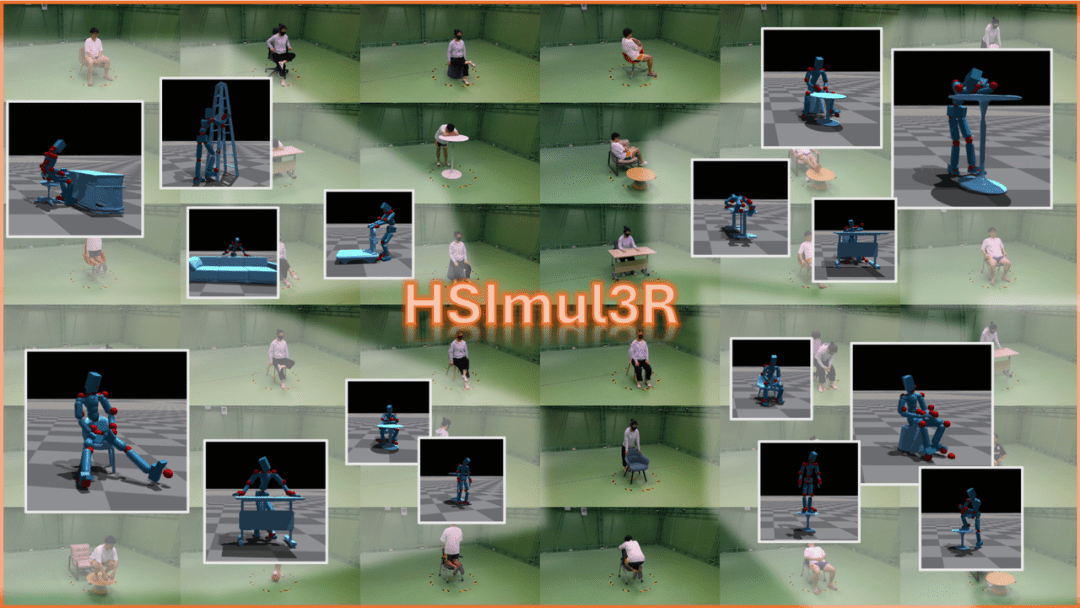
不只是让人站稳,更要让人“坐得住”
传统人体运动估计或强化学习方法,通常关注人体自身是否动力学可行——比如走路不摔倒、动作流畅。但即使人体动作物理上成立,也可能已经脱离了原始的交互意图。
举个例子:一段“坐在椅子上”的视频,经过普通运动优化后,人体可能为了保持平衡而微微前倾或侧移,结果臀部完全没碰到椅子。人是没倒,但“坐”这个交互已经消失了。
HSImul3R 提出 面向场景的强化学习(Scene-targeted Reinforcement Learning),在运动跟踪基础上加入场景交互约束。系统通过检测人体关键点(如臀部、手肘)与物体表面的空间关系,确保优化后的动作不仅符合物理规律,还能与当前场景形成有效接触。
换句话说,它优化的不是一条抽象的“合理轨迹”,而是一段在特定环境中真正能成立的物理交互。“坐下”就必须真实坐到这把椅子上,而不是在空中比划一个相似姿势。
用交互结果反过来修正三维场景
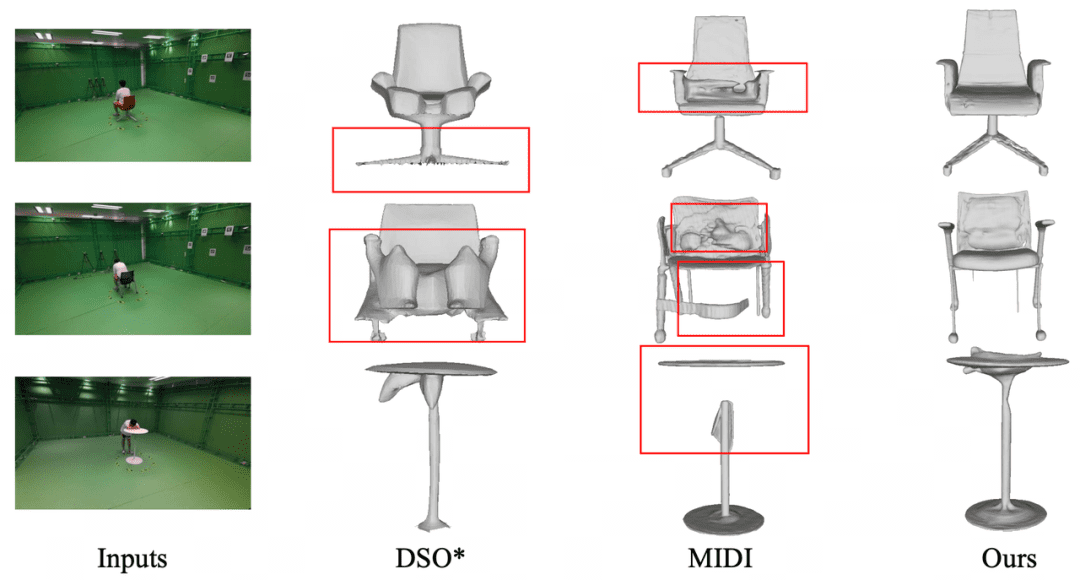
但问题不止出在人体动作上。很多时候,仿真失败是因为场景本身没建对。尤其在人类遮挡严重的情况下,像桌腿、椅腿这类细长结构很容易在图像到三维的转换中丢失或变形。即使人体动作完全正确,一把“缺腿”的椅子也会在人坐上去时瞬间倒塌。
针对这一问题,HSImul3R 在反向路径中引入 直接仿真奖励优化(Direct Simulation Reward Optimization, DSRO)。系统将物理仿真的交互结果作为监督信号,反向优化三维物体生成模型。
具体来说,团队将仿真反馈划分为四种状态:
- 物体自身在重力下失稳(如椅子自己就倒了)
- 物体稳定,但人一接触就失稳
- 人与物体接触但未形成有效支撑(如悬空轻触)
- 人与物体实现稳定交互(如稳稳坐下)
只有最后一种情况才被视为重建成功。这意味着,评价标准从“物体自己能不能站住”升级为“人和它互动之后还能不能稳住”。人类的交互行为本身,成了优化三维世界的监督信号。
HSIBench:用物理实操检验重建质量
为了验证这套新范式,团队构建了专门面向人–场景交互的基准数据集 HSIBench。它包含 19 种常见家具(椅子、沙发、桌子等)、超过 50 段人体动作序列和 300 个独立交互实例,由 3 名参与者完成,每个案例从 16 个同步视角采集。
与传统三维重建基准不同,HSIBench 的核心指标是 人–场景交互稳定性(Stability-HSI)。它不仅检查物体在重力下是否稳定,还要求整个交互进入仿真后仍能保持结构完整,并保留有意义的人–物接触。
实验结果显示,在 Easy、Medium 和 Hard 三档任务中,HSImul3R 的交互稳定率分别达到 53.68%、30.56% 和 13.92%,远高于基线方法 HSfM 的 10.52%、4.50% 和 2.66%。同时,人–场景三维穿模率从 69.51% 降至 22.90%。
这些数字说明:当三维重建服务于机器人时,“看起来真实”远远不够。重建的世界必须能承受真实的动作与力。
从视频到机器人:让人类经验变成可执行技能
HSImul3R 的另一突破,是实现了从人类视频到真实机器人的完整迁移。团队首先将物理优化后的人体运动重定向至 Unitree G1 人形机器人,再以这些动作为先验,在仿真中训练全身控制策略,最终直接部署到真实机器人上。
这意味着,一段普通人坐在椅子上的手机视频,经过 HSImul3R 处理后,可以变成 G1 机器人在现实环境中复现的“坐椅子”技能。整个流程覆盖了:
- 日常图像/视频输入
- 三维人–场景交互重建
- 物理仿真优化
- 动作迁移与控制策略训练
- 真实机器人执行
这条路径打开了一个新可能:互联网上数以亿计的人类行为视频,不再只是供 AI “观看”的视觉数据,而可能成为机器人学习物理技能的宝贵资产。只要交互能被重建、验证并迁移,视频就变成了可仿真、可学习、可执行的技能库。
距离实用还有多远?
当然,这条路还很漫长。目前 HSImul3R 主要处理静态单物体场景(如一把椅子),复杂环境(如厨房操作台上有多个物品)、动态物体(如开门、推车)或柔性交互(如躺沙发、叠衣服)仍是挑战。此外,单目视频输入下的重建精度仍有提升空间。
但它的价值在于指明了一个方向:机器人从人类视频中学到的,不应只是“人看起来怎么动”,而应该是“这个动作为什么能在物理世界中成立”。
过去,三维重建的目标是“还原视觉”。现在,HSImul3R 正在推动它走向“支撑行动”。当重建结果能直接用于仿真和机器人控制,三维视觉才算真正迈入了具身智能时代。