阿里千问开源 Qwen-Image-2.1:小模型解决图像生成与编辑的实际痛点
小模型,大改进
对设计师和电商运营来说,AI 生成图片常常“差一口气”——整体画面不错,但文字错位、商品变形、人物特征丢失,或者改一处就得重做整张图。这些细节卡住了 AI 进入真实工作流的脖子。
阿里千问最新开源的 Qwen-Image-2.1,试图用一个仅 7B 参数的视觉生成模型,解决这些实际痛点。它不是追求炫技的超大模型,而是聚焦于“能用、好改、少返工”的生产力场景。
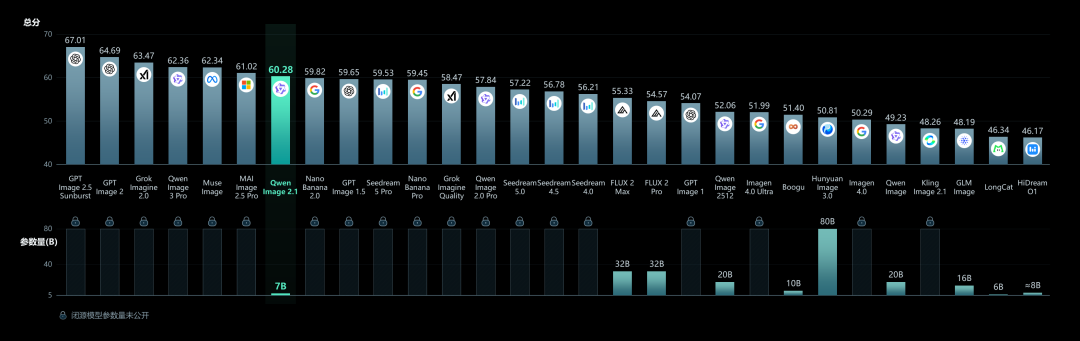
在公开评测 Qwen-Image-Bench 上,它的总分达到 60.28,超过了 Nano Banana 2.0(59.82)和 GPT Image 1.5(59.65),成为当前开源图像模型中的第一名。更关键的是,它把文生图、图像编辑、透明素材生成全部整合进同一个轻量架构里,为开发者和创作者提供了一个高性价比的起点。
原生支持透明图,省掉抠图步骤
设计工作中最耗时的环节之一,就是处理素材背景。常规 AI 生成的图片自带完整背景,要用于海报或商品详情页,还得手动抠图、修边缘、调融合。而 Qwen-Image-2.1 原生支持透明图(RGBA)生成,用户只需在提示词中说明“透明背景”或“可叠加素材”,模型就能直接输出带透明通道的图像。
官方展示的样例包括节庆插画、人物角色、装饰元素,甚至由多个对象组成的复杂组合。这意味着设计师可以直接拿到可用的 PNG 素材,跳过 Photoshop 或在线抠图工具的中间步骤。
更重要的是,这些透明素材还能继续编辑。比如同一个插画人物,可以调整表情、更换服装,甚至修改图中的文字内容,而主体轮廓和透明区域保持不变。这种“生成即可用、修改不重来”的能力,贴近真实的设计迭代流程。
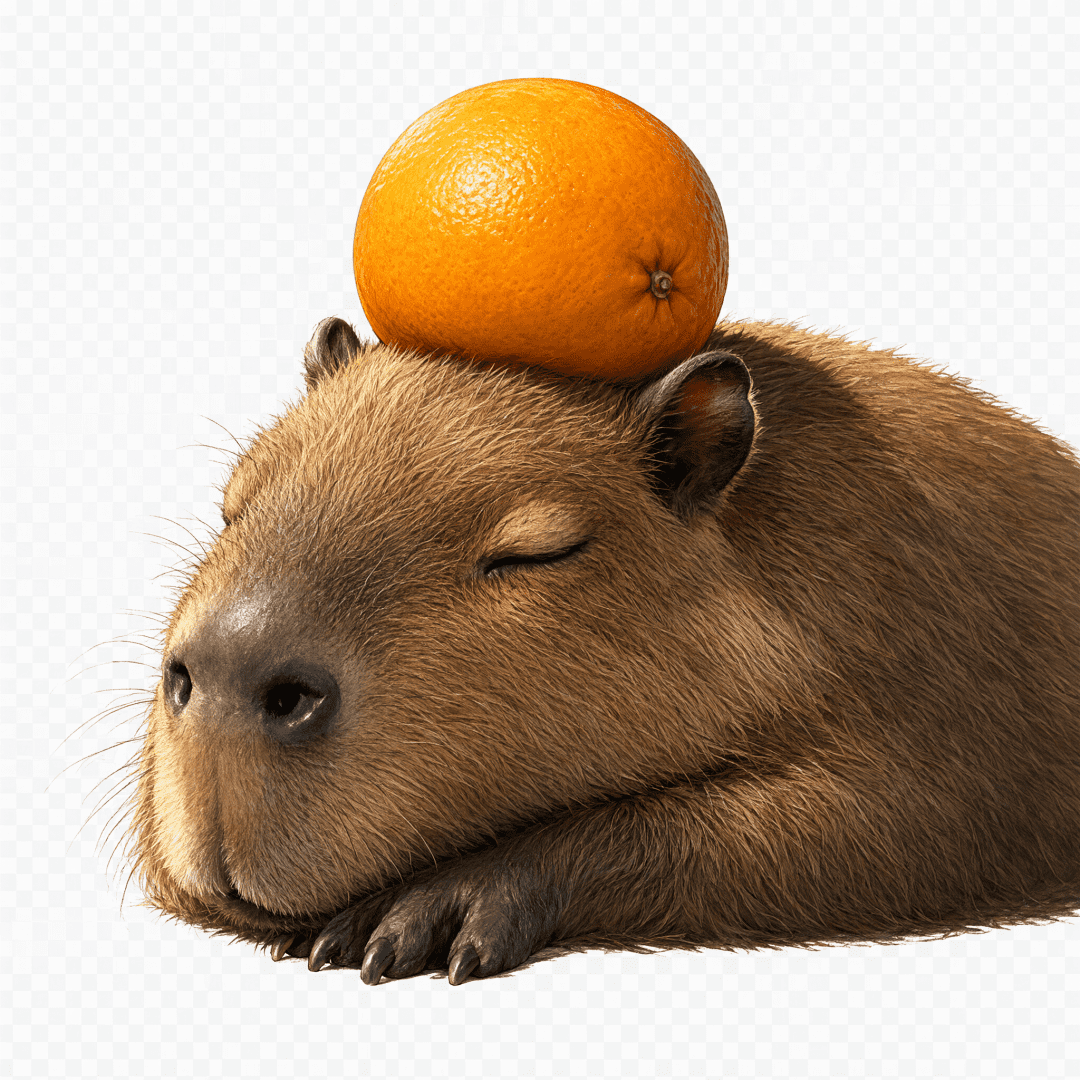
此外,模型还能从真实照片中提取主体并转为透明图。你上传一张产品实拍图,要求“只保留瓶子,背景透明”,它就能输出干净的 RGBA 图像,方便后续复用。
多图参考 + 精准局部编辑
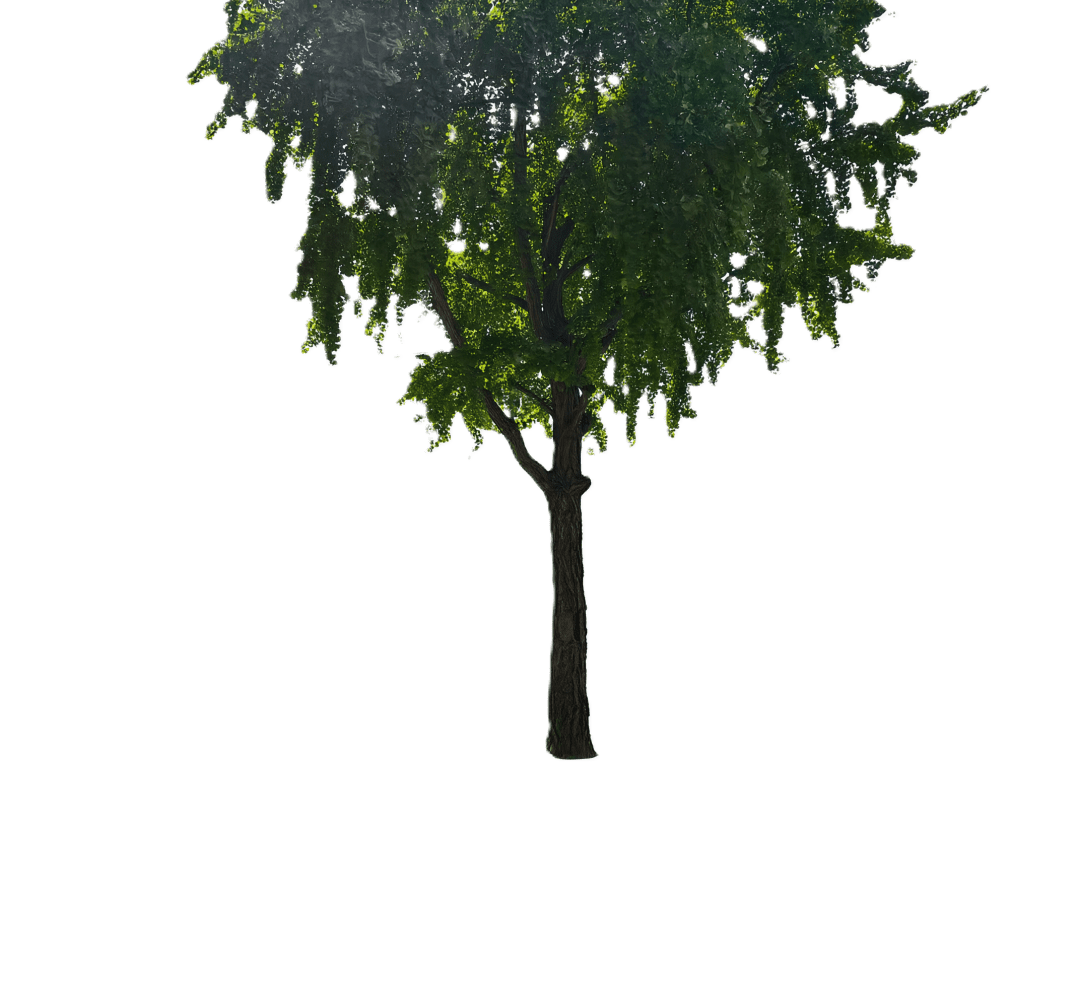
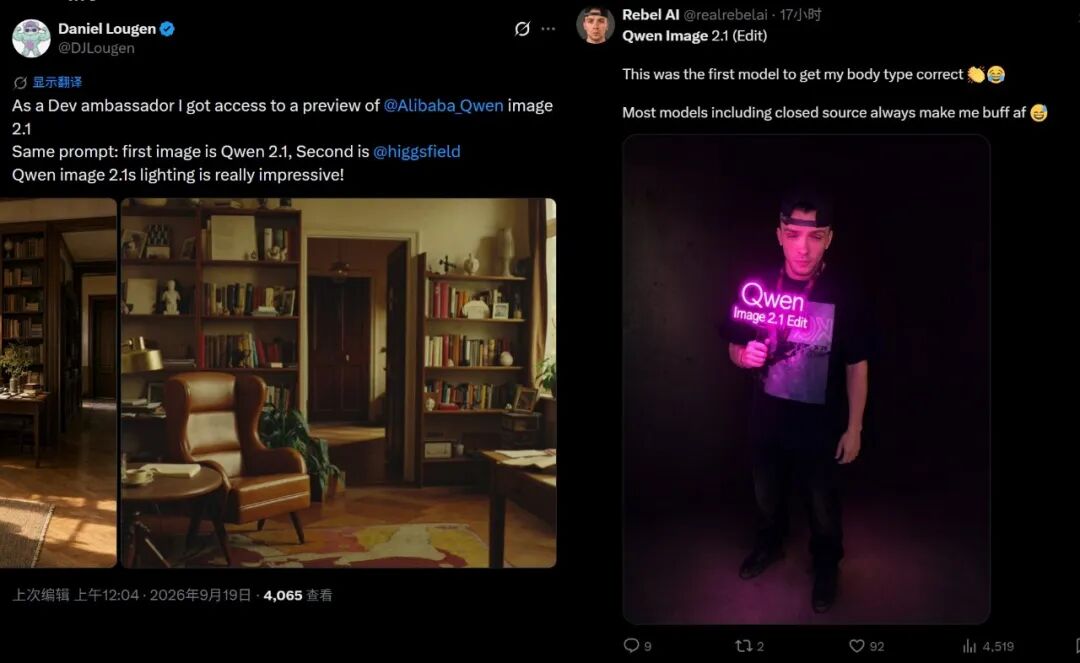
当一张图需要融合多个来源——比如给模特穿上指定衣服、搭配特定鞋子、放在某个房间背景里——传统 AI 往往顾此失彼。Qwen-Image-2.1 最多支持 10 张参考图输入,并能区分每张图的作用:哪张是人物、哪张是服饰、哪张是环境。
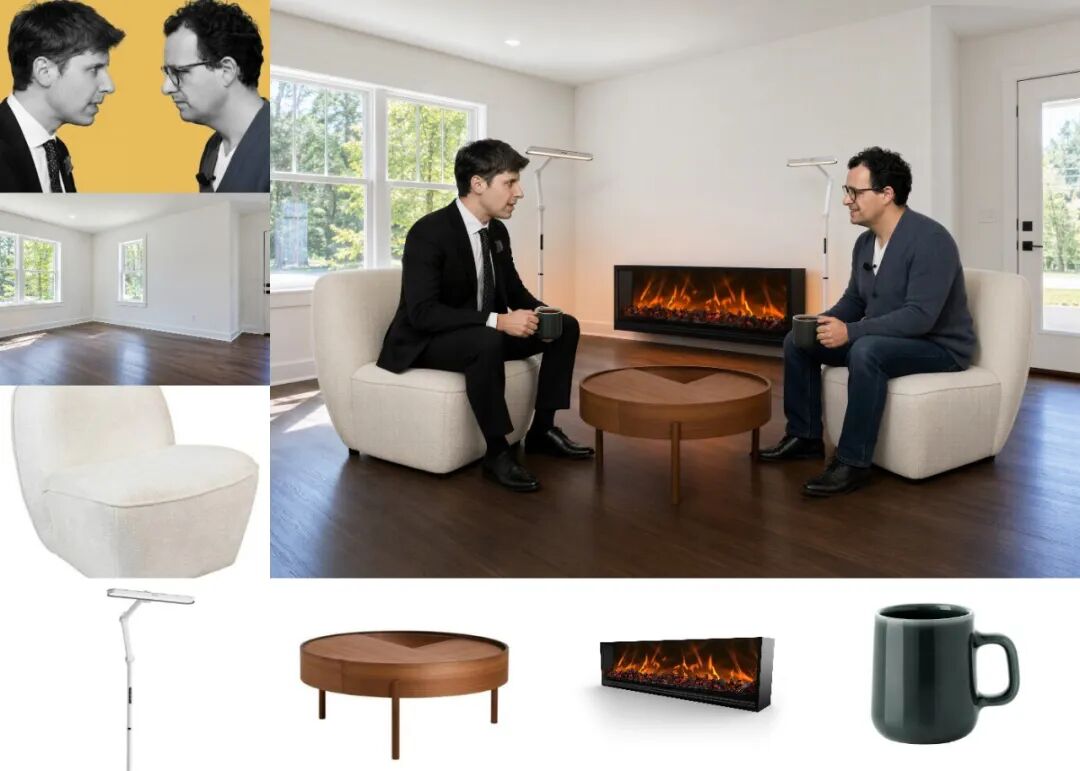
我们测试了一个场景:让奥特曼和《权力的游戏》中的达里奥坐在客厅对谈。用了 7 张参考图——两人对峙照(用于表情调整)、单人沙发、咖啡杯、落地灯、电壁炉、矮桌和房间背景。最终生成的画面中,角色比例、物品位置和光影风格基本协调,没有出现常见的肢体扭曲或物体漂浮问题。
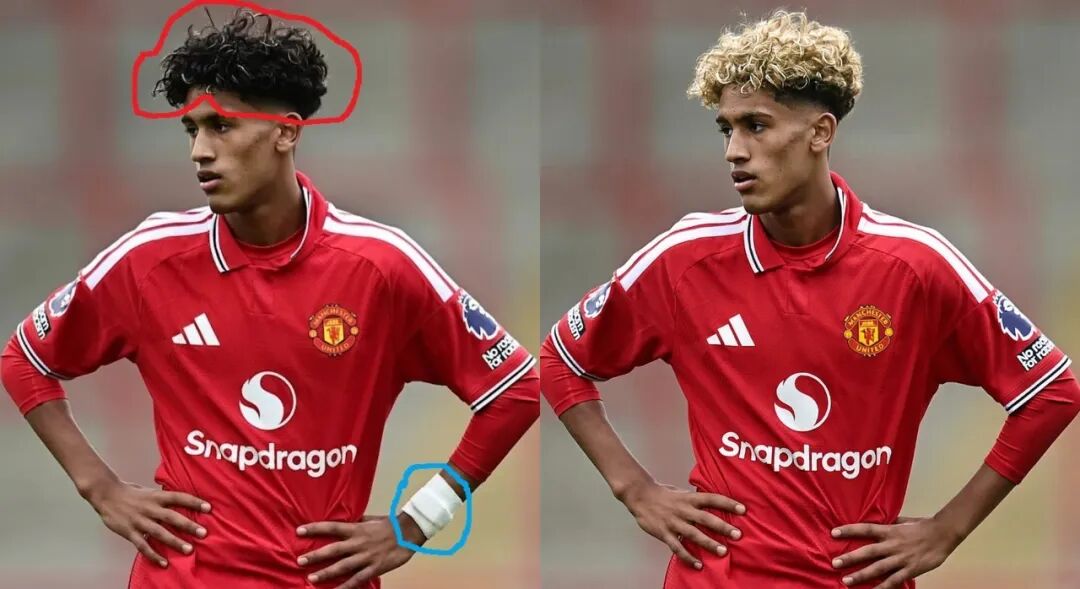
生成之后,通常还有局部调整需求。Qwen-Image-2.1 提供了多种编辑交互方式:
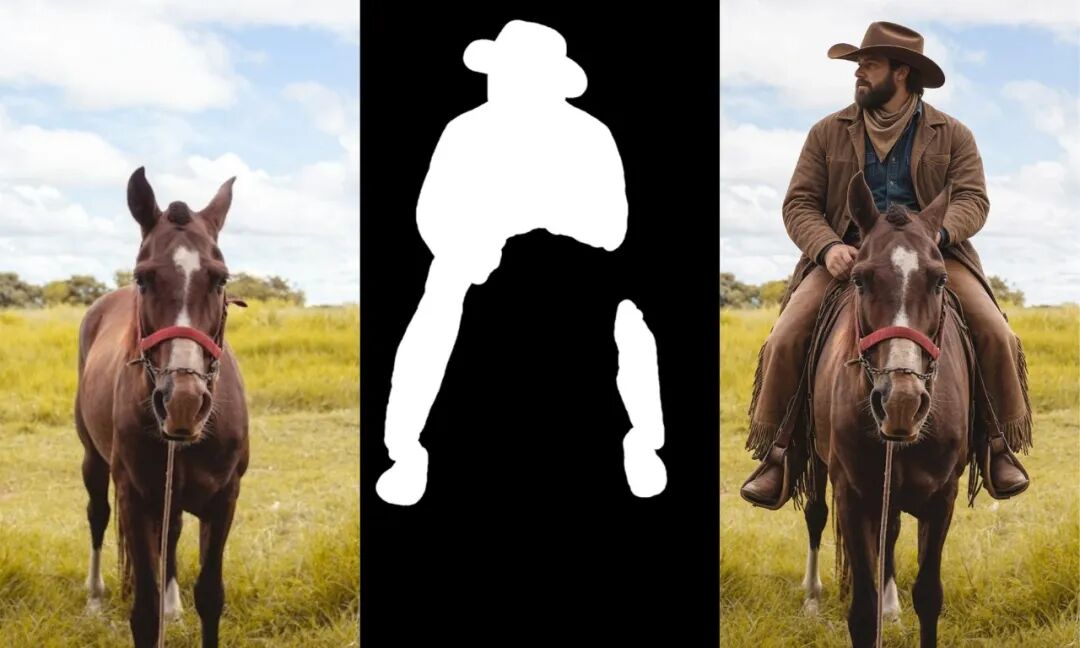
- 圈选或涂抹:直接在图像上标出要修改的区域;
- 独立掩码图:上传一张黑白掩码图,白色区域表示需编辑,避免遮挡原图信息;
- 多区域同时编辑:用不同颜色标记不同区域,分别指定修改内容,比如“去掉帽子、染红头发、替换 T 恤图案”。
这种空间与语义的对应关系,让复杂编辑指令变得更可控。尤其对于包含人物和商品的商业图,保留原始细节的同时精准修改局部,是能否交稿的关键。
文字准确与人像保真
AI 生图长期被诟病的两个短板:文字乱码、人脸失真。Qwen-Image-2.1 在这两点上做了重点优化。
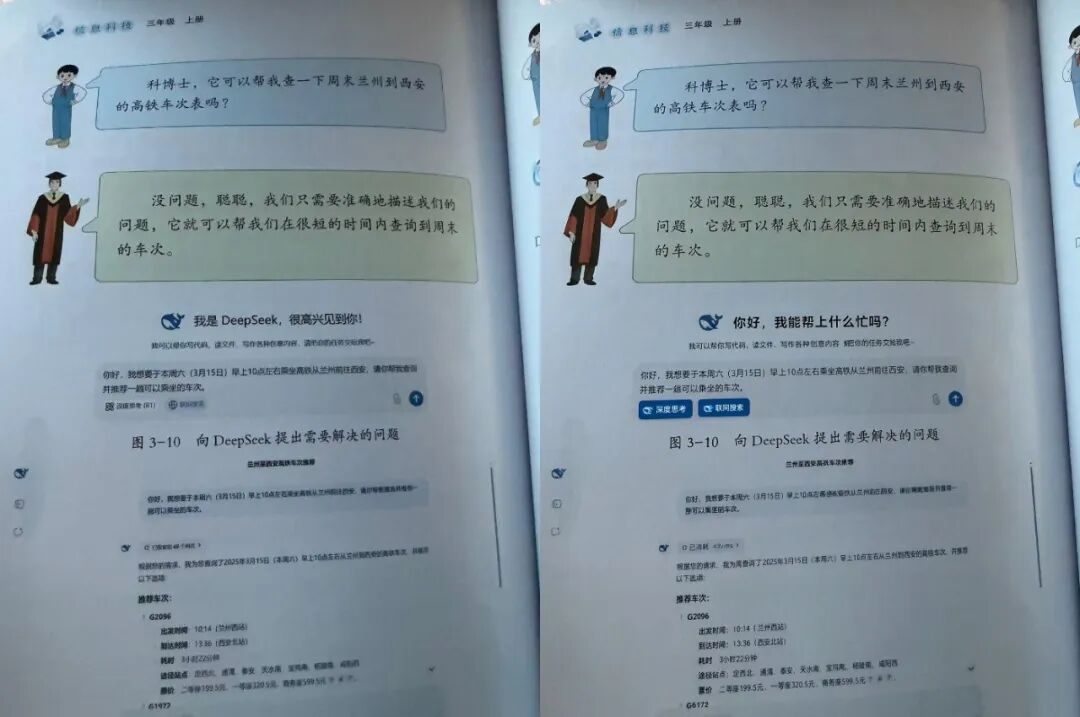
我们尝试修改小学《信息科技 三年级上册》教材截图中的 AI 对话框:将“我是 DeepSeek,很高兴见到你!”改为“你好,我能帮上什么忙吗?”,并将“深度思考(R1)”按钮更新为最新样式并点亮。结果不仅文字内容正确,排版、字体大小和按钮样式也基本一致,没有出现常见的字符错位或符号乱码。
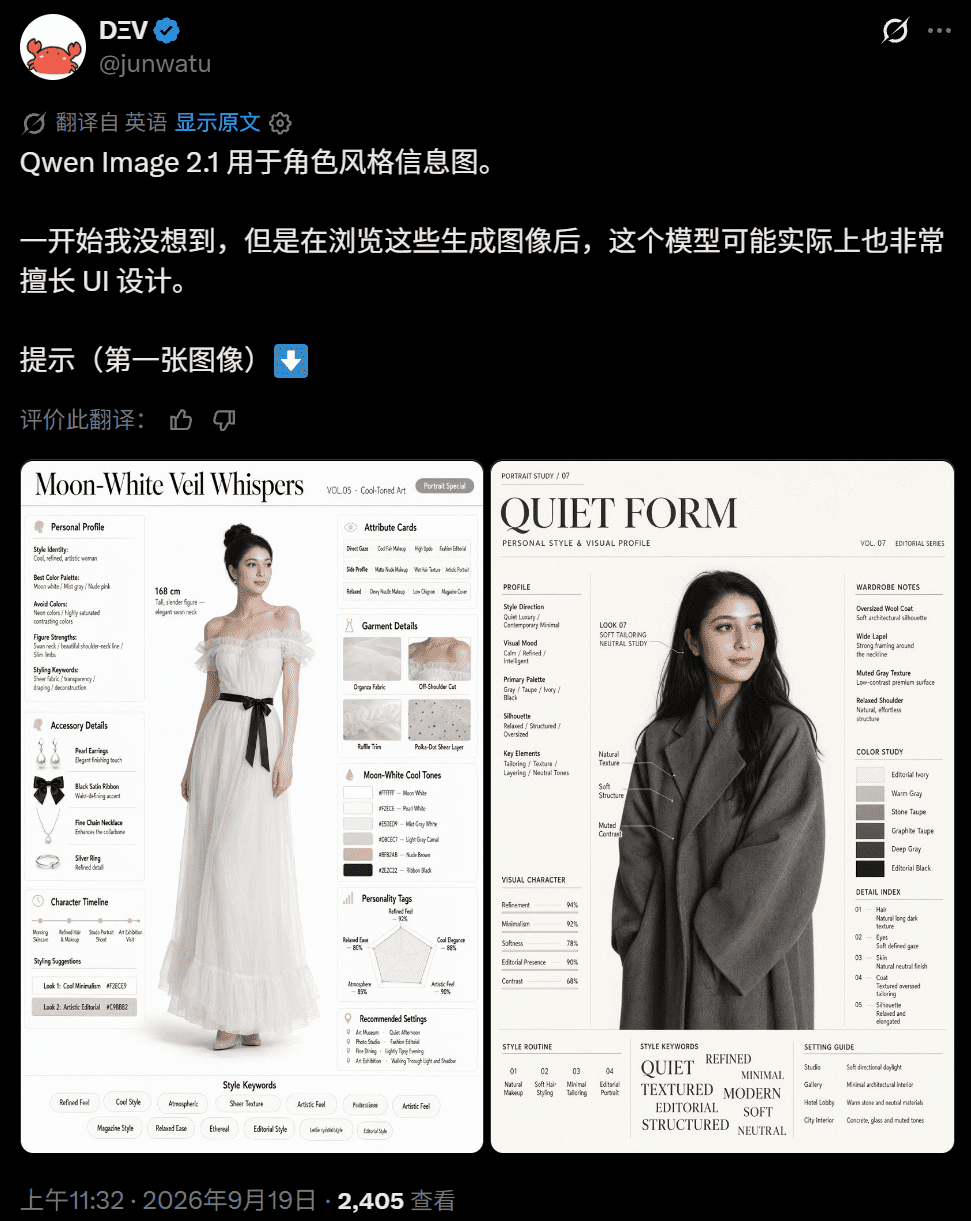
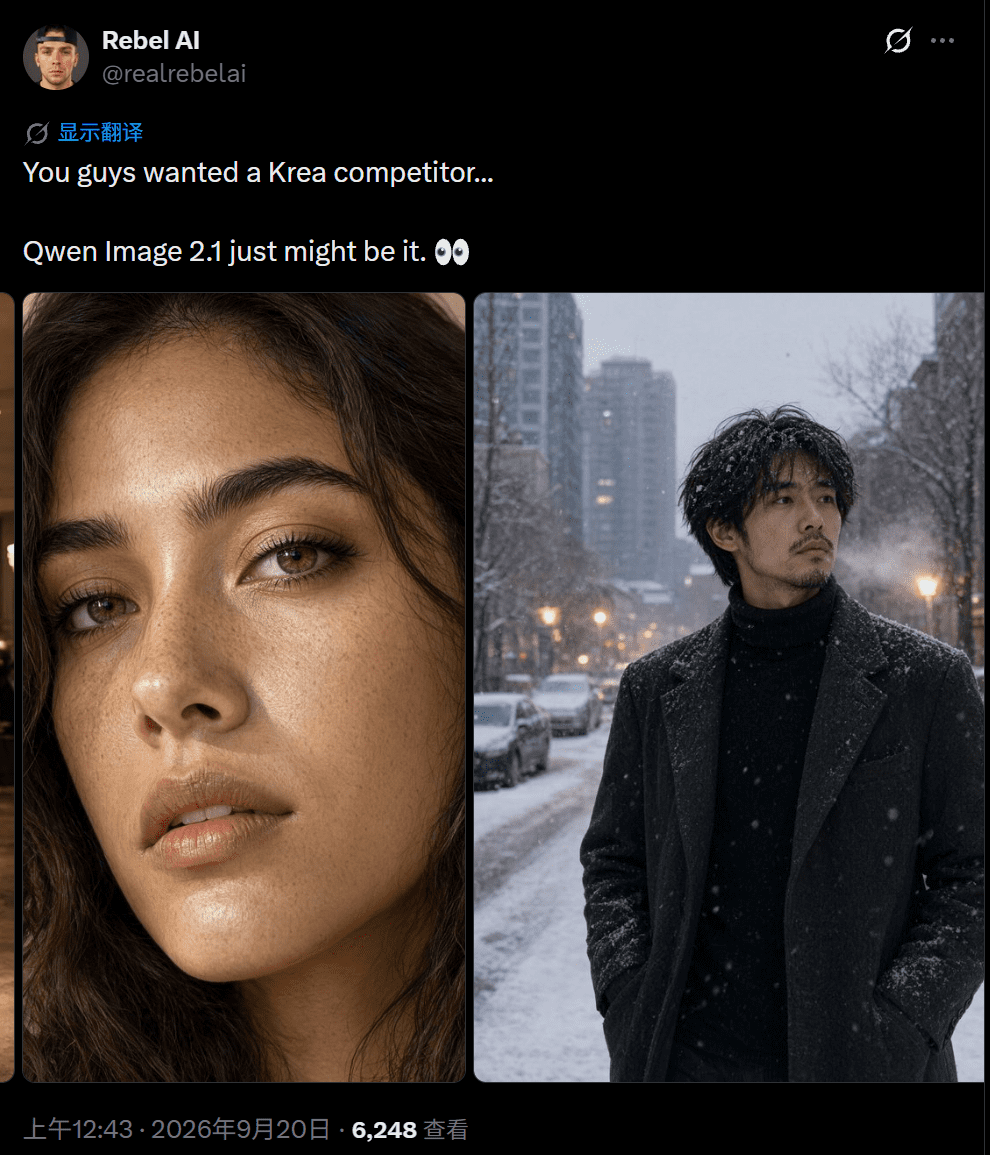
人像方面,模型增强了发丝、皮肤质感、服装纹理与环境光的协调性。即使更换发型、背景或打光风格,人物的身份特征(如脸型、五官比例)仍能保持稳定。这对于需要多次迭代的角色设计或产品代言图尤为重要——不能每次改图都变成“另一个人”。
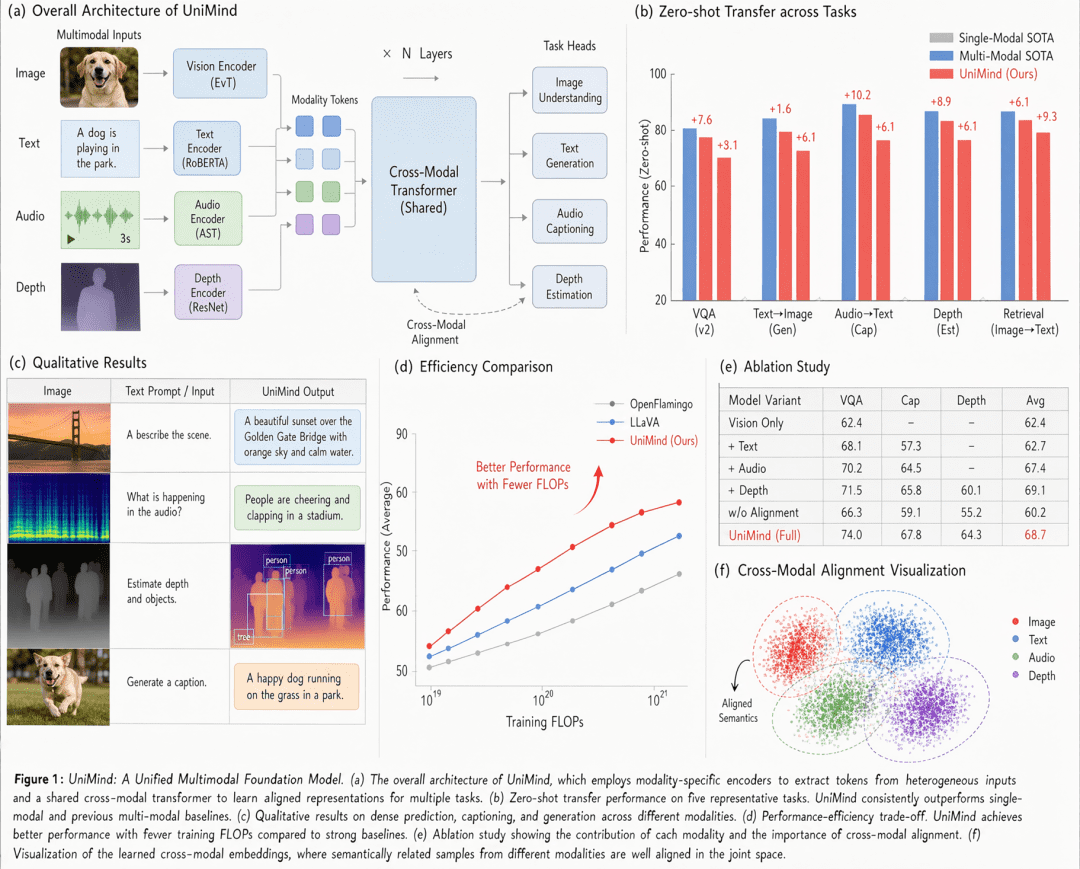
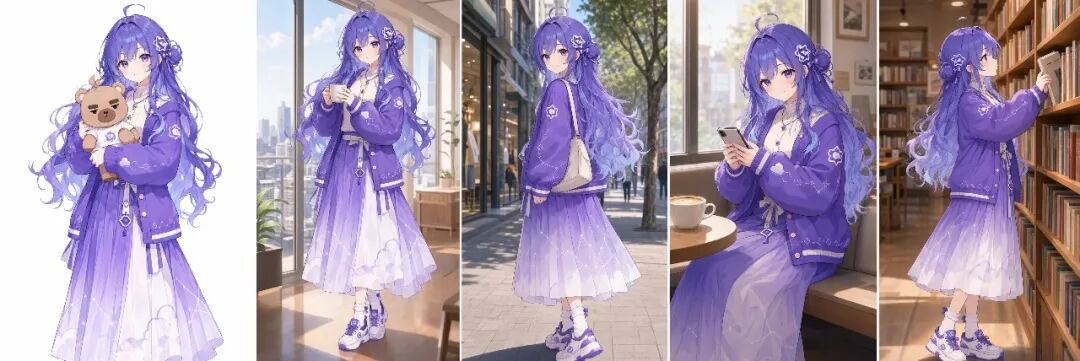
此外,新模型还提升了全景图、信息图、三视图和分镜图的生成能力。社区已有用户用 Qwen 的二次元形象生成系列分镜插画,展示了其在视觉叙事上的潜力。
轻量架构下的效率优化
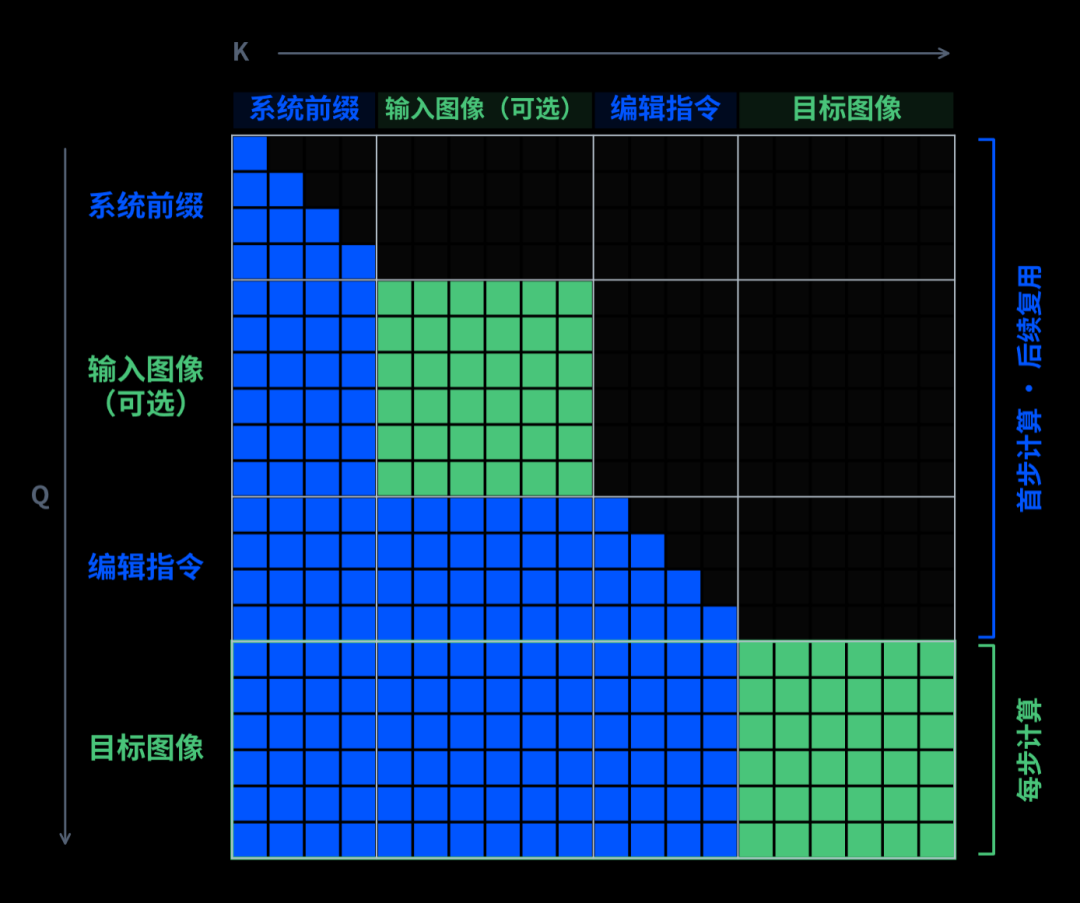
Qwen-Image-2.1 的视觉生成部分采用 20 层 Single-Stream DiT 架构,参数量仅 7B。但它通过一项关键优化,在多图输入场景下显著提升了推理效率:混合粒度注意力机制。
具体来说,文本指令(如系统提示、编辑要求)仍按传统 Token 级因果掩码逐词处理,确保语义理解连贯;而图像生成部分则采用 Chunk 级掩码,并通过 KV Cache 缓存静态上下文(如参考图特征)。这样,在逐步生成目标图像时,模型无需重复计算不变的参考信息。
这项优化在输入多张参考图时效果尤为明显。虽然具体节省的显存和时间取决于硬件、分辨率和输入数量,但对开发者而言,这意味着可以用更低的资源部署一个支持复杂编辑的图像模型。
开源带来的可能性
Qwen-Image-2.1 的权重已发布至 Hugging Face 和 ModelScope,技术报告也公开在 GitHub。它的开源,不只是多了一个模型选项,更是为围绕图像生成与编辑构建定制化工具提供了新基础。
对内容创作者来说,现在可以用一个模型完成从素材生成、组合到局部修改的完整链条;对开发者而言,7B 的体量加上统一的生成-编辑管线,降低了集成到设计软件或电商后台的门槛。
随着社区基于此模型开发插件、工作流或垂直应用,AI 图像工具可能会更快地融入日常创作。当“改个字、换件衣服、加个背景”不再需要专业技能或反复返工,从想法到视觉成品的距离,或许真的能缩短一大截。