ToolLoop:用分阶段反馈合成更精准的工具调用训练数据
工具调用数据合成的痛点
让大语言模型学会调用外部工具,比如查天气、订机票或操作数据库,关键在于训练数据的质量。一条合格的样本必须满足三重对齐:用户说的、模型选的工具、以及填进去的参数,三者要严丝合缝。

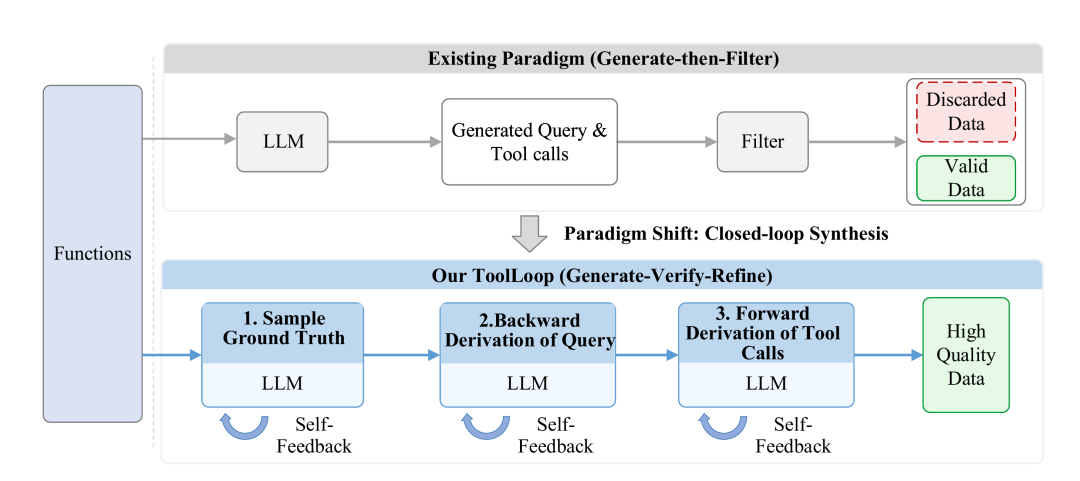
但现实中的合成方法往往粗糙。主流做法是让模型一次性生成“用户问题 + 工具调用”,再用规则或另一个模型检查格式是否合规。这种方式能筛掉明显错误,比如参数类型不对,却很难发现更隐蔽的问题——比如用户只问了北京天气,模型却额外查了上海。两次调用单独看都合法,但多出来的那次违背了用户意图。
这类错误之所以难抓,是因为整个生成过程是黑箱。一旦出错,你不知道是问题写得模糊,还是工具选多了,或是参数理解偏了。更麻烦的是,传统流程一旦判定不合格,整条样本就直接扔掉,哪怕其中某些部分其实可用。
ToolLoop 的核心思路:拆解 + 反馈
ToolLoop(发表于 EMNLP 2026)试图改变这一局面。它的核心不是“生成后筛”,而是“分阶段造 + 动态修”。整个流程被拆成三个明确阶段,每个阶段都有清晰的中间目标和对应的验证点。更重要的是,验证失败不会立刻判死刑,而是触发针对性修正。
这种方法背后有个朴素逻辑:与其指望模型一步到位写出完美样本,不如给它搭个脚手架,分步引导,并在每一步及时纠偏。
三阶段生成:从目标到实例
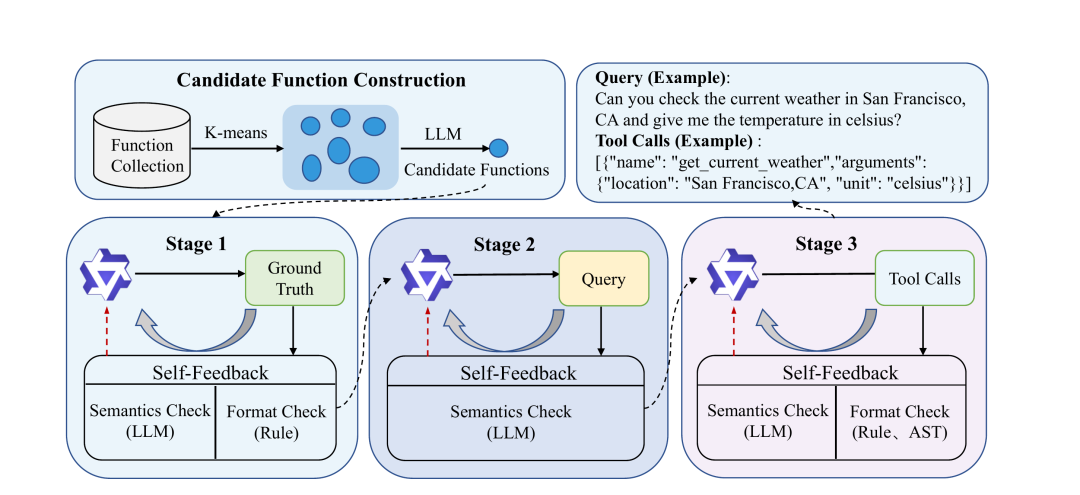
第一阶段:先定“要用哪些工具”
ToolLoop 不是从用户问题开始,而是反过来——先决定这条样本应该调用哪些函数。这听起来有点反直觉,但恰恰是控制质量的关键。
系统会从候选函数池中采样一个“目标函数组合”。这个组合可以是单个函数,也可以是多个并行调用(比如同时查两个城市的天气),但要求这些调用彼此独立,不能互相依赖结果。研究团队还用了 K-means 对函数描述做语义聚类,确保选出的组合在使用场景上有关联性,避免生硬拼凑。
这一步只确定函数名称和调用次数,不涉及具体参数。它相当于给后续步骤立了个“靶子”:后面生成的问题和调用,都必须对准这个靶心。
第二阶段:反向生成匹配的问题
有了目标函数组合,下一步是生成一个自然语言问题,这个问题必须能“解释”为什么需要这些调用。
例如,如果目标是对天气 API 做两次独立调用,问题就得包含两个地点的信息,比如“北京和上海明天的天气怎么样?”。生成的问题既要提供所有必填参数所需的信息(如城市名、日期),又不能引入目标之外的任务(比如突然问空气质量)。
验证环节会检查两点:一是信息是否充分,能否支撑后续调用;二是意图是否纯净,有没有跑题。这一步把抽象的函数计划转化成了人类可读的请求,也为第三阶段提供了明确依据。
第三阶段:正向生成结构化调用
最后,模型根据上一步生成的问题和函数定义,输出完整的工具调用。这里的要求最细:选的函数必须和第一阶段的目标一致;每个参数的值必须能在问题中找到依据;参数名、类型、输出格式也得严格符合 API 规范。
至此,一条样本才算完整。三个阶段分别处理“目标构造—意图表达—调用实例化”,错误定位变得容易。如果是参数错了,问题大概出在第三阶段;如果是问题没提必要信息,锅就在第二阶段。
动态自反馈:失败了就改,别急着扔
ToolLoop 的另一大特点是“动态自反馈”。每个阶段结束后,系统会用三类信号做验证:
- 语言模型:判断语义是否合理、逻辑是否连贯;
- 确定性规则:检查格式、数据类型等硬性约束;
- AST 解析:验证工具调用的语法结构是否合法。
如果验证失败,系统不会直接放弃,而是把原始提示、失败输出和具体错误原因打包成新提示,让模型重试当前阶段。比如,问题里漏了日期,反馈就明确说“请补充查询的具体日期”;调用格式不对,就指出“参数应为字符串而非数字”。
每个阶段最多允许三次重试。这种机制让那些“差点意思”的样本有机会被救回来,而不是因为一个小疏忽就被淘汰。毕竟,有些复杂场景本来就难生成,直接筛除会造成数据多样性损失。
当然,这也带来开销——重试意味着更多计算成本。但实验表明,这点代价换来的质量提升是值得的。
实验效果:分阶段反馈确实管用
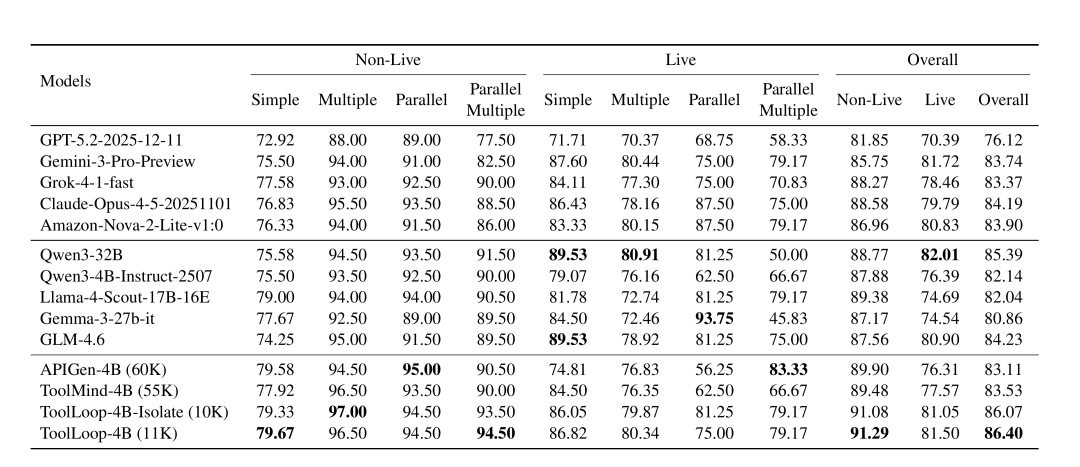
研究团队用 ToolLoop 合成了 11,024 条样本,并用它们微调了 Qwen3-4B-Instruct-2507 模型。评估在 BFCL 单轮任务上进行,结果显示:
- 完整版 ToolLoop 达到 86.40% 的准确率;
- 如果移除与评估集函数重叠的部分(Isolate 版本),仍有 86.07%;
- 在 ACEBench 上,总体准确率为 72.1%。
更关键的是消融实验:
- 不用任何反馈,仅靠初始生成,准确率只有 79.97%;
- 加入最终筛选(但无分阶段反馈),提升到 82.56%;
- 完整 ToolLoop(分阶段 + 动态反馈)则进一步拉到 86.40%。
这组对比清晰说明,分阶段验证本身就有帮助,而动态修正机制带来了额外增益。反馈不是摆设,它真的在修复那些“半成品”样本。
局限与未来方向
ToolLoop 目前仍依赖函数定义和模型判断来做验证,没有接入真实 API 的执行结果。这意味着它无法发现“参数合法但业务逻辑错误”的问题——比如传了一个不存在的城市代码,API 返回空结果,但格式上完全合规。
作者也提到,下一步可以结合实际执行反馈,把框架扩展到多轮交互场景。毕竟,真实世界中的工具调用往往是连续的:查完天气可能接着订酒店,订酒店又需要先查价格。如何在多轮中保持意图与调用的一致性,会是更复杂的挑战。
不过,就单轮工具调用而言,ToolLoop 提供了一种更精细、更可控的数据合成思路。它证明了:与其追求模型一次写对,不如设计一个允许试错和修正的闭环流程。