中国团队LimiX-2登顶结构化数据模型榜单,挑战谷歌亚马逊
LLM啃不动的数据分析硬骨头,LDM开始接手了
大语言模型(LLM)这几年能力突飞猛进,但热闹背后有个问题越来越明显:现实世界远比语言世界“更大”。
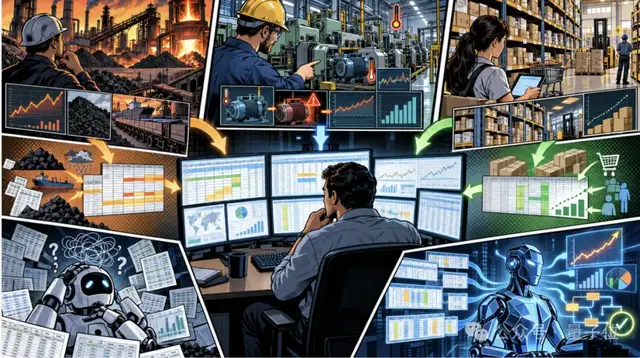
LLM处理的信息——文本、代码、论文、带描述的图像——本质上都是人类已经理解、筛选并抽象过的内容。模型学的是这些“语义化”后的知识之间的关联。换句话说,它是在人类知识体系内部打转。
但在制造业、能源、金融等产业现场,大量关键数据根本没经过这层“翻译”。温度、压力、原料配比、设备状态……几十甚至上千个变量实时变化,构成一个高维动态系统。其中真正决定良率、风险或效率的规律,往往藏在变量之间的细粒度关系里,而非某个孤立数值。
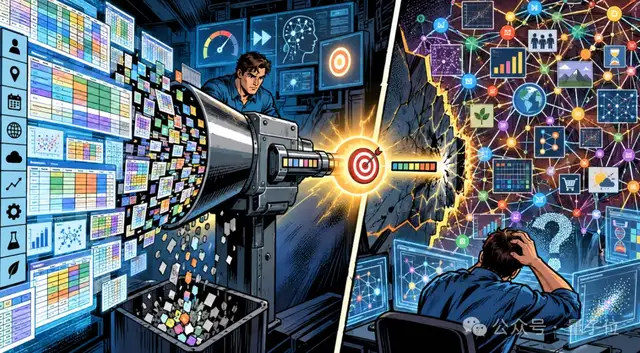
如果先把这类原始结构化数据转成文本再喂给LLM,中间必然经历一次信息压缩。而被压缩掉的那些微妙差异,在生产环境中可能恰恰是最值钱的部分。比如某个传感器读数的微小漂移,结合其他变量的特定组合,可能预示着即将发生的设备故障——这种信号在语义层面很容易被忽略。
这正是结构化数据基础模型(Large Data Model, LDM)的价值所在:它不依赖人类预先总结的规则,而是直接从原始数据空间中学习变量如何相互作用。如果说LLM擅长处理“人类已知的世界”,LDM则试图理解“世界本身如何运行”。两条路线并非替代关系,而是互补拼图。
巨头入场,赛道突然加速
随着AI深入产业决策核心,LDM的重要性迅速凸显。过去一年,全球科技巨头密集布局:
- Google 发布 TabFM,正式将表格数据模型纳入其基础模型版图;
- Amazon 推出 Mitra,探索预训练模型如何跨不同表格任务迁移;
- SAP 动作最猛,先自研 SAP-RPT-1,又以超10亿欧元收购 TabPFN 背后的 Prior Labs,近期刚把升级版 TabPFN-3.5 Plus 接入 SAP AI Core,用于现金流预测、供应商风险评估等企业级任务。
这场竞赛已从学术圈快速蔓延至商业战场。就在9月中旬,SAP 刚发布 TabPFN-3.5,几小时后,一支中国团队就用新模型 LimiX-2 在多个国际基准测试中实现全面超越。
LimiX-2:改写底层技术范式
这支团队来自稳准智能,核心成员包括清华大学计算机系崔鹏教授——他是LDM理念的早期提出者之一,长期研究结构化数据与因果智能。
与主流LDM(如TabPFN)聚焦“如何更准地预测目标Y”不同,LimiX-2 把目标直接定为“理解所有变量之间如何共同构成这份数据”。这种转变看似细微,实则重构了整个技术栈。
上下文机制网络(CMNs):从预测到关系建模
传统PFN类模型通常将整行数据压缩成一个高层表示,再用于预测目标变量。这种方式适合快速适配任务,但容易丢失变量间的细粒度交互信息。
LimiX-2 提出的 上下文机制网络(Contextual Mechanism Networks, CMNs) 则反其道而行:它不预设哪个变量是目标,而是让模型学习任意变量在给定其他变量条件下的生成机制。换句话说,模型要回答的问题不再是“Y是多少”,而是“当X₁、X₂…Xₙ取这些值时,整个数据是如何被生成的”。
这种设计使得分类、回归、缺失值填补等任务,都变成对同一个底层数据模型的不同查询方式,而非独立任务。
训练机制:逼模型学会“换位思考”
要让模型真正掌握变量关系,光有新架构不够,还得有匹配的训练方法。LimiX-2 引入 上下文条件掩码建模(CCMM):在训练时随机遮蔽不同变量,要求模型根据剩余变量预测被遮部分。
由于每次被遮的变量都不同,模型无法只围绕某个固定目标优化,而必须理解整个变量系统的联合依赖结构。就像反复让人从不同角度描述同一幅画,最终才能掌握全貌。
数据表示:下沉到单元格级别
在数据表示层面,LimiX-2 将建模粒度细化到 Cell-Level(单元格)。每个单元格不仅包含数值,还保留其所属列的身份信息、具体取值类型(连续/离散)、缺失状态等元数据。这种设计支持跨变量、跨样本的信息交互,为捕捉复杂依赖关系提供基础。
配合这套框架,团队还升级了 自动化合成数据引擎,能生成覆盖更多分布形态、交互模式和噪声类型的训练数据,确保模型见过足够复杂的“数据世界”后再处理真实任务。
实测成绩:全面领先国际对手
技术理念需要 benchmark 验证。在三大主流评测中,LimiX-2 表现如下:
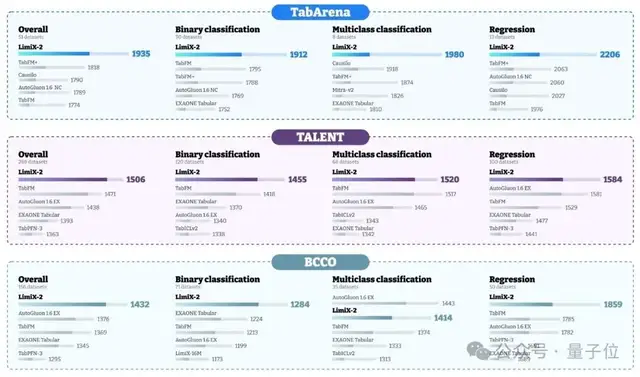
- TabArena 分类任务:Elo评分1917,领先谷歌TabFM 143分,在二分类、多分类四项指标均居第一;
- TabArena 回归任务:Elo评分2206,同样四项指标全部第一,显示其对连续变量关系的建模精度更高;
- TALENT 与 BCCO:在跨数据集泛化和小样本适应性上也保持领先。
更值得注意的是,LimiX-2 的参数规模仅4亿,远小于部分竞品,却实现了断层优势。这说明性能提升主要来自架构创新,而非单纯堆参数。
此外,模型在 Sachs、UF、Causal Chamber 等因果发现公开数据集上,已超越多种传统因果推断方法。这意味着它不仅能预测,还能初步揭示变量间的因果骨架——这对工业根因分析、干预策略制定至关重要。
为什么这可能是AGI的下一个“GPT-3时刻”?
2020年GPT-3问世,让人们看到基础模型跨过临界点后,AI可从单点工具走向通用能力。六年过去,AGI愿景逐渐清晰,但下一个瓶颈在于:如何让AI理解真实世界的运行机制,而不仅是人类描述的知识。
LDM 正指向这一方向。当模型能可靠地从高维数据中识别稳定关系、推断因果链条、预测干预效果,它就具备了参与复杂系统决策的基础能力。这在智能制造、科学发现、金融风控等领域意义重大。
目前,LimiX-2 已开源模型权重和代码(GitHub与Hugging Face均可获取),并上线ModelScope。虽然离大规模工业落地还有距离,但它证明了一条可行路径:通过重构学习目标与技术范式,中国团队完全有能力在AGI底层竞争中占据先机。
在这场关于“谁更能理解真实世界”的新竞赛中,LimiX-2 不只是刷榜,更是打开了一扇门。