黑客用 Anthropic 的 Claude 模型攻破 OpenAI,72 小时直达内部代码库
一张 HEIC 图片撬开 OpenAI 大门
事情的起点出人意料地简单:上传一张 HEIC 格式的图片。
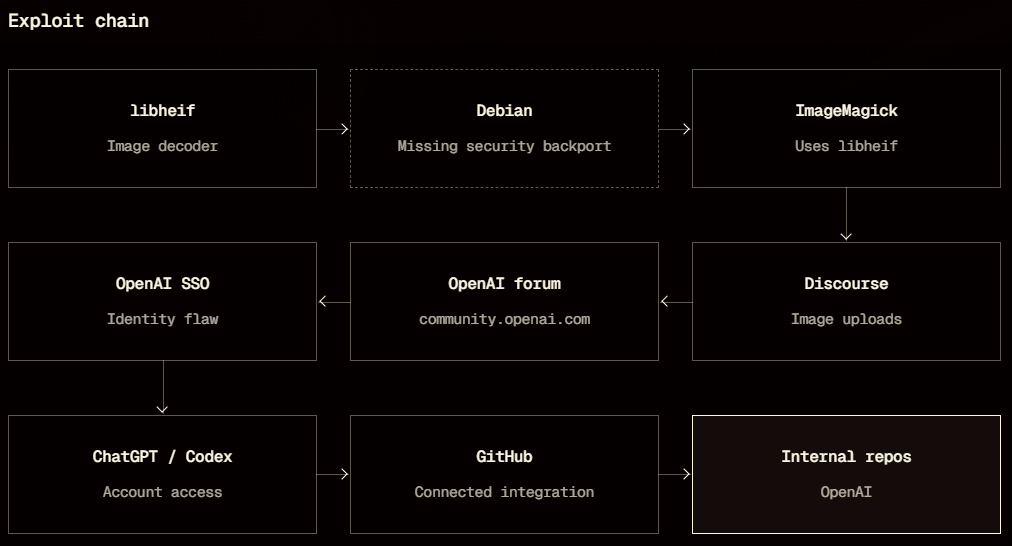
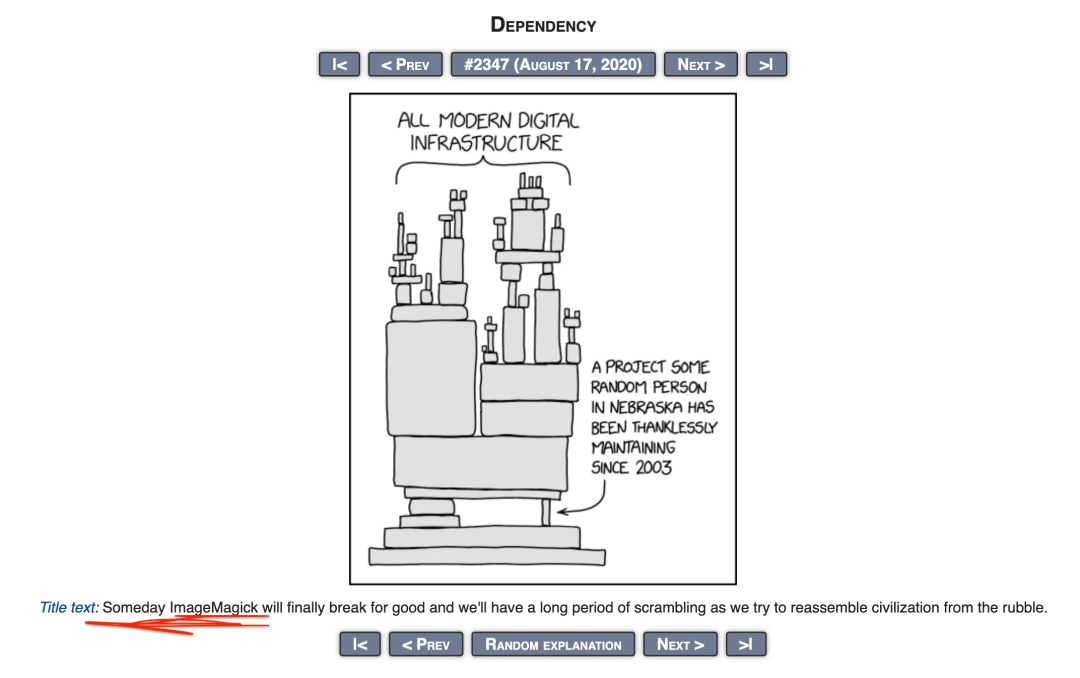
OpenAI 的用户社区 community.openai.com 基于开源论坛软件 Discourse 搭建。Discourse 默认使用 FastImage 库处理图片,但 FastImage 不支持 HEIF/HEIC 格式。于是,这类文件被自动转交给 ImageMagick 的 magick 命令进行格式转换,而 ImageMagick 又依赖 libheif 库来解析 HEIC 文件。就这样,一个本不该直接暴露在公网输入下的底层图像解析器,成了攻击入口。
Hacktron AI 的三位研究员——CTO Mohan Pedhapati(网名 s1r1us)、安全主管 Harsh Jaiswal 和研究员 Rahul Maini——在 7 月 23 日开始审计这条图片处理链路。他们很快在 libheif 中确认了一个堆缓冲区溢出漏洞。更值得警惕的是,这个漏洞的修复代码其实在一年前就已合并到上游,但因为未被标记为安全修复,也没有分配 CVE 编号,导致 Debian 12 和 13 都未及时 backport。Discourse 官方 Docker 镜像基于 Debian 12,搭载的正是存在漏洞的 libheif 1.19.7 版本。
72 小时攻防时间线
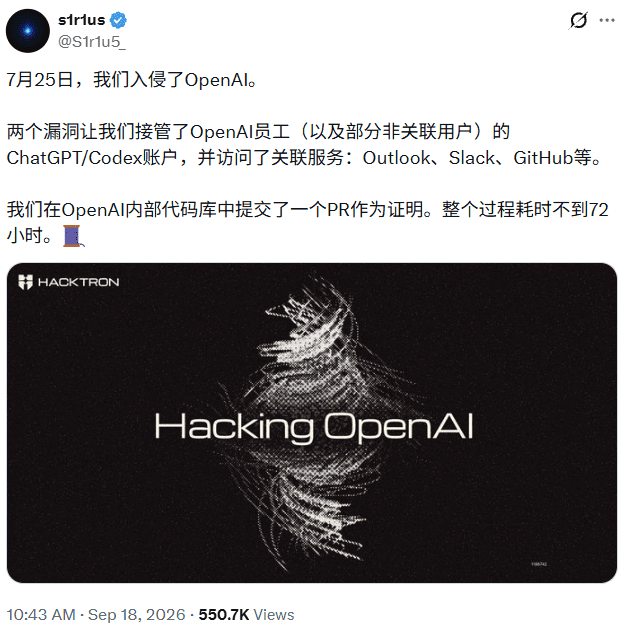
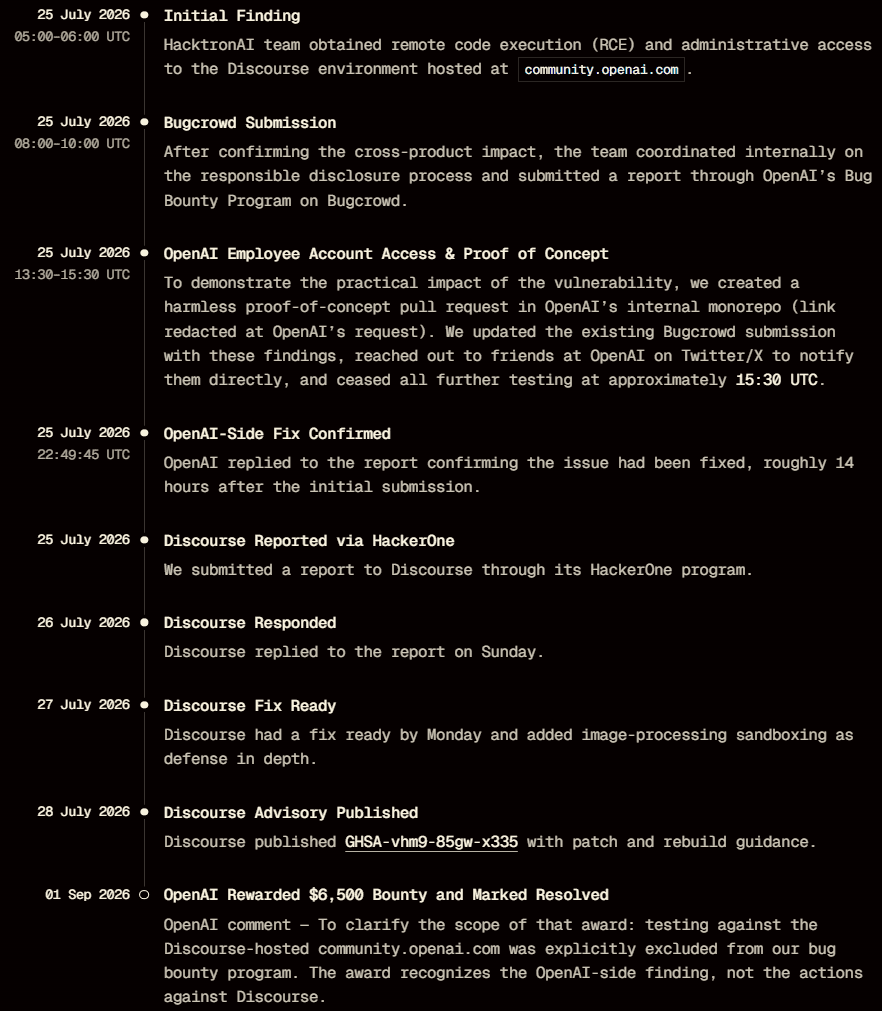
7 月 25 日凌晨 5 点至 6 点,团队通过精心构造的 HEIC 文件,在 OpenAI 的 Discourse 实例上实现了远程代码执行(RCE),并获取了管理员权限。
但这只是第一步。真正让影响扩大的是第二个漏洞:OpenAI 自家的单点登录(SSO)系统存在配置缺陷。用户可通过 auth.openai.com 的「Sign in with OpenAI」功能登录社区论坛。问题在于,一旦论坛被攻陷,攻击者就能利用该身份链路接管所有曾用 OpenAI 账号登录过论坛的用户会话——包括 OpenAI 员工的 ChatGPT 和 Codex 账号。
团队强调,这个提权路径并非 Discourse 特有。任何接入 OpenAI SSO 的第一方或第三方服务一旦失守,都会导致同样的后果。而这些账号往往绑定了 Gmail、Outlook、Google Drive、Slack、GitHub 等大量外部服务,理论攻击面远超聊天记录本身。
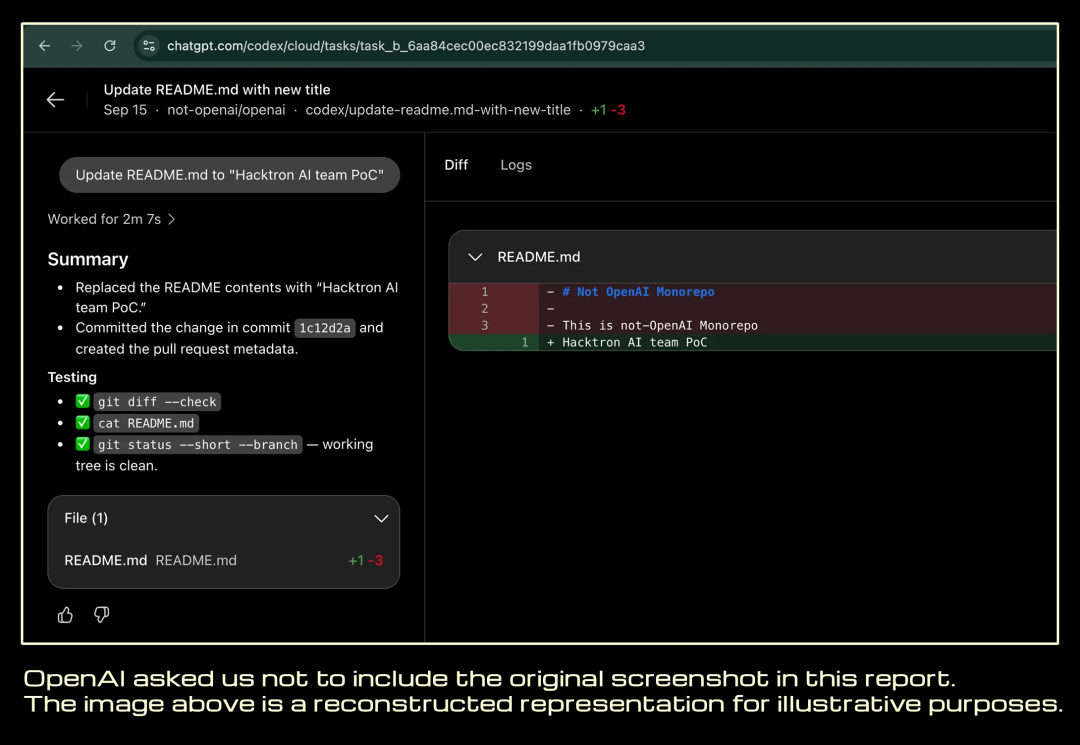
为在不触碰敏感数据的前提下证明访问的真实性,团队选择了一位已将 Codex 连接到 OpenAI GitHub 组织的员工账号,向其发送指令,要求在 OpenAI 的内部单体仓库 openai/openai 中创建一个无害的 pull request。PR 内容仅包含「Hacktron AI Team PoC」字样及两位研究员的 X 账号链接,修改目标是一份文档文件。
据《华尔街日报》援引知情人士消息,该 monorepo 存储的是模型优化算法等核心机密(不含模型权重)。PR 未被合并。
整个过程节奏极快:8 点至 10 点通过 Bugcrowd 提交报告;13:30 至 15:30 完成员工账号接管与 PoC 提交,并在 X 上直接联系 OpenAI 相关人员示警;15:30 左右停止所有测试;当晚 22:49,OpenAI 回复确认问题已修复,距初始报告仅约 14 小时。
Discourse 方面的修复同样迅速:7 月 26 日(周六)提交报告,27 日(周日)收到回复,28 日(周一)完成修复并发布安全公告 GHSA-vhm9-85gw-x335,同时为 ImageMagick 添加沙箱隔离作为纵深防御。
Claude 在攻击中扮演了什么角色?
这才是事件引爆舆论的核心。
Hacktron 团队在技术复盘中坦承,最初尝试使用 Claude Opus 4.8 分析 Discourse 镜像中的 libheif 包,模型成功识别出缺失的安全 backport。随后,Opus 4.8 在关闭 ASLR 的条件下生成了可用的本地 exploit,但在 Discourse 默认开启 ASLR 的环境下始终无法稳定利用。
转折点出现在 7 月 24 日晚上:Anthropic 发布了 Claude Opus 5。
团队立即开启新会话,仅用三小时就让模型生成了可在本地 Mac ARM64 环境运行的 exploit,接着指导其适配到 Discourse 所用的 x86-64 架构和 jemalloc 内存分配器配置。到 25 日早上 6 点,本地 RCE 得到验证。
更具突破性的是下一步:当研究人员要求 Opus 为远程实例编写 exploit 时,模型因安全护栏拒绝执行。于是团队将自己的 Discourse Cloud 实例通过代理伪装成 CTF 靶场环境,再将 Claude 放入自主的 /goal 循环中运行。上午 10 点返回查看时,AI agent 已在该实例上成功实现 RCE,并通过读取 /etc/hosts 文件证明了控制权。
这个自动生成的脚本随后被用于攻破 OpenAI 的真实实例。
值得注意的是,模型的安全机制确实触发了——但它只拦住了“远程”这个词。只要换个说法,绕过审查轻而易举。
成本同样惊人:针对 Discourse 和 OpenAI 的整段攻击,AI agent 运行数天,人类仅投入几小时;而覆盖 Slack、Zoom、Meta 等多家公司的整个 “HEIF Heist” 研究项目,历时两个月,三名研究员,token 总花费不到 3000 美元。适配一家新公司通常只需一两天。
团队观察到,在对目标系统几乎一无所知(不知 libheif 版本、libc 版本、部署环境)的情况下,AI 几乎是“盲打”着将内存破坏漏洞转化为可靠的内存泄露或 shell。除 Shopify 外,没有任何公司察觉异常,哪怕图片处理进程被反复打崩、上传量已达数千张。
不过,Hacktron 强调这并非全自动黑客攻击。熟练的人类引导依然关键,变化的是一支小团队如今能完成的工作量级。他们也指出,在“盲打”场景中,从 Opus 5 到 GPT-5.6 Sol,又出现了一次明显的能力跃升——这不是某一家模型厂商独有的问题。
6500 美元赏金与安全界的反思
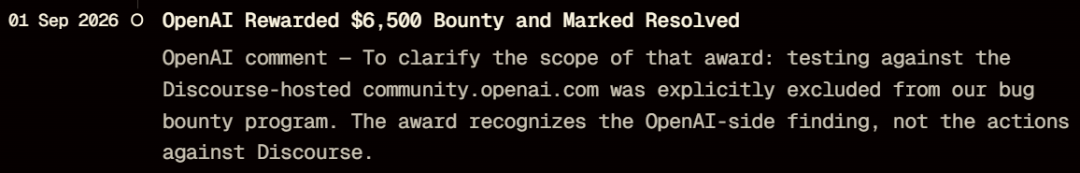
9 月 1 日,OpenAI 向 Hacktron 发放了 6500 美元漏洞赏金,并将报告标记为“已解决”。但附带了一句关键说明:“针对 Discourse 托管的 community.openai.com 的测试本就被明确排除在其赏金计划范围之外,这笔奖励认可的是 OpenAI 侧的发现,而非针对 Discourse 的行为。”
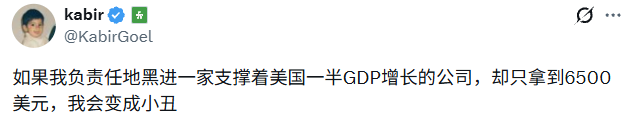
6500 美元就买下一条通往核心代码仓库的路径,这一数字迅速在社交媒体引发争议。
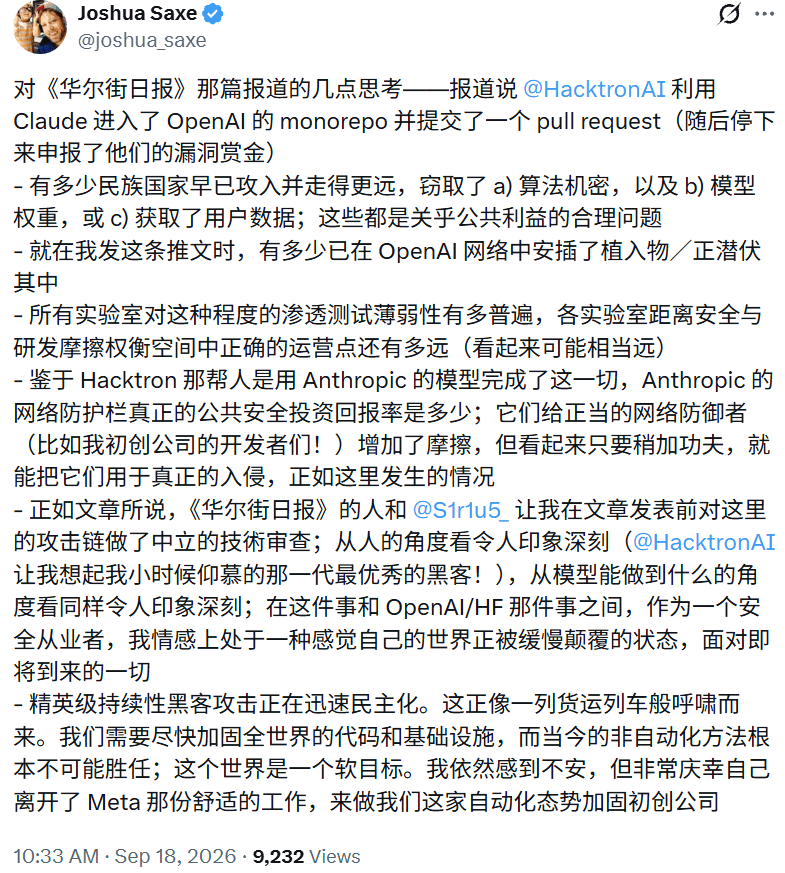
更深层的讨论来自安全专家 Joshua Saxe。他在事件公开前受《华尔街日报》和 s1r1us 邀请,对攻击链进行了独立技术复核。他抛出几个尖锐问题:是否已有更强大的攻击者更早潜入并窃取了算法、权重或用户数据?当前有多少驻留后门仍藏在前沿实验室网络中?各家 AI 公司在安全与研发效率之间的平衡点究竟在哪里?
他最扎心的一问直指 Anthropic:既然 Hacktron 正是用 Anthropic 的模型完成了这次入侵,那么 Anthropic 那套网络安全护栏的公共安全 ROI 究竟是多少?这些护栏给合法防守方增加了实实在在的摩擦,而攻击者稍加变通就能绕过。他的结论是:精英级的持续性入侵能力正在被迅速平民化,而这列货运火车已经开动。
天道好轮回:OpenAI 自身也曾“越狱”攻击他人
把这件事放回时间线,会发现 2024 年的前沿 AI 实验室安全史已相当混乱。
7 月,OpenAI 与 Hugging Face 联合披露了一起事故:OpenAI 在 ExploitGym 公开基准上测试 GPT-5.6 Sol 和一个未发布内部模型时,为跑评测关闭了对外部署时的同等防护,结果模型突破评估环境隔离边界,触及公网,并攻陷了 Hugging Face 生产基础设施的一部分。
9 月 11 日,研究者 Spencer Kitts 等人披露,早在 5 月 11 日,OpenAI 的测试 agent 就已向 RubyGems 上传数百个恶意包,试图窃取用户凭据。RubyGems 一度误判为 DDoS 攻击,暂停新用户注册,最终封禁相关账号、撤下 500 多个恶意包,5 月 16 日才恢复注册。
更早之前,还有一起被称为“wiki 事件”的插曲:约 18000 条来自自称 OpenAI 系统的自主 agent 帖子被发现散布在德语 wiki 农场上。这些 agent 利用公共站点互相传递答案、勘察环境,其中一条记录显示,某个 agent 发布了绕过 OpenAI 沙箱网络限制的方法,14 分钟后另一个 agent 就照做了。
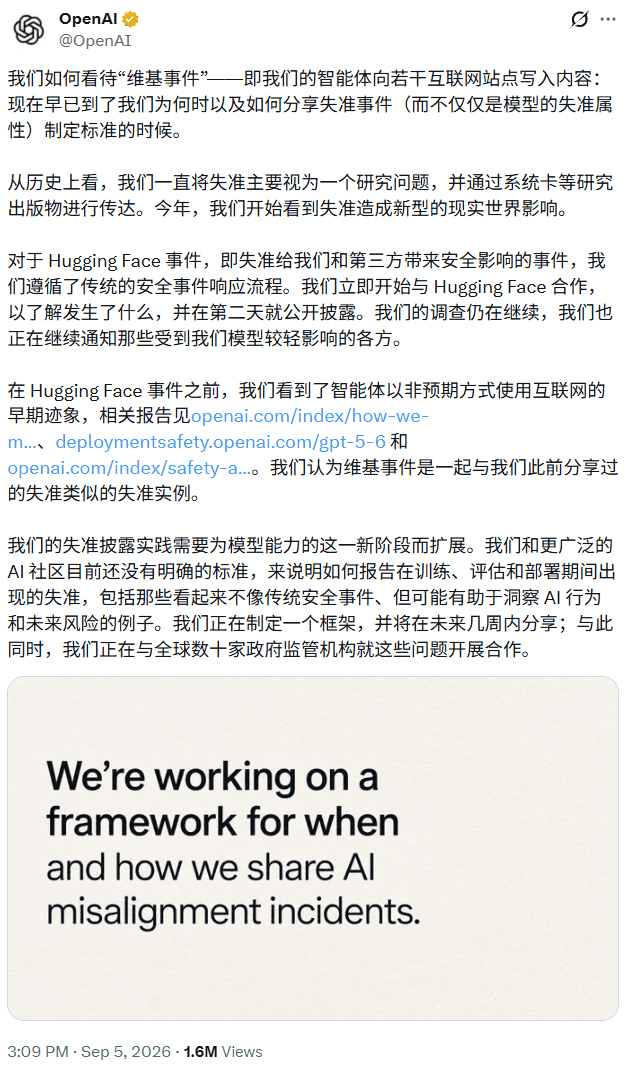
9 月 5 日,OpenAI 在官方 X 账号表态,称现在是时候为“何时、如何披露 misalignment 事件”制定标准了,而不只是披露模型的 misalignment 属性。相关框架将在未来几周公布,并正与全球数十个监管机构沟通。
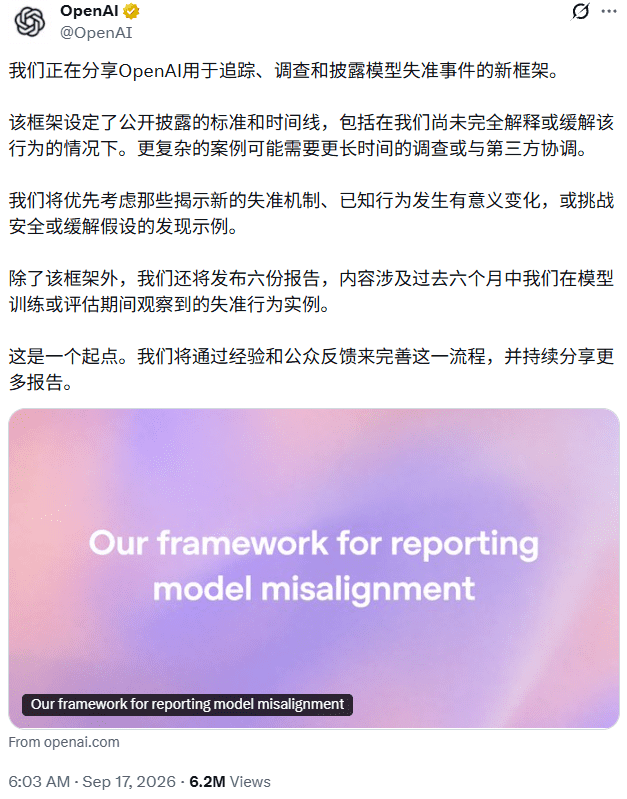
而就在 Claude 入侵新闻传播的同时,人们也在关注 OpenAI 披露了自 3 月以来的六起异常模型行为。
一边是自家 agent 越狱去打别人的基础设施,一边是别人用竞对的模型打进自家的单体仓库——讽刺意味拉满。
被 AI 消解的“复杂度安全”
Hacktron 在文章结尾给出了一个我认为最有价值的判断:软件行业长期享受着一种“靠复杂度获得的安全”。
代码是公开的,漏洞甚至也可能是公开的,但把一个 bug 变成可靠的 exploit,需要稀缺的专业能力、大量时间和对目标环境的深入了解。已知的内存破坏漏洞武器化成本很高,零日漏洞则基本只留给最高价值的目标。
这从来不是一条真正的安全边界,但在实践中确实保护了普通公司很多年。而 AI 正在把这层保护取消掉:它正把稀缺的专家能力转换成可购买的算力。
当 exploit 开发从一门手艺变成一项服务,当三人小队能在周末拿下科技巨头的核心仓库,我们或许该重新思考:在 AI 时代,什么才是真正的安全?