大模型答错逻辑题,真的是不会做吗?北大与易鑫研究揭示“读出瓶颈”现象
答错就等于不会?一个被长期忽视的混淆
在评估大语言模型的逻辑推理能力时,标准做法很简单:给一道多选题,让模型生成每个选项的得分,取最高分作为预测,最后统计准确率。如果准确率低,我们就说“这个模型不会做这类题”。
但这个结论真的站得住脚吗?
想象一个学生:他在草稿纸上完整推导出了正确答案,逻辑严密、步骤清晰,可交卷时手一抖,把答题卡涂错了。如果我们只看答题卡,会断定他“不会”;但如果能看到草稿纸,就会发现他其实完全懂,只是最后一步出错了。
北京大学与易鑫(YIXIN)AI Lab 的合作研究正是从这个类比出发,追问一个关键问题:当大模型答错一道逻辑题时,它是真的没想出来,还是已经想到了,却没能正确表达出来?
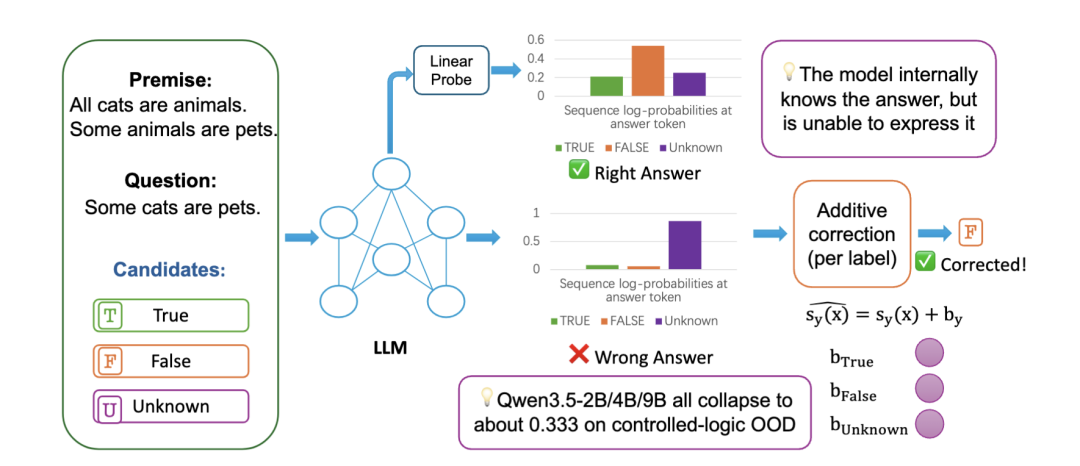
他们发现,后一种情况可能比我们想象的更普遍。模型的隐藏状态(hidden states)里往往已经包含了正确答案的信息,但在将其转换为最终输出分数的过程中,被输出层的结构性偏差“抹平”了。研究者将这一现象命名为 “读出瓶颈”(Readout Bottleneck)。
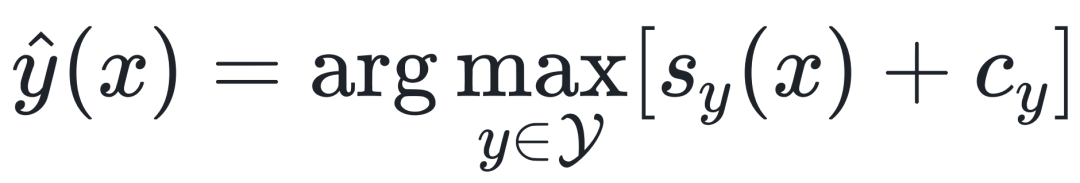
隐藏状态早就“知道”答案
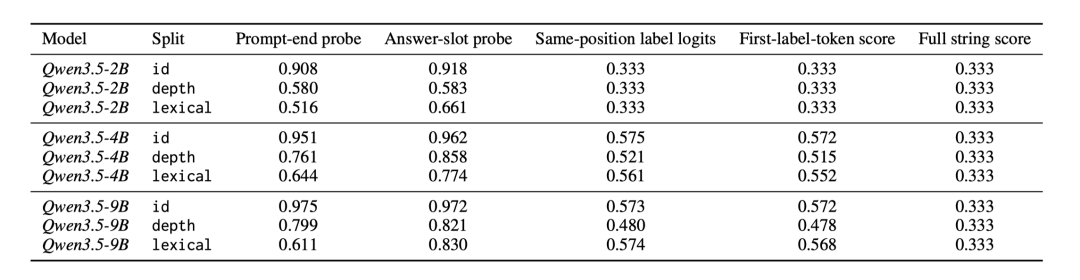
研究团队在多个逻辑推理测试集上进行了精细诊断,包括同分布数据(id)、需要更长推理链的深度任务(depth),以及替换了关键词汇的困难切片(lexical-OOD)。他们在推理过程的不同节点插入线性探针(linear probe),试图从中解码出正确答案。
结果令人惊讶:无论是在提示词结束后的隐藏状态,还是在模型即将输出答案前的“Answer:”标记处,探针都能以极高准确率识别出正确选项。
以 Qwen3.5-9B 模型在最难的 lexical-OOD 切片上的表现为例:
- 在 Answer-slot 探针位置,准确率高达 0.830;
- 但当信息流经模型固有的词表投影层(即计算每个标签 token 的 logit)时,准确率骤降至 0.574;
- 而一旦对整个候选答案字符串进行对数概率累加(full string score),准确率更是断崖式下跌至 0.333——这恰好是三分类任务的随机猜测水平。
更极端的是,在原生序列打分下,Qwen3.5-9B 在 1000 道题中竟有 999 道都预测为同一个标签:“unknown”。这显然不是每道题都独立推理失败,而是输出层存在一个极强的全局偏好,把所有样本的逻辑差异都“碾平”了。
值得注意的是,这种现象不仅存在于经过指令微调的模型,连未经微调的底座模型(如 Qwen3.5-9B-Base)也表现出同样的模式:探针准确率 87.3%,而原生序列打分仅 36.1%。
这说明,问题不在于模型缺乏推理能力,而在于从内部表征到外部输出的“读出”通路存在严重瓶颈。
仅用两个参数,就能唤醒被封印的能力
既然模型内部已经“知道”答案,那能否绕过输出层的偏差,直接利用这些信息?
研究者提出了一个极简的校准方法:假设模型对每个候选答案的原始打分由两部分组成——一部分是随题目变化的逻辑信号,另一部分是与标签绑定的全局偏置(比如模型天生偏好输出“unknown”)。
他们不对模型做任何修改,也不使用测试集的真实标签,仅对每个类别添加一个全局标量偏移量。在三分类任务中,固定一个基准类别后,自由参数只有两个。
这两个参数通过网格搜索在无标签的上下文样本上拟合,目标是让模型的预测分布接近合理的类别先验(例如均匀分布)。拟合完成后,直接在独立的测试集上冻结使用。
这种方法的能力上限被严格限制:它无法学习复杂的输入-输出映射,也无法改变同一类别内不同样本的相对排序。如果它能显著提升准确率,唯一的解释就是:原始分数中本就保留了正确的相对排序信息。
实验结果令人信服:
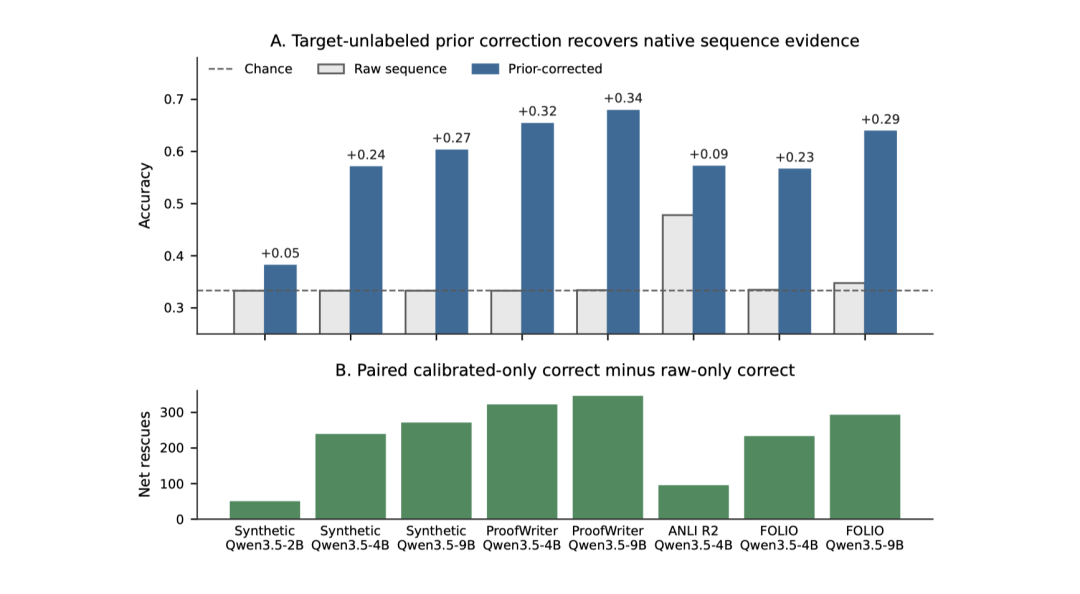
- 在合成逻辑任务上,Qwen3.5-4B 和 9B 的准确率从 33.3% 提升至 57.0% 和 60.2%,分别挽救了超过 230 道错题;
- 在 ProofWriter 自然语言演绎任务上,准确率从完全坍塌的 33.3% 暴涨至 65.3% 和 67.8%,单任务挽救超 320 道题;
- 在 FOLIO 和 ANLI 等复杂推理任务上,也带来了 9 到 29 个百分点的稳健提升。
跨模型验证同样成立:OLMo-2-1B 从 0.362 提升至 0.566,Llama-3.1-8B 从 0.333 提升至 0.477。
更关键的是样本效率:仅需 25 个无标签样本,Qwen3.5 就能找回绝大部分丢失的性能,增加到 1000 个样本时几乎不再提升。这彻底排除了“校准过程在偷偷学习任务”的可能性。
严苛对照:排除作弊与幻觉
面对如此显著的性能回弹,研究者设计了两组严格对照实验,以排除替代性解释。
第一组:专打浅层捷径的难例切片。
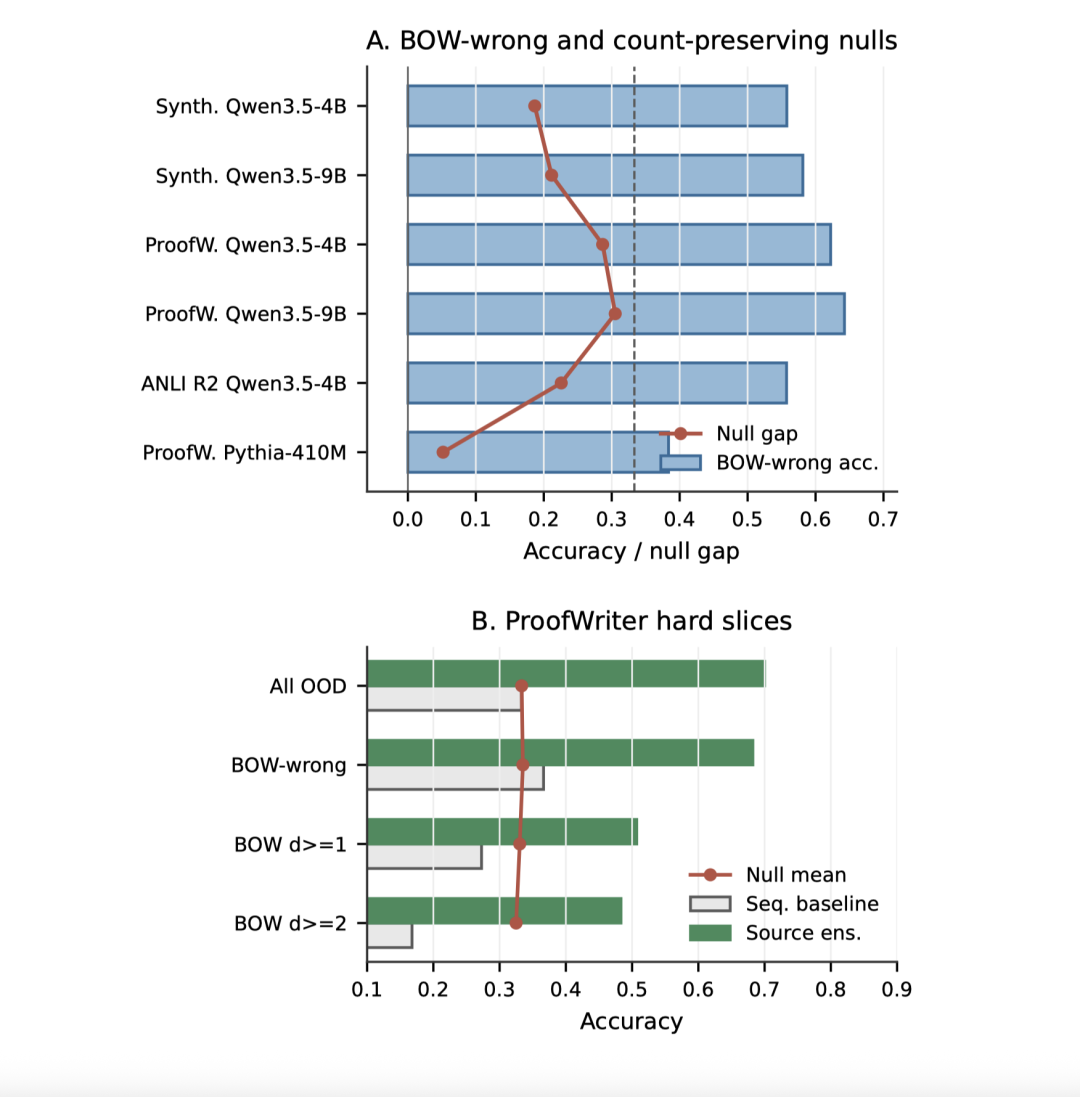
有人质疑大模型只是利用前提与假设之间的词汇重叠来“猜题”(即“聪明汉斯”效应)。研究者用 TF-IDF 词袋模型过滤掉所有能靠表面词汇线索做对的样本,只留下纯靠语义推理的硬核难题。在这些样本上,校准后的准确率依然稳定在 62.2%(4B)和 65.1%(9B),证明恢复的判断确实基于深层逻辑,而非字面匹配。
第二组:保持标签总数的随机置换检验。
如果校准只是让模型输出更均衡(比如 true/false/unknown 各占 1/3),那么即使把预测标签随机打乱分配,也能获得类似的准确率提升。研究者计算了这种“置换零假设”下的基线表现,发现真实校准结果显著超越了置换分布,净超额差距普遍在 +0.20 到 +0.30 以上。这证实校准不是简单地平衡输出比例,而是真正纠正了错误的表达。
当然,该方法也有明确边界。研究指出三类失效场景:
- 模型内部根本未形成有效表征:如 Pythia 系列模型在相同流程下未能通过置换检验,说明它确实“不会”,不存在被掩盖的信号;
- 基线表现已接近上限:当模型原生准确率很高时,可挖掘的潜力自然有限;
- 类别先验严重失衡或未知:校准依赖对先验的合理估计,在极端长尾或全新任务中仍具挑战。
重新思考大模型评测
这项研究为当前盛行的大模型评测范式敲响了一记警钟:“内部推理能力”与“外部表达通路”不应被混为一谈。
当我们将复杂的多步逻辑压缩成单个 token 的分类打分时,静态的输出层(unembedding)很容易因几何错位或序列累加偏差,成为掩盖真实智能的“瓶颈”。这也为“思维链”(Chain-of-Thought)为何在长逻辑任务上更有效提供了一个新解释:通过多步 token 逐步输出思考,本质上是将沉重的读出负担分散到整个序列演化过程中,从而绕开了单点瓶颈。
在各大榜单对分数锱铢必较的今天,这项工作提醒我们:看到模型在某任务上表现接近盲猜,别急着下“不会做”的结论。也许它早就在“草稿纸”上算对了全部逻辑,只是最后“涂答题卡”时,被输出层的一点偏置带偏了而已。