GLM-5.3驱动Infra Agent在十万卡集群上优化推理系统,吞吐提升3.2倍
GLM开始参与构建GLM
清华大学计算机系教授、智谱AI创始人唐杰近日分享了一个内部观察到的递归自我改进(Recursive Self-Improvement, RSI)早期案例:由GLM-5.3驱动的Infra Agent,在超过10万张国产芯片组成的集群上,从零参与搭建并优化了一套生产级推理系统。
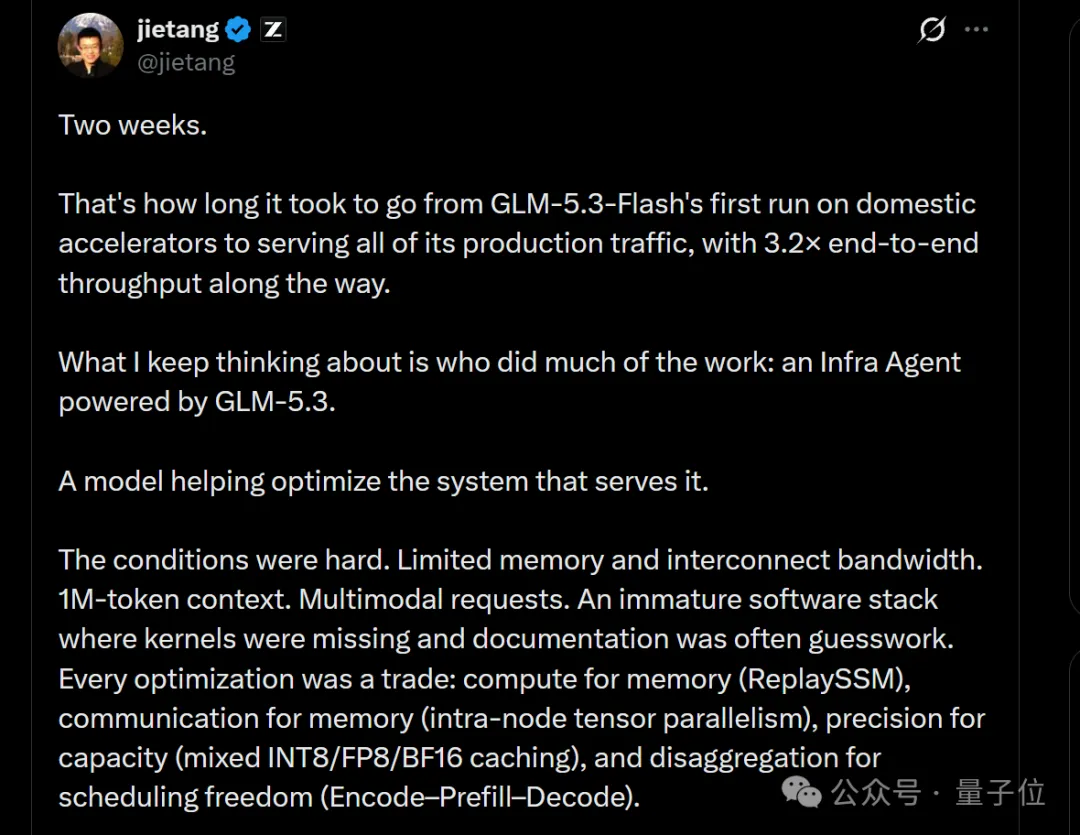
不到两周时间,这套系统的端到端吞吐量就提升到了初始基线的3.2倍。
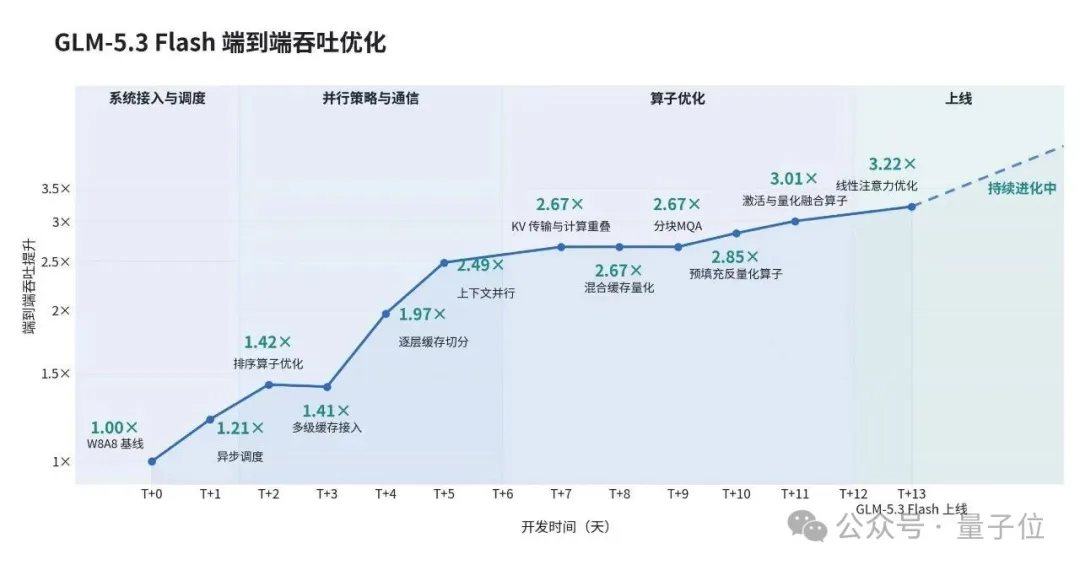
这并不是简单的“AI写代码”。Agent能够读取系统反馈、提出假设、修改代码、运行实验,并根据结果持续迭代。它处理的问题横跨多个技术层次——从算子精度异常,到Python与C++之间的并发瓶颈,再到Kernel级别的性能调优。
一个具体例子是:Agent定位出在KV Transfer场景中,Python全局解释器锁(GIL)导致Prefill与传输阶段无法有效重叠,使得整体性能比单独Prefill慢了20%以上。通过在C++调用中显式释放GIL,这一损失被压缩到1%以内。
另一个案例是在KDA Decode算子上,Agent发现原实现沿V维度分块导致归一化计算重复执行四次。它将这些计算合并到同一线程块中批量处理,以牺牲部分并行度为代价,换来了1.71倍的性能提升。
由此形成了一个有点“套娃”的闭环:GLM优化运行GLM的系统,而被优化后的系统又继续承载新的GLM。唐杰将其概括为:“模型优化系统,系统承载模型。”
需要强调的是,智谱明确表示,他们尚未实现真正的RSI。目标设定、边界划定和风险判断仍由人类工程师主导。但这次实践的意义在于,RSI第一次有了跑进生产环境的工程雏形,不再只是理论设想。
从“被迫用自家模型”到“每天离不开”
唐杰提到,在GLM-4.7之前,团队内部使用自家模型写代码多少带点“亲儿子情结”——明知能力有限,还是硬着头皮用。那时,大模型在编程上的产品市场契合度(PMF)还没真正到来。
但到了GLM-5.3,情况变了。它已成为工程师日常不可或缺的编码伙伴,甚至开始“一步步走向取代我们”。
这种转变背后,是模型能力的真实跃迁。2025年10月,智谱启动安全能力增强研究,初衷很简单:能读懂复杂代码的模型,理应也能识别漏洞。没想到不到一年,安全团队用GLM在真实代码库中发现了数千个漏洞,直接改变了网络安全的工作方式。
这也迫使他们设计了受信访问机制,确保这类能力不被滥用。
而最近一次“震动”,来自更根本的变化:GLM开始参与构建AI基础设施本身。过去需要一支资深Infra团队数周完成的工作,现在由Agent在几天内搞定,且直接影响下一代模型的训练与部署方式。
唐杰坦言:“我们的继任者,正是我们亲手创造出来的AI。”
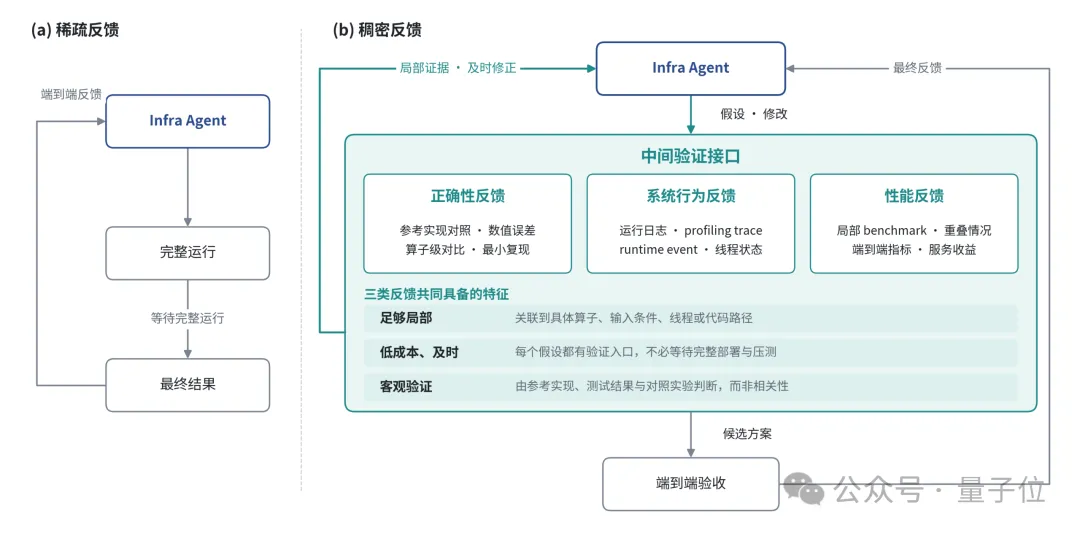
稠密反馈:让Agent真正“看得见”系统
Infra Agent之所以能高效工作,关键在于一套名为“稠密反馈”的机制。传统优化中,工程师靠经验串联日志、Trace、微基准测试等工具。但对Agent来说,如果每次修改后只能看到“吞吐下降20%”这样的端到端结果,它很难判断问题出在哪一层。
稠密反馈的核心,是把稀疏的全局指标转化为局部、及时、可验证的工程信号。
具体来说,它有三个特征:
- 足够局部:反馈要关联到具体代码路径、算子、输入形状或执行区间。比如不是“精度下降”,而是“某请求在CP并行下输出偏差0.03”;
- 低成本获取:能用算子测试或微基准回答的问题,不必等完整服务部署;
- 支持客观验证:通过对照实验确认修改是否产生预期效果,而非仅凭相关性推测。
围绕这一思路,智谱构建了一个由工程师、Agent和实验环境组成的优化闭环:工程师定义目标与边界,Agent负责分析与修改,实验环境提供分层反馈。
案例一:正确性反馈——修复KDA算子的精度问题
推理优化的前提是数值正确。Agent首先需要知道“模型是否算对”。
在验证过程中,团队建立了“并行策略→算子实现”的映射关系,让Agent能针对不同切分方式生成对应的精度测试。正是通过这种方式,他们发现了KDA算子在上下文并行(Context Parallel, CP)路径下的精度偏差。
问题根源在于:CP合并状态时使用的tl.dot默认以TF32精度计算,即使输入是FP32。长上下文下,误差不断累积,导致输出偏离。
修复方案是将关键计算显式指定为input_precision="tf32x3",通过三次TF32 Tensor Core运算组合出更高精度结果,既减轻误差,又保留硬件加速优势。
这一修复已合并至Flash Linear Attention上游(PR #1180),体现了从局部验证到全局验收的完整流程。
案例二:系统行为反馈——解决KV Transfer并发瓶颈
性能优化常卡在跨语言边界。Agent在测试中发现,Prefill + KV Transfer组合的性能比单独Prefill慢了20%以上,远超5%的验收阈值。
通过分析执行Trace,Agent注意到:KV Transfer的Python线程始终无法与DeepEP的dispatch调用重叠。进一步排查发现,DeepEP v1.2.1的intranode_dispatch未释放Python GIL,而该函数在CPU上等待GPU返回token数量时会长时间持锁。
由于GIL未释放,负责Mooncake Transfer的Python线程被阻塞,导致传输任务提交延迟,预期的异步并行无法发生。
有趣的是,同版本的internode_dispatch已显式释放GIL,注释明确说明这是为了避免阻塞其他线程的KV Transfer——这为Agent提供了直接对照证据。
修复方法很简单:在相关C++调用区间释放GIL。结果,Prefill + KV Transfer的性能差距缩小到1%以内。
案例三:性能反馈——从存量经验中提炼优化骨架
算子优化不仅要知道“怎么改”,还要知道“往哪改”。Agent从SGLang、Flash Linear Attention等项目的手写Kernel中学习优化技巧,提炼出包含适用条件、变换方式和资源约束的“优化骨架”。
以KDA Decode算子为例:引入ReplaySSM后,算子耗时首次增加(v1 vs v0)。Agent先通过除法优化缩短9.6%时间;随后在获得“计算是瓶颈”的反馈后,发现原实现沿V维度分块导致归一化计算重复四次。
于是它将这些计算合并到同一线程块,提前批量计算并共享中间结果,最终获得1.71倍加速。
每一次验证通过的修改,其适用条件都会回流到骨架库,形成持续积累的优化知识。
工程师的角色:守好那条线
尽管Agent能力惊人,但智谱强调:目标设定、边界划定和风险判断仍由人类负责。工程师的核心职责包括:
- 定义优化目标与系统约束;
- 构建Agent可直接使用的反馈环境;
- 审核涉及系统架构、异步并发和线上风险的关键修改。
两周、三倍吞吐、十万卡集群——这些数字表明,技术演进不会因人类希望“慢一点”而放缓。但至少在可预见的未来,那条决定“做什么”和“不该做什么”的线,仍应由人来守护。
这次实践的价值,不在于宣称实现了RSI,而在于证明:真正缩短系统工程周期的,不只是更强的模型,更是一个能让模型持续获得反馈、验证假设并修正行动的工程闭环。