小米直播强化学习训练过程,每小时烧3万美元
小米把强化学习训练搬上直播
9月中旬,一个奇怪的页面出现在小米官网:实时滚动着模型训练的各项指标——花了多少钱、跑了多少步、奖励分数涨没涨、哪块显卡又挂了。这不是运维监控后台,而是面向公众开放的强化学习训练直播。
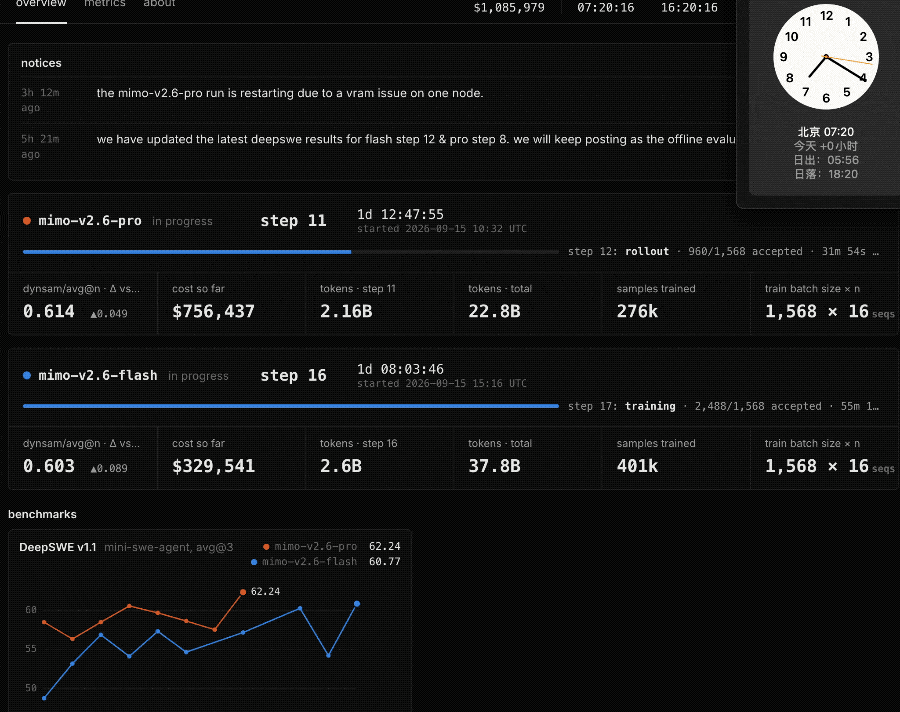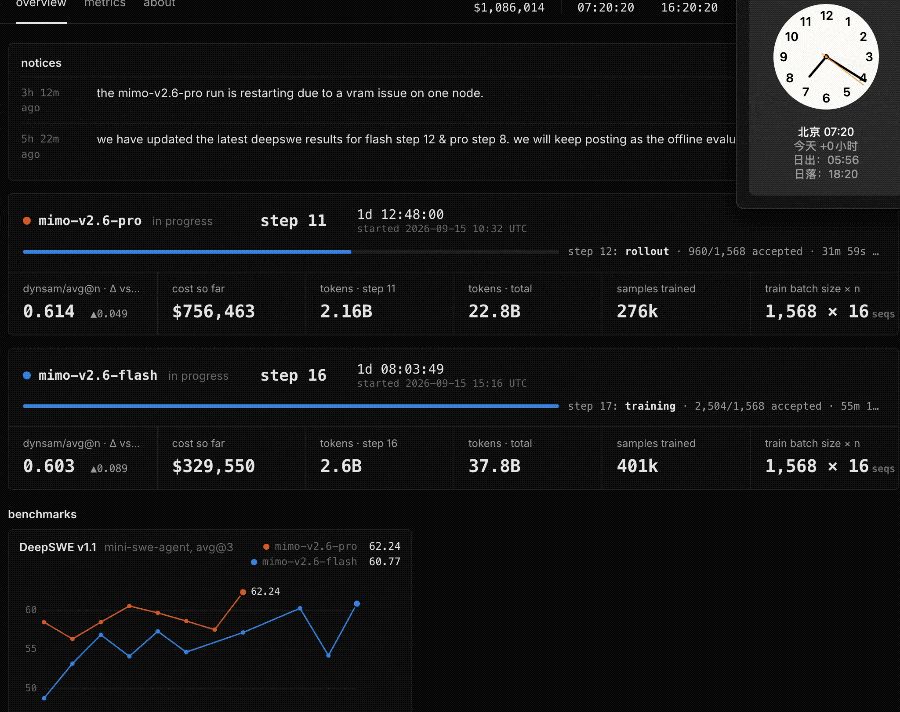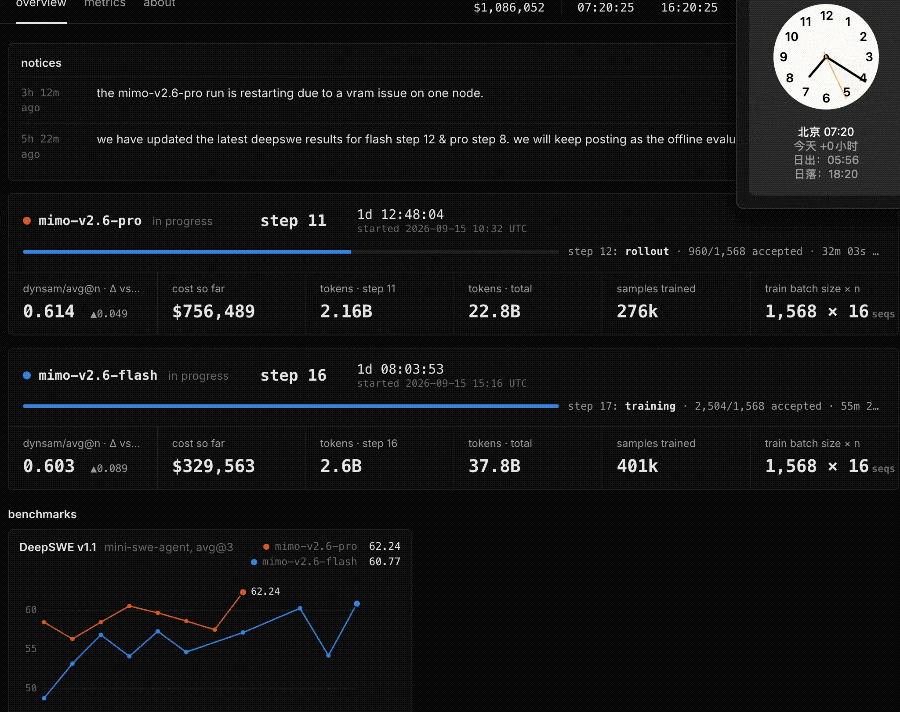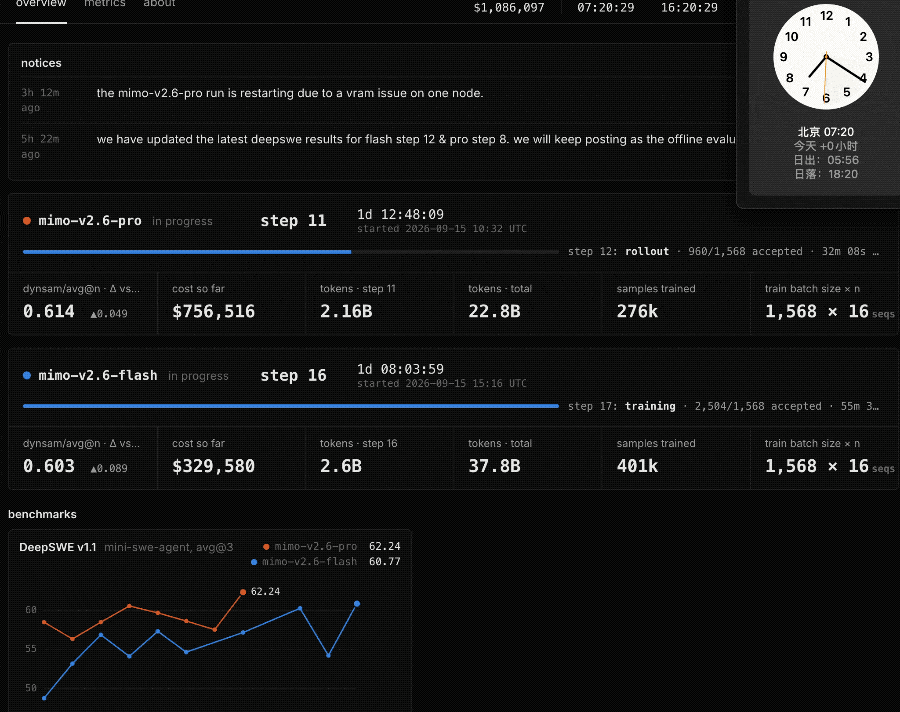
点进去的人第一反应往往是:“这哪是训练,这是烧钱。”页面显示,从Pro模型开始训练算起的36小时内,两款模型已消耗超108万美元,平均每小时3万美元。按当前汇率,一分钟就烧掉4000多元人民币。
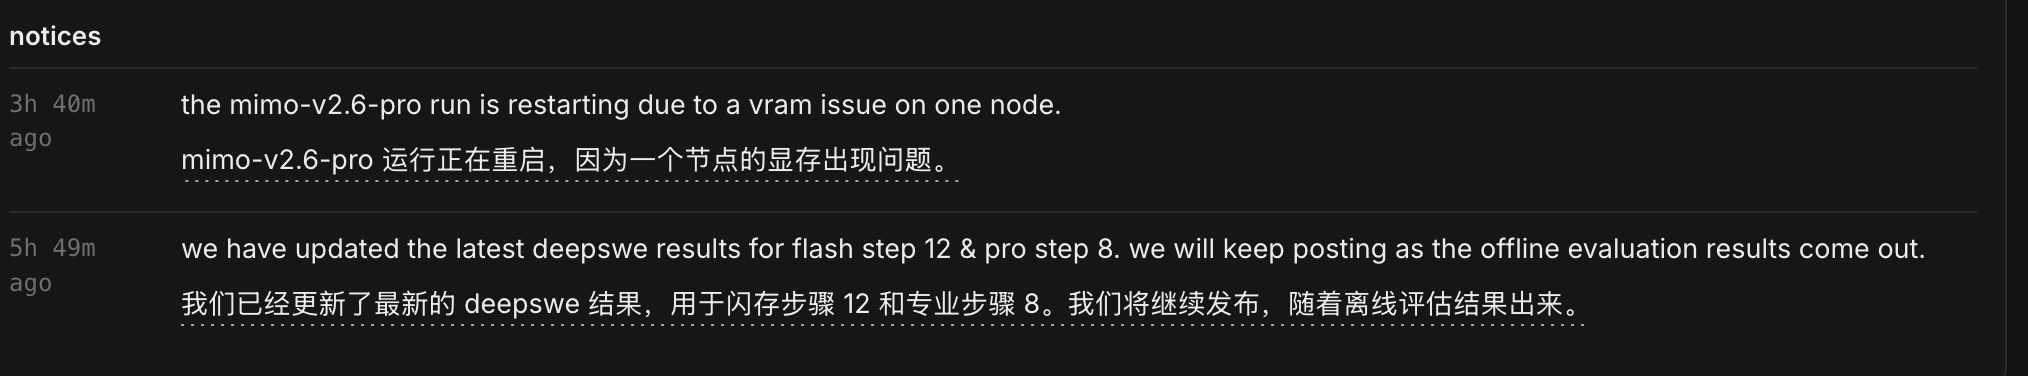
更特别的是,所有数据完全透明:训练成本、轨迹数量、任务构成、硬件状态,甚至失败日志都可查。过去开源项目会发布权重、代码或数据集,但直接直播整个训练过程,小米是头一家。
模型表现:起步快,差距小
目前训练刚开始一天多,MiMo-V2.6的Flash和Pro两个版本都处于早期阶段,但已能看出强化学习带来的能力提升。
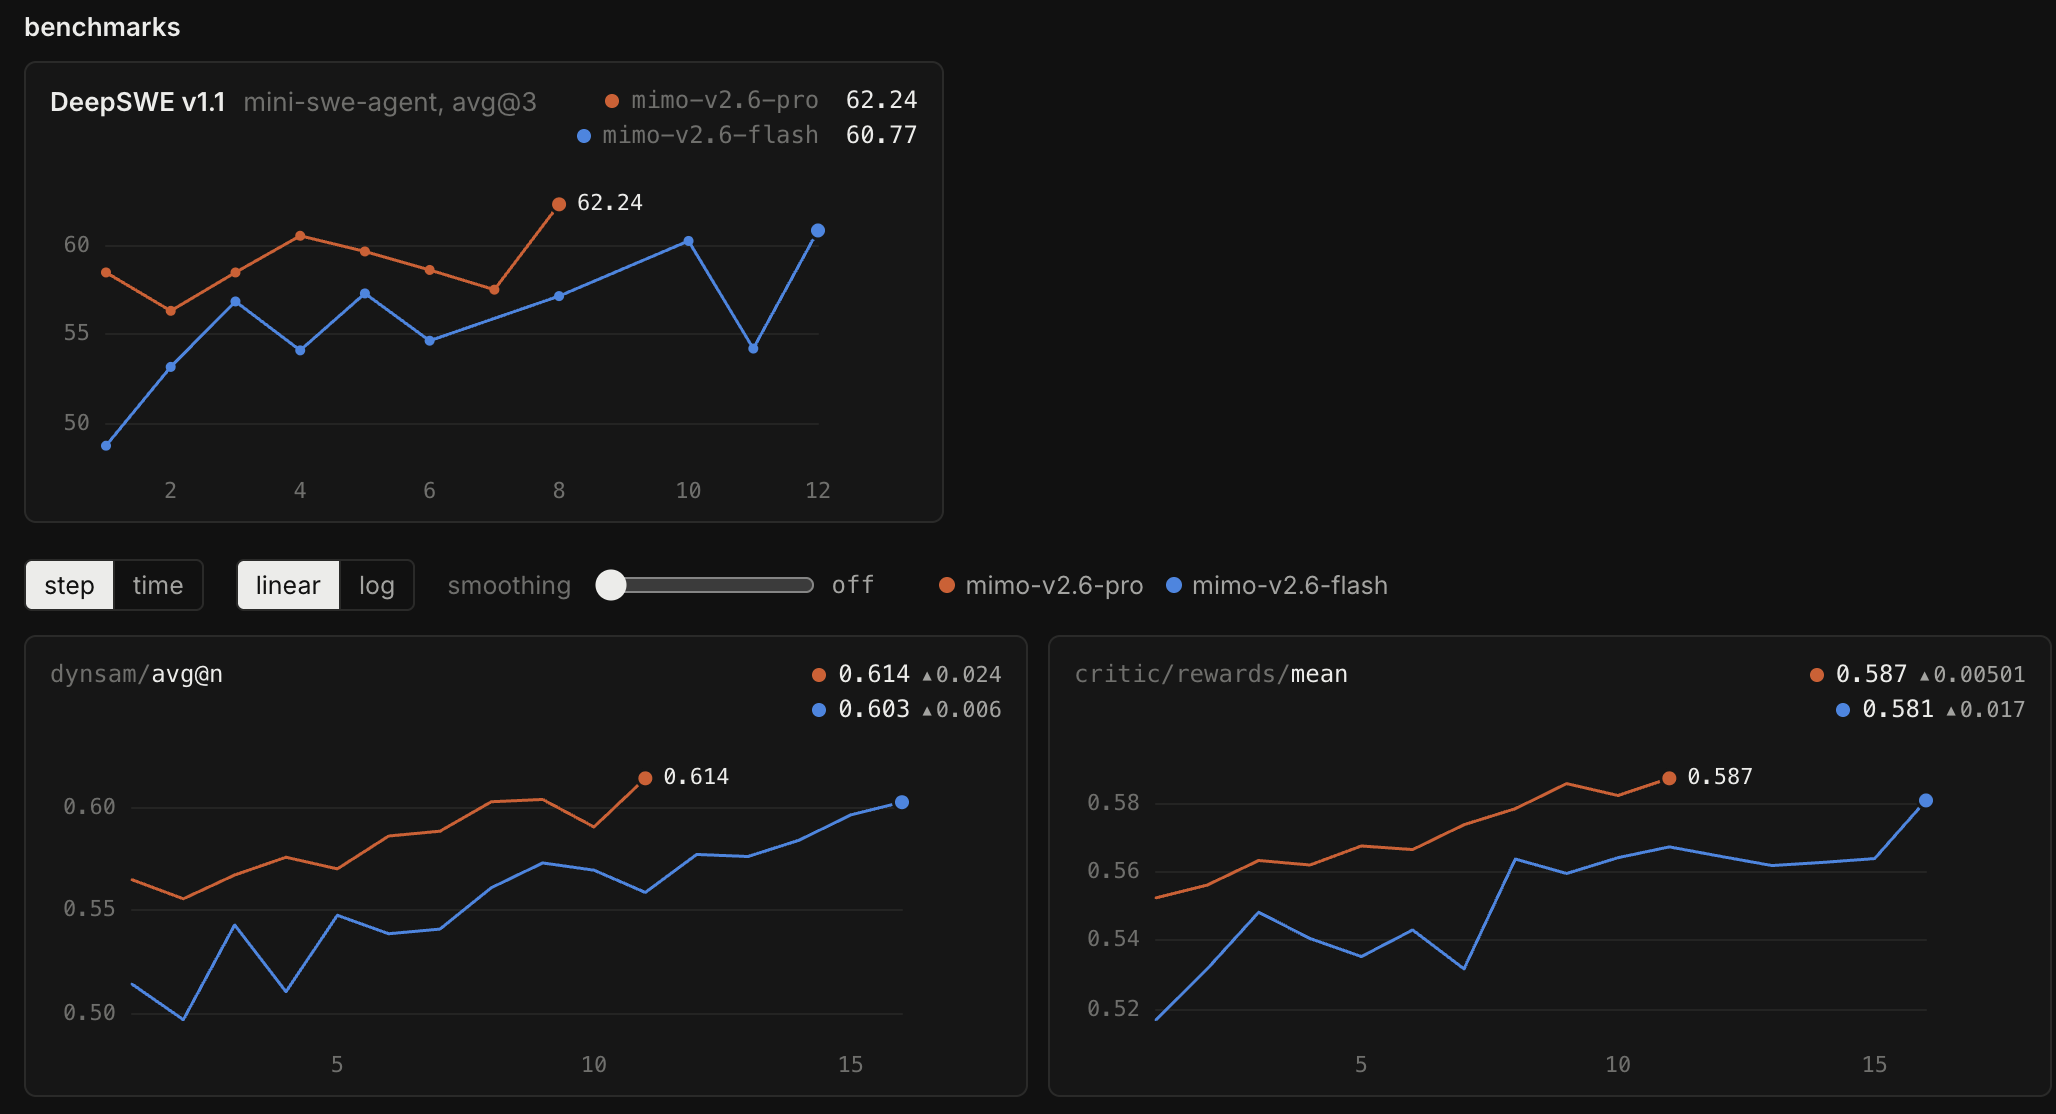
Pro模型的dynsam/avg@n指标从第1步的约0.565升至0.614;Flash则从0.514快速追到0.603。在最新公布的DeepSWE v1.1离线评测中,两者得分分别为62.24和60.77。作为参照,DeepSeek-Flash v1.1得分为74.2%。
值得注意的是,Flash虽然起点低,但追赶速度快;Pro保持小幅领先,但单步训练耗时更长,因此最新评分尚未更新。这也反映出两种配置在算力投入和训练策略上的差异。
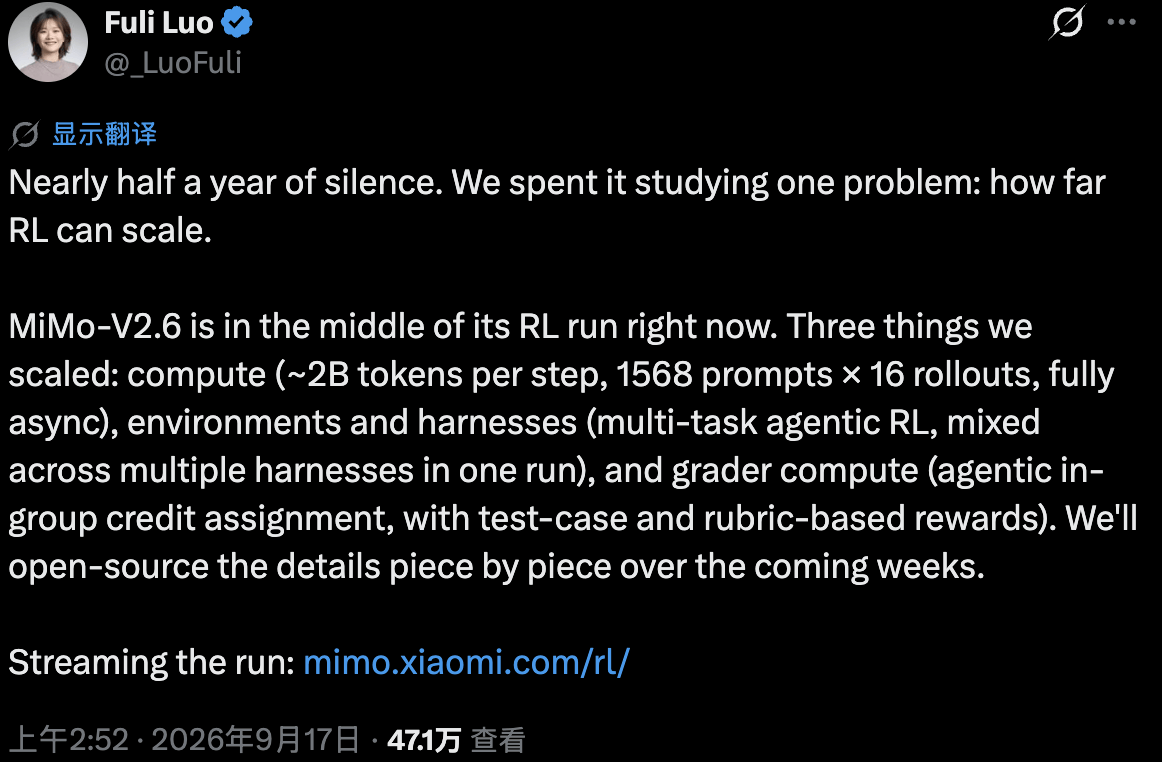
自今年4月开源MiMo-v2.5后,小米AI团队沉寂近半年。如今负责人罗福莉出面解释:这段时间只聚焦一个问题——强化学习到底能扩展到多远?
强化学习的三个Scaling维度
传统大模型的Scaling定律很清晰:更多数据、更大参数、更强算力,就能得到更强模型。但强化学习(RL)能否同样“堆规模”?小米的答案是肯定的,并提出了三个扩展方向。
训练计算量:异步处理数十亿Token
MiMo-V2.6每个训练Step处理约20亿Token,配置为1568个Prompt,每个Prompt生成16条Rollout(行动轨迹)。这意味着单轮就可能产出超过2.5万条轨迹。
对Agent任务而言,一条Rollout远不止一问一答。模型可能要经历几十轮思考、调用工具、接收反馈、再行动,最终累积成海量Token。
关键在于,整个系统采用Fully Async(完全异步)架构。传统RL像流水线:先批量生成样本,再统一评分,接着训练,最后进入下一轮。但在大规模Agent训练中,这种同步模式效率太低。
MiMo的做法是让不同任务同时处于不同阶段:有的Agent还在执行,有的已完成等待判分,有的正在计算Reward,新的任务又不断加入。生成、执行、评分、训练不再排队,而是一套持续运转的异步流水线。
环境与执行框架:混合多类型任务
第二个扩展方向是Environments and Harnesses,即训练环境和执行框架的多样性。
MiMo-V2.6做的是Multi-task Agentic RL,将代码、通用任务、视觉、聊天等不同类型的任务混合在同一轮训练中。更重要的是,这些任务运行在不同的Harness(执行框架)里。
比如,编程Agent的Harness允许它打开终端、修改代码、运行测试、读报错、再修改;而视觉Agent面对的可能是完全不同的工具集、环境反馈机制和成功标准。
因此,小米扩展的不仅是“题目数量”,更是模型能进入多少种环境、使用多少种工具、解决多少类问题。直播页面专门展示了“Batch Composition”栏目,实时说明当前Step中模型正在从哪些任务和环境中获取经验。
评分算力:细化信用分配
最容易被忽视的是第三个维度:Grader Compute(评分计算量)。
强化学习依赖奖励信号,但复杂Agent任务的奖励不像选择题那样明确。代码任务还能靠测试用例通过率给出客观反馈,但开放任务仅靠“成功/失败”二元判断远远不够。
更大的挑战是Credit Assignment(信用分配)。假设一个Agent为完成任务执行了40步:搜索资料、打开网页、读信息、写代码、运行测试、发现错误、修改代码,最终成功。如果系统只反馈“Reward=1”,模型根本不知道哪几步真正关键,哪几步纯属冗余。
MiMo此次特别提到Agentic In-group Credit Assignment。虽然未公布具体算法,但结合“同一Prompt生成16条Rollout”的设计,其思路可能是:利用同组多条轨迹及其结果,推断哪些行为更值得鼓励,哪些应减少,再将这种细粒度判断转化为训练信号。
这三个维度共同构成一套完整体系:扩大计算量以产生更多经验,扩展环境以获得更丰富经验,增加评分算力以提取更精准的学习信号。
背后都是算力
有围观者调侃:“别人干这事叫误闯天家,小米干这事叫误闯米家。”也有人更直白——ViT领域的大佬评论道:“说到底,三件事背后都是算力。”
确实,无论是异步处理数十亿Token,还是维护多样化的任务环境,或是运行复杂的评分模型,每一项都极度依赖GPU资源。每小时3万美元的开销,不只是数字,更是对工程能力和基础设施的考验。
不过,小米此举的意义或许不止于技术验证。通过公开训练全过程,它向社区展示了强化学习在真实大规模场景下的运行状态——包括进展、瓶颈、故障和成本。这种透明度本身,就是对AI研发文化的一种推动。
目前MiMo-V2.6仍在早期训练阶段,最终效果还需时间检验。但可以确定的是,这场“烧钱直播”已经让很多人第一次看清:当大模型开始与环境深度交互,真正的智能进化才刚刚开始。