当 Agent 自我进化得分变高,真的是因为系统变聪明了吗?
五次机会,怎么花最值?
一个 Agent 第一次没把任务做对。你手头还有五份额外的推理预算,可以有很多种花法。

最朴素的做法是:让它把同一道题再做几遍,从多个结果里挑最好的。稍微聪明一点,可以把上次失败的过程交给它,让它接着改。还有一种听起来更“高级”的思路——让 Agent 分析自己的失败,修改 Prompt、工具、Memory 甚至整个运行框架。这种做法,最近在 Agent 研究圈里很火,被称为 Harness Evolution。
它的愿景很吸引人:今天工程师手动调 Prompt、加工具、设 Memory;未来这些工作或许能交给 Agent 自己完成。Agent 不仅执行任务,还能不断优化支撑自己工作的“操作系统”,从而一轮比一轮更强。
但这里藏着一个容易被忽略的问题:当“自我进化”的 Agent 得分提高时,我们怎么知道它是真的学会了更好的工作方式,而不是仅仅因为多获得了几次尝试机会?
AI2 和华盛顿大学的一项最新研究,把这个问题直接摆到了台面上。
Harness 到底是什么?
要理解这项研究,得先搞清楚什么是 Harness。
你可以把 Harness 看作模型外面的那套“操作系统”。一个大模型真正成为 Agent,通常不只是靠模型本身。模型外面还有一整套系统:Prompt 怎么写、能调用哪些工具、有没有 Memory、如何验证结果、失败后是否重试、什么时候停止、下一步看到什么信息……这些加起来,就是 Agent 的 Harness。
同一个模型,底层参数完全不变,仅仅因为 Harness 不同,表现就可能出现明显差异。
过去,Harness 大多依赖工程师手工优化。Agent 跑一次任务,工程师读轨迹(trajectory),发现工具调用不合理,就改 Prompt;发现 Agent 总忘事,就加 Memory;发现它不会检查答案,再塞个 verifier。
Harness Evolution 想做的,就是把这套人工迭代过程自动化。Agent 运行任务,观察结果,总结失败经验,自动修改自己的 Harness,再运行一轮,然后继续修改。Meta-Harness、AHE、AEVO 等工作都在探索类似方向。如果这条路走通,意义很大:Agent 系统可能具备某种形式的自动工程优化能力,甚至成为递归自我改进的一部分。
公平比较:改系统 vs. 多做题
问题是——这种“进化”本身也是一种搜索。真正该比较的,不是“进化前”和“进化后”,而是“改系统”和“多做题”在相同条件下的效果。
假设一个普通 Agent 只跑一次,得分 70。Harness Evolution 允许系统连续运行五轮:分析失败、修改 Harness、重新执行……最后得分变成 75。我们能因此说 Harness Evolution 提升了 5 分吗?
不一定。因为在第二种情况下,系统不仅改了 Harness,还用了更多推理计算、执行了更多轨迹、获得了更多反馈。真正公平的对照应该是:如果不改 Harness,也给普通 Agent 五次运行机会,会发生什么?
比如,同一道任务独立跑五次,选最好的结果;或者第一次失败后,让 Agent 看着之前的结果继续修改,连修五轮。这些方法没有复杂的“自我进化”模块,本质上只是增加测试时计算,通常叫 test-time scaling。
这篇论文的核心问题就是:在反馈和计算预算基本一致的情况下,修改 Harness 本身究竟贡献了多少额外收益?
四种花钱方式的对决
研究者在 Terminal-Bench 2.1 上做了对照实验。为了减少干扰,所有方法都从一套极简初始 Harness 出发:只有一个 bash 工具,没有额外 Skills、Middleware 或持久化 Memory。使用的模型包括 Claude Opus 4.6、GPT-5.4 和 GPT-5.4 mini。每个任务统一获得 K=5 的计算预算。
他们测试了四种花钱方式:
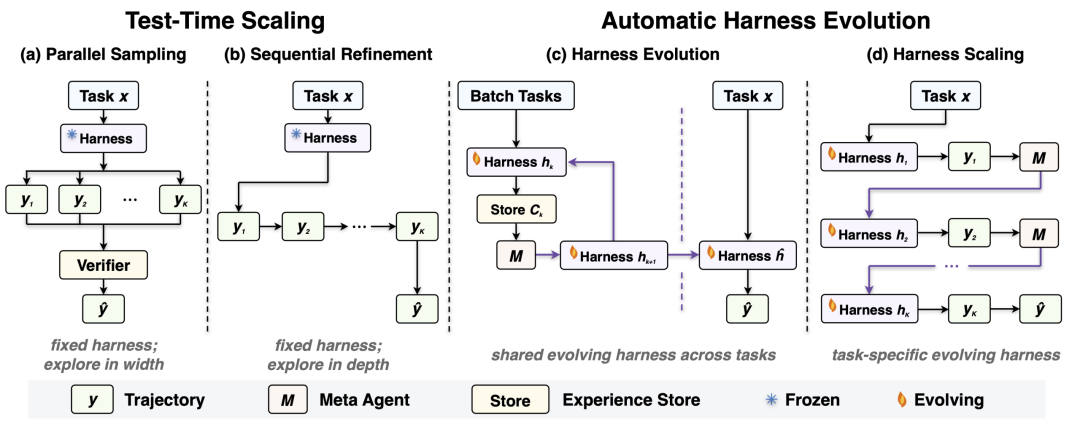
- Parallel Sampling:Harness 完全不动。同一个任务独立执行多次,从候选结果中选最终答案。相当于“不会就多做几遍”。
- Sequential Refinement:Harness 固定,但后一次执行能利用前一次的结果和反馈。不是从头重来,而是“接着改”。
- Harness Evolution:从多个任务的运行经验里总结规律,修改一套共享 Harness,希望新配置能让整个任务分布上的 Agent 都变强。论文用 AHE 作为具体实现。
- Harness Scaling:作者设计的新方法。不学面向整个数据集的通用 Harness,而是针对当前这道题,根据刚发生的轨迹动态修改 Harness。
这四种方法的区别看起来很大,但面对的是同一个问题:五次计算机会,到底该拿来“改系统”,还是直接“继续做题”?
没有正确答案反馈时,简单方法反而赢了
研究者首先去掉了 Unit Test。也就是说,Agent 做完任务后,没有可靠外部信号告诉它“你到底做对没有”。这种场景对 Harness Evolution 尤其有挑战,因为它需要根据自己的轨迹判断哪里出错,再决定 Harness 怎么改。
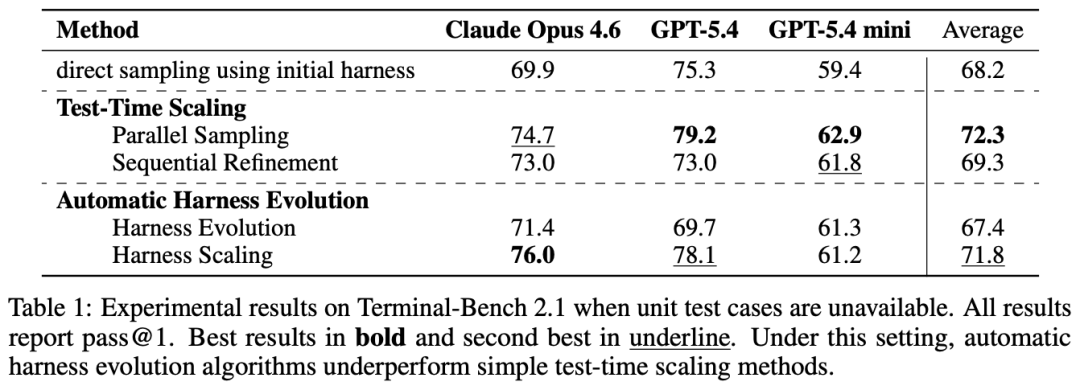
结果令人意外:
- 初始简单 Harness 平均分 68.2
- Parallel Sampling 提升到 72.3
- Sequential Refinement 为 69.3
- Harness Scaling 达到 71.8
- 传统 Harness Evolution 只有 67.4
换句话说,花了更多步骤去“学习如何改进自己的 Harness”,最后甚至没超过最初的简单 Harness。
为什么会这样?一个可能原因是:没有可靠 verifier 时,Agent 连“自己为什么错了”都未必判断准确。假如第一轮错误诊断就出现偏差,后续的 Harness 修改实际上是在基于错误信息继续优化。它可能不是越改越好,而是越改越偏。
Parallel Sampling 则完全没有这个问题。它什么也不学习,什么也不总结,只利用模型输出本身的随机性,多尝试几次。这种方法非常简单,却反而更稳定。
有了正确反馈,赢家依然不是“进化”
那如果 Agent 明确知道自己做错了呢?接下来,研究者加入了 Unit Test。
这一次,各种方法都能得到相对可靠的 correctness signal。如果之前的 Harness Evolution 主要吃亏在“自己不知道自己错在哪”,那么有了 Unit Test,它理论上应该更有优势。
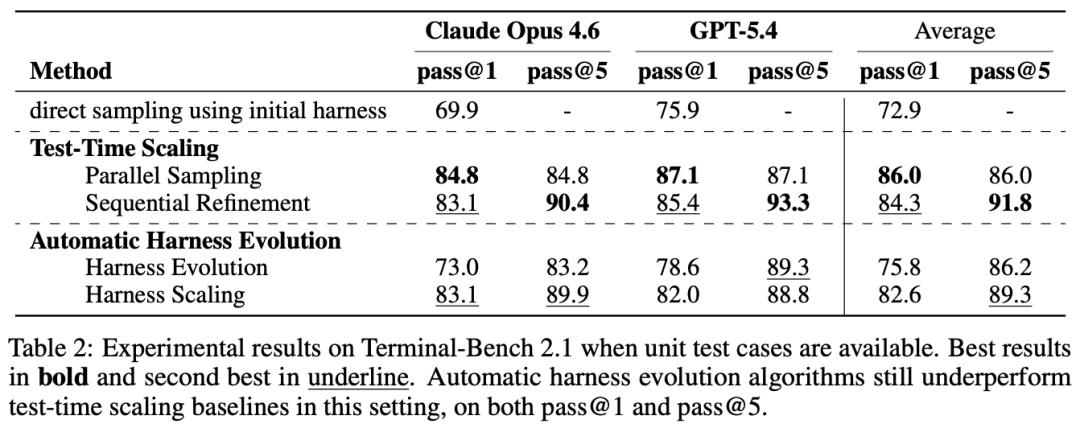
实验结果确实整体大幅提高,但赢家依然不是 Harness Evolution:
- Parallel Sampling 的平均 pass@1 达到 86.0
- Sequential Refinement 的平均 pass@5 达到 91.8
- Harness Evolution 的平均 pass@1 是 75.8,pass@5 为 86.2
- Harness Scaling 的平均 pass@1 为 82.6,pass@5 为 89.3
这里最值得看的其实是 pass@1。因为如果 Harness Evolution 真的发现了一套明显更好的 Harness,那么换上新 Harness 后,Agent 第一次尝试就应该比以前更容易成功。真正属于 Harness 的能力提升,应该很明显地出现在 first-try performance 上。
但实验中看到的现象并不是这样。很多提升只有在系统拥有多次 trajectory、能够反复尝试或从多个结果中挑选成功答案以后才出现。
新任务上几乎没提升
还有一个比计算预算更关键的问题:很多 Harness Evolution 方法会利用 benchmark 中的任务和反馈不断优化 Harness,最后再回到同一个 benchmark 上报告成绩。这很容易造成混淆:系统究竟学会了通用的 Agent 设计原则,还是越来越熟悉这一批 benchmark?
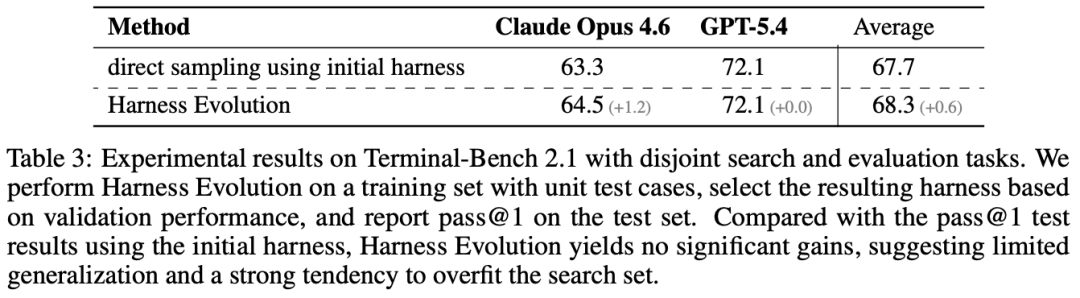
为了区分两种情况,作者重新划分了 Terminal-Bench 2.1:45 个任务用于 Harness Evolution,10 个作为 validation set,最后留下 34 个完全隔离的任务作为 test set。进化过程中,系统不能看到最终 test set。
结果是:
- Claude Opus 4.6 从 63.3 提升到 64.5
- GPT-5.4 从 72.1 变成 72.1,没提升
- 两个模型平均下来,成绩从 67.7 变成 68.3,仅 +0.6 个百分点
这和 Harness 在参与优化的任务上表现出来的增益形成鲜明反差。如果一种 Harness 设计真正捕捉到了通用的 Agent 工作原则,那么换一批新任务以后,理论上应该继续带来明显收益。但这里看到的迁移效果非常有限。
因此作者提出一种解释:当前自动 Harness Evolution 得到的部分收益,可能更接近 task-specific adaptation。系统在搜索过程中逐渐适应了这组 benchmark,而不一定发现了一套能够稳定迁移的新 Agent 架构。
真正卡住 Agent 的,可能是模型本身
这项研究反过来也指出了一个重要方向:真正适合研究 Harness Evolution 的 benchmark,可能需要让“Harness 的质量”成为决定成败的关键变量。
例如,任务确实需要长期 Memory,需要多个专业工具协同,需要复杂 workflow,需要在不同阶段采用不同策略,或者必须依靠精心设计的验证和恢复机制。只有在这些任务里,我们才能真正观察到:不换模型,只改变 Agent 外部架构,能不能让系统获得原本没有的能力?
而 Terminal-Bench 这样的任务,可能已经可以被强模型用相对简单的 Harness 解决。Shell 加一个基本 Prompt,对于很多能解决的任务来说可能已经足够。剩下那些做不出来的问题,也许真正卡住 Agent 的并不是 Prompt、Memory 或工具配置,而是底层模型本身的能力上限。
如果模型根本不知道该怎么解决一道问题,再复杂的 Harness 也不一定能凭空创造出缺失的推理能力。
对整个 Agent 评估范式的挑战
这篇论文真正挑战的,可能是整个 Agent Evaluation 范式。
今天越来越多 Agent 系统都会加入 Reflection、Memory、Planner、Evaluator、Multi-Agent、Self-Improvement、自动 Prompt 优化等模块。系统也因此越来越复杂。但与此同时,一个非常基础的问题变得更加重要:复杂系统成绩更高,到底因为算法更好,还是因为它消耗了更多计算?
假设一个新 Agent 架构有 Planner、Critic、Memory,还有三个子 Agent。它每道题总共调用模型二十次,最终 benchmark 提高了五个百分点。另一个极简 Agent 什么模块都没有。但如果也允许它调用模型二十次,只是重复采样、不断修正,结果同样提高五个百分点。那么前面那套复杂架构真正带来的算法价值,就值得重新衡量。
因此,未来评估这类系统时,一个更严格的标准可能应该是:比较双方是否拥有相近的 inference budget,是否获得同等级别的外部反馈。
而随着 Agent 从单次调用模型,走向越来越长的 trajectory、越来越复杂的工作流,这个问题只会越来越重要。
结语:别把重试当成进化
这项工作的价值,也许就在于提醒我们:在谈 Agent 的“自我进化”之前,首先要把一个更朴素的问题算清楚——如果给最简单的方法同样多的时间、反馈和计算,它能做到什么程度?
有时候,看起来像“进化”的提升,可能只是一次没有被计入对照组的重试。
这并不是说 Harness Evolution 没有意义,而是说:现有实验可能还不足以证明,我们看到的性能提升确实来自“Harness 变聪明了”。要真正验证这一点,我们需要更严格的对照、更合适的 benchmark,以及对计算成本的透明核算。
毕竟,真正的智能,不应该建立在未被承认的额外尝试之上。