Self-Developing Agents 如何从模糊目标中学习并保留有效改进
从“做题”到“自学”:AI 面临的真实挑战
人学新东西时,很少有现成的题库和标准答案。想成为更好的程序员,你得自己判断该补算法、练工程,还是学新框架;想提升写作,可能要决定是多读经典、模仿风格,还是找人批改。这种“没有明确路径”的学习,正是当前 AI Agent 最难跨越的门槛。

字节跳动 Seed、TokenWave 等机构的研究者在 Self-Developing Agents 项目中,试图让 Agent 像人一样,在模糊目标下自主决定学什么、怎么验证、如何积累经验。他们指出,现有许多所谓“递归式自我改进”(Recursive Self-Improvement, RSI)其实依赖一个外部设定的“黄金验证器”(Golden Verifier)——它告诉 Agent 什么是好结果,Agent 只需沿着反馈优化。这更像是“半环 RSI”,缺少了目标形成、经验提炼和能力沉淀的完整闭环。
为补上这一环,团队设计了三个基准:ASPIRE 研究如何从模糊目标中找到学习方向,S³Gym 探索能否从自身行为中可靠地学习,HarnessDev 则检验改进能否真正留在系统里并持续生效。
ASPIRE:目标越模糊,越容易“瞎忙”
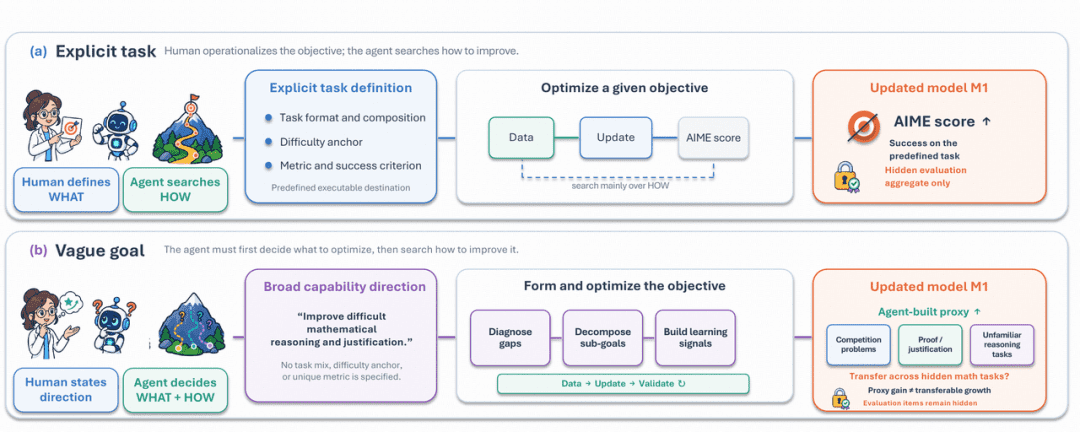
ASPIRE 的核心问题是:当目标只是“提升数学推理能力”而非“提高某次考试分数”时,Agent 该如何行动?
在这个设定中,Agent 只收到一段自然语言描述的能力目标(如“增强代码生成能力”),其余全靠自己:找什么数据、用什么方法训练、如何验证效果,都由它决策。研究者准备了 6 类能力目标、520 道专家编写的隐藏评测题,题目和答案对 Agent 完全不可见,仅用于事后评估其选择是否真正提升了目标能力。
结果令人意外:Agent 能完成数据收集、训练和内部评测的全流程,但最终能带来真实能力增益的改进极少。在 30 次实验单元中,21 个产出了可筛选的检查点,最终只有 1 个被确认有效。
问题出在“决策膨胀”。面对模糊目标,Agent 把大量时间花在解释目标、设计代理指标上,留给实际训练和验证的时间反而减少。LoRA 微调的使用率从明确任务下的 24.1% 飙升至 89.8%,说明它更倾向于频繁尝试小规模更新,而非深入训练。但频繁更新不等于有效提升——完成一次权重修改,不代表目标能力真的变强了。
这揭示了一个关键矛盾:目标拆解活动的增加,并不等同于方向正确。Agent 可能在“思考该学什么”上很努力,却偏离了真实需求。
S³Gym:会复盘,不代表会进步
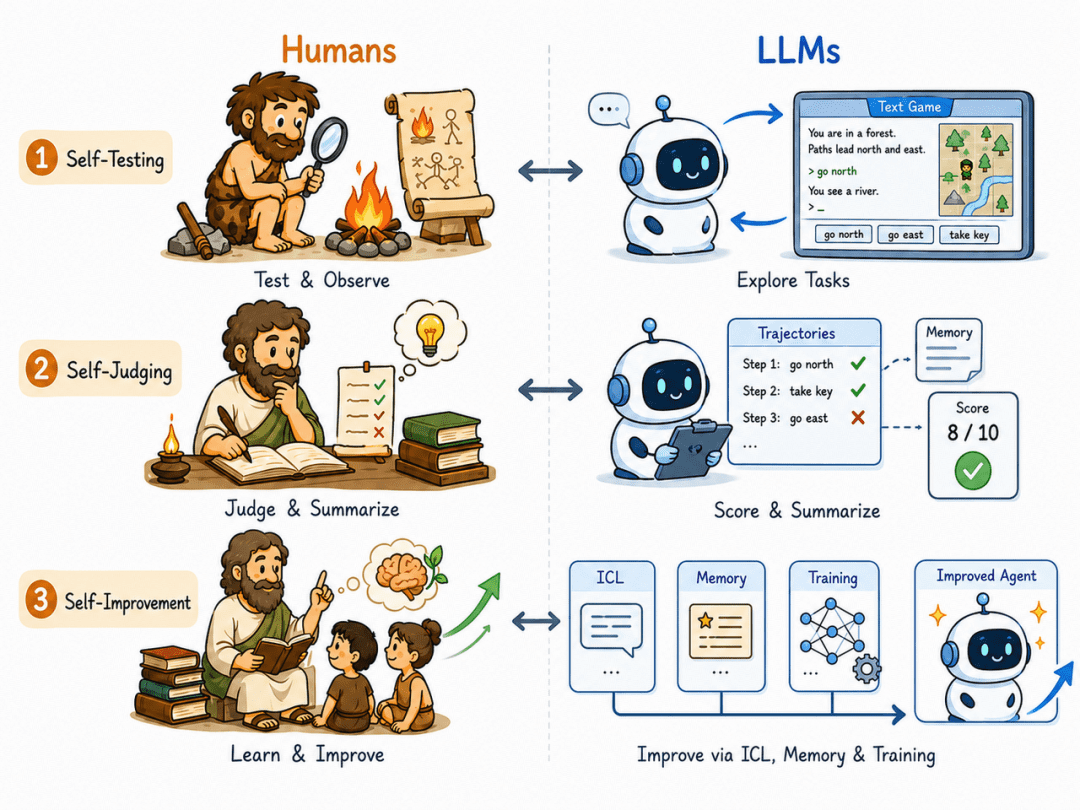
即使 Agent 能自主行动,它还得判断自己做得好不好,并从中提取有用经验。S³Gym 在七个文字游戏中测试这一能力。
游戏过程中,Agent 能看到环境反馈(如角色移动、物品变化),但看不到程序内部的真实奖励分。探索结束后,研究者用新的随机种子和更严格条件重新测试,检验其表现是否真正提升。值得注意的是,这些测试记录不会回流为学习材料,避免“偷看答案”。
实验发现,Agent 的自我判断能力很弱。它能给出“这次行动不错”的评价,但这种判断与后续表现几乎没有稳定关联。换句话说,它知道自己某次做得好,却不知道为什么好,也无法据此调整下一次策略。
更麻烦的是,经验没有通用的保存方式。在某些游戏中,原始操作轨迹比摘要记忆更有效;换一个游戏,摘要反而胜出。原因在于:有些经验是通用策略(如“先探索再行动”),适合概括;有些则依赖精确状态(如“在第 37 步点击左上角”),摘要一压缩就丢了。
模型参数更新也非万能。同一条训练轨迹中,Agent 在“信任博弈”游戏中进步明显,在“植物大战僵尸”类任务中却持续退步。这说明,经验吸收的效果高度依赖任务特性,盲目更新可能损害原有能力。
S³Gym 的结论很直接:不能因为一份复盘报告写得漂亮,就认为学习发生了。必须分开检验——复盘是否准确?经验以什么形式保存?下次是否真的做得更好?
HarnessDev:改得越多,未必越好
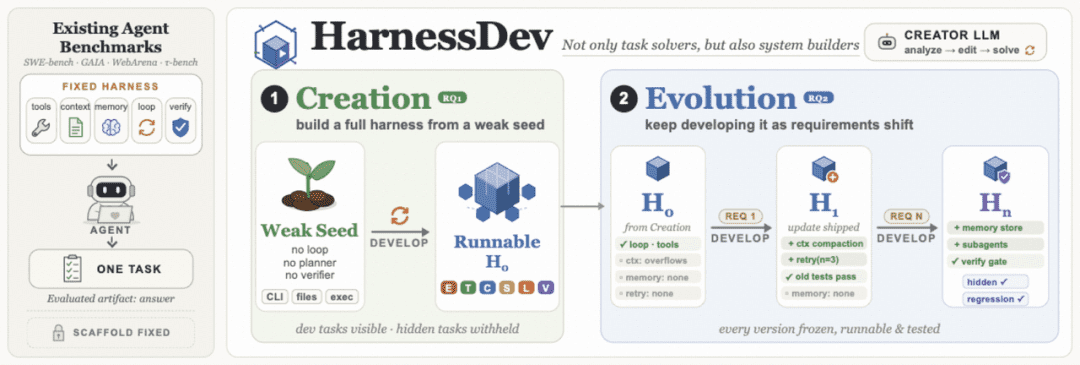
即使 Agent 找对了方向、提取了经验,还得把改进“焊”进系统里,让它在后续任务中持续发挥作用。HarnessDev 就研究这件事。
项目分两个阶段:Creation 阶段,Agent 从零构建执行系统(如代码生成工具链);Evolution 阶段,它根据运行反馈不断修改系统。关键设计是:执行任务的模型权重固定不变,所有改进只能通过修改 Harness(执行系统)实现,从而区分“模型能力”和“系统增强”。
结果再次出人意料:在 Qwen 和 DeepSeek 两条演化轨迹中,选定版本在开发阶段的可见反馈上都有提升,但在未参与开发的隐藏任务(SWE-Pro 数据集)上,表现反而下降。这些隐藏分数在开发结束后才计算,未返回给创建者,因此暴露了开发反馈的局限性。
更严重的是,系统修改可能破坏原有功能。例如,为节省上下文长度加入的消息清理机制,意外删除了合法的工具调用消息,导致任务失败。部分改动后来不得不回滚。
这说明,对当前任务有效的调整,未必适合长期保留。HarnessDev 由此强调:任何持久改动必须满足三点——在运行中实际被调用、能迁移到新任务、必要时可回退。
目前这些观察主要来自代码任务,单条轨迹尚不足以证明长期收益稳定。但趋势已很明显:自我修改若缺乏跨任务验证,极易陷入对局部反馈的过拟合。
真正的瓶颈:判断力,而非执行力
综合三项基准,Self-Developing Agents 的核心发现是:当前 Agent 已具备基本的自我训练、总结和修改能力,但真正的瓶颈不在“能不能改”,而在“该不该改”。
具体来说,有三大断层:
- 目标断层:模糊目标被错误拆解为无效子任务,导致努力方向偏离;
- 经验断层:自我判断与后续收益脱节,经验保存方式与任务特性不匹配;
- 验证断层:开发反馈无法代表真实能力,改进在未见任务中失效甚至有害。
这些问题的根源,是对代理指标和局部反馈的过度依赖。Agent 太容易被“看起来合理”的中间信号误导,而缺乏对真实目标的锚定和跨场景验证机制。
未来,Self-Developing Agent 的突破点可能不再是更强的基座模型或更复杂的执行系统,而是建立可靠的目标形成、经验筛选和能力保留机制。只有当 Agent 能持续区分“表面改进”和“真实进步”,并在长期运行中沉淀可泛化的经验,才算真正迈入自主进化的大门。
这条路还很长,但至少现在我们知道,问题不在算力,而在判断力。