GPT-6 Astra混合架构在具身智能仿真测评中大幅领先
混合架构拉开性能差距
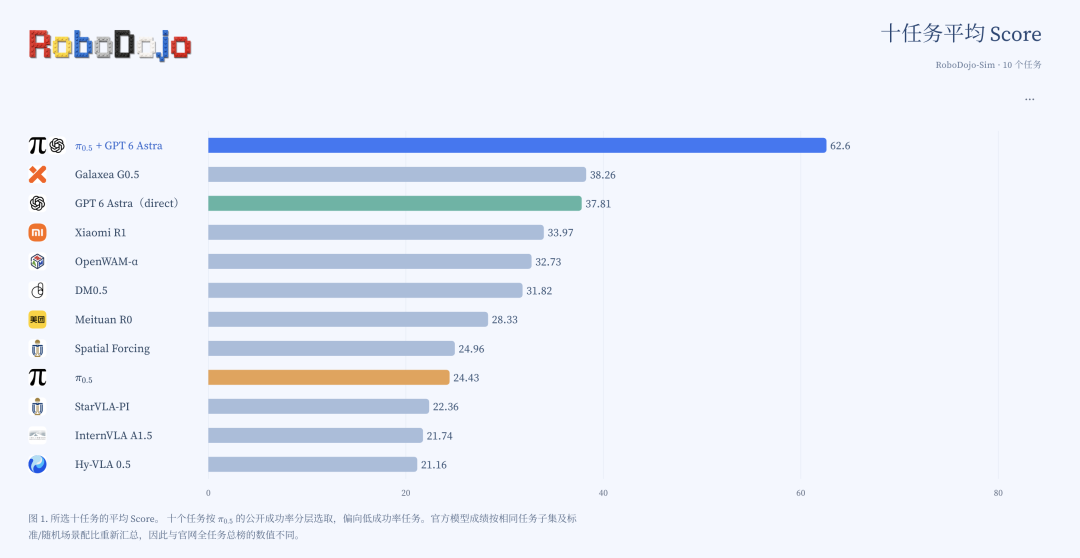
最近,一份匿名发布在 GitHub 上的仿真测评报告在具身智能圈引发广泛关注。报告显示,采用 GPT-6 Astra 与 π₀.₅ 混合架构的方案在综合评分上达到 62.6 分,而第二名仅为 38.26 分——两者相差超过 64%。这种量级的差距已经不是靠微调或工程优化能解释的,更像是架构层面的代际差异。
值得注意的是,这项研究并没有让 GPT-6 Astra 直接输出机械臂控制指令。它做了一件更聪明的事:让 Astra 负责语义层面的判断与修正,而由 π₀.₅ 提供物理空间中的动作先验和交互能力。两者形成互补,一个管“想什么”,一个管“怎么做”。
银河通用团队对 Astra 的深度评测显示,该模型在 System 2 类型的通用推理能力上取得明显突破。虽然其生成的轨迹质量不高、实时性差,但能在未见过的机器人形态和任务上实现高成功率,并具备较强的错误恢复能力。这让人联想到 ChatGPT 在语言领域的跃迁——当模型参数规模达到数万亿级别,通用性似乎真的出现了质变。
测评方法:两种闭环控制架构对比
这份报告由银河通用创始人兼 CTO 王鹤教授的博士生主导,采用严格对齐的闭环控制实验设计。研究聚焦于仿真环境下的双臂操作任务,对比了两种架构:
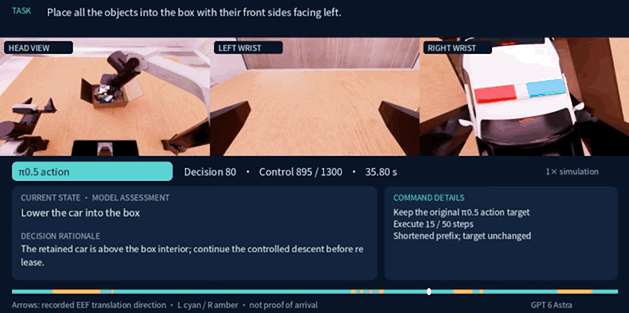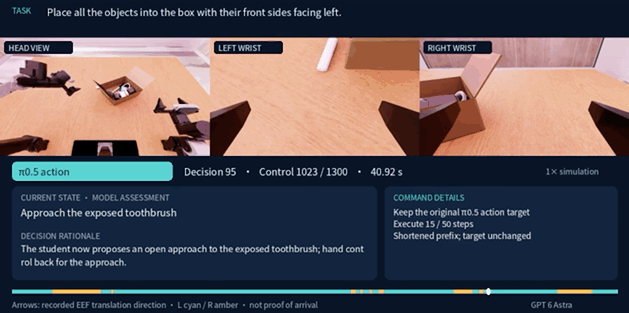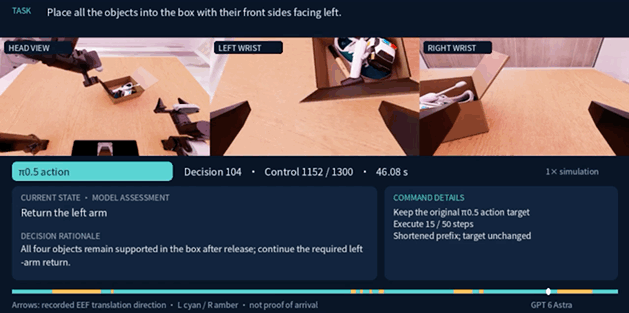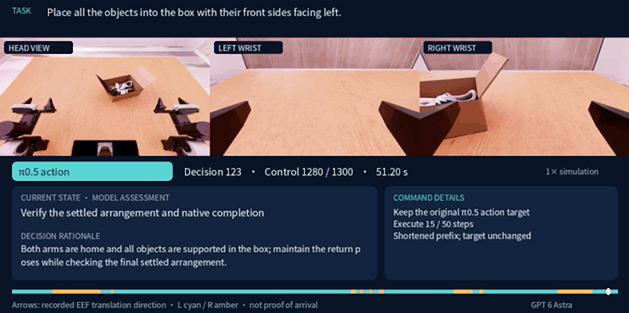
Direct 模式:GPT-6 Astra 直接接收三路相机画面和机器人本体状态,输出双臂末端位姿及夹爪开合指令,每次执行 1 到 5 个控制步。
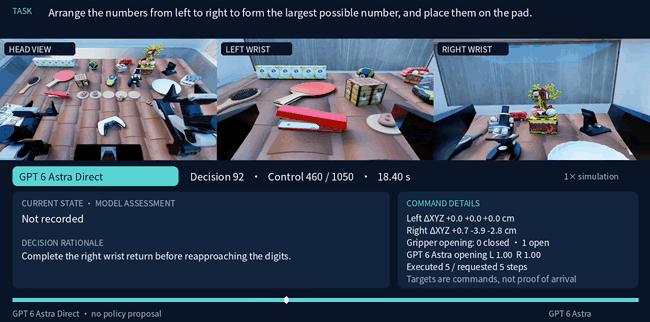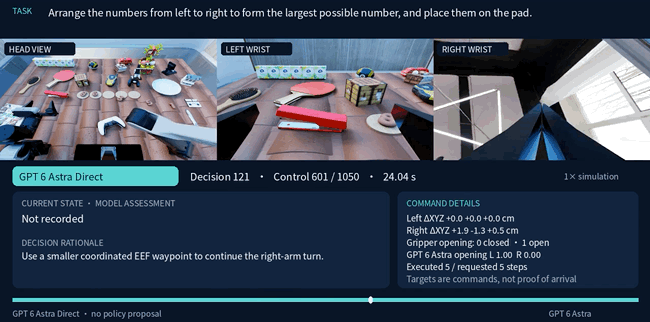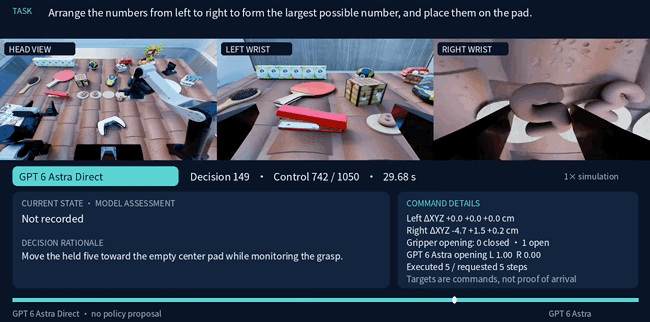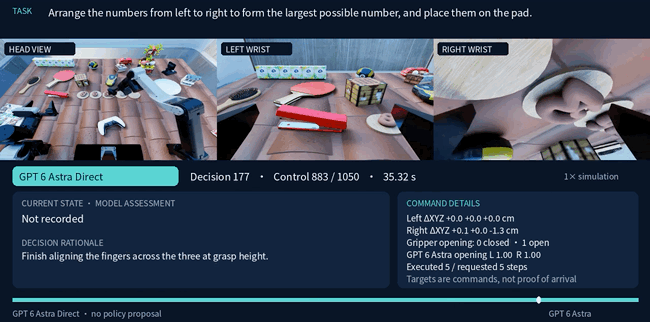
混合模式:每个决策时刻,π₀.₅ 先生成 50 步候选动作序列。Astra 同时看到画面、执行历史以及这些候选轨迹,然后做出选择——要么沿用 π₀.₅ 的前 1 到 15 步,要么自己生成 1 到 5 步的修正指令。执行完这一段后,系统重新观察环境,进入下一轮决策。
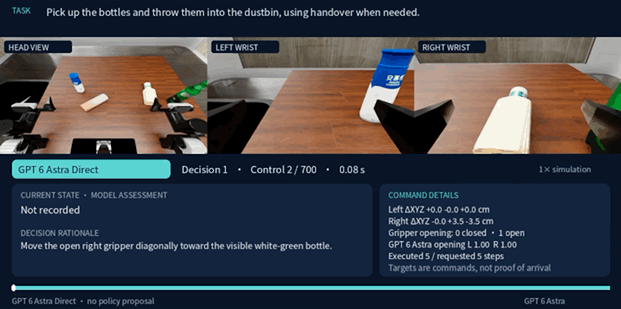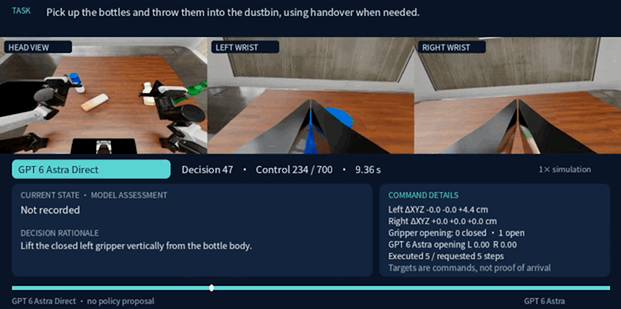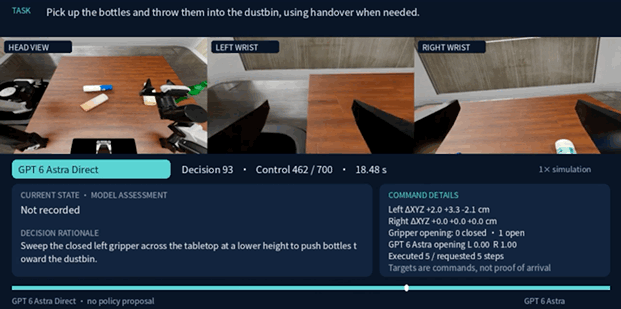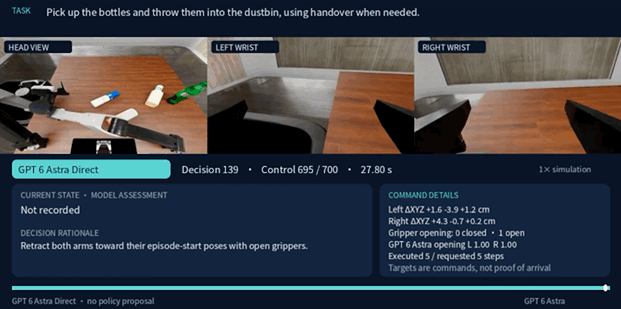
这个思路并不新鲜。报告作者也承认,“候选动作挑选”的 TopK 策略在业内早有讨论。但此前没人能跑出如此显著的性能差异。最终,混合模式以 48% 的成功率和 62.60 的平均分大幅领先,比第二名高出 64%。
RoboDojo:混合架构大幅提升复杂任务成功率
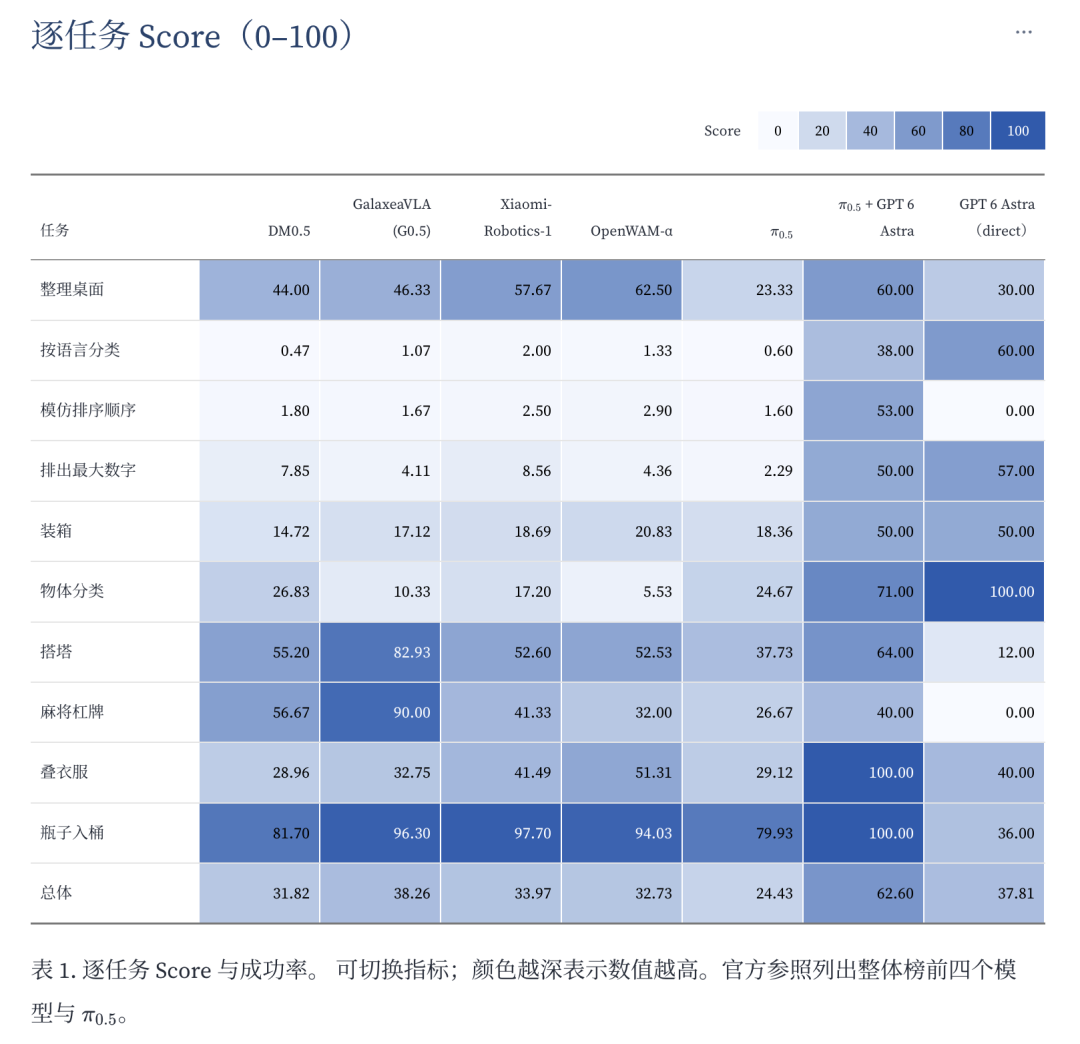
研究首先在 RoboDojo 平台上测试了 10 类复杂操作任务,包括整理桌面、按语言分类物体、排序数字、装箱、搭塔、麻将杠牌、叠衣服和瓶子入桶等。每类任务重复 5 次,共 50 次实验。
结果对比鲜明:
- GPT-6 Astra Direct:成功 13 次(26%),平均分 37.81
- π₀.₅ + Astra 混合:成功 24 次(48%),平均分 62.60
更关键的是,Astra 在整个执行过程中只修改了 14.4% 的控制步骤。这意味着绝大多数动作仍由 π₀.₅ 完成,Astra 仅在关键节点介入,负责理解任务目标、判断当前状态,并决定是否需要修正。
这说明两类模型确实互补。Astra 擅长语义理解、视觉识别、空间关系推理和任务规划。在“物体分类”任务中,Astra Direct 甚至拿到满分;面对抓取失败或环境变化,它还能重新观察并调整策略。
但在需要精细接触的任务上,大模型的短板立刻暴露。例如“搭塔”任务,Astra Direct 平均仅得 12 分;“麻将杠牌”更是得分为 0——它知道木块该放哪儿,却无法稳定控制落点、摩擦和碰撞。
引入 π₀.₅ 后,情况大为改观:“搭塔”得分升至 64,“麻将杠牌”提高到 40,“叠衣服”和“瓶子入桶”也从部分成功变为全部成功。这清晰地表明:对物理世界的理解(认知)
RoboLab:零样本泛化能力惊人
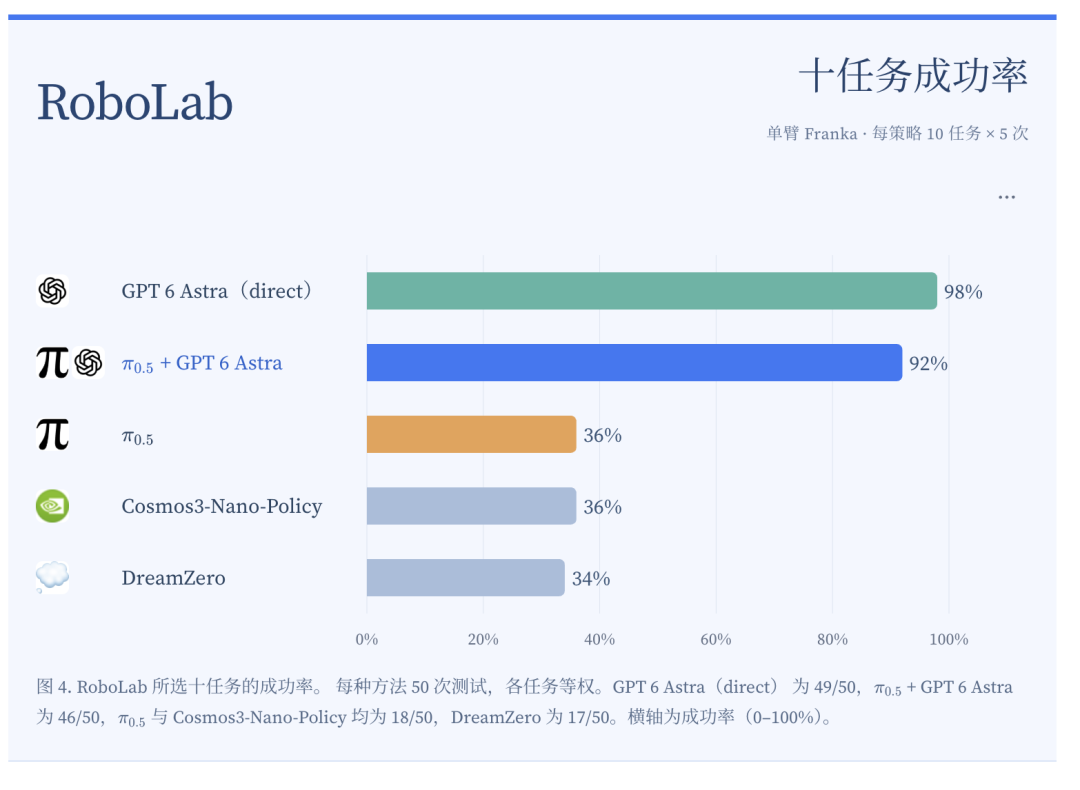
RoboLab 实验进一步验证了 Astra 在语义密集型任务上的优势。团队选取了 10 类任务,如将方块放入容器、在杂物中找南瓜、按顺序堆叠积木、调整杯子朝向等,同样每类测试 5 次。
结果令人惊讶:
- Astra Direct:成功 49/50(98%)
- Astra + π₀.₅:成功 46/50(92%)
- π₀.₅ 单独:仅 18/50(36%)
Astra 没有针对这些任务进行任何微调,仅凭当前画面、机器人状态和自然语言指令,就能持续判断下一步操作。多个任务实现 5 次全成功,唯一失败的是“大号葡萄干盒放入容器”,5 次完成 4 次。
这展示了强大的零样本泛化能力:模型能识别目标、理解空间关系、将语言转化为动作,并在环境变化后动态调整策略。
不过报告也提醒,这组数据并非严格复现完整 RoboLab 排行榜。实验仅选了 10 个任务,且部分 Astra 运行包含授权重试。因此 98% 更应视为能力上限的参考,而非同条件下的绝对排名。
Astra 强在“发现哪里不对”
回到 RoboDojo 的详细数据,能看出 Astra 真正的优势所在。
在高度依赖语言和视觉的任务中,它表现极佳:“物体分类”100 分,“按语言分类”平均 60 分,“排出最大数字”得 57 分。这些正是大模型的舒适区。
更有趣的是,实验中出现了许多传统机器人策略很少展示的行为:
- 发现抓取姿态不理想后,主动改变接近方式
- 物体看似摆好,但重新观察后发现任务未完成,继续调整
- 装箱过程中识别出箱子后方还有遗漏物体
- 原计划受阻时,根据新视觉反馈重新规划
在数字摆放任务中,模型甚至能在运动受阻后理解机械臂的控制反馈,调整动作并继续执行。这说明 Astra 并非机械执行预设轨迹,而是形成了“观察—决策—执行—再观察”的闭环。
有时它还会尝试训练数据中未必出现的策略。比如在“瓶子入桶”任务中,Astra Direct 曾试图不逐个抓取,而是用机械臂将瓶子扫向桶内。虽然最终失败,但展示了模型能根据目标自主探索新路径。
物理交互仍是瓶颈
然而,报告也坦承 Astra 的局限。
在“搭塔”和“麻将杠牌”这类任务中,它几乎完全失效。原因在于:理解目标不等于能稳定完成动作。模型可能知道木块该放哪,却无法保证放下时不倒塌;知道物体要进容器,也可能因夹爪与边缘碰撞而失败。
当前控制采用分段执行,模型通常要等一段动作结束后才能重新观察。因此执行中发生的滑落、偏移等问题,往往要到下一轮才被发现。
这正是 π₀.₅ 的价值所在。它通过大量机器人交互数据训练,形成了可靠的运动先验。两者结合后,原本 Astra 难以完成的任务显著改善。
研究还指出,Astra Direct 会提出一些“听起来合理但实际不稳定”的方案,比如单手搭塔、用扫动代替抓取等。这些零样本行为虽有创意,却因缺乏成熟的抓取姿态、支撑判断或释放时机控制,难以稳定复现。提出可行方案与稳定执行方案,是两个不同层次的能力。
成本与现实差距
报告强调,当前方案离实际部署仍有不小距离。
首先是推理成本。RoboDojo 实验中,混合架构累计消耗约 6.25 亿 Token,而 Astra Direct 超过 11.3 亿 Token。大模型需要反复读取视觉和历史上下文,进行长链推理,这与机器人所需的低延迟、高频控制存在天然矛盾。
其次,所有实验都在仿真环境中进行。真实世界还有相机噪声、机械误差、通信延迟、摩擦力变化和安全约束等挑战。目前的结果更像是一次“能力边界测试”——在不限制 Token 和时间的前提下,看看大模型能把机器人控制推到什么程度。
两条能力线:认知泛化 vs 物理交互
综合来看,报告得出两个关键结论。
第一,大规模训练带来的泛化能力正在具身任务中显现价值。Astra 在语义理解、视觉感知和任务规划等“认知层”大幅抬高了端到端模型的能力上限。RoboLab 中 49/50 的成绩说明,通用模型通过预训练获得的能力,确实能迁移到机器人决策环节。这验证了 Scaling Law 正在向具身智能延伸。
第二,再强的认知泛化也无法自动解决精细物理操作问题。在依赖接触稳定性的任务中,Astra Direct 几乎失效。而 π₀.₅ 提供的动作先验,仍是不可替代的。但反过来,π₀.₅ 自身泛化能力有限——在 RoboLab 中单独使用仅 36% 成功率,远低于与 Astra 组合后的 92%。
因此,最优路径或许是:通用模型拓展认知边界,具身模型夯实物理交互基础。两者协同,才能覆盖从“理解任务”到“稳定执行”的完整链条。
中国具身智能的挑战与机会
GPT-6 Astra 的出现给国内具身产业带来压力。据传 OpenAI 已采购上千万小时类具身数据,在相关模型上投入超百亿人民币,目标直指“具身 ChatGPT”。
但 Astra 本身也有缺陷:轨迹质量一般、软硬件不一体、模型过大导致部署困难、成本极高。这说明其路线尚未成熟。
对中国而言,真正的机会在于场景与产业链。制造业、物流、零售等领域拥有大量机器人应用环境,也有完整的硬件供应链。但场景不等于数据,数据不等于能力。只有把现场问题转化为高质量数据,把数据送入训练,再将模型放回真实环境验证,形成闭环,场景优势才能兑现为技术优势。
接下来的竞争,将取决于谁能更高效地完成“场景→数据→模型→验证”的飞轮。而驱动这个飞轮的燃料,依然是数据和算力。